Skip to content
← 标签

#视觉语言模型 (17)

VAP-TAMP 精读:用动作知识引导 VLM 主动感知——机器人在执行中发现「门只开了一半」怎么办

VAP-TAMP 精读:用动作知识引导 VLM 主动感知——机器人在执行中发现「门只开了一半」怎么办

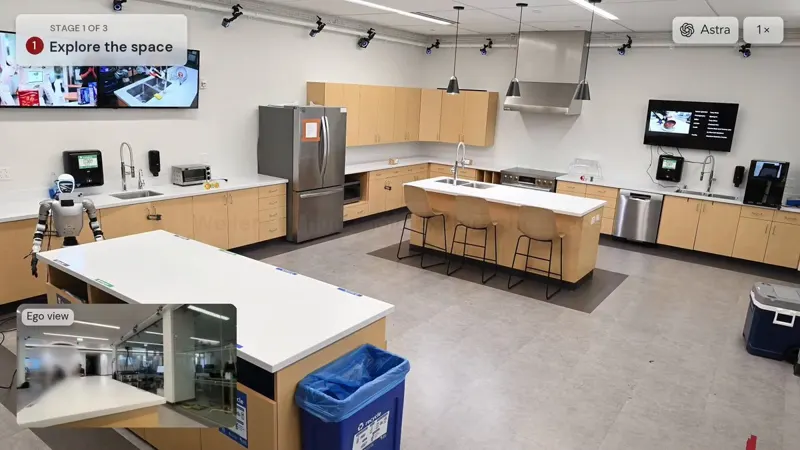
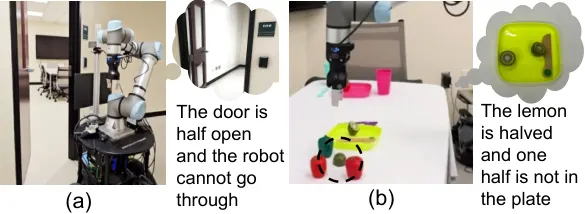
SUNY Binghamton + CMU + Ford Research + Agility Robotics,TAMP(任务与运动规划)+ VLM 主动感知框架。核心问题:TAMP 规划假设全知世界,但真实执行中随时冒出计划外状况——门只半开过不去、柠檬切半后一半掉出盘子。既有开放世界规划方法隐含假设「状况是完全可观测的」,而现实中机器人只能靠不靠谱的机载传感器。VAP-TAMP 的关键创新是 **VLM 与动作知识的双向交互**:用当前动作 PDDL 前置条件/效果构造视觉问句去 prompt VLM,再用 VLM 输出更新动作知识。三个模块:① 场景图生成器(RGB-D 点云+实例分割+CLIP 嵌入,几何规则判定 on/inside/near,动作驱动+观测驱动双通道更新);② 主动感知(对每个谓词生成 N 个语义等价问句让 VLM 多数投票,响应不一致→VLM 建议视角方向(left/right/closer/above)→导航过去再看,预算 K 内循环直至视图充分);③ 状况处理(verify-execute-verify 闭环:动作前验前置条件、动作后验效果,任一失败→修正场景图→PDDL 重规划;诊断区分感知错误/世界状态变化/执行失败三种根源)。真机实验:Segway RMP+UR5e+Robotiq 夹爪,4 个家务任务×25 次共 100 试,**成功率 88%**(OK-Robot 76%、COWP 69%、Closed-World 33%),72/100 试验中至少出现一次计划外状况;VLM 引导选视角平均 1.61 个 vs 贪心遍历 4.35 个(省 63%);失败模式显示 VAP-TAMP 的失败集中在操作硬件(42%),感知瓶颈被转移走。仿真实验(OmniGibson,5 任务+注入故障概率)证明基于具体状态谓词的验证优于 SuccessVQA/AffordanceVQA 及其组合,效果验证贡献大于前置条件验证(抓取/切割各 50% 组合故障率只能靠后验发现)。

Austine Oloo, Zainab Altaweel, Yohei Hayamizu · 468次阅读 · 2026年4月28日
TAMP主动感知视觉语言模型2026年4月28日
World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人

World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人

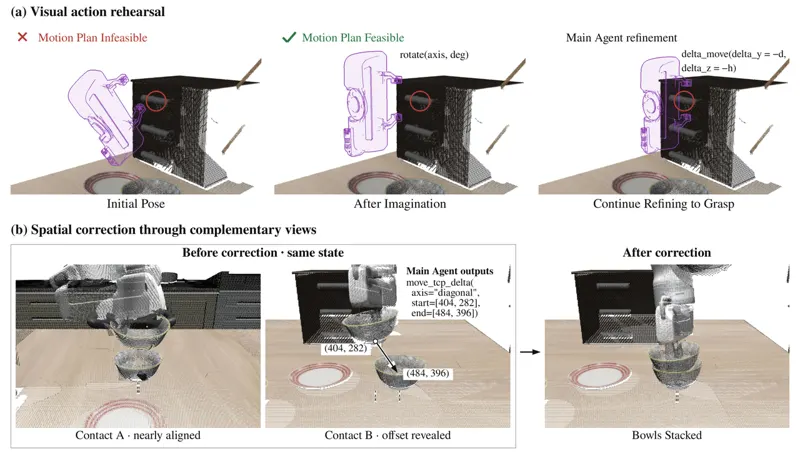
香港科技大学(广州)、香港中文大学与 Knowin AI 提出 World Action Agent(WAA),一个多智能体 harness——它不改 VLM,而是改 VLM 看到什么、以及它的决策如何生效,让通用 VLM 只用点选、拖拽、预览、执行等基础工具就能驾驶机器人,所有决策都在同一个「视觉动作工作区」内完成。工作区有三个性质:其一是 Contact views,根据交互区域、遮挡、取景紧凑度、视点冗余与稳定性主动求解相机参数,且约束两个视图的水平投影正交,使任何对齐误差都能沿两个独立方向被读出,且只需基坐标系点云,因此对 RGB-D 融合、仿真渲染或 VGGT 重建等感知来源完全无关;其二是动作试演,把每个动作表示为可编辑提案,由 cuRobo 规划后以半透明机器人叠加到各视图并报告可行性,Imagination Agent 在物理场景不变的独立上下文中反复修订,只有具备可执行规划的提案才能变成物理运动;其三是视图内修正,智能体在观察到误差的 Contact view 中从参考点拖到期望位置,参考点可以是所持物体上的可见点,因此无需先把关系换算成绝对位姿。技能侧由 Learner、Editor、Reviewer 三个角色在证据与独立审核约束下从专家视频与人类 Canvas-GUI 教学中进化出关系型多模态技能库。LIBERO-Pro 上以 Gemini 3.7 Flash 为骨干、仅用 LIBERO-90 进化并冻结的技能取得 75.6% 平均成功率的 SOTA,超过 ASPIRE(72.0%)、端到端 VLA 与同骨干的 Show-Harness(6.7%),Spatial 两个切分达 80.0 / 73.3;每回合仅 31 次模型调用、150 秒、0.1996 美元,远低于 Show-Harness 的 120 次、874 秒、0.5021 美元。同一套冻结技能迁移到 robosuite 达 100.0%;用 112 条轨迹(1,774 决策步)LoRA 微调 Qwen3.5-9B 只替换主智能体,域外成功率从 1.7% 提升至 43.3%。

Yehang Zhang, Haojian Huang, Yifan Chang · 776次阅读 · 2026年9月24日
World Action AgentWAA视觉语言模型2026年9月24日
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。