Rolling-WAM:把世界动作模型的去噪摊到每个重规划周期
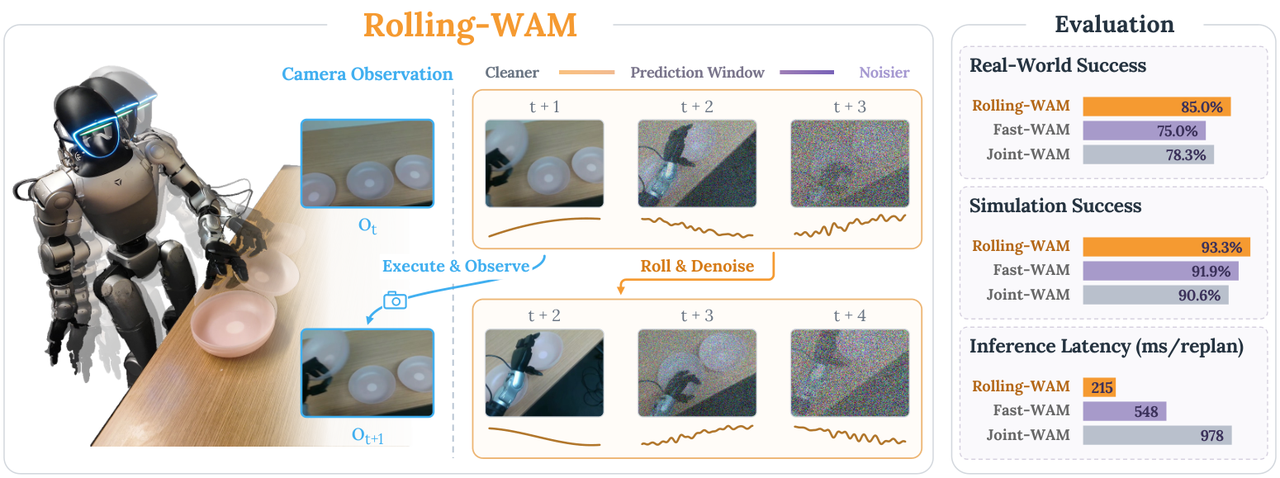
南加州大学、布朗大学、复旦大学与丰田研究院提出 Rolling-WAM。世界动作模型(WAM)把未来视觉预测与动作生成耦合,但标准做法要求每个重规划周期把整个预测视野从纯噪声完整去噪一遍,延迟巨大、闭环反应迟钝。作者指出 receding-horizon 控制实际只执行视野的开头一小段,未被执行的尾巴含有价值却被丢弃。Rolling-WAM 维护一个滑动窗口,窗口内越靠未来的 chunk 噪声越高:滚动模式下 chunk j 的噪声为 σ((j-1+τ)/W),第一个 chunk 在周期结束时变干净,且满足 σ_{j+1}(0) = σ_j(1) 的衔接条件,因此窗口前移后被保留的 chunk 恰好处于新位置的起始噪声,可直接接着去噪。每个 chunk 仍走满 N 步,但计算被摊到多个周期,稳态每周期只需 N/W 步。默认 N=10、W=5、K=16,即维持 80 个动作的预测窗口而每次更新只跑 2 步去噪。注意力掩码上,每个动作 chunk 可 attend 整个窗口的视觉特征,动作之间的直接注意力仅限同 chunk,视频 token 不 attend 动作 token,训练与推理一致。结果:稳态重规划 215 ms 对比 Joint-WAM 的 978 ms,加速 4.5 倍,比不做未来想象的 Fast-WAM(548 ms)还快,且比两个 VLA 基线(285/296 ms)更快;LIBERO 98.1%、RoboTwin 2.0 93.3%(全场最高,且无具身预训练即超过预训练的 LingBot-VA)、Unitree G1 真机三任务 85.0%。消融显示窗口 W=5 最优而 W=8 掉到 69.5%,且跨 chunk 直接动作注意力反而有害——动作应借道共享视觉未来协调。