Skip to content
← 标签

#代码生成 (6)

AI 编程开发C

v0:把「生成代码」升级成「自己打开自己写的 app 去用它」的发布型 agent
Vercel 的 v0 是闭源全栈生成工具里 agent 闭环做得最完整的一条:联网检索带可点击来源、浏览器实际操作自己生成的 app 并回传截图、沙箱内跑终端与单测、自带 MCP 接外部工具,2026-09 起 GitHub 项目一键 Publish 走完 PR→merge→部署。它的边界同样明确:默认栈锁 Next.js+shadcn、最短路径锁 Vercel、credits 随迭代轮次线性涨,且没有任何公开的正确性基准。

一步 PR→merge→部署GitHub 项目发布链路厂商宣称 · 2026-09
产品Vercel官网
v0:把「生成代码」升级成「自己打开自己写的 app 去用它」的发布型 agent
ReST-RL:用统一自训练与价值引导搜索强化大模型推理

ReST-RL:用统一自训练与价值引导搜索强化大模型推理

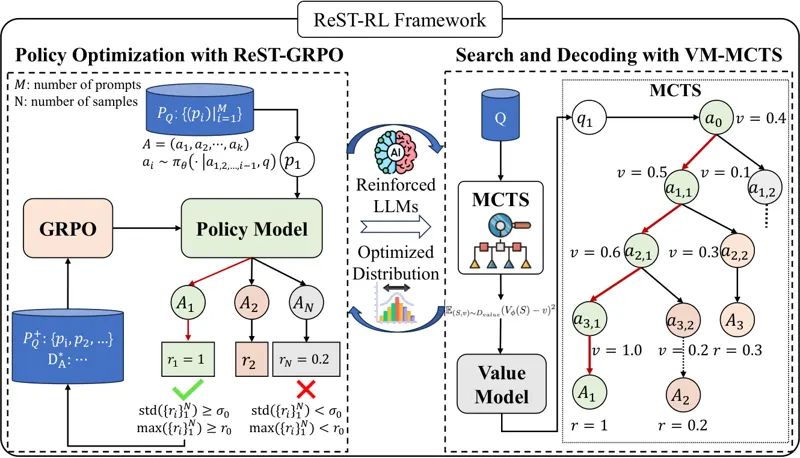
GRPO 是当前提升大模型推理能力的代表性强化学习方法,但它只在整条轨迹末端拿到一个稀疏奖励:一旦同组采样得到的奖励彼此接近,组内相对优势就退化成噪声,策略几乎学不到东西。ReST-RL 把策略优化与价值引导搜索重新接回同一条自训练流水线。第一阶段 ReST-GRPO 先按奖励标准差过滤掉信息量低的提示词,再从每个提示词的最高奖励轨迹中按离散指数分布抽取若干前缀,把它们当作在线 GRPO 的新起点——前缀只作为上下文,后缀一律重新采样并优化,而不是拿来模仿。第二阶段 VM-MCTS 在这个已静态化的策略下用 MCTS 自采价值目标,训练一个预测期望终端奖励的价值模型,推理时同一个模型既用于 UCT 搜索分配,也用于最终 Best-of-N 排序,搜索与验证共享同一套状态价值尺度。在 APPS、BigCodeBench、HumanEval 等代码基准上,Qwen3-8B 的平均分从 0.503 提升到 0.689;在匹配策略与价值模型的对照实验里,ReST-GRPO + VM-MCTS 在 APPS-500 上得到 0.642,而 GRPO + VM-MCTS 只有 0.538,说明第一阶段带来的轨迹分布改善确实穿过了价值学习环节存活下来。端到端算力核算上,ReST-GRPO 用 1752 GPU 小时对 GRPO 的 2080 小时,在 71 小时而非 207 小时达到 9% 的提升。仅用代码轨迹训练出的价值模型,在不做目标域微调的情况下迁移到 MATH、Omni-MATH 与 GPQA-Diamond 同样带来增益。

Sining Zhoubian, Dan Zhang, Jie Tang · 721次阅读 · 2025年8月27日
强化学习GRPO
2025年8月27日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。