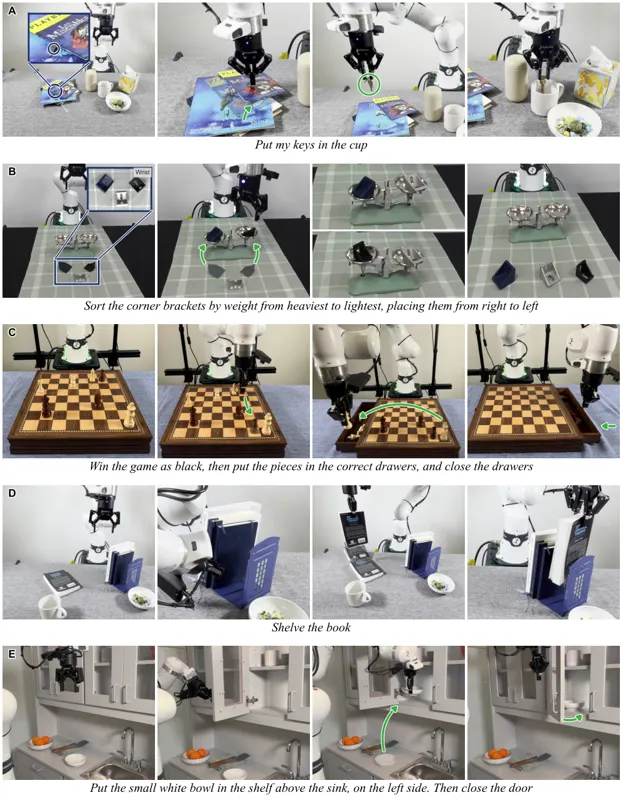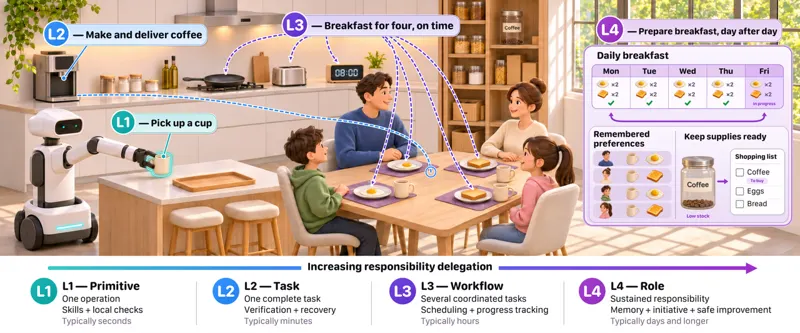
构想智能体机器人:机器人系统的新时代论文将具身智能体机器人的决策核心定义为“基础模型 + 具身执行外壳”的 Embodied S2,其中外壳负责上下文、工具、规划、记忆与验证。文章把模型能力与闭环系统表现分开评测,以延迟、成本和持续运行世界中的安全性约束系统结论,并用 L1 至 L4 的逐步扩展责任衡量从局部技能到长期角色的进展。它是一份概念框架与研究路线图,而不是已统一实现并验证的完整系统。Grid Robotics, Qingfeng Lan, Duo Li · 137次阅读 · 2026年11月13日Agentic Robotics人工智能2026年11月13日
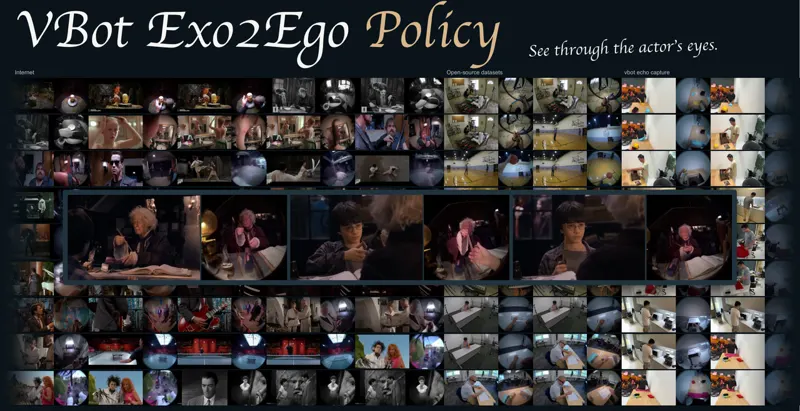
VBot Exo2Ego Policy:轻量数据采集与第三人称到第一人称视频生成本文提出 VBot Exo2Ego Policy,一种把第三人称操作视频转换为指定操作者第一人称观测的视频生成模型,用于从丰富的真实世界素材扩展第一人称操作数据。作者同时设计轻量采集流程与移动应用,支持第一人称、第三人称以及同步双视角采集,并将单视角素材与带相机几何的配对数据结合起来。模型以预训练视频扩散 Transformer 为基础,引入相机射线几何条件、语义掩码和手部关键点辅助监督,以改善视角转换与手物交互保真度。训练时随机注入并逐步移除相机几何条件,使推理不依赖目标相机标定;针对互联网视频,再加入源视频感知与推理、可选人物参考和跨镜头适配,以识别目标操作者并跟踪跨剪切操作。Tong Rao, Zhihao Zhang, Yuntian Wang · 118次阅读 · 2026年11月12日具身智能First-Person Video2026年11月12日
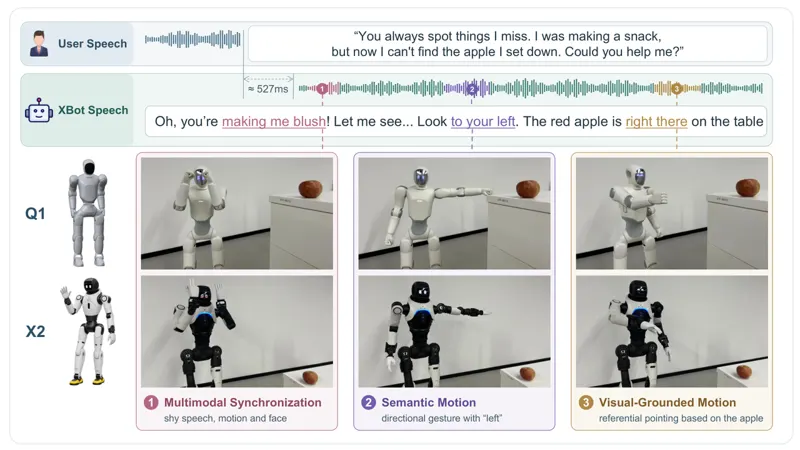
XBot-Omni:面向具身理解与交互的全模态模型XBot-Omni 是面向具身理解与交互的全模态模型,采用 Thinker–Talker–Actor 三层架构。Thinker 统一处理文本、图像、音频和视频,Talker 以流式方式生成语音,Actor 直接利用二者的原生内部表示,同步生成身体动作与面部表情,并通过语义事件控制、语音—动作对齐和视觉指向训练,把场景理解转化为可执行的非语言表达。模型在七个基准上评估,在 Daily-Omni 达到 86.30%,在 ReTurn 达到 84.00%,语义动作质量显著高于已有动作生成方法;项目页目前只提供展示与视频,尚未发布公开模型代码。Kerui Gu, Xing Fu, Shuoyang Sun · 158次阅读 · 2026年11月12日具身智能Omni-Modal Model2026年11月12日
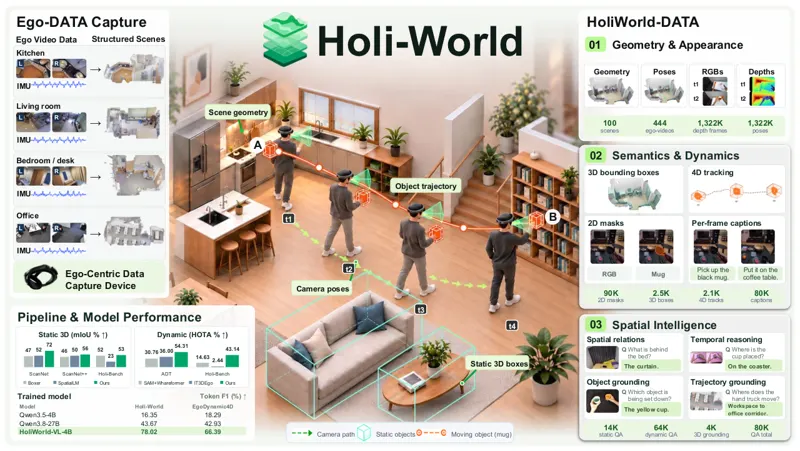
Holi-World:从第一视角经验构建世界智能Holi-World 将自采第一视角数据、静态与动态三维感知、约 8 万条证据链问答和独立人工评测连成闭环,训练 4B 视觉语言模型理解空间与时间变化。Hao Li, Xiyuan Zheng, Yuanyuan Gao · 147次阅读 · 2026年10月19日Egocentric Vision3D Scene Understanding2026年10月19日
智能体式机器人操作策略研究通用模型无需示范即可通过代码直接控制机械臂。AMP1在RoboLab-120零样本达到85.6%,真实机器人完成104/108次试验。Chen Chen, Omid Bagherieh, Naveen Nikamanth Appiah Balaji · 241次阅读 · 2026年11月6日机器人操控Agentic AI2026年11月6日
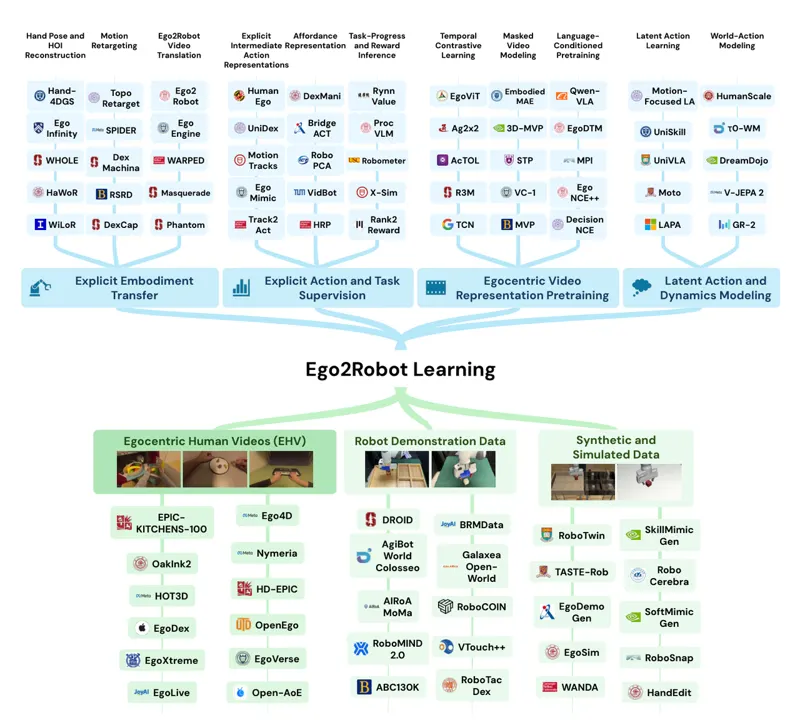
从第一人称人类视频到机器人操作:具身智能时代的经验迁移综述第一人称人类视频记录了近距离手物交互、操作时序与日常任务结构,为机器人操作提供了可扩展的经验来源,但缺少机器人动作标签,并存在形态、视角与动作空间差异。本文把从这类视频学习或适配机器人操作策略定义为 Ego2Robot 学习,归纳为显式具身迁移、显式动作与任务监督、第一人称视频表征预训练、潜动作与动力学建模四类范式;随后梳理人类视频、机器人演示及合成或仿真数据,并以保留的交互信息和目标机器人可执行性为分析主线,讨论物理可行性、智能体协同、上下文适应、受控评测与闭环控制等开放问题。Yi Wang, Jingqiu Wu, Lei Yao · 176次阅读 · 2026年11月10日Egocentric Video机器人操控2026年11月10日