UC Berkeley Sky Lab 出身、2000+ 贡献者的推理与服务库:分页 KV 显存、连续批处理与分块 prefill、CUDA/HIP 图与 torch.compile、FP8/MXFP4/NVFP4/GGUF 等全量量化、FlashInfer/TRTLLM-GEN/FlashMLA 可插拔注意力核、n-gram/suffix/EAGLE/DFlash 四条投机解码路线、张量/流水线/数据/专家/上下文五维并行与 P/D 分离,同时讲 OpenAI 与 Anthropic 两套协议。
LMSYS 托管的高性能服务框架:RadixAttention 前缀缓存、零开销 CPU 调度器、P/D 分离、DFlash 与 Spec V2 投机解码、压缩有限状态机做结构化输出、大规模专家并行(96 张 H100、GB200 NVL72 二期 3.8 倍 prefill / 4.8 倍 decode)。day-0 记录覆盖 Kimi K3、DeepSeek-V4、GLM5.2 NVFP4、Nemotron 3、MiniMax M2,并被 AReaL/Miles/slime/Tunix/verl 用作 RL rollout 后端。
NVIDIA 的 LLM 与视觉生成推理优化库,2025-03-22 起完全开源。28 篇技术博客构成一份可查的工程账本:Skip Softmax 与稀疏注意力压长上下文、专家并行三部曲与 NVLink 单边 AlltoAll、NVL72 的 DWDP、引导解码与投机解码协作、推理时计算,以及用 trace 回放与作业级指标评估 agentic 服务。宣称 Llama 4 Maverick 单用户破 1000 TPS、B200 上超 40000 tok/s,Bing 与 NAVER Place 在生产使用。
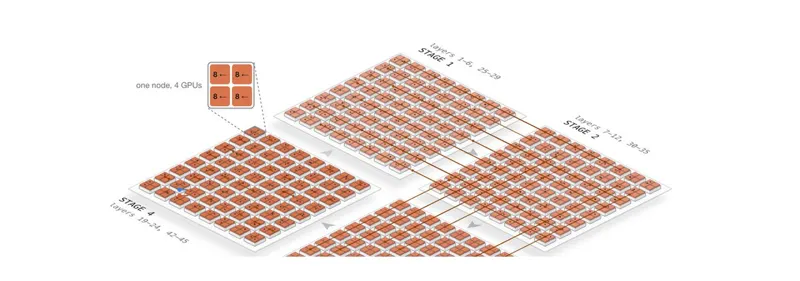
从显卡集群、数据与 tokenizer 到 router、负载均衡、专家并行、训练诊断和推理部署,逐项讲清 MoE 的关键配置与实验依据。
博客
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。