HIL-UMI:把 VLA 人在环后训练搬离机器人本体
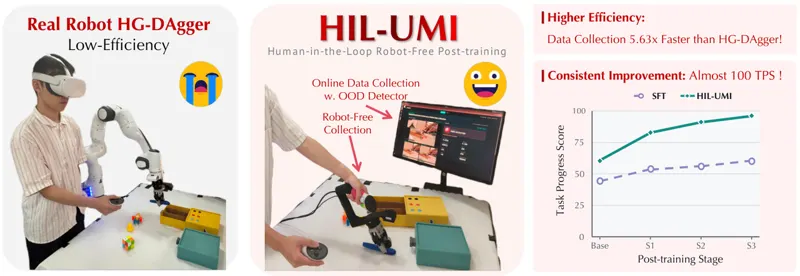
HIL-UMI 用手持 UMI 夹爪做人机在环 VLA 后训练:人在演示时,同一观测流上并行跑当前策略但不执行其预测,用 Energy Score 比较人类动作块与策略动作分布,超阈值即判为分布外(OOD)并触发定点采集;另一条回路上,在线优势预测偏低的片段被收来重训基于任务进度的优势估计器,再由它给数据打二元优势标签做优势条件行为克隆(ACBC)。四个真机任务上持续优于 SFT,Stack Cube 三轮后 TPS 84→100;对比真机 HG-DAgger,Clean Up Table 每帧采集时间 73.40ms 对 412.99ms,快 5.63 倍且末轮 TPS 高约 5 分。
Han, Zimu, Zeng, Yiming, Zhang, Jiyao2026年9月17日
视觉语言动作模型Human-in-the-Loop后训练2026年9月17日