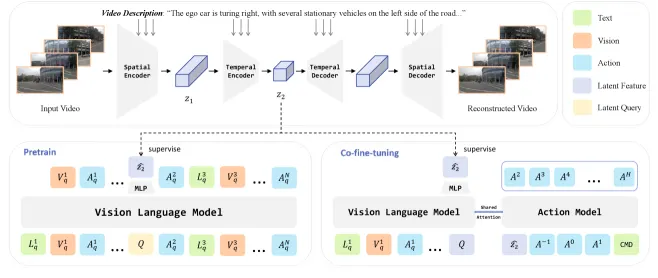
HyWorldVLA:面向自动驾驶的混合世界建模视觉语言动作模型VLA模型增强世界建模是端到端自动驾驶的有前景范式。像素级未来预测提供细粒度时空推理但在噪声场景下鲁棒性不足;隐式世界建模鲁棒但缺乏细粒度推理。本文提出HyWorldVLA,采用混合世界建模同时利用两种优势。Quanfu Yu, Xian Wu, Hao Xu·2026年7月23日视觉语言动作模型世界模型无人驾驶2026年7月23日