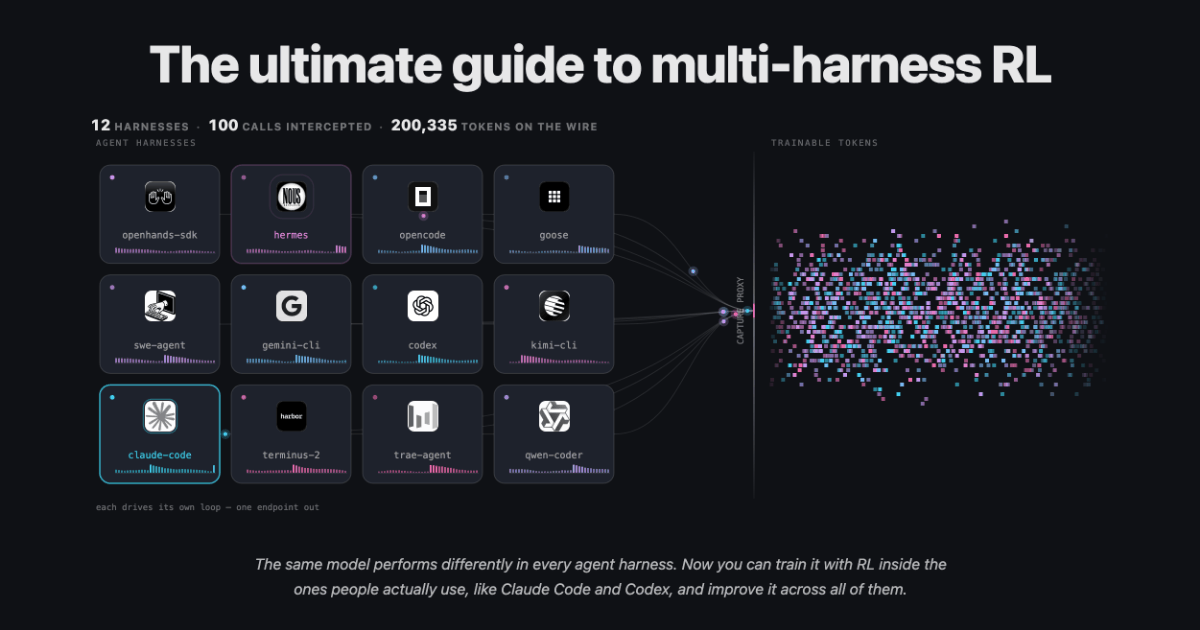
多 harness 强化学习完全指南:在 Claude Code、Codex 里直接训练模型——HF 团队用 2.6B 小模型验证跨 harness 训练
同一个模型换个 agent harness 表现判若两人:GLM-5.2 在 SWE-bench Pro 上一个 harness 23%、另一个 52%;受控实验里换 harness 移动 13 个点,同 harness 换模型只移动 2.5–5 个点。Hugging Face 团队(Adithya S Kolavi、Joel Niklaus、Lewis Tunstall、Leandro von Werra 等,联合 Liquid AI)发布的这篇长文给出开放解法:在 Claude Code、Codex、OpenCode、Mini-SWE-Agent 这些真实 harness 里做 agentic RL,harness 一行代码不改。框架三件套——OpenEnv 提供与环境/训练器共享的标准接口,capture proxy 以「会话即钥匙」方式截获模型端点上的精确 token id、逐 token 行为 logprob 与损失掩码(强制全分布采样,top_p=1.0),Harbor 提供 40+ harness 适配器与 26 种沙箱后端,TRL 的 Async GRPO 消费带掩码的训练序列。用 1 万小时级数据之外的实打实数字说话:LFM2.5-2.6B 四 harness 训练后平均 pass@1 从 42.2% 升到 54.2%,四个 harness 全涨,已解任务工具调用少 31%;只训 OpenCode 的对照组增益几乎锁在自己家里。文章还诚实交代了 SFT 对照(RL 54.6% vs SFT 47.5%)、Qwen 先涨后崩的完整归因(输出预算耗尽、不交卷空转、奖励项被钻空子导致 0.740→0.178)以及 proxy 并发上限等工程边界。
博客
强化学习智能体运行时OpenEnvHarborGRPO