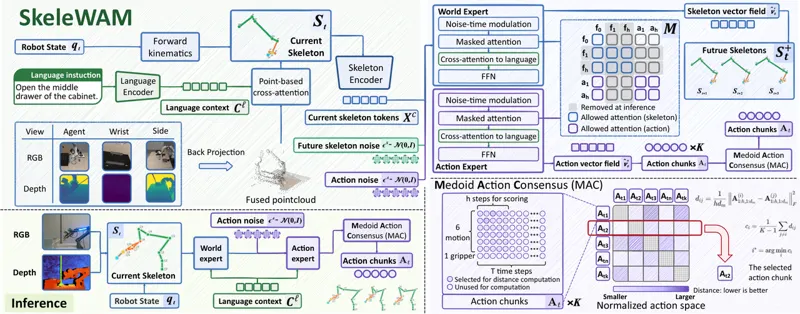
SkeleWAM:把操作场景压成稀疏三维骨架
世界动作模型通常把未来状态表示为视频或视觉 latent,几何只被隐式编码且夹带与控制无关的外观。SkeleWAM 只保留机器人关节、物体中心与交互点三类三维路标,用同一副骨架同时做动作生成与未来骨架预测,训练期用后者作辅助监督、推理期完全省掉,在 LIBERO-Plus 上以 57.1M 参数取得 85.9% 零样本成功率,超过 2B 参数的 Cosmos-Policy 3.7 个百分点。
Juyi Sheng, Hua Wang, Mengyuan Liu2026年10月1日
视觉语言动作模型WorldActionModel操作2026年10月1日