亲手构建自己的 Jev(100% 本地):用 SGLang 复现固定答案打分决策引擎
用 SGLang /v1/score 在本地复现 Jev 式固定答案打分:单 token 标签、受限 softmax、置信度分流路由,并与结构化输出、自回归生成实测对照:单决策 6 ms 对 1088 ms。
大多数 LLM 调用并不需要模型「写」出新文本。应用早就知道所有可能的答案,它只需要模型从中选一个。一张写着「同一笔订阅被扣了两次款」的工单,必须且只能落到三个团队之一:账单、技术支持、或账户权限。普通的 LLM 调用会让模型写一个答案——一句话、一个标签、或一个 JSON 对象——然后应用等这段文本生成完,再解析它、抽出被选中的团队。
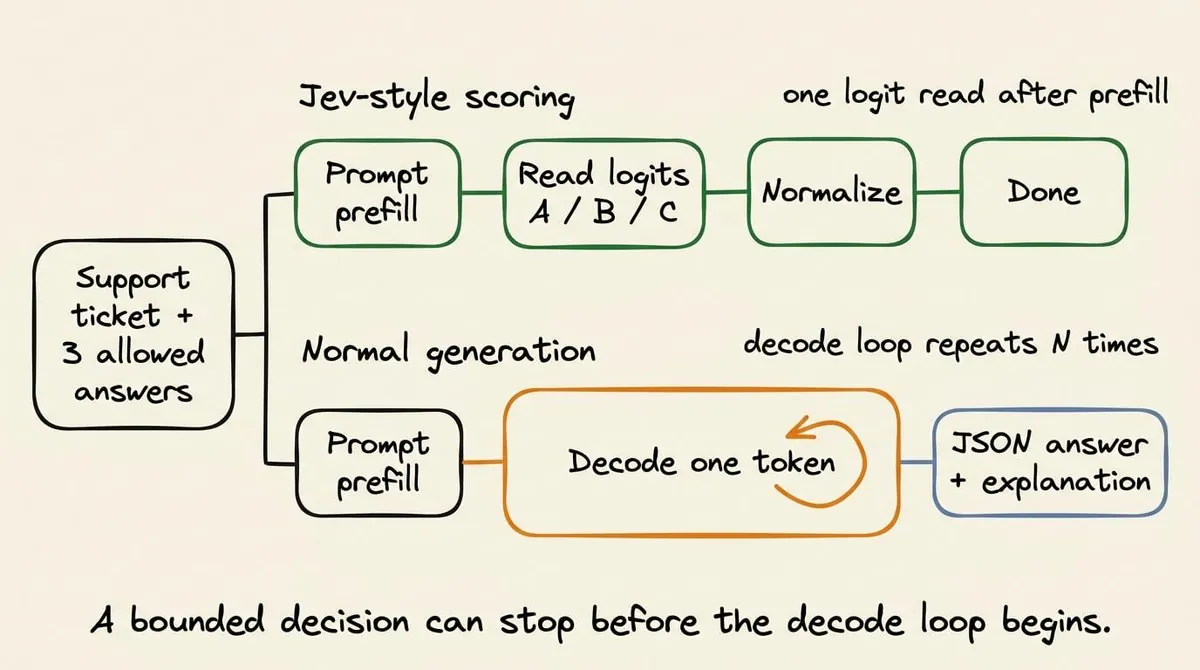
当所有合法答案都已知时,这个来回完全是多余的。更好也更高效的做法是把同一次请求当成一个「决策」:应用提供工单和三个候选答案,模型一次性返回每个答案的得分:
billing             0.91
technical support   0.06
account access      0.03
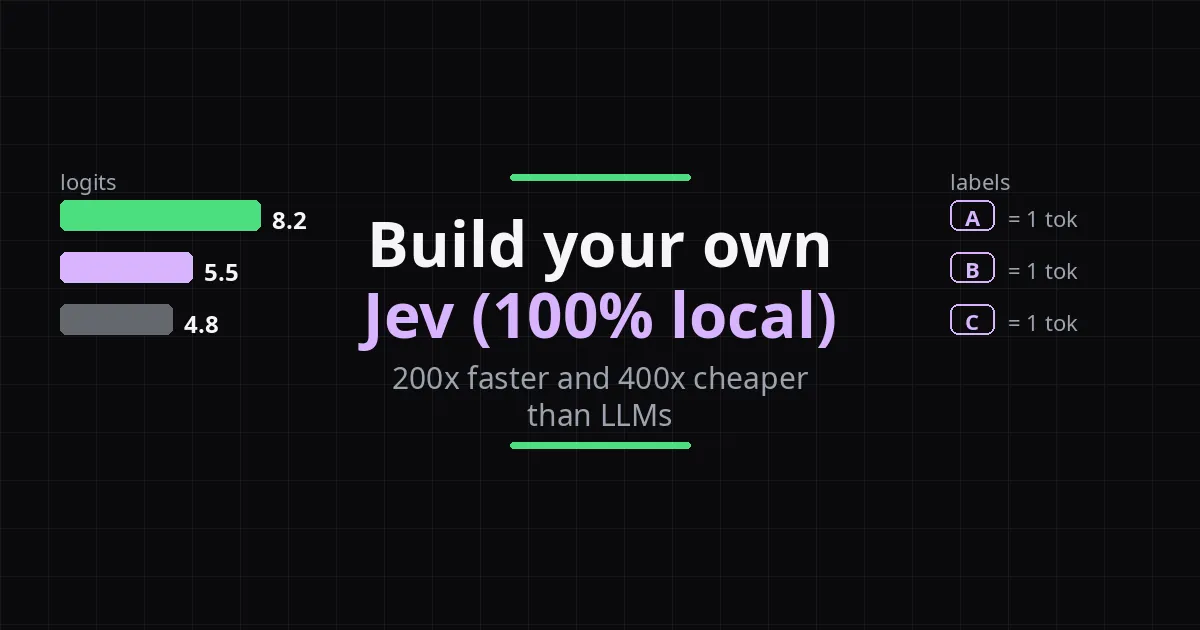
billing 以最高概率胜出,而且应用代码能看见它赢得有多明显。这正是 Jev 具备的行为,本文要在本地把它复现出来:一次打分请求返回决策和概率分布,不生成任何句子或 JSON 对象。Jev 本身闭源,但这个推理模式在若干开源语言模型里已经存在。具体地,我们用 SGLang 的 /v1/score 端点实现它,在 Qwen 与 DeepSeek 模型上测试,并与同一个模型上的结构化输出、普通文本生成做对照。
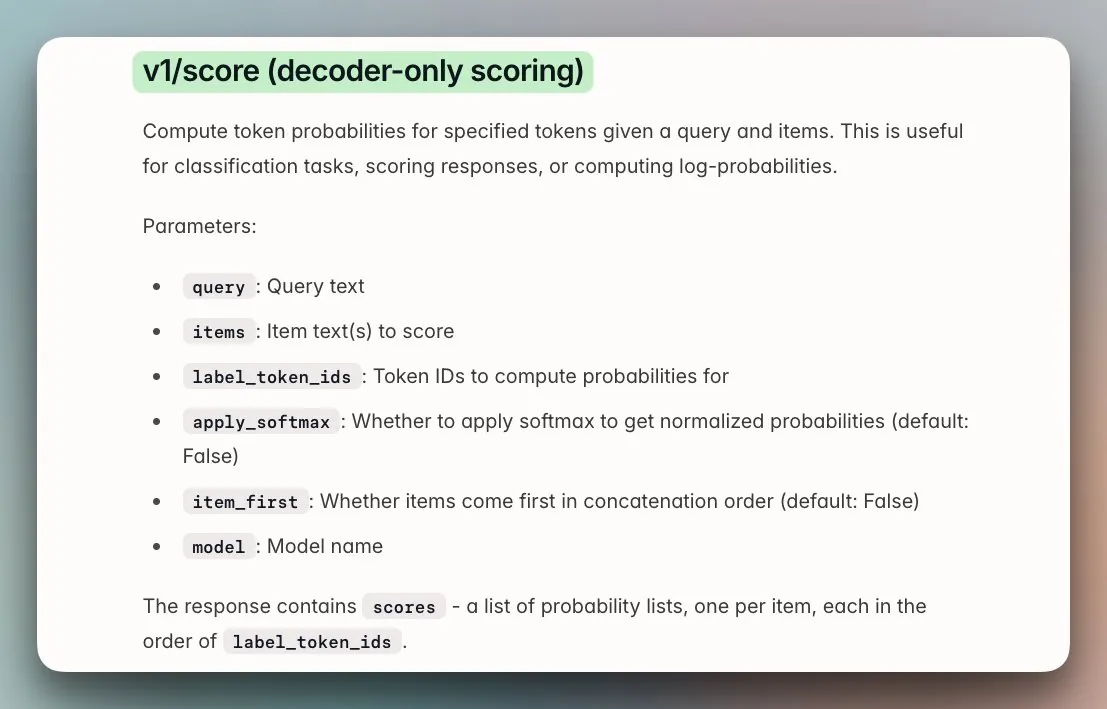
/v1/score:给定 query 计算指定 token 的概率——正是 Jev 式决策引擎需要的那个原语。先把预期说清楚:本文复现的是推理路径,不是完整的 Jev 系统。Jev 还包含训练与校准工作,那是一个打分端点给不了的。
固定答案打分不是结构化输出
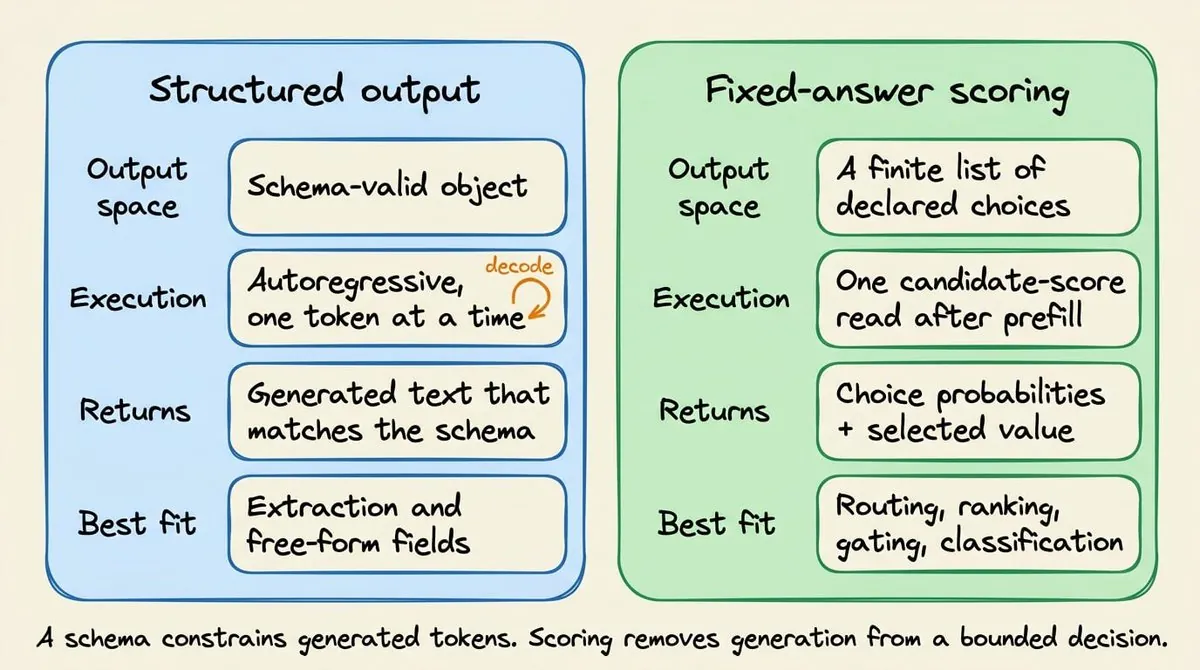
人们很容易把 Jev 的机制和结构化输出混为一谈,因为两者都限制了应用能收到什么。但它们在推理服务器内部做的是不同的事。同一张工单,结构化输出可能返回:
{"team": "billing"}schema 挡住了非法对象,但它本身并不负责「选出团队」。底层模型仍然要一个 token 一个 token 地生成左花括号、字段名、取值、右花括号;生成结束后应用才去读 team 字段。
{"team": "billing"},之后才有人知道答案。换成打分,应用把三个团队作为「合法结果全集」提供给服务器;服务器读出每个结果的一个模型得分,返回上文那个分布。全程不生成任何 JSON 对象。
一旦你返回全部取值而不只是胜者,差异就变成了可操作的系统行为:
Result 1                          Result 2
billing       0.91                billing       0.46
technical     0.06                technical     0.44
account       0.03                account       0.10
两个结果都选 billing,但第一个是明确偏好,第二个几乎打平。应用可以让第一张工单自动路由,把第二张送人工复核。模型只负责给分;怎么用这些分的规则写在应用代码里,可以被测试、可以被修改。例如可以要求最高分超过 0.80 且领先第二名至少 0.20,即仅当 $p_{\top} \geq 0.80$ 且 $p_{\top} - p_{2} \geq 0.20$ 时才自动放行。
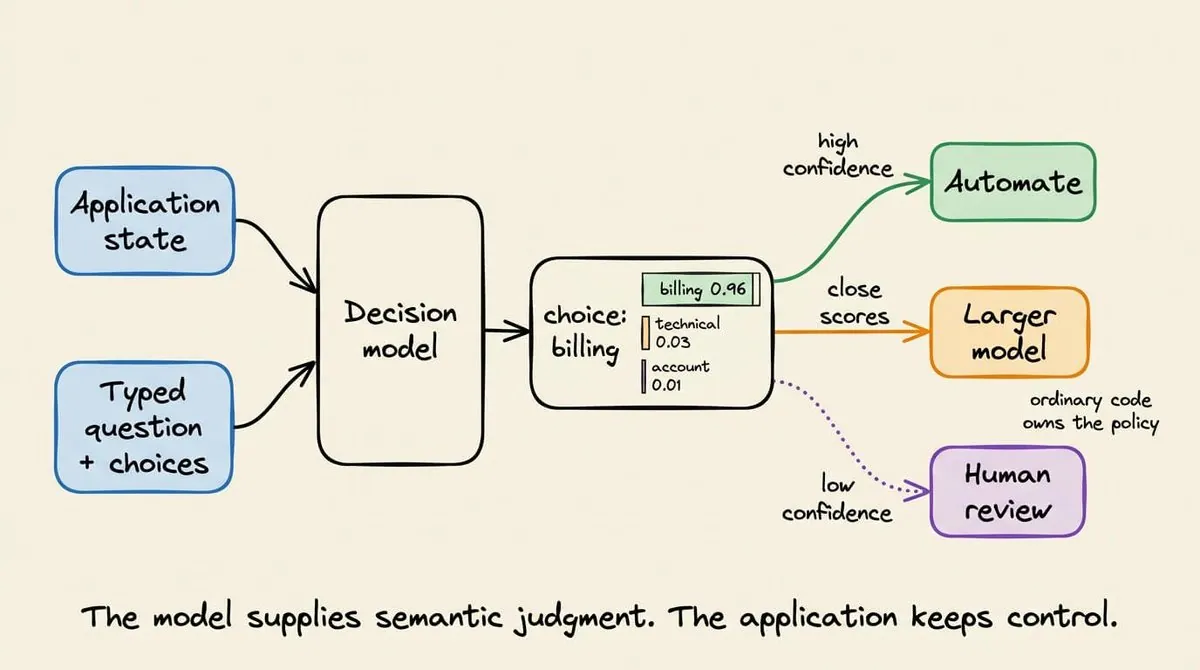
一个校准上的警告:0.91 表示 billing 在这三个候选上拿到了 91% 的概率质量,并不证明模型在 91% 的情况下答对。要度量后者需要带标签的样本。记住这条分工:结构化输出生成一个合法对象;固定答案打分返回「应用已知答案」上的分布。
LLM 如何生成第一个输出 token
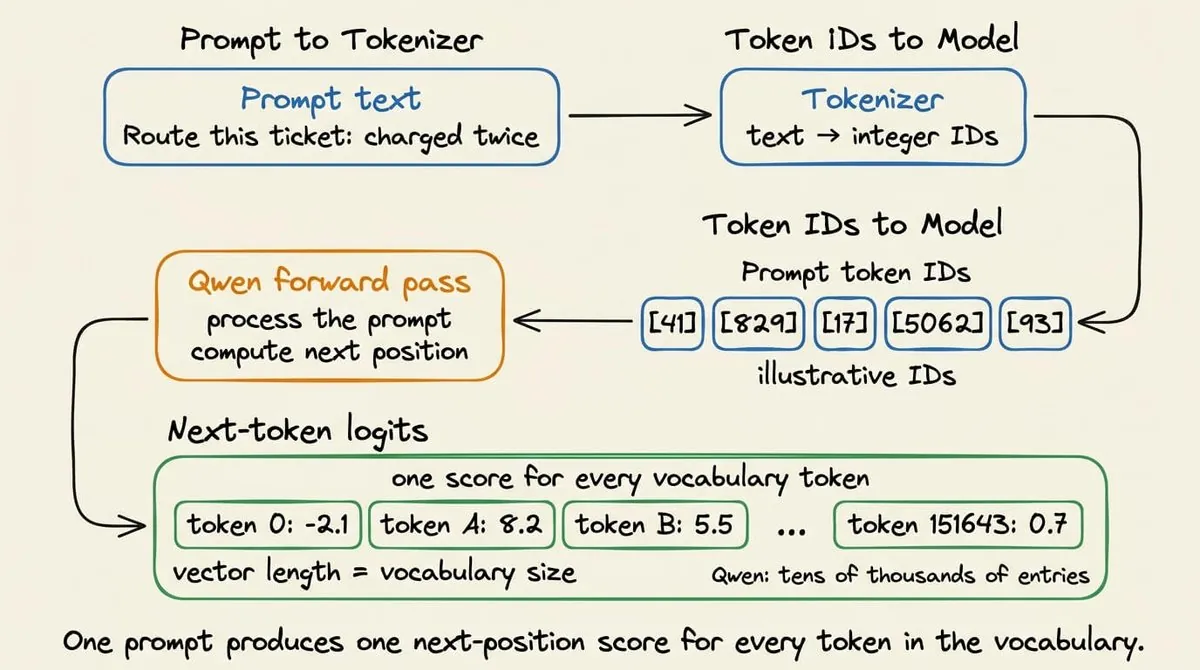
一次普通的生成步骤是这样的:
- 分词器把提示词转成 token ID。
- 模型处理该序列,为下一个位置产出一个向量。
- 向量里词表每个 token 对应一个数。这些原始数值叫 logits:logit 越大表示模型越偏好该 token 作为下一个续写,但它们还不是概率。
普通生成时,服务器对该向量套用解码规则(temperature 等),选出一个 token 追加到提示词,再为下一个位置产出新的词表大小向量。解码如此循环,直到停止 token 或输出上限。
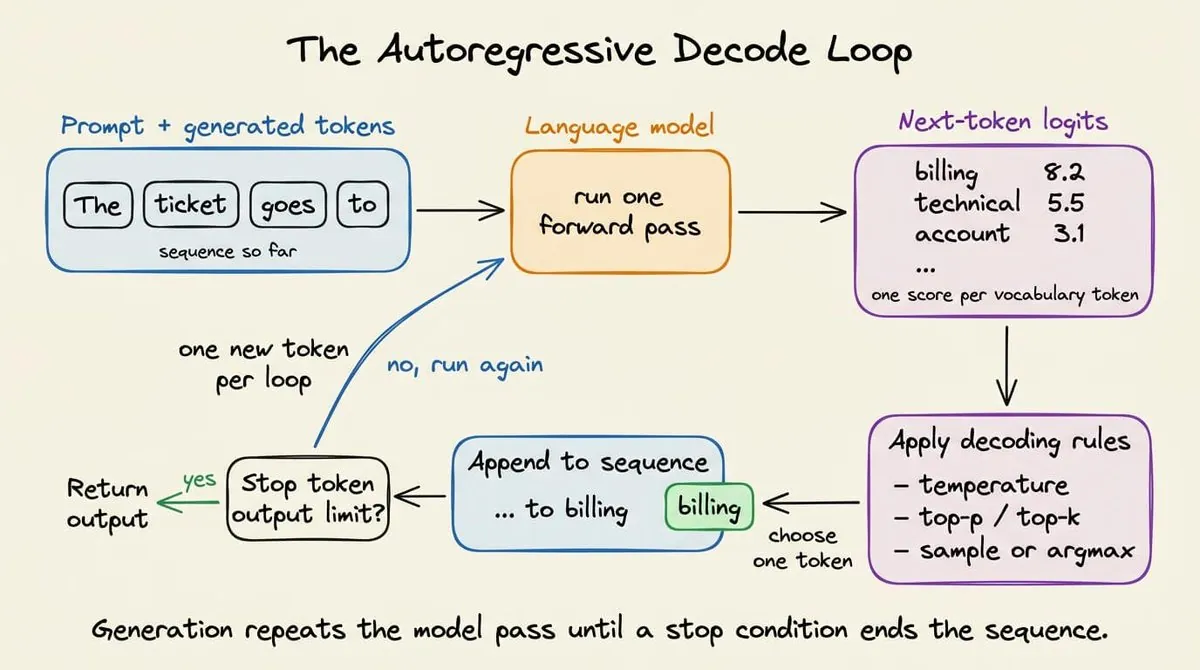
对有界决策而言,我们只关心第一个向量。以支持工单路由为例:应用接受三个答案,并在提示词里给每个答案一个短标签:
Route the support ticket into exactly one category.

Ticket:
I was charged twice for the same subscription.

Allowed labels:
A = billing
B = technical support
C = account access

Return only the label.

Label:
「Label:」是提示词的结尾,因此下一个位置正是模型按惯例会生成 A、B 或 C 的地方。处理完提示词后,模型为该位置产出与平时一样的词表大小向量,其中包含 A、B、C 的 logit 以及所有其它 token 的 logit。打分路径随后做四步操作:
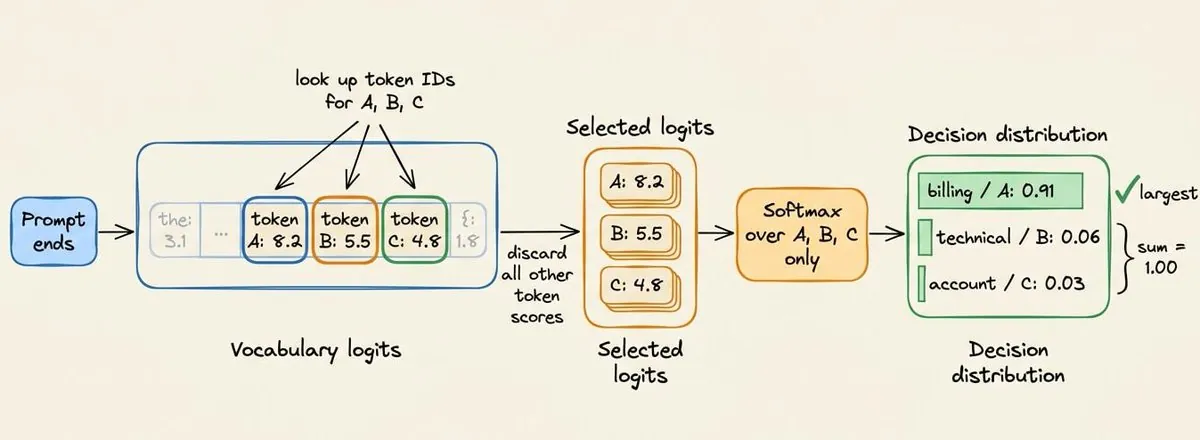
- 找出 A、B、C 的 token ID。
- 读取词表向量中这三个位置的 logit。
- 忽略其它所有 logit。
- 对选中的三个值做 softmax。
若选中的 logit 是 8.2、5.5、4.8,受限 softmax 大约得到 0.91、0.06、0.03:
$$p_i = \frac{e^{z_i}}{\sum_{j \in \{A,B,C\}} e^{z_j}}, \quad \mathrm{softmax}([8.2,\,5.5,\,4.8]) \approx [0.91,\,0.06,\,0.03]$$把这三个位置映射回 billing、technical support、account access,就得到决策分布。归一化只发生在声明的候选集合内:我们问的不是「A 在全词表上有 91% 概率」,而是「在应用排除了其它一切回答之后,模型如何在 A、B、C 之间分配偏好」。
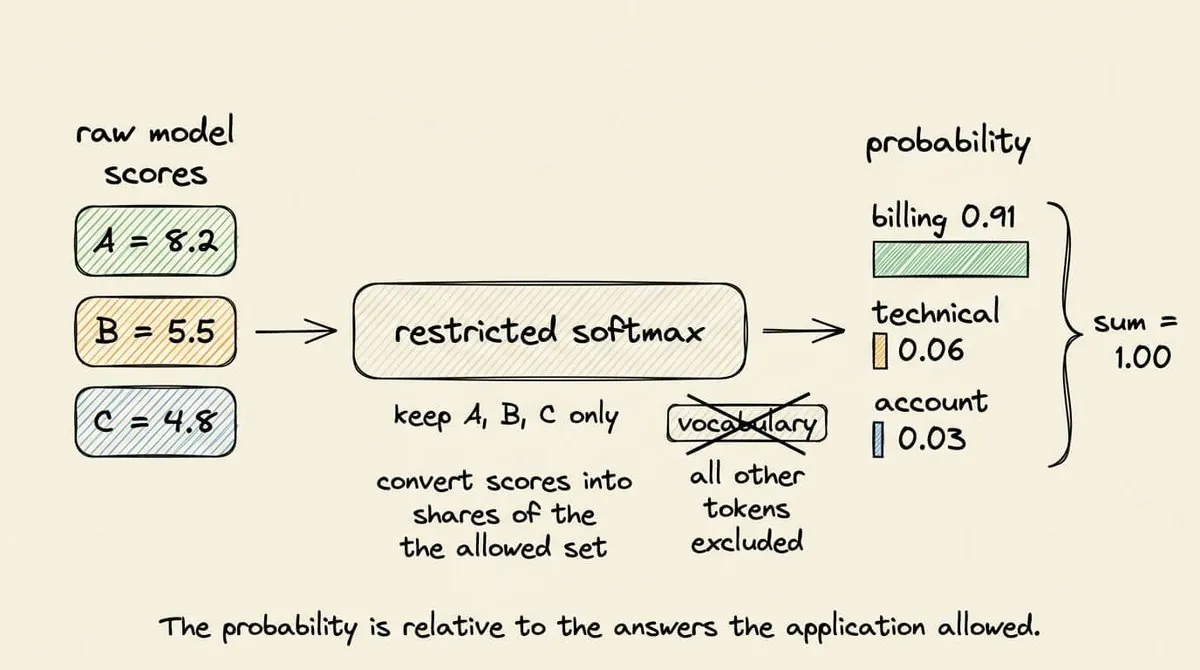
这正是 SGLang 在 /v1/score 里已经实现的操作:它把提示词送进模型,读取请求的 token 位置,返回它们的得分——省去了我们修改 Qwen 实现、亲手抽最后一层张量的麻烦。
为什么用 A、B、C 做标签,而不是直接对「billing」「technical support」「account access」这些词打分?因为看得见的词不一定是一个 token:
- 「billing」在某个分词器里是一个 token,在另一个分词器里可能是好几个。
- 「technical support」必然跨越多个位置。
比较多 token 短语需要序列打分:给第一个 token 打分、追加、再给下一个打分、合并数值,长度还会渗进比较里。单 token 标签把这些问题全部避开:每个选项在同一个输出位置上只占一个词表条目,而语义仍然写在提示词里:
A = billing questions and payment problems
B = product errors and technical failures
C = login, password, and account access problems
模型在处理提示词时读到这些描述;标签只是我们事后检查 logit 的那个 token。但我们仍要验证每个标签确实是一个 token,因为分词器常把前导空格编进 token:字符串「A」和「 A」可能对应不同的 token ID。
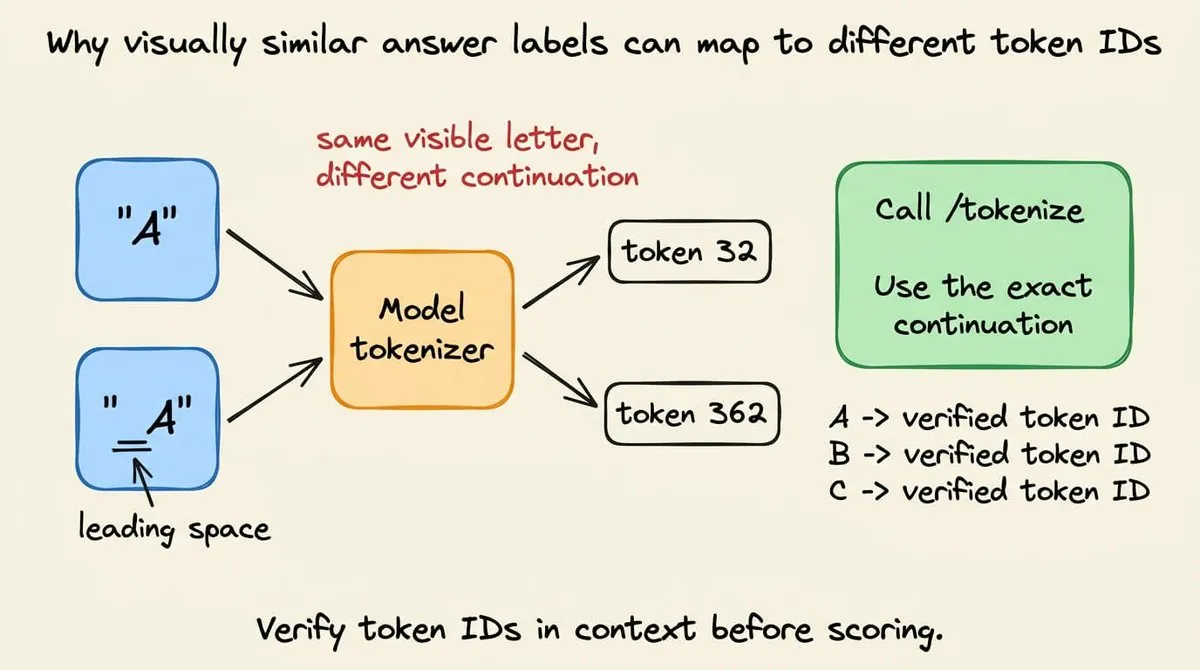
/tokenize,在打分前于上下文中验证 ID。聊天模板还可能在答案位置前塞入空白或控制 token。稳妥的流程是:用模型的聊天模板渲染完整提示词,确定答案位置上期望的精确续写,把该续写送给 /tokenize,凡是产出超过一个 token 的标签一律拒绝。这套标签映射只存在于打分客户端内部:应用发送的是 billing、technical_support 这样的语义选项,从不发送 token ID,也从不看见 A、B、C。这正是「公开 API 与模型标签解耦」的含义。
最后,候选清单还需要一条逃生通道,以应对「列出的选项并不穷尽」的情况。如果一张安全事件工单落到只提供 billing、technical support、account access 的路由器上,受限 softmax 仍会把全部概率质量分给这三个错误选项。只要存在「所列选项可能都不对」的场景,就加上 OTHER 或 ESCALATE。
用 SGLang 实现本地打分端点
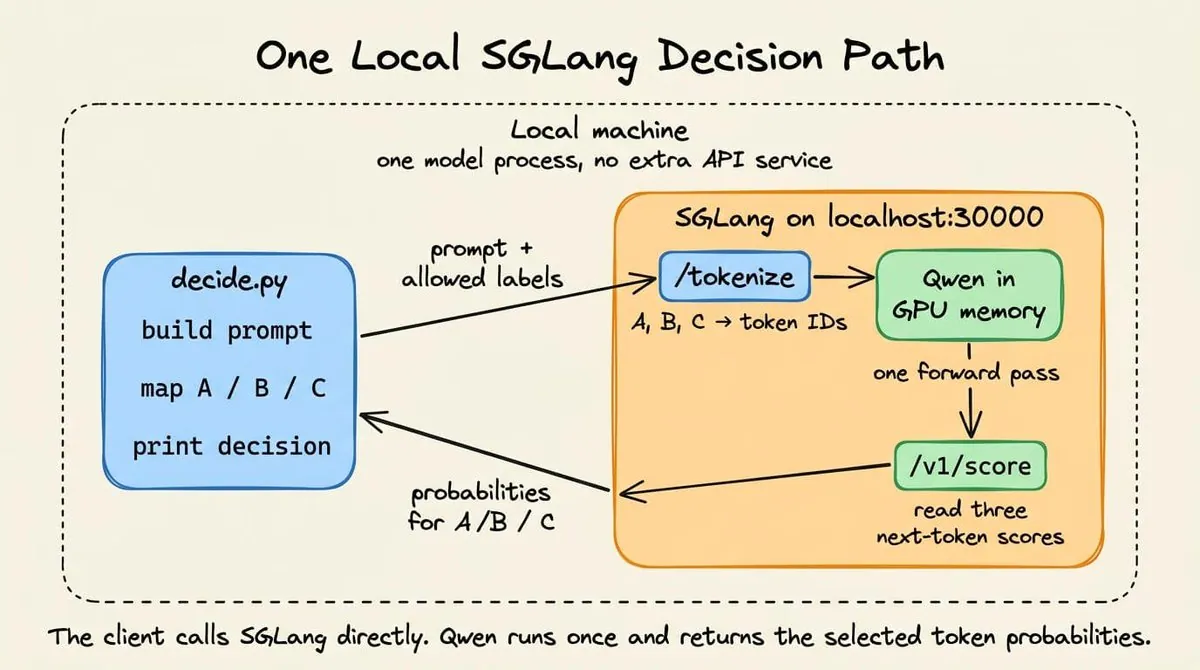
本地示例只需要一个推理服务器。SGLang 把 Qwen 载入 GPU 内存并暴露原生 HTTP 端点,我们的 Python 脚本直接与它对话。完整流程:
- 用 SGLang 启动一个 Qwen 模型。
- 把决策写成带字母标签的提示词。
- 让 SGLang 对这些标签分词。
- 向
/v1/score发一次请求。 - 把返回的概率映射回候选答案。
第 1 步:用 SGLang 启动 Qwen
创建 Python 环境并安装本文用到的两个包:
python3 -m venv .venv
source .venv/bin/activate
pip install "sglang[all]==0.5.10.post1" "requests==2.34.2"
然后启动模型服务器:
python -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-0.5B-Instruct \
  --host 127.0.0.1 \
  --port 30000
首次启动会从 Hugging Face 下载模型,之后复用本地缓存。加载完成后 Qwen 常驻内存,SGLang 监听 30000 端口。执行下面的客户端期间保持该进程运行。
第 2 步:定义候选并构建提示词
创建 decide.py,写入以下代码:
import json
import requests

BASE_URL = "http://127.0.0.1:30000"
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"

choices = {
    "A": "billing and payments",
    "B": "technical support",
    "C": "account access",
}

ticket = "I was charged twice for the same subscription."
choice_lines = "\n".join(
    f"{label} = {meaning}" for label, meaning in choices.items()
)

prompt = f"""Ticket:
{ticket}

Question:
Which category matches the ticket?

Allowed labels:
{choice_lines}

Return only the label.
Label:
"""

print(prompt)这个字典同时记录每个答案的两种表示:A 是我们打分的 token,「billing and payments」是返回给应用的语义,且两者的顺序在分词、打分、结果映射全程必须保持不变。这里产出的提示词以「Label:」结尾,我们要的是「下一个位置本应出现的 token」的得分,而不是让 SGLang 把那个 token 生成出来。
第 3 步:解析标签的 token ID
label_token_ids = []

for label in choices:
    response = requests.post(
        f"{BASE_URL}/tokenize",
        json={
            "model": MODEL,
            "prompt": label,
            "add_special_tokens": False,
        },
        timeout=30,
    )
    response.raise_for_status()
    token_ids = response.json()["tokens"]

    if len(token_ids) != 1:
        raise ValueError(
            f"{label!r} is not a single token: {token_ids}"
        )

    print(f"{label!r} -> {token_ids}")
    label_token_ids.append(token_ids[0])
SGLang 的 /tokenize 端点返回 Qwen 分词器产出的整数 ID;任何变成多个 token 的标签都会被拒绝,因为打分请求要求每个答案恰好占一个词表位置。对 Qwen/Qwen2.5-0.5B-Instruct,这段代码打印:
'A' -> [32]
'B' -> [33]
'C' -> [34]
每个列表只含一个整数,因此随后的打分请求将读取词表位置 32、33、34。这个检查也防止我们假设「分词跨模型一致」:在 Qwen 上成立的标签,换一个分词器可能被拆开。
第 4 步:向 SGLang 要三个概率
response = requests.post(
    f"{BASE_URL}/v1/score",
    json={
        "model": MODEL,
        "query": prompt,
        "items": [""],
        "label_token_ids": label_token_ids,
        "apply_softmax": True,
    },
    timeout=120,
)
response.raise_for_status()
score_response = response.json()

print(json.dumps(score_response, indent=2))
scores = score_response["scores"][0]query是完整提示词。- 空的
items条目表示对「紧随其后」的那个位置打分。 label_token_ids告诉 SGLang 从 Qwen 的词表大小输出中读哪三个条目。apply_softmax把这三个条目归一化成概率。
因为 items 只有一个条目,响应里也只有一组得分。对同一个 Qwen checkpoint 跑这条精确提示词,返回:
{
  "scores": [
    [
      0.67776233,
      0.310878605,
      0.011359035
    ]
  ]
}
按官方端点参考,每组返回的顺序与 label_token_ids 一致:第一个得分属于 A,第二个属于 B,第三个属于 C。softmax 之前选中的 logit 是 25.277620、24.498226、21.188837;不同硬件与精度设置下可能出现细微数值差异。
第 5 步:把模型标签换回决策
probabilities = {
    choices[label]: float(score)
    for label, score in zip(choices, scores, strict=True)
}

decision = max(probabilities, key=probabilities.get)

print(
    json.dumps(
        {
            "decision": decision,
            "probabilities": probabilities,
        },
        indent=2,
    )
)
在第二个终端运行脚本:
{
  "decision": "billing and payments",
  "probabilities": {
    "billing and payments": 0.6777623295783997,
    "technical support": 0.31087860465049744,
    "account access": 0.011359035037457943
  }
}
一个 SGLang 进程完成标签分词、Qwen 一次前向、返回选中概率。本例 billing 胜出,但概率只有 0.678:一条要求 0.70 的策略会把这张工单送人工复核而不是自动路由——而这个阈值应当来自带标签样本上的评测。
打分延迟 vs 自回归生成:实测
单请求示例展示机制;一个小型基准应用展示它在大量决策下的表现。
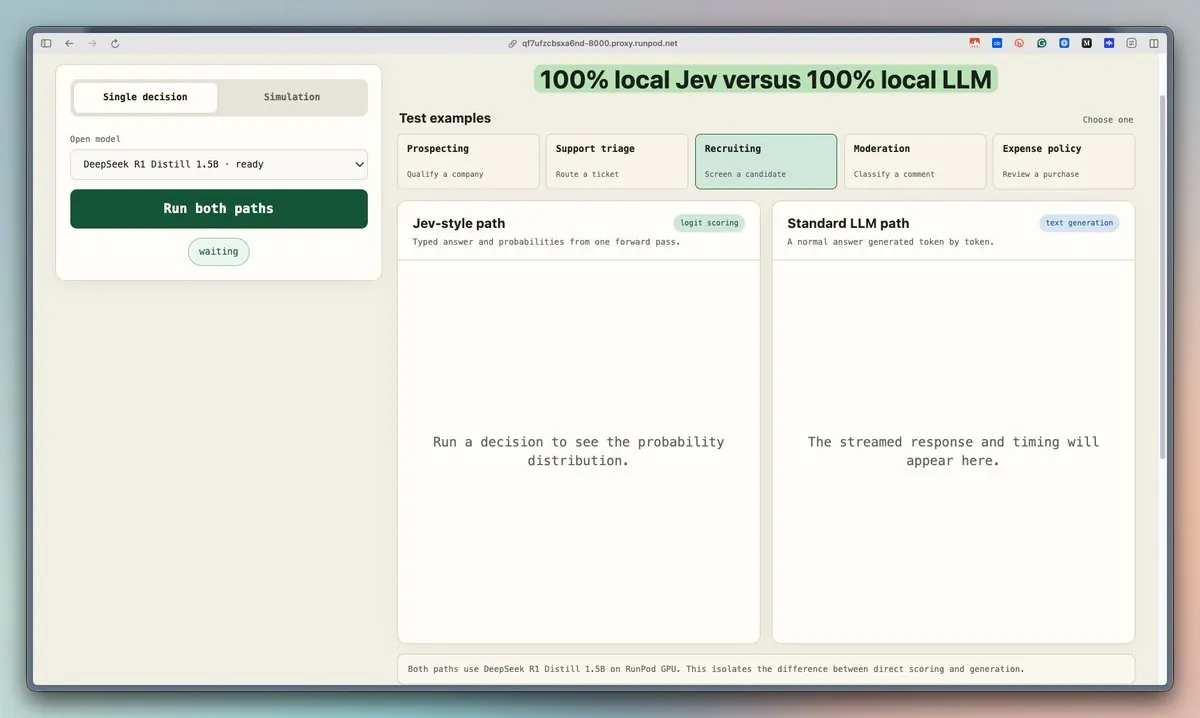
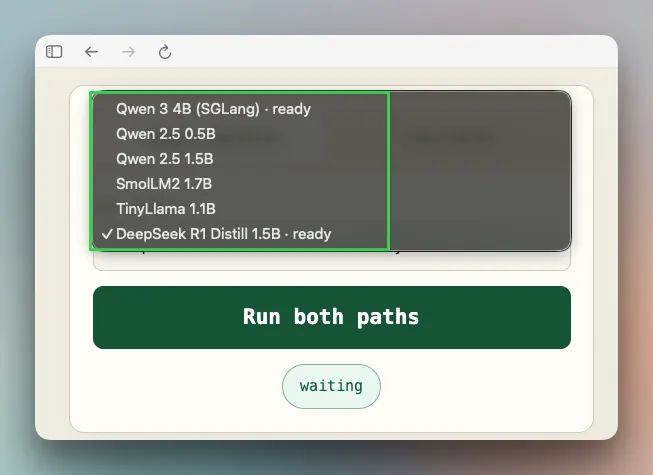
该 demo 支持多个开源模型:Qwen 3 4B、Qwen 2.5 0.5B 与 1.5B、SmolLM2 1.7B、TinyLlama 1.1B、DeepSeek-R1-Distill-Qwen 1.5B。
Jev 式泳道调用决策方法:
result = engine.decide(request)
answer = result["answers"]["decision"]
choice = answer["choice"]
probabilities = answer["probabilities"]
在 decide() 内部,SGLang 通过 /v1/score 收到提示词以及 A、B、C 的 token ID;它跑一遍提示词、读三个下一 token 得分、归一化、然后停止。响应里不含任何生成 token。标准泳道调用同一个引擎的生成方法:
result = engine.generate_response(
    case["state"],
    case["question"],
    list(case["criteria"].items()),
    max_tokens=32,
)
该方法把同样的 state、question、choices 发给 /v1/chat/completions;Qwen 生成答案加一段简短解释,最多 32 个 token。应用在前 100 个字符里搜索某个被允许的候选名,解析出的候选与存储标签一致即记为正确。
strong_fit、0 个输出 token、置信度 100.0%;生成泳道要花 1088 ms、105 个输出 token 才说出同一件事。速度差异一眼可见,原因前文已经讲过。单用例之外,基准还从固定本地数据集模拟 100 个用例;当前数据集覆盖支持路由、候选人筛选、报销审核,期望标签让界面能同时显示速度与正确率。
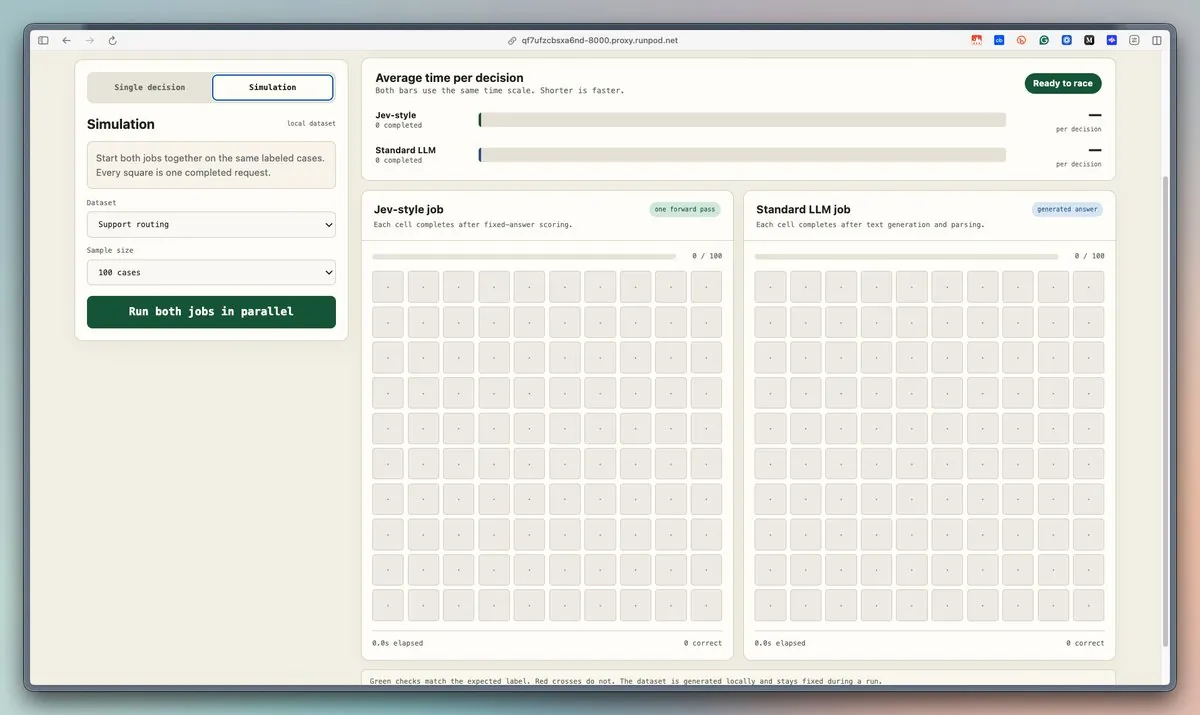
远程 SGLang 路径用一道 barrier 启动两个 worker,两条泳道同时起步,又不会把 200 个请求一次性砸向服务器:
starting_line = threading.Barrier(2)

def worker(lane, runner):
    starting_line.wait()
    for case in cases:
        updates.put(runner(case))

workers = [
    threading.Thread(target=worker, args=("jev", run_jev)),
    threading.Thread(target=worker, args=("llm", run_llm)),
]

for worker_thread in workers:
    worker_thread.start()
每条泳道按顺序处理自己的用例,上一个请求一结束就发下一个。SGLang 同时收到两条泳道的并发工作,用 continuous batching 调度;两类请求共享同一块 GPU、同一份内存带宽、同一个调度器。
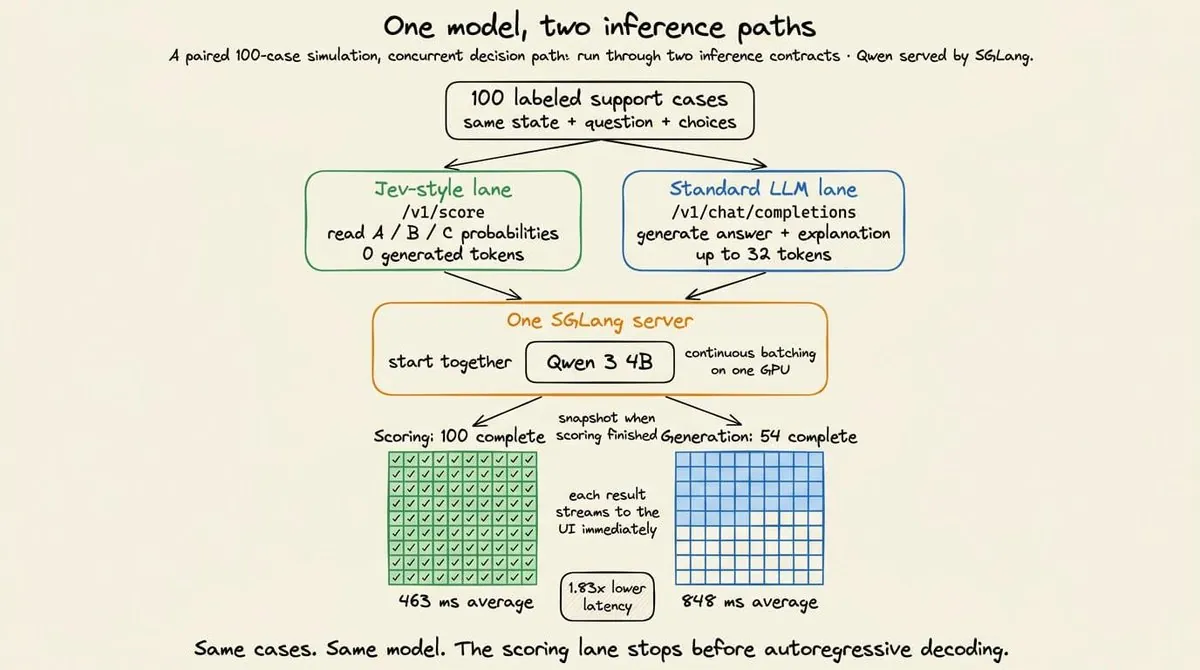
| 测量项 | Jev 式打分 | 标准生成 |
|---|---|---|
| 单用例(Qwen 3 4B,demo UI) | 6 ms,0 输出 token,置信度 100.0% | 1088 ms,105 输出 token |
| 100 用例平均延迟 | 463 ms | 848 ms(快照时 100 例中完成 54 例) |
| 每个决策的工作量 | 一次前向,读三个 logit | 最多生成 32 个 token,再解析 |
| 调用方收到什么 | 候选 + 概率分布 | 需要解析的自由文本 |
如何选择合适的路径
打分不是生成的替代品。Jev 的路子只适用于「应用在推理之前就定义了输出空间」的场景:兼容的工作负载应有一组有限且有意义的标签,每个标签对应一个明确的下游动作,且调用方只需要标签加概率分布、不需要新文本。结构化输出是另一种东西:它定义响应的语法,解码器仍要逐 token 生成字段名与取值;所以当取值无法事先枚举时用结构化生成。打分只有在候选取值已知时才能去掉解码。
一个稳妥的推进方式是按「需要的输出」选推理路径:
- 生成:输出内容在推理前未知。
- 打分:输出集合已知且「选中」就够用。第一个下一 token 向量里已经装着排序;把它返回,就省掉调用方根本不需要的自回归循环。
| 维度 | 普通 LLM 解码 | 结构化输出 | Jev 式打分 |
|---|---|---|---|
| 约束方式 | 自由生成 | 语法约束 token | 只对一个输出位置打分 |
| 解码步数 | N 步串行 | N 步受约束 | prefill 后读 1 次 logit |
| 返回内容 | 自由文本 | schema 合法对象 | 标签 + 概率分布 |
| 最适合 | 起草、解释、综合 | 取值未知的抽取 | 路由、排序、门控、分类 |
| 不适合 | 只需要一个已知标签的调用 | 固定候选的决策 | 写新文本或未知字段值 |
再强调一次:本项目复现的是 Jev 式推理机制,不是 Jev 的权重、RLCD 流程或评测栈。它们背后的训练与校准故事,是另一篇文章。
来源:Avi Chawla,《Build your own Jev (100% local)》,X 长文,2026-09-20,x.com/_avichawla/status/2101563610644496464。
原文来源:Avi Chawla (X)https://x.com/_avichawla/status/2101563610644496464