
OPEN SOURCE DEEP DIVE
一小时写成的 SuperMimic 复现:单卡 1.5 小时训练 40 段动作
一个由 AI 辅助在一小时内写成的非官方复现,以单个 GPU 约 1.5 小时训练 40 段动作;结果由作者报告,代码未审阅,数据与检查点也未随仓库发布。
先看边界:这不是论文作者发布的官方工程
SuperMimic Vibed 是一份非官方复现。作者 Chong Zhang 在说明中明确表示,项目与 SuperMimic 论文作者没有隶属关系,也没有得到论文团队的背书。目标论文是 Qiao Liao 等人提出的《SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model》。仓库围绕论文中的受控 LAFAN1 对比实验重新实现了一条完整训练链,而不是发布原作者的代码。
作者还给出了一条同样重要的警告:整个仓库是在约一小时内借助 AI 编程助手快速完成的,代码“快速、未经审阅”,作者本人不建议把它视为实验室级工程。因此,阅读这个项目的正确方式是研究一个可执行的复现假设,而不是把它当作论文结论的独立证明。页面下面会分别标记仓库直接验证到的实现、作者报告的运行结果,以及目前仍无法核验的部分。
项目是什么:用一个策略跟踪四十段动作
实验使用 Unitree G1 的 29 自由度模型和 40 段重定向到 G1 的 LAFAN1 动作。数据共有 264,705 帧,以 30 fps 记录,折合约 2.45 小时动作。训练目标不是为每段动作单独拟合控制器,而是训练一个统一策略,让机器人按当前指令跟踪不同风格的舞蹈、跳跃、格斗、跑步、冲刺和跌倒后起身动作。
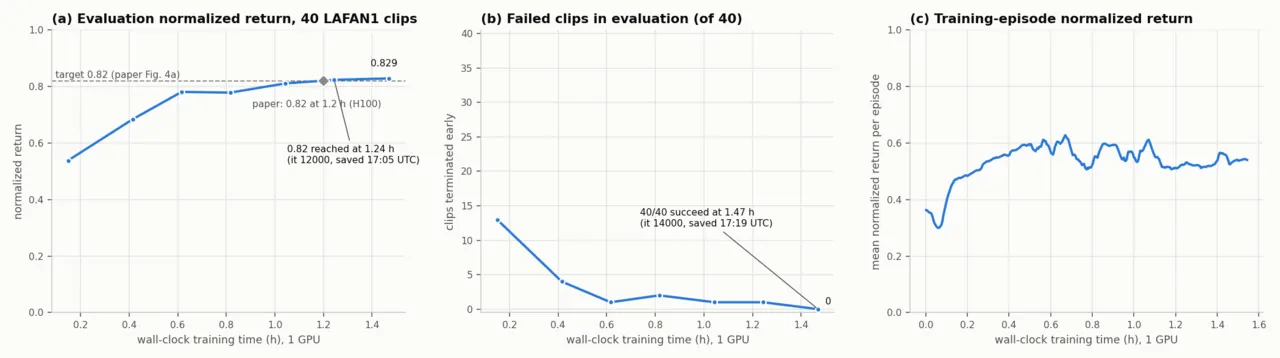
仓库给出的核心结果来自一块 RTX PRO 6000 Blackwell。训练到 1.24 小时时,40 段动作的平均归一化回报为 0.824,有 1 段失败;到 1.47 小时时,回报为 0.829,失败数为 0/40。README 同时引用了论文在 H100 上 1.2 小时达到 0.82 的结果,但这只是时间尺度上的参照。两张显卡、不同软件栈和不同评测实现不能直接组成同硬件加速比,不能据此断言复现比原论文更快。
仿真栈:Isaac Lab 3 的无 Kit 路线
项目运行在 Isaac Lab 3 main 分支的固定提交上,使用无 Kit 的容器镜像,物理后端是 Newton 与 MuJoCo-Warp,不使用 Isaac Sim、Kit 或 PhysX。控制频率为 50 Hz,每个控制周期包含 4 个 5 ms 子步,积分器设置为 implicitfast,并使用 MuJoCo 接触管线。为了减少摔倒时约束溢出,求解器把 njmax 设为 500,把 nconmax 设为 128。
G1 的关节驱动沿用 BeyondMimic 的执行器参数:自然频率 10 Hz,阻尼比 2,电机电枢计入反射惯量,动作尺度按 0.25 * effort_limit / Kp 计算。机器人自身碰撞被关闭,但机器人会通过 URDF 生成的凸包和脚部球体与地面接触。URDF 先在离线步骤中转成 MJCF,再转成 USD,原因是无 Kit 的导入器无法在 Isaac Lab 进程内正常注册 PhysX schema。
这个选择解释了项目为何能在一张显卡上跑完整闭环,也划定了一条不能忽略的边界:训练和评测都在仿真里完成,仓库没有真机实验,也没有把策略迁移到实体 G1 的证据。
动作管线:从 30 Hz 数据到 50 Hz 目标
supermimic/motion.py 读取每段 CSV 中的骨盆位置、四元数和 29 个关节角。位置和关节角采用线性插值,四元数采用球面插值,从 30 Hz 重采样到 50 Hz。位置与关节速度用中心差分计算,首尾帧改用单边差分;角速度则通过相邻旋转矩阵的相对旋转求取。
每个未来目标包含 73 个数值:相对当前位置的局部平移、相对当前朝向的六维旋转、局部线速度、局部角速度、29 个关节位置,以及缩放后的 29 个关节速度。策略一次读取未来 10 帧,因此目标向量为 730 维。参考动作被切成约 1 秒一段的重置区间,训练可以从动作中段恢复,而不是永远只从第一帧开始。
奖励比较 14 个身体部位:骨盆、左右髋滚转、膝关节、踝滚转、躯干、肩滚转、肘关节和腕偏航。跟踪项包含身体位置、朝向、线速度、角速度、根节点位置和根节点朝向,再叠加动作变化率惩罚与关节软限位惩罚。终止条件为骨盆高度误差超过 0.25 米,或倾斜指标超过 0.8。
可微世界模型预测的是局部增量
世界模型不是直接重建下一帧的绝对状态,而是预测 71 维状态的帧间增量。输入由位置与朝向不变量、当前动作的 29 维向量,以及 33 维环境上下文组成。这里的上下文包括摩擦系数、29 个关节偏置和躯干质心偏移。网络为三层 2048 宽的全连接 MLP,激活函数是 SiLU,每层带 LayerNorm。输出层初始化为零,使训练初期世界模型近似不改变输入状态。
由于输入去掉了全局位置和整机朝向,模型学习的是机器人局部动力学,而不是记某段动作在全局坐标中的轨迹。预测增量再通过当前朝向变换回全局位置,并用旋转指数映射更新姿态。模型的训练样本不是单步转移,而是从回放中取 8 步自回归窗口,把 8 次预测的误差联合反传。每个数组件的误差会按滑动统计量归一化,并设置下限,避免小误差维度被异常放大。
这套设计和论文的“可微世界模型”叙事一致:策略不需要通过传统仿真器反向传播,只需要在这个局部动力学模型里完成 32 步想象。奖励、观测和终止在想象中仍由解析函数给出,所以可微性主要来自状态转移链,而不是把整个仿真器变成神经网络。
训练循环:真实仿真采样,想象空间优化
默认配置同时启动 4096 个环境,回放缓冲保存每个环境 1000 步。每轮迭代默认收集 2.5 个向量化仿真步,对应 UTD 0.4;然后做 10 次世界模型更新,每次采样 2048 个、长度 8 的窗口。强化学习部分只取 4096 条合法起点,在想象中展开 32 步,再对策略做一次反向传播。前 500 轮只训练世界模型,策略更新在模型具备基本预测能力后才开始。
策略采用非对称的编码器和解码器。动作目标编码器把 730 维未来动作压成 32 维、经 tanh 限制的潜在表示,网络宽度依次为 2048、1024、512、256。解码器接收潜在表示与最近 10 帧本体感觉观测,输出 29 维动作。实现中的观测包括关节位置误差、关节速度、机体角速度、投影重力、上一时刻动作,以及相对参考骨盆朝向的六维旋转。没有全局位置输入。
评论家使用维数为 256 和 128 的两层 MLP,输入含当前不变量、目标、环境上下文与机器人相对参考的误差。每批想象轨迹使用 GAE,折扣因子 0.99,lambda 0.95,评论家训练 5 个 epoch、4 个 minibatch。策略目标把解析奖励与终止后的评论家 bootstrap 组合在一起,使 32 步想象在第 32 步以外仍有价值估计。
优化器为 Adam,学习率 2e-4,策略的 beta 为 0.9 和 0.95。学习率按余弦曲线在 25 万轮内衰减到初始值的 3%。策略梯度全局范数裁剪到 1.0,并额外把每个元素裁剪到 0.1。缓存与观测历史都跟着回合重置,世界模型采样窗口也会屏蔽已经结束的转移。
重置课程与域随机化
训练并不会均匀地从动作开头起步。每段动作按 1 秒区间分箱,起点按三个来源混合抽取:50% 均匀采样、40% 偏向低回报区间的 softmax、10% 根据历史成功率变化的 softmax。环境每完成一次回合,会用新的折扣回报更新对应起点的估计。这样的设计更常回到失败和难学片段,目标是减少后期动作、起身和跳跃这类稀疏难点被简单片段淹没。
摩擦系数在 0.3 到 1.2 之间,每个环境只采样一次。躯干质心在三个轴向上有小幅随机偏移,同样在启动时写入仿真模型。29 个关节偏置在每次回合重置时重新采样到正负 0.01 弧度。动作加噪标准差为 0.1。观测噪声、重置状态噪声和关节限位裁剪都单独实现。由于摩擦和质心并不逐回合重采样,这里的域随机化范围不能和完整 episode-level 随机化直接等同。
评测协议与作者报告结果
评测器为每段动作分配一个环境,从第一帧起步,只播放一次。摩擦固定为 1.0,不使用域随机化、动作噪声、观测噪声或重置噪声,策略也切换到确定性模式。由于只测试每个动作的首帧起步,而训练大量从动作中段恢复,评测覆盖了动作开头,却不覆盖“从中途恢复后能否完成余下片段”的另一面。
“失败”被定义为触发训练终止条件,而终止条件只看骨盆高度误差和倾斜,不看任务是否完成、动作风格是否足够自然。归一化回报则把未折扣奖励和除以动作理论最大回报。该指标适合比较同一套奖励实现下的检查点,但不能单独说明真机稳定性、能耗、冲击或接触质量。项目也没有公开逐动作 JSON,因此只能看到汇总值和作者绘制的曲线。
按照里程碑记录,首个检查点在 0.15 小时得到 0.541 和 12 段失败;0.62 小时升到 0.781 和 1 段失败;0.82 小时短暂回落到 0.779;1.04 小时达到 0.811;1.24 小时为 0.824;1.47 小时为 0.829 并实现 40 段全部不触发终止。上述轨迹可以帮助理解训练是否稳定,但它仍然来自作者单次运行说明,而非可重新计算的原始 CSV。
相对论文实现,哪些地方是作者自己的选择
仓库并没有假装所有细节都与论文一致。README 列出了多处有意的工程偏差:关闭自碰撞以换取速度;MLP 矩阵乘使用 bf16,而论文报告使用 TF32;奖励、观测和终止头保持解析实现;想象 rollout 中使用平滑终止概率;在策略更新前加入 500 轮世界模型预热;模型转换放在仿真进程之外。状态积分、正运动学、奖励和终止仍保持 fp32,bf16 只覆盖神经网络矩阵乘。
这些选择会改变结果的可比性。关闭自碰撞会让摔倒、接触和起身更简单;bf16 可能影响数值稳定性;解析终止比学习式终止更可控,却不是同一种模型规模。它们并不意味着结果无效,但读者不能把 0.829 当成论文表格中某个完全同配置数字的等价复现。更准确的结论是:在这套独立实现和这组工程选择下,作者报告了一个快速达到相近回报的运行。
证据链目前缺什么
仓库包含训练代码、评测代码、世界模型、策略、动作处理和一条运动目标边界测试,也提交了成功曲线与高亮 GIF。问题在于最重要的原始证据没有一起发布:没有 logs/<run>/train_log.csv,没有 eval.csv,没有 checkpoint,没有 traj.npz,也没有完整渲染视频。代码能解释数字如何产生,但外部读者无法从这些提交文件重算出 0.824 或 0.829。
测试覆盖也比较有限。当前仓库没有随附 Isaac Lab 与数据,无法在普通环境直接运行;真正可独立执行的轻量测试主要是动作目标边界回归。其余“测试”更多是环境检查、生成检查、基准或可视化的启动脚本。tools/test_motion_goal.py 不是一次性摆件;它明确覆盖了动作结束后未来目标应保持末端姿态,并且只有补出来的合成速度应为零。这项设计修正已经进入当前提交。
此外,项目只在 RTX PRO 6000 Blackwell、驱动 580、CUDA 13 的一组环境中报告了完整训练。作者称论文项目页当时尚未释出官方代码,因此这里的模块划分和数据格式都是根据论文与 BeyondMimic 生态推断出来的。缺少第二套硬件、第二个人独立运行和官方实现对照时,应把它视为有价值的复现线索,而不是已经完成的第三方复现认证。
为什么它仍值得研究
这个项目最有价值的地方不是“一小时写代码”的叙事,而是把一项昂贵的 GPU 训练拆成了可检查的流水线:真实仿真只负责产生短转移,世界模型负责学习局部动力学,策略在高比例模型更新中反复优化,评论家在想象轨迹上估计长期价值。对一个需要 40 段动作、4096 个环境和数千次网络更新的实验来说,1.5 个 GPU 小时如果可以被独立复算,会显著降低研究迭代门槛。
它也给出了一份很有用的“复现所需最小系统”清单:动作重采样、14 个跟踪点、执行器标定、状态不变量、环境上下文、终止与奖励、起点课程、模型预热和确定性评测,任何一环缺失都可能让曲线失去意义。作者把这些边界写得比很多演示仓库更清楚,并主动标出未审阅与未验证部分,这也是当前证据下最可信的贡献。
如果要把这份作者报告升级为可重复实验,下一步需要固定代码快照与容器摘要,发布评估 CSV、检查点和轨迹,再用相同动作集重跑一次,并至少补一组消融:去掉低回报重置课程、关闭环境上下文、把想象长度从 32 缩短。只有这些证据齐备后,才能更可靠地回答“节省的是算法效率,还是特定仿真器与硬件组合带来的吞吐优势”。
适用人群与使用建议
它适合已经熟悉 Isaac Lab、强化学习训练循环和人形机器人动作跟踪的研究者,用来学习 SuperMimic 的一条可能实现路线,或作为小规模 GPU 实验的起点。它不适合直接用于生产控制,也不应在没有安全评估的情况下搬到实体机器人。第一轮使用应从代码审计、数据许可确认和固定随机种子的单动作检查开始,再逐步放大环境数,而不是先假定 README 中的时间与回报会原样出现。
许可同样需要分层理解。仓库代码使用 MIT,但 LAFAN1 动作数据来自 Ubisoft La Forge,采用 CC BY-NC-ND 4.0;G1 描述文件采用 BSD-3-Clause。演示 GIF 展示的是参考动作,不能因为代码仓库采用 MIT 就默认整段演示和底层动作数据都能商用或二次改编。部署、训练数据再分发和商业使用前应分别核对代码、模型描述、动作数据与渲染素材的条款。
结论
SuperMimic Vibed 是一份边界说明清楚、实现链路完整、证据却仍停留在作者报告阶段的快速复现。它把“用可微世界模型扩展人形全身控制训练”变成了可以阅读和运行的具体代码,也报告了一个 1.47 小时、单卡、40 段动作全部通过的亮眼结果。但在检查点、训练日志和独立重跑缺席之前,最有根据的判断是:这是一个值得审计与复测的高潜力实现,而不是已经被独立验证的论文结论。