PAPER DEEP DIVE
SSTG-Nav:面向可复用物体导航的度量接地空间语义拓扑图
服务机器人在同一住宅或设施中长期工作时,不应为每次请求重新探索熟悉空间。SSTG-Nav 把一次与目标无关的环境巡检转化为持久度量语义拓扑:最远点采样建图(6,642 节点/21,845 边,覆盖半径 0.8 米),视图级 VLM 检测经深度反投影与 0.8 米 standoff 接地为可达停点位,源感知 noisy-OR 融合跨视角合并证据并保留残差 standoff 用于恢复。在 HM3D-v2 全验证集 1,000 个 episode 上,目标无关拓扑的几何成功上限达 99.4%;固定语义响应下度量接地把 SR/SPL 从 0.835/0.560 提升到 0.920/0.603,融合达 0.926/0.586,融合感知 Top-3 恢复达 0.975/0.601,并以 ROS 2/Nav2 真机闭环验证了查询到执行的完整链路。
论文元信息
标题:SSTG-Nav: Metric-Grounded Spatial-Semantic Topological Graphs for Reusable Object Navigation(SSTG-Nav:面向可复用物体导航的度量接地空间语义拓扑图)
作者:Daojie Peng(香港科技大学广州分校)、Bingtao Wang(山东大学)、Jun Ma(香港科技大学,通讯作者)
链接:arXiv:2608.00527(https://arxiv.org/abs/2608.00527 ,v1,2026 年 8 月 1 日,主分类 cs.RO);项目主页 https://daojiepeng.github.io/SSTG-Nav
代码与数据状态:基准实现已开源,仓库 https://github.com/DaojiePENG/sstg-nav-bench ,包含建图、RGB-D 接地、融合、检索、恢复与评测全链路脚本及单元测试,属于「已发布」状态;评测使用 HM3D-Semantics v0.2 的 ObjectNav 验证集(1,000 个 episode、36 个场景)。
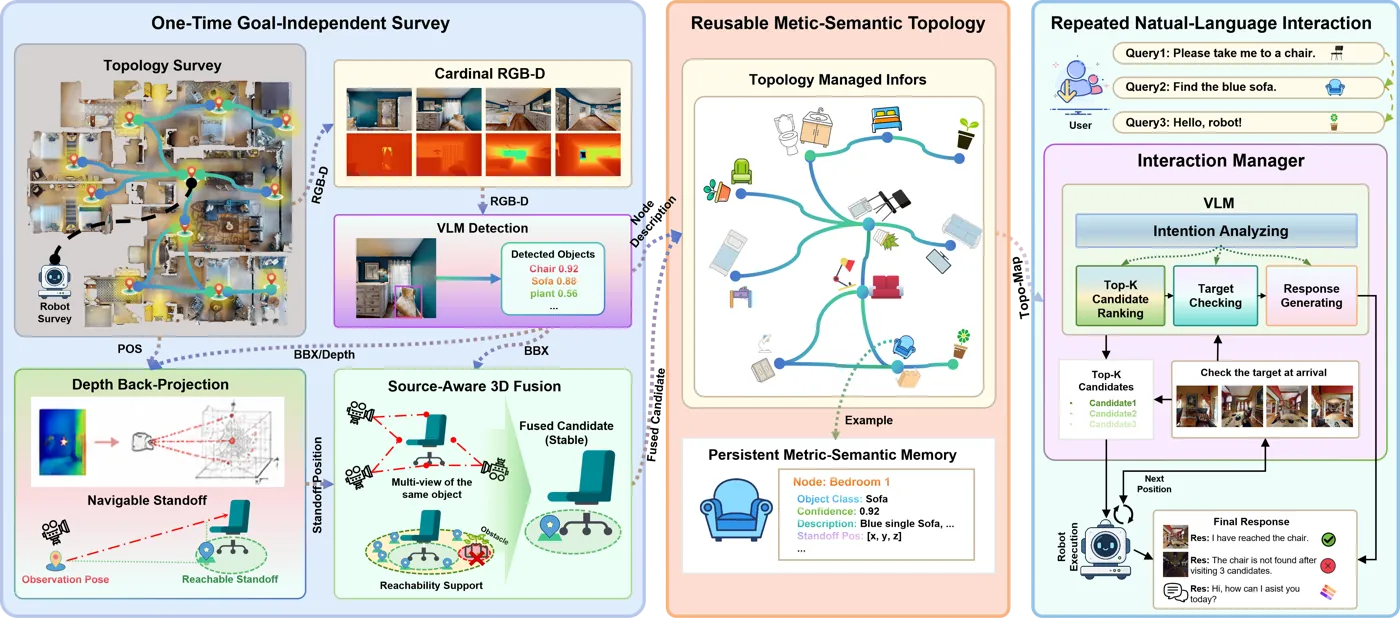
图1:SSTG-Nav 把一次与目标无关的环境巡检转化为持久度量语义拓扑,支撑重复的自然语言导航请求(论文 Figure 1)。左侧为巡检与 RGB-D 接地,中间为拓扑管理索引与持久度量语义记忆,右侧为交互管理器驱动的检索、排序、恢复与到达验证闭环。
一句话总结
本文把物体目标导航(ObjectNav)从「每来一个请求就重新探索一次」改写为「一次巡检、终身复用」:用与任务无关的最远点采样拓扑承载视图级 VLM 检测,经深度反投影与 0.8 米 standoff 接地把「认出物体」变成「可到达的停点位」,再用源感知 noisy-OR 融合与保留残差 standoff 的双层记忆,把 HM3D-v2 全验证集上的一次成功率推到 0.926、Top-3 成功率推到 0.975。
研究背景与动机
ObjectNav 要求具身智能体走到被请求类别的某个实例旁,并在合法位置宣告 STOP。主流基准刻意让智能体从未知场景出发,语义探索、视觉语言前沿地图、常识约束、在线场景图与拓扑记忆等路线在这一设定下已把成功率推得很高。但服务机器人的真实工况恰恰相反:同一套住宅、办公室或护理设施会被重复访问数百次,每次请求都重新做完整探索,既浪费先前感知投入,也让任务完成时间不可预测。
论文由此提出一个被忽视的区分:可复用设定下的目标不是单 episode 的探索效率,而是机器人整个生命周期内的可靠完成率。持久地图可以摊销昂贵感知、立即响应后续语言查询、为歧义物体保留多个假设、并在候选被拒绝后无需重启搜索即可恢复。作者把这一设定命名为 reusable ObjectNav,并将其与 unknown-scene 设定并列为两种操作域(operating regime)。
可复用设定真正的科学难点在于让记忆「可执行」。相机可能隔着门洞、越过栏杆、或从家具背面认出物体,但相机位姿本身往往是一个糟糕的导航目标:它可能不可达、可能停在物体错误的一侧、也可能距离过远无法宣告成功。论文把这一现象称为观察位姿与 STOP 位姿的错配(observation-pose / STOP-pose mismatch),并指出它正是复用地图与可执行目标之间的鸿沟。
第二个难点是证据的独立性。同一物体常被相邻节点反复观测,若把同一帧内的重复检测框当作多次确认,置信度会被虚假抬高;反之,若只保留单一代表点,又会在主假设被拒绝时丢失所有备选停靠几何。论文用「源感知融合 + 残差 standoff 保留」同时处理这两个方向。
第三个难点是评测的信息边界。若建图时使用了官方目标视点,地图里就已经预置了成功 STOP 配置,成功率会被系统性高估。论文因此设计三套协议,把「目标视点覆盖」「目标无关几何 + oracle 语义」「目标无关几何 + 真实 VLM 语义」严格分开,使每一分增益都能归因到几何、语义或表示设计上。
预备知识
评测遵循 Habitat 2023 导航挑战赛的 ObjectNav 协议:对 episode $e$,设请求类别为 $c_e$、官方最短路径长为 $\ell_e$、该场景该类别的合法目标视点集合为 $\mathcal{Y}_{c_e}$,选中候选 $\hat{\mathbf{s}}_e$ 的成功判据为到最近合法视点的测地距离不超过 1 米:
$$S_e=\mathbf{1}\!\left[\min_{\mathbf{y}\in\mathcal{Y}_{c_e}}d_{\mathrm{geo}}(\hat{\mathbf{s}}_e,\mathbf{y})\leq 1\,\mathrm{m}\right]$$路径效率用 SPL 衡量,$ \mathrm{SPL}_e=S_e\,\ell_e/\max(\ell_e,p_e) $,其中 $p_e$ 为实际执行路径长;DTG 为最终位置到最近合法视点的测地距离。这套指标只关心「停得对不对、走得省不省」,不关心中间表示,因此表示设计的优劣必须靠受控消融来归因。
三套协议的信息边界是理解全文实验的钥匙。Target-view coverage 为每个标注实例选一个高 IoU 的官方可导航视点采集四视角图像,它度量「覆盖受控」下的语义检索上限,本身不可部署;Independent oracle 用与目标无关的采样建图,但语义标签由评测器事后按官方目标集合赋予,隔离几何覆盖的贡献;Independent real 是主协议,episode 起点、类别、物体标注与合法视点在建图、采集、VLM 推理、投影、融合与检索全程不可见,只在候选选定后进入评分。
方法详解
5.1 目标无关的空间拓扑
对每个场景,论文用固定种子从 navmesh 可导航空间抽取 12,000 个候选点,再做贪心最远点采样:从最靠近池质心的点出发,反复加入距已选集合最远的点,直到每个池点都被 0.8 米内的已选节点覆盖。全验证集 36 个场景共得 6,642 个节点、21,845 条边,单场景节点数从 74 到 399 不等——采样以覆盖半径为停止条件而非固定节点数,因此紧凑公寓与大型住宅共用同一条规则。边连接最多八个欧氏近邻,且要求 navmesh 路径存在、欧氏距离不超过 2.4 米、测地长度不超过 3.84 米。采样、采集、推理与融合全程不读取任何 episode 字段。
每个节点存储四个正交方位的 RGB-D 视图(yaw 偏移 0°/90°/180°/270°),相机高度 1.25 米。论文刻意逐视图送 VLM,而不是拼接全景图让模型定位:全景坐标语义含糊,且会破坏各视图各自的相机模型。每次检测返回四元组 $d=(c,b,q,k)$:类别、归一化框、置信度与视图索引。
5.2 从检测到可导航候选:度量接地
给定检测框中心 $\tilde{\mathbf{u}}$ 与框内 $7\times 7$ 补丁的有效深度中位数 $z$(接受区间 0.2-6.0 米),用内参 $K$ 与相机到世界变换 $T_{wk}$ 反投影出物体表面点:
$$\hat{\mathbf{o}}_{d}=T_{wk}\left(zK^{-1}[\tilde{\mathbf{u}}^{\top},1]^{\top}\right)$$展开到像素坐标即补充材料式 (5)(6):$x_c=2(u-0.5)\,z\tan(\phi_h/2)$、$y_c=-2(v-0.5)\,z\tan(\phi_v/2)$、$z_c=-z$,其中垂直视场角由 $\phi_v=2\tan^{-1}\!\left(\frac{H}{W}\tan\frac{\phi_h}{2}\right)$ 给出。标准相机为 640×360、水平 90°,垂直约 59°;宽相机为 640×640、双向 120°。这一步只把深度当几何用,语义置信度仍完全来自 VLM。
观察位姿往往不可停靠,论文于是把表面点沿地面向源相机方向平移 $\rho=0.8$ 米,得到 standoff 停点位:
$$\mathbf{s}^{*}_{d}=\hat{\mathbf{o}}_{d}+\rho\,\frac{\Pi(\mathbf{p}_{i}-\hat{\mathbf{o}}_{d})}{\|\Pi(\mathbf{p}_{i}-\hat{\mathbf{o}}_{d})\|_{2}}$$其中 $\Pi$ 丢弃竖直分量。随后把 $\mathbf{s}^{*}_{d}$ 吸附到 navmesh 可导航空间,并丢弃从源节点不可达的候选。图2 展示了一次被审计的沙发观测:视图级检测框索引对齐深度,表面点中位数反投影后被平移到 0.8 米 standoff,整个构造不使用任何 ObjectNav 目标信息。源码中这一链条对应 sstg_bench/rgbd_fusion.py 的 project() 与 candidate_from_detection():前者按 Habitat 约定(+X 右、+Y 上、−Z 前、传感器高 1.25 米)做坐标变换,后者执行 standoff 平移、snap_point 吸附与最短路径可达性检查,不可达即返回 None。
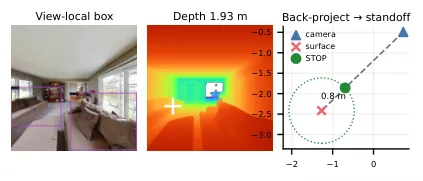
图2:一次被审计的沙发观测。视图级 VLM 框索引对齐深度,表面点中位数被反投影并向源相机平移 0.8 米得到可达 standoff(论文 Figure 2)。
5.3 可达性感知的软融合与双层记忆
同类检测只有在物体估计水平距离不超过 $r_o=1.2$ 米、竖直差不超过 $r_h=1.0$ 米、且各自 STOP 候选之间测地距离不超过 $r_g=3.0$ 米时才聚为一簇。第三个条件不可或缺:仅凭欧氏邻近会把隔墙两侧、或不同楼层互不连通的观测错误合并。簇内同一源节点的重复框只取其最大置信度,再以独立观测节点为单元做 noisy-OR:
$$Q(C)=1-\prod_{i\in U(C)}\left(1-\max_{d\in C_{i}}q_{d}\right)$$其中 $U(C)$ 为独立观测节点集合。全验证集地图上,簇至少需要两个独立源节点支持,或单源置信度不低于 0.92 才保留;minival 的表示对照保留全部有效簇,以免类别稀缺与过滤策略混淆。融合把 20,107 个有效深度候选压缩到 1,329 个代表点,压缩率 93.4%。
论文存储两层互链记忆:$\mathcal{H}^{F}$ 每簇一个带 $Q$ 分数的代表 standoff,用于稳定的主排序;$\mathcal{H}^{R}$ 保留全部融合前的可达 standoff 及其视图级置信度,用于恢复。源码 sstg_bench/rgbd_fusion.py 中,source_confidence 字典先按源节点取 max 再连乘,注释明确写着「独立观测提升置信度,但不允许同帧重复框抬高支持度」;每个被保留簇的成员还会以 multi_standoff 形式整体落盘,使查询期 Top-K 能在保持融合语义分数的同时选择不同的可达停点位。
5.4 到达验证:用新鲜 RGB-D 决定 STOP
部署闭环从不读取目标集合。机器人到达候选 $k$ 后采集四张新鲜 120° RGB-D 视图:第 0 张正对存储的物体估计,其余三张依次旋转 90°。VLM 收到这四张图与建图期带框参考图,返回目标可见性、停靠侧判定 $g_k$、到达视图框与置信度 $q_k$;框中央半区索引对齐深度得中位数 $z_k$。接受 STOP 的条件为:
$$A_k=\mathbf{1}\!\left[\mathrm{visible}_k\wedge g_k=\mathrm{valid}\wedge q_k\geq 0.75\wedge 0.25\,\mathrm{m}\leq z_k\leq 2.5\,\mathrm{m}\right]$$被拒绝时,规划从当前位姿继续前往下一个空间相异的候选,而非重启 episode。全验证集 1,000 个 raw-list episode 共引用 656 个唯一候选、产生 2,624 张新鲜视图,验证请求 656/656 全部完成,单候选平均延迟 20.52 秒。
5.5 可复用查询与执行层
语言归一化器把查询 $q$ 映射为类别 $c(q)$,候选集合为 $\mathcal{C}(q)=\{i:c_i=c(q),\ \mathbf{s}_i\text{ reachable from }\mathbf{x}_0\}$,即类别匹配且从起点可达的融合主候选。排序采用字典序置换:
$$\boldsymbol{\pi}_q=\operatorname{LexSort}_{i\in\mathcal{C}(q)}\left(-Q_i,\ d_{\mathcal{G}}(\mathbf{x}_0,\mathbf{s}_i)\right)$$语义支持度为主键、路径长为确定性次键。这一选择防止「近但无支持」的单源观测压过「远但被多视角佐证」的证据,同时避免引入学习型查询策略。第一访问取 $\pi_q(1)$;至多两次后续访问从类别匹配的残差集 $\mathcal{R}(q)\subset\mathcal{H}^{R}$ 中按置信度与路径长选取,并强制与先前访问保持 $\|\mathbf{s}_i-\mathbf{s}_{\pi_q(j)}\|_2\geq 2$ 米分离;若 $\mathcal{C}(q)$ 为空,则最佳可达残差直接成为第一访问。
执行是 receding candidate sequence:第 $k$ 段为 $P_k=\operatorname{ShortestPath}(\mathcal{G},\mathbf{x}_{k-1},\mathbf{s}_{\pi_q(k)})$,$\mathbf{x}_k=\mathbf{s}_{\pi_q(k)}$,实际路径为 $P(q)=P_1\oplus\cdots\oplus P_\tau$,$\tau=\min\{k:A_k=1\}$。排序代价 $O(m_c\log m_c)$,每次图搜索 $O(|\mathcal{E}|+|\mathcal{V}|\log|\mathcal{V}|)$;若一次巡检服务 $N$ 个请求,摊销后的非运动成本为
$$\bar{C}_N=C_{\mathrm{map}}/N+C_{\mathrm{retrieve}}+C_{\mathrm{plan}}$$即 VLM 推理与深度接地只付一次,后续请求只做检索、图搜索与新鲜到达验证。源码 sstg_bench/topk.py 的 diverse_candidates() 以贪心方式跳过与已选候选距离小于 min_separation 的节点,hierarchical_candidates() 则实现「先主代表、后残差」的分层取候选;排序键 (-score, distance) 正是式 (7) 的实现。
flowchart TB
  subgraph SURVEY["One-time goal-independent survey"]
    A[FPS topology 6642 nodes
21845 edges, cover radius 0.8 m] --> B[4 cardinal RGB-D views per node]
    B --> C[View-local VLM detection
category, box, confidence, view index]
    C --> D[7x7 patch median depth]
    D --> E[Back-project surface point Eq.2]
    E --> F[0.8 m standoff Eq.3
navmesh snap + reachability test]
  end
  subgraph FUSE["Source-aware fusion"]
    F --> G[Cluster by 1.2 m horizontal
1.0 m vertical, 3.0 m geodesic]
    G --> H[Noisy-OR over unique sources Eq.4]
    H --> I[H^F one representative per cluster]
    H --> J[H^R all residual standoffs]
  end
  subgraph QUERY["Repeated natural-language query loop"]
    K[Query normalized to category] --> L[LexSort by -Q then path length Eq.7]
    I --> L
    L --> M[Leg k: graph shortest path Eq.8]
    M --> N[Fresh 4-view RGB-D arrival check Eq.5]
    N -->|accept: q at least 0.75, depth 0.25-2.5 m| O[STOP and report completion]
    N -->|reject| P[Next residual at least 2 m apart]
    J --> P
    P --> M
  end
图3(示意):按论文 Algorithm 1 与第 3.4 节绘制的 SSTG-Nav 数据流。巡检层只付一次感知成本,融合层产出双层记忆,查询层以 receding horizon 方式逐候选执行并在到达处用新鲜 RGB-D 裁决。
实验结果
主实验在 HM3D-Semantics v0.2 的 1,000 个验证 episode(36 场景、六类:chair、bed、plant、toilet、TV/monitor、sofa)上进行,主语义后端为 GPT-5.4,MiMo-v2.5 与本地 Qwen2.5-VL-3B 作为模型对照;表示与模型消融在 30 episode、两场景的 minival 子集与 339 节点图上进行。表1 给出跨操作域的对照:unknown-scene 设定下最强的 ConsistNav 为 0.842/0.412,而 SSTG-Nav 单融合目标即达 0.926/0.586,融合感知 Top-3 达 0.975/0.601,分别高出 0.133 SR 与 0.122 SPL。需要强调的是这一对比跨越了操作域:复用地图的感知成本被摊销到重复请求上,论文用式 (9) 的摊销成本公式把这一差异显式化,而非假装同场竞技。
| 方法 | 起始场景状态 | 评测集 | 策略 | SR | SPL |
|---|---|---|---|---|---|
| ConsistNav | unknown | HM3D-v2 | TF | 0.842 | 0.412 |
| IntentNav | unknown | HM3D-v2 | learned | 0.822 | 0.385 |
| TrajRAG | unknown | HM3D-v2 | TF | 0.781 | 0.402 |
| FOM-Nav | unknown | HM3D-v2 | learned | 0.758 | 0.479 |
| CARe+VLMaps | pre-explored | custom MP3D | TF | 0.827† | – |
| SSTG-Nav 单融合目标 | pre-explored | HM3D-v2 | TF | 0.926 | 0.586 |
| SSTG-Nav 融合感知 Top-3 | pre-explored | HM3D-v2 | TF | 0.975 | 0.601 |
表1:跨操作域对照(论文 Table 2 摘要)。† 为 CARe 自报的 MP3D 自定义成功指标,不可直接横向比较。
覆盖与语义的分解实验(论文 Table 3)说明增益来自哪里。目标视点 + oracle 语义得 0.990/0.802,说明特权覆盖下仍非满分;目标视点 + 真实 Qwen 语义只有 0.644/0.438,把 0.346 的差距完全归因于语义检索;目标无关拓扑 + oracle 语义达 0.994/0.992,证明 0.8 米最远点采样几乎覆盖了全部成功区域;目标无关 + GPT-5.4 融合得 0.926/0.586。结论清晰:几何覆盖已接近天花板,剩余瓶颈在语义接地与 STOP 位放置,而非地图密度。
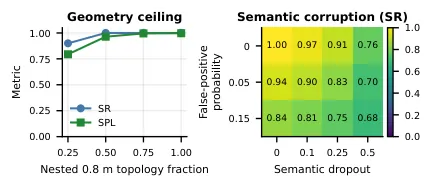
图4:几何密度先饱和、语义可靠性仍脆弱(论文 Figure 3)。左:oracle 语义下嵌套的 0.25/0.50/0.75/1.00 拓扑比例(约 85/170/255/339 节点)的 SR/SPL;右:20 个种子平均的标签腐蚀网格,列为 dropout 概率、色标为假阳性概率。
图4 左半进一步显示,minival 上 50% 密度(约 170 节点)即让 oracle SR 饱和到 1.000,而右半的语义腐蚀实验中 25% 标签 dropout 就把均值 SR 打到 0.907、50% dropout 打到 0.763、15% 假阳性打到 0.840,三者叠加最坏到 0.602——几何早饱和、语义仍脆弱,是全文最有信息量的一组对照。
| 地图协议 | 语义来源 | 节点数 | SR | SPL | DTG |
|---|---|---|---|---|---|
| Target-view | Oracle | 1,168 | 0.990 | 0.802 | 0.073 |
| Target-view | Qwen | 1,168 | 0.644 | 0.438 | 2.016 |
| Independent | Oracle | 6,642 | 0.994 | 0.992 | 0.622 |
| Independent | GPT-5.4 融合 | 6,642 | 0.926 | 0.586 | 0.747 |
表2:覆盖—语义分解(论文 Table 3)。Target-view 地图的采集位姿由目标视点导出,Independent 地图则完全与目标无关。
固定语义响应下的累积消融(论文 Table 4)给每个组件定价。相机节点基线 0.835/0.560;加入度量接地后升至 0.920/0.603,配对 McNemar 检验 93 胜 8 负、$p=1.74\times10^{-19}$,是全文最大且最显著的单步增益——它不改变任何语义预测,只是把目标从观察位姿搬到可达 standoff;加入源感知融合后 SR 微升至 0.926 但 SPL 降到 0.586(28 胜 22 负、$p=0.480$),说明融合在全尺度上的价值主要是候选压缩与排序稳定,而非净成功率;加入残差恢复后 Top-3 达 0.975/0.601。表3 的序列恢复消融进一步区分恢复策略:只用融合代表的 Top-3 饱和在 0.964,而「一个主代表 + 两个 2 米分离残差」达 0.975,配对比较 11 胜 0 负(9 个沙发、2 个床),说明恢复的收益来自保留被融合压掉的备选停靠几何,而不是简单地多访问几个簇。
| 候选策略 | K | SR | ΔSR | SPL | 成功数 |
|---|---|---|---|---|---|
| 单融合目标(无恢复) | 1 | 0.926 | – | 0.586 | 926 |
| 仅融合感知主候选 | 1 | 0.928 | +0.002 | 0.588 | 928 |
| 仅融合代表 Top-3 对照 | 3 | 0.964 | +0.038 | 0.596 | 964 |
| 主候选 + 1 个相异残差 | 2 | 0.965 | +0.039 | 0.598 | 965 |
| 主候选 + 2 个相异残差 | 3 | 0.975 | +0.049 | 0.601 | 975 |
表3:序列恢复消融(论文 Table 6)。ΔSR 以严格单融合目标为基准。
同响应三元组对照(论文 Table 5)检验融合是否只是提示工程效应:在六个 backend×FoV 组合中,融合一律抬高 raw SR——全尺度 0.920→0.926,GPT 90° 0.867→0.967、120° 0.933→1.000,Qwen 0.333→0.500,MiMo 0.833→0.900 与 0.567→0.633。宽视场并非免费午餐:GPT-5.4 在 120° 下靠融合补上低处马桶与无支持沙发单例达到 1.000 SR,而 MiMo 从 0.900 跌到 0.633,说明可见性、投影几何与 VLM 定位能力必须联合标定。图5 的机制审计把聚合数字落到个案:宽视角捕获接地了一个成功马桶 standoff;源感知融合把无支持沙发单例替换为 22 源假设;新鲜 RGB-D 拒绝了一个错误的 rank-1 盆栽候选并接受空间相异的 rank-2;物理序列则展示 Yahboom X3 上从 RGB-D 对齐、持久拓扑、语言检索 Node 22 的玩具到 Nav2 到达的完整闭环。
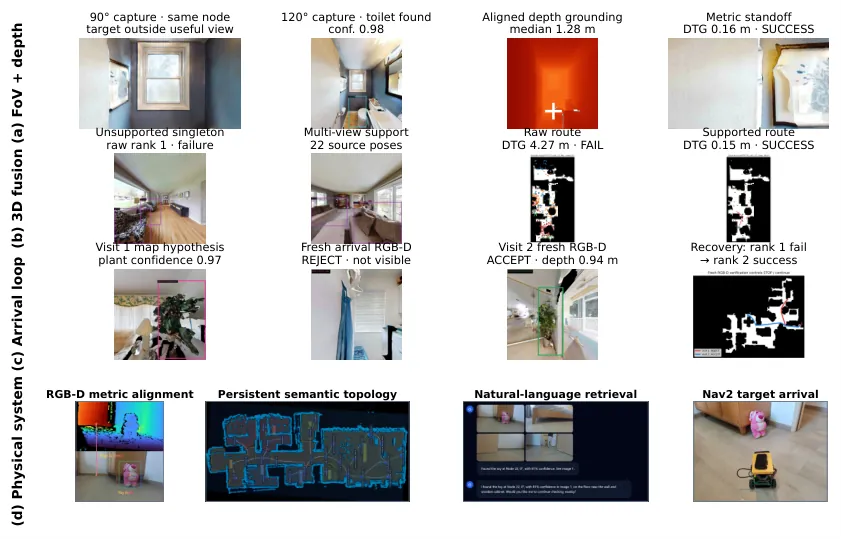
图5:机制与部署审计(论文 Figure 4)。(a) 宽视角捕获与深度接地成功马桶 standoff;(b) 源感知融合以 22 源假设替换无支持沙发单例;(c) 新鲜 RGB-D 拒绝错误 rank-1 盆栽、接受 rank-2;(d) 物理系统序列:RGB-D 对齐、持久语义拓扑、Node 22 玩具的语言检索与 Nav2 到达。
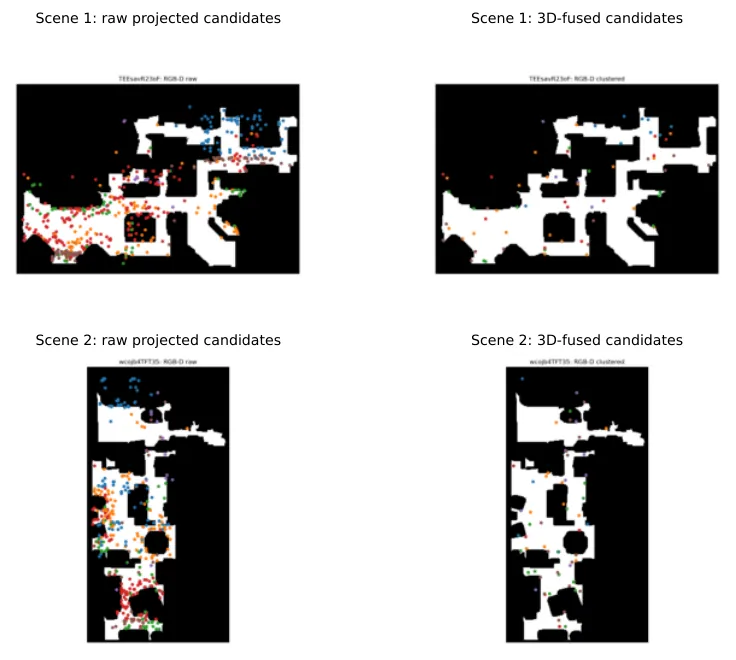
图6:minival 两场景的真实语义地图(补充材料 Figure 1)。左列为全部有效深度投影候选,右列为 3D 与可达性聚类后保留的候选;融合删掉重复投影点的同时保持跨楼层的类别覆盖。
物理系统在 Yahboom X3 移动机器人上实现:ROS 2 Humble + Nav2 执行度量目标,Gemini 336L 提供对齐 RGB-D,RPLIDAR S2 提供激光扫描,slam_toolbox 维护占据栅格与定位;持久管理器跨导航段保留图与交互状态。论文同时坦承:定量 SR/SPL 全部来自仿真,物理序列只记录系统接口的定性集成。
局限性
作者自述的边界包括:全研究只覆盖一个 HM3D-v2 split、一个托管主 VLM、六个类别与静态场景;连续 navmesh 路径抽象掉了控制噪声与地图变化;关系型对话(如「沙发旁的花瓶」)超出类别查询基准,未做定量评测;托管端点的权重与未来服务行为不受作者控制;置信区间只量化 episode 采样不确定性,不覆盖跨数据集、模型服务或真实世界变异。
我们的独立判断有三点。其一,融合在全尺度上的净成功率增益并不显著(28 胜 22 负、$p=0.480$),且 SPL 有统计可辨的小幅下降(ΔSPL -0.017,95% CI [-0.032, -0.002]);论文摘要把「fusion reaches 0.926」作为标题级结论,但表2、表3 与补充 Table 7 的数据更支持「融合的价值在压缩与排序稳定、恢复的价值在净成功率」这一读法。其二,到达验证每个唯一候选平均耗时 20.52 秒(中位 19.45 秒、P95 32.31 秒),叠加全量建图 44,499,374 token 的托管推理成本,距离「家庭机器人即装即用」仍有工程距离;论文未报告端到端墙钟时间或成本核算。其三,定量结论完全建立在仿真 navmesh 的最短路径上,物理实验仅定性,真实传感器的运动模糊、定位漂移与碰撞恢复对 verifier 精度/召回率的影响未被测量,而 verifier 恰是闭环里唯一的安全阀。
总结与展望
SSTG-Nav 的贡献不在于某个单点技巧,而在于把「复用」从一个有利假设变成一个可严格评测的操作域:三套信息边界协议把几何覆盖、语义接地、表示融合与序列恢复的增益逐一隔离;度量接地给出全文最大且最显著的单步增益;双层记忆与 2 米分离残差把 Top-3 成功率推到 0.975;ROS 2/Nav2 实现证明接口可以落到真实机器人。对长期驻留同一环境的服务机器人而言,「感知付一次、查询只做检索与图搜索」的摊销结构,可能比任何单 episode 的探索策略都更接近部署现实。
开放问题同样明确:语义接地仍是瓶颈(oracle 几何 0.994 对真实语义 0.926),开放词汇与关系型查询需要新的表示与评测;动态环境下的地图老化、物体搬移与 verifier 再标定尚无方案;把托管 VLM 换成端侧模型时,宽视场与融合的收益是否保持(MiMo 的反例提示未必)也需要逐模型重新标定。作者计划将持久地图与到达接口扩展到动态环境与更广的真实相机评测。
金句
认出物体不等于知道该在哪里停下——可复用导航的真正产物,不是地图,而是一组被多视角佐证、可达且可验证的停点位。