PAPER DEEP DIVE
世界模型增强的人形落脚受限地形视觉运动
WM-LOCO 将循环世界模型与 PPO 联合训练,仅凭本体感知与单路深度图产出预测性循环特征,在落脚受限地形大幅超越基线,真机成功率 93.3%。
论文元信息
标题:World-Model-Augmented Visual Locomotion for Humanoids on Foothold-Constrained Terrain
作者:Yuxi Liu(共同一作)、Lijun Han(共同一作)、Ziming Wang、Ao Zhang、Cong Yang、Wei Sui(项目负责人 / 通讯作者)
机构:D-Robotics;北京邮电大学;哈尔滨工业大学;苏州大学
提交:2026 年 9 月 2 日,arXiv:2609.02542 [cs.RO],11 页、3 图、4 表
代码状态:作者开放了项目主页仓库(M0PUPPET/wm-loco,含演示视频与图表),训练代码尚未公开;在线主页 m0puppet.github.io/wm-loco
一句话总结
WM-LOCO 把一个循环世界模型(RSSM)与 PPO 策略端到端联合训练,让策略在只靠本体感知和单目深度图的情况下,获得一份"预测性的循环特征",从而在踏石、沟壑、窄楼梯这类落脚受限地形上稳定通过,真机平均成功率 93.3%。
研究背景与动机
人类走过踏石、跨过沟壑、踩上窄楼梯时,眼睛总是先看几步之外:先判断哪些位置能落脚,再决定脚往哪放。这种"提前看"的能力,是双足在稀疏落脚地形上不掉下去的关键。然而大量基于强化学习的运动策略是在连续地形上训练的——那里可行落脚点是稠密的——并且只把当前或很短时间窗内的观测作为条件。于是它们在平地上表现很好,一旦地形变成"只有少数离散位置能踩"的形态,就会频繁失足。
作者把这类地形统称为落脚受限地形(foothold-constrained terrain):可行脚接触区域相对机器人标称步长而言是稀疏的、不连续的、或几何上受限的,例如沟壑、踏石、窄楼梯踏面。在这类地形上,一次踩空往往就足以导致摔倒;而对双足来说问题更严峻——与四足相比,双足在踩空之后可供支撑的接触点更少,几乎没有纠错余地。
已有工作用"更复杂的控制器"来应对稀疏落脚信号。BeamDojo 把稠密目标与稀疏目标拆分到不同的 critic,并逐步提升地形难度;RPL 先训练带特权信息的专家策略,再蒸馏到只吃深度的学生策略;PLANC 把降阶参考轨迹包进多阶段的教师—蒸馏循环;基于模型的方法则在线求解混合整数二次规划做脚步规划。这些方法都能走通稀疏落脚地形,但普遍依赖分阶段训练、蒸馏或模型脚手架,系统复杂度高。
另一条线索来自世界模型。世界模型已被用于腿式运动的预测性表征学习:有工作用世界模型为视觉四足运动学习预测潜变量,有工作用世界模型重建世界状态以服务人形控制,Perceptive Internal Model 被用于爬楼梯,DreamPolicy 用扩散模型合成未来运动。它们都把预测或重建目标引入了运动控制,并在楼梯或粗糙地面上报告了收益,但都没有正面回答一个问题:当可行落脚变得稀疏时,预测信号到底有没有帮上忙——而这恰恰是双足最需要"提前看"的场景。
WM-LOCO 正是冲着这个空白去的。它不引入分阶段 critic、不做蒸馏、也不挂规划器,而是让一个循环世界模型与 PPO 端到端共训练:循环模型从本体感知与单张机载深度图中汇总出预测性上下文,产出一个预测性循环特征去条件化策略,全程不使用任何显式的落脚标签。作者想验证的命题很直接:一份"对近未来观测与奖励的学习式预测摘要",能否提供稀疏落脚地形所需的 anticipatory 信息。
预备知识
POMDP 视角下的运动控制。论文把运动建模为部分可观测马尔可夫决策过程。每个控制步 $t$,策略观测 $o_{t}=(p_{t},d_{t},c_{t})$:$p_{t}$ 是 5 帧本体感知历史(关节位置、关节速度、惯性测量与上一步动作),$d_{t}$ 是单个头戴机载相机的深度图,$c_{t}$ 是基坐标系下的指令速度。任务是在避免非脚部接触的前提下跟踪 $c_{t}$ 并通过地形。
RSSM:循环状态空间模型。RSSM 用一条确定性记忆 $h_{t}$ 加一个随机潜变量 $z_{t}$ 来压缩历史。直观上,$h_{t}$ 由上一时刻的状态、潜变量与动作循环更新,承载"我记得什么";$z_{t}$ 则捕捉超出确定性状态所能表达的、依赖当前观测的信息。Dreamer 系列证明了这个结构在视觉控制里的威力,WM-LOCO 把它搬进了人形运动,并让它与策略共享编码器、同步更新。
为什么标准奖励不够。在落脚受限地形上,"速度跟踪 + 常规步态整形"这套标准目标太稀疏:大多数 rollout 在智能体还没发现"可行步与不可行步的区别信号"之前就已经终止;而早期一次踩空的不可逆性,又让"最终摔倒"的时序信用分配极其困难。因此论文在标准奖励之上叠加了地形专用的整形项,且对 WM-LOCO 与 PPO 基线完全相同地施加,保证对比公平。
方法详解
整体框架。WM-LOCO 由两个块耦合而成:左侧是策略块(PPO + MoE actor-critic),右侧是 RSSM 世界模型块。世界模型吃本体感知 $p_{t}$ 与第一视角深度 $d_{t}$,维护一个循环状态来汇总近未来的观测与奖励;由该循环状态导出的特征 $f^{\mathrm{WM}}_{t}$ 去条件化策略。策略侧则把本体感知历史、速度指令、第一视角深度图与 $f^{\mathrm{WM}}_{t}$ 一起送入一个 mixture-of-experts 骨干,再喂给 actor 与 critic 头。
世界模型的四个学习组件。具体地,模型学习:(i) 转移 $h_{t}=f_{\phi}(h_{t-1},z_{t-1},a_{t-1})$,用上一步动作更新记忆;(ii) 后验 $z_{t}\sim q_{\phi}(z_{t}\mid h_{t},p_{t},d_{t})$,从记忆与当前观测推断潜变量;(iii) 先验 $\hat{z}_{t}\sim p_{\phi}(z_{t}\mid h_{t})$,在不看当前观测的情况下从记忆预测潜变量;(iv) 解码器,重建本体感知、深度与奖励。潜变量维度为 128。
训练目标。世界模型的损失由三项重建加一项 KL 组成:
$$\mathcal{L}_{\mathrm{WM}}=\underbrace{\mathrm{MSE}(\hat{p}_{t},p_{t})}_{\text{proprio recon}}+\underbrace{\mathrm{MSE}(\hat{d}_{t},d_{t})}_{\text{depth recon}}+\underbrace{\mathrm{MSE}(\hat{r}_{t},r_{t})}_{\text{reward pred}}+\beta\,\underbrace{\mathrm{KL}\!\left(q_{\phi}\,\|\,p_{\phi}\right)}_{\text{forward prediction}}$$
前三项迫使潜变量保留关于观测与奖励的信息;KL 项把先验拉向后验,从而鼓励 $h_{t}$ 在当前观测到来之前就保留"能预测潜变量"的信息——这正是"预测性"的来源。注意这个 KL 不是普通的正则,它把"提前预测"这件事直接写进了目标函数。
联合训练,而非预训练。世界模型不在单独的预训练阶段训练,而是与策略一起优化:标准 PPO 裁剪代理目标与 $\mathcal{L}_{\mathrm{WM}}$ 在同一次联合更新中求解,世界模型的梯度会回传进共享的深度编码器与本体感知编码器。推理时只把记忆通过 $f_{t}^{\mathrm{WM}}=g_{\psi}(h_{t})$ 传给策略,不需要想象 rollout,也不使用任何落脚标签。这一点很重要:它意味着部署端没有额外的规划开销,世界模型只充当一个"预测性特征提取器"。
flowchart LR
  subgraph OBS["onboard observation o_t"]
    P["proprio history p_t
5 frames"]
    D["depth image d_t
32x18 crop"]
    C["velocity cmd c_t"]
  end
  subgraph WM["RSSM world model"]
    OE["observation encoder"]
    POST["posterior q
z_t | h_t, p_t, d_t"]
    PRIOR["prior p
z_t | h_t"]
    TR["state transition f
h_t from h_t-1, z_t-1, a_t-1"]
    DEC["decoders
proprio / depth / reward"]
    WFE["WM-feature g
f_t from h_t"]
  end
  subgraph POL["policy: PPO + MoE actor-critic"]
    HE["history / proprio / depth encoders"]
    MOE["MoE backbone"]
    ACT["actor -> action a_t"]
    CRI["critic"]
  end
  P --> OE
  D --> OE
  OE --> POST
  TR --> POST
  POST --> TR
  POST --> DEC
  PRIOR --> DEC
  POST --> WFE
  P --> HE
  D --> HE
  C --> HE
  WFE --> MOE
  HE --> MOE
  MOE --> ACT
  MOE --> CRI
  DEC -. "L_WM joint update" .- MOE
地形专用奖励:脚部体积点集。所有地形专用接触项都基于脚部体积点集 $\mathcal{V}^{\mathrm{foot}}_{t}$ 计算——在每只脚的网格上采样接触点,并在每个控制步投影到世界坐标系,传感器设计沿用 Zhu 等人(Hiking in the Wild)的方案。有了这个点集,"脚有没有踩进不该踩的区域"就变成一个可数的几何判定。
楼梯边界惩罚。在每个楼梯结构两侧的平地上布置二维惩罚区,阻止策略为了完成速度跟踪而绕开地形、回避落脚约束。对应的非负违规项统计落在惩罚区内的脚部采样点数:
$$r^{\mathrm{bdry}}_{t}\;=\;\bigl|\,\mathcal{V}^{\mathrm{foot}}_{t}\cap\mathcal{Z}^{\mathrm{bdry}}\,\bigr|$$
其中 $\mathcal{Z}^{\mathrm{bdry}}$ 是每块地形上若干二维矩形的并集,位于楼梯足迹旁侧(横向全范围乘一条沿 $x$ 方向贴着足迹的窄带)。其边缘区域构造复用 Zhu 等人的 Terrain Edge Detection 原语,但施加在楼梯块周围的平地而非地形边缘本身。
踢面穿透惩罚。类似地,统计落入任一楼梯踢面(riser)内的脚部采样点数:
$$r^{\mathrm{riser}}_{t}\;=\;\bigl|\,\mathcal{V}^{\mathrm{foot}}_{t}\cap\mathcal{Z}^{\mathrm{riser}}\,\bigr|$$
其中 $\mathcal{Z}^{\mathrm{riser}}$ 是覆盖每个踢面的轴对齐三维长方体的并集,且每个踢面顶部 4 cm 被排除——这个 clearance 防止踏面前缘附近的斜向脚接触被误判为踢面穿透。作者报告:没有这一项时仿真中持续出现踢面撞击,硬件测试也观察到了;加上之后该失败在仿真 rollout 中不再出现,且策略无需再调参即可迁移到真机。这是一个"小惩罚项解决真机大问题"的典型案例。
顺序踏面接触奖励。楼梯奖励维护一个沿当前朝向有序的踏面接触区域序列 $R_{1},R_{2},\dots$,并用每环境索引 $k_{t}$ 标记"当前"区域。当某只脚首次在 $R_{k_{t}}$ 上达到鞋底接触比 $c_{\min}=0.5$ 时,打开一个速度自适应的激活窗口,长度为 $\tau_{t}=\mathrm{clip}\!\left(\ell_{k_{t}}/(2\,\bar{v}^{\mathrm{cmd}}\,\Delta t),\,5,\,50\right)$ 个控制步,其中 $\ell_{k_{t}}$ 是区域深度、$\bar{v}^{\mathrm{cmd}}$ 是指令前进速度。窗口打开期间:
$$r^{\mathrm{tread}}_{t}\;=\;g_{t}\,\rho^{\mathrm{seq}}_{t}\;-\;0.7\,\max\!\bigl(0,\;\rho^{\mathrm{other}}_{t}-0.05\bigr)$$
其中 $g_{t}\in\{0,1\}$ 在窗口打开时为 1;$\rho^{\mathrm{seq}}_{t}$ 是左右交替所要求的那只脚在 $R_{k_{t}}$ 上的鞋底接触比(踩错脚时折扣 0.3 而非清零,保留非零学习信号);$\rho^{\mathrm{other}}_{t}$ 是另一只脚与当前区域的重叠。索引只有在接触持续至少 $0.3\,\tau_{t}$ 帧后才推进到 $R_{k_{t}+1}$;在当前区域完成之前,接触后续区域不给奖励。这套"顺序门控"把爬楼梯变成了一个有明确进度的课程。
踏石顶部接触奖励。踏石采用另一套并行式表述:当前地形块上所有有效石顶区域在 reset 时全部激活,每个区域在达成合格接触后独立被"消费",因此没有顺序约束、也没有左右交替逻辑;中心平台整形鼓励踩在石面中央,逐脚车道门控惩罚踩错车道的重叠。
总奖励。在 gap+stairs 训练设定下,三项与标准奖励组合为:
$$r_{t}\;=\;r^{\mathrm{std}}_{t}+w_{b}\,r^{\mathrm{bdry}}_{t}+w_{r}\,r^{\mathrm{riser}}_{t}+w_{t}\,r^{\mathrm{tread}}_{t}$$
权重 $w_{b},w_{r},w_{t}$ 见论文附录 B(边界 $-0.05$、踢面 $-0.5$、顺序踏面 $+0.5$),且这三项与世界模型损失一起联合调参。换句话说,奖励整形与世界模型是"同一个优化问题里的两个部件",而不是先后叠加的两层。
实验结果
设置与基线。仿真在 IsaacLab 中用 Unitree G1 人形、8192 个并行环境、单张 NVIDIA RTX 5880-Ada(48 GB)完成;深度观测来自仿真的头戴 Intel RealSense D435,渲染分辨率 $64\times 36$、视场 $89.5^{\circ}\times 58.3^{\circ}$,裁剪到 $32\times 18$、截断到 0.1–2.5 m、采样 50 Hz。基线是与 WM-LOCO 训练条件完全对齐的 PPO:共享同一奖励、同一感知流、同一本体感知编码器、同一 AMP 运动先验、同一 MoE actor-critic 与同一迭代预算,唯一去掉的就是世界模型通路及其辅助损失。因此观测到的差异可以归因于预测性循环特征。评测在留出地形实例上进行,每类地形单独测、固定生成器行、关闭外部推扰与域随机化,每个(方法, 地形, 难度)组合至少 50 个 episode;45 秒内质心越过终点线记为成功。
成功率:稀疏落脚地形上的断层式差距。下表是论文 Table 1 的核心数字。在沟壑与踏石上,PPO 基线在所有难度档都是 0.0%,而 WM-LOCO 介于 78.2%(踏石 Hard)到 100%(沟壑 Medium)之间;在楼梯上两者都能过,PPO 为 87.0%–91.4%,WM-LOCO 为 92.0%–95.7%,差距不超过 7.2 个百分点。这个"楼梯上 modest、稀疏地形上 decisive"的形态,恰好印证了论文的假设:预测信号在"必须提前看"的地形上才真正值钱。
| 地形 | 难度 | PPO | WM-LOCO | 真机 |
|---|---|---|---|---|
| 楼梯 | Easy | 87.0% | 94.2% | 90% |
| 楼梯 | Medium | 91.4% | 95.7% | — |
| 楼梯 | Hard | 91.3% | 92.0% | — |
| 沟壑 | Easy | 0.0% | 98.0% | 90% |
| 沟壑 | Medium | 0.0% | 100.0% | — |
| 沟壑 | Hard | 0.0% | 90.0% | — |
| 踏石 | Easy | 0.0% | 87.0% | 100% |
| 踏石 | Medium | 0.0% | 88.3% | — |
| 踏石 | Hard | 0.0% | 78.2% | — |
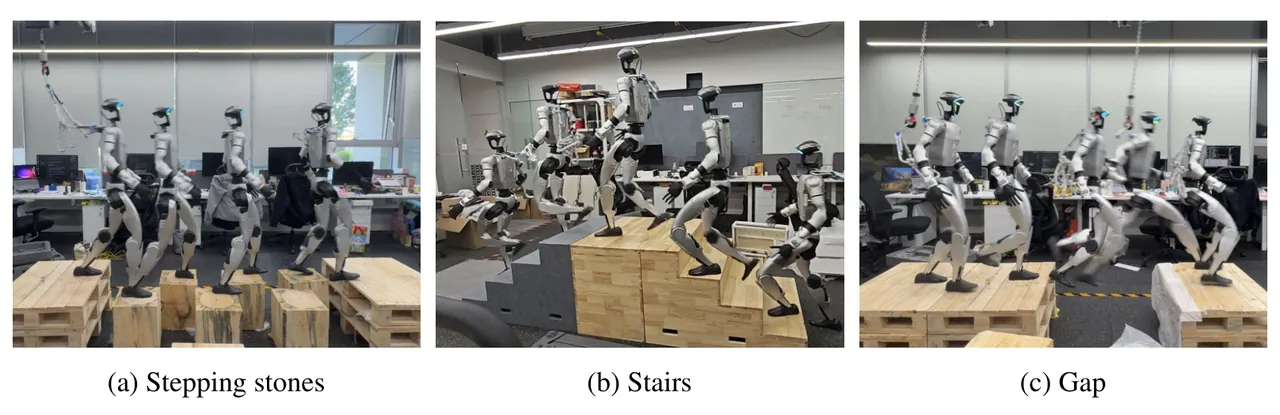
图 1:WM-LOCO 在 Unitree G1 上的真机部署——(a) 踏石、(b) 楼梯、(c) 沟壑。策略仅靠机载单路深度流运行,无离线感知、无地形图。
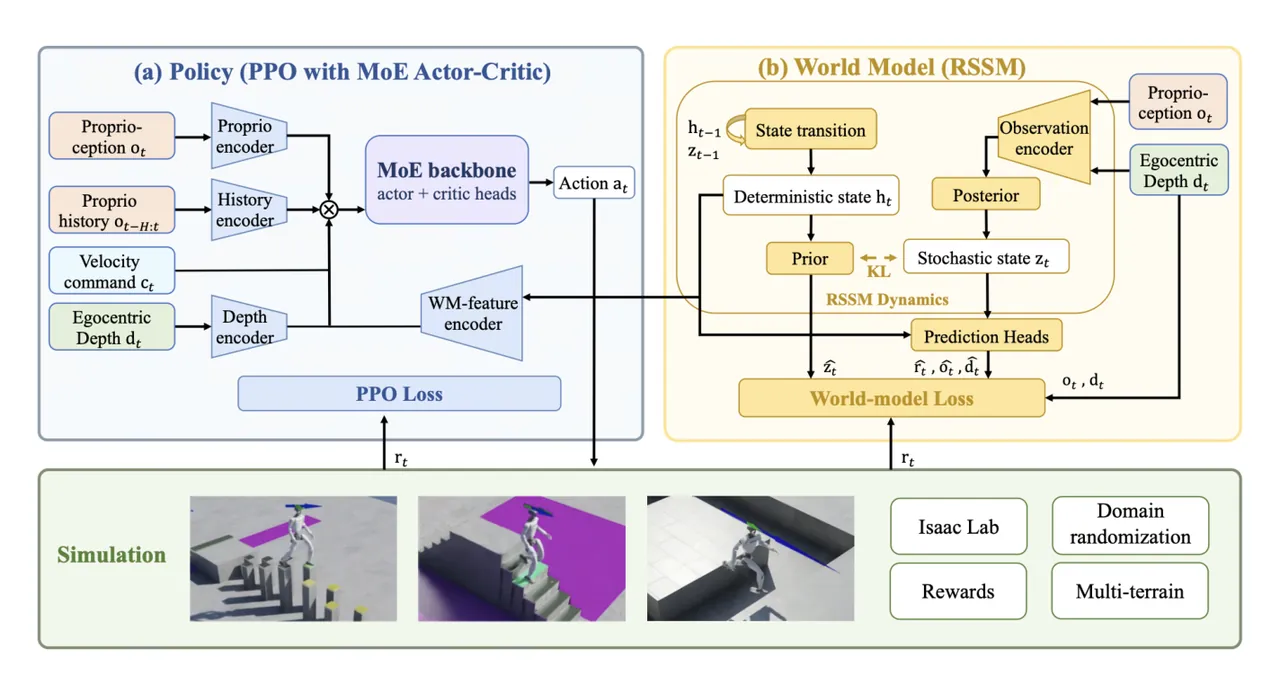
图 2:WM-LOCO 框架。左为策略块(PPO + MoE actor-critic),右为 RSSM 世界模型块;世界模型特征 $f_t$ 注入策略骨干。
步态质量:楼梯上不只是"过",而是"过得更省"。在成功率接近的楼梯上,两者步态质量差异明显:WM-LOCO 步长 +15% 到 +35%、每米步数 −9% 到 −21%、骨盆加速度 −24% 到 −33%、归一化机械能耗 −6% 到 −20%。下表(论文 Table 4)给出逐档数字。以 Hard 档为例,步长从 0.40 m 提到 0.54 m,每米步数从 5.15 降到 4.07,骨盆加速度从 9.89 降到 6.58 m/s²,action-rate 从 8.14 降到 3.32——动作更平滑、更少抖动。值得注意的是扭矩/限位比两者几乎持平(0.67 vs 0.66),说明这种"更省"并非靠压榨执行器换来。
| 指标 | 单位 | 难度 | PPO | WM-LOCO |
|---|---|---|---|---|
| 步长 ↑ | m | Easy / Medium / Hard | 0.45 / 0.42 / 0.40 | 0.52 / 0.53 / 0.54 |
| 每米步数 ↓ | — | Easy / Medium / Hard | 4.91 / 5.04 / 5.15 | 4.45 / 4.26 / 4.07 |
| 归一化机械能 ↓ | — | Easy / Medium / Hard | 1.01 / 1.21 / 1.43 | 0.95 / 1.01 / 1.14 |
| 骨盆加速度 ↓ | m/s² | Easy / Medium / Hard | 6.96 / 8.26 / 9.89 | 5.28 / 5.85 / 6.58 |
| action-rate ↓ | — | Easy / Medium / Hard | 3.94 / 6.19 / 8.14 | 2.61 / 2.88 / 3.32 |
失败模式:从"摔"变成"踩错"。在踏石上,WM-LOCO 失败时的主导模式是非法落脚(跨档聚合 23.0%),而非摔倒(仅 1.9%);基线的失败则主要是摔倒(61.0%)或无进展(36.0%),且多发生在 episode 开头的前几次接触。这个对比很有信息量:世界模型并没有把"踩错"完全消除,但它把失败的后果从"直接摔"降级为"踩错但还能站住",这正是稀疏落脚地形上最需要的容错形态。沟壑上也是同样的模式:基线全档 0%,WM-LOCO 始终不低于 90%。
世界模型到底学到了什么。作者用一步后验重建来检验世界模型头:把 rollout 中记录的观测编码进循环潜变量,再重建深度与本体感知。一次 warm-up 之后,逐步深度重建 MSE 通常低于 $1\times 10^{-3}$,仅在第 45–55 步附近出现约 $1.2\times 10^{-3}$ 的瞬态峰值(此时高起伏结构扫过视场);本体感知聚合重建 MSE 低于 $5\times 10^{-4}$,其中基座角速度是误差最大的通道(约 $1\times 10^{-3}$,与高带宽 IMU 信号一致)。图 3(a) 的逐面板 MSE 为 0.0117 / 0.0004 / 0.0006 / 0.0001,第 1 步的大误差来自循环状态初始化。作者也坦诚说明:这一分析刻画的是编码器/解码器的重建保真度,而非开环前向预测质量。
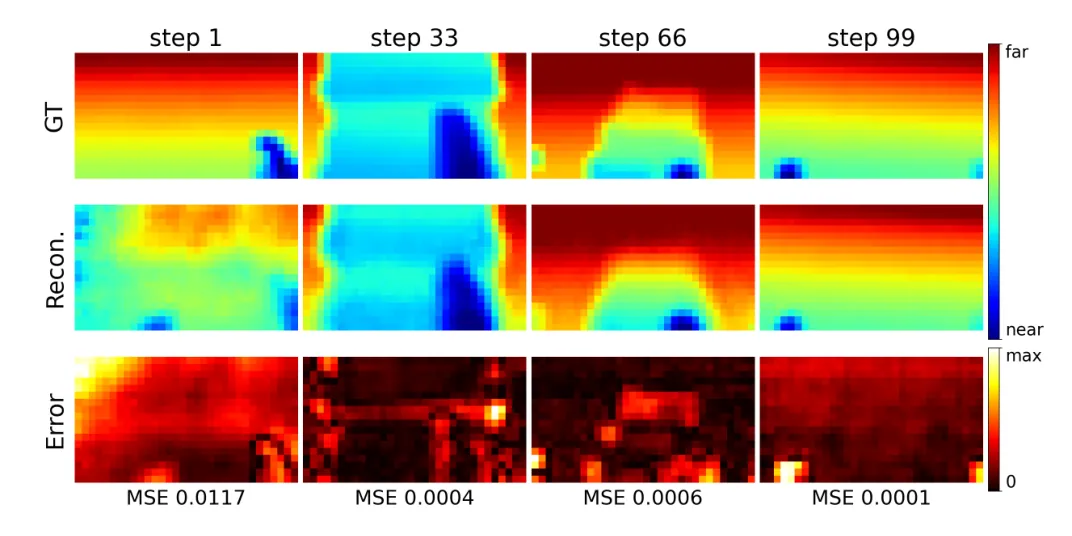
图 3(a):四个循环更新步上的真值深度、后验重建与逐像素绝对误差,附每步 MSE;第 1 步的大误差源于循环状态初始化。
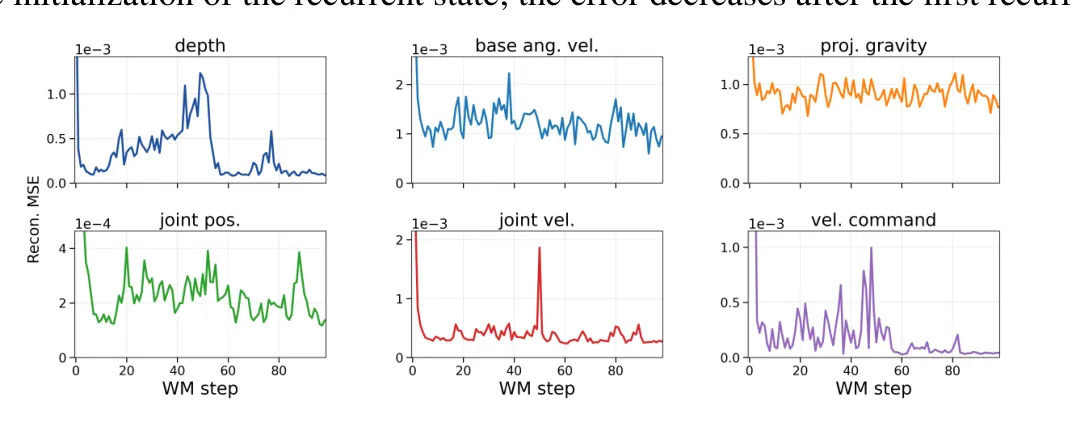
图 3(b):深度图与各本体感知变量组的逐 tick 重建 MSE(7 个并行环境的中位数)。
真机部署:同一份策略,全机载运行。策略导出为 ONNX,部署在 Unitree G1 的 Jetson Orin 上,只吃本体感知与单路头戴深度流(RealSense D435,与仿真同型号相机),不需要离线感知、预计算地形图或额外状态估计器。在石顶宽 0.25 m、纵向间隔 0.45 m 的踏石上,策略无落脚失败地通过离散石垫;在踢面 0.15 m、踏面 0.25 m 的楼梯上,机器人逐级抬脚并把脚掌平放在踏面上,无需额外调参;0.8 m 的沟壑用单步跨越,摆动—落地模式与仿真一致。出于安全考虑未测试更大沟壑。每类地形 10 次试验,真机成功率见表 1 最后一列(踏石 100%、楼梯 90%、沟壑 90%),三类平均 93.3%。
地形难度是怎么分档的。附录 A 的 Table 2 给出三档仿真难度与真机场地的物理尺寸:楼梯踢面高 Easy 9.2–10.4 cm、Medium 12.8–14.0 cm、Hard 18.8–20.0 cm(真机 15 cm),踏面深 25.5–30.0 cm 递增;沟壑宽 0.40 / 1.00 / 2.00 m(真机 0.8 m);踏石边长 33–34 / 30–31 / 25–26 cm,同车道石间距 7–9 / 13–15 / 23–25 cm(真机 25 cm 边长、45 cm 间距)。可以看到 Hard 档踏石间距已达 23–25 cm、边长仅 25–26 cm,对 G1 的标称步长而言确实是"踩错就完"的区间。
局限性
作者自述其一:适用范围。框架面向"可行接触由离散石垫或窄几何约束主导"的落脚受限地形。连续窄支撑(如平衡木)与高度变化的踏石会同时叠加横向与纵向约束,可能需要单独的奖励整形;室外非结构化地形不在本研究范围内。
作者自述其二:平台与架构单一。结果只报告在单一 Unitree G1 人形与单一 RSSM 世界模型骨干上。作者指出策略消费的是"通用预测性循环特征",因此表述上可以容纳其他世界模型架构,但其他人体形态与更多落脚受限任务的验证仍是未来工作。
我们的判断:重建保真 ≠ 预测能力。论文用一步后验重建来佐证世界模型学到了有用表征,但作者自己也承认这刻画的是重建保真度而非开环前向预测质量。换言之,"成功率提升来自预测性特征"这一因果链条,目前靠的是消融(去掉世界模型通路)而非对预测行为本身的直接度量;KL 项所鼓励的"提前预测"究竟在多大程度上被策略利用,仍缺少可解释性层面的证据。
我们的判断:奖励整形与世界模型耦合。地形专用奖励对 WM-LOCO 与基线完全相同,这保证了对比公平,但也意味着"稀疏地形上的成功"是奖励整形与世界模型共同作用的结果。论文没有给出"只加奖励整形、不加世界模型"与"只加世界模型、不加奖励整形"的交叉消融,读者无法把两者各自的贡献拆开。
总结与展望
WM-LOCO 的贡献不在于发明新的世界模型结构,而在于把一个成熟的 RSSM 以"联合训练、只做特征、不做想象"的极简方式接入人形运动策略,并在"落脚受限"这个被明确定义的 terrain family 上给出了干净的对照实验。它用一组可数的几何奖励项(边界、踢面、顺序踏面、石顶接触)把稀疏落脚信号变得可学习,再用预测性循环特征把"提前看几步"变成策略的一个输入通道。仿真中断层式的成功率差距、真机 93.3% 的平均成功率、以及失败模式从"摔"到"踩错"的降级,共同构成了一个自洽的证据链。
对工程实践的启示同样直接:踢面穿透惩罚里那 4 cm 的 clearance、顺序踏面奖励里 0.3 的错脚折扣与 $0.3\,\tau_{t}$ 的推进门槛,都是"让稀疏信号保留梯度"的细活;而"世界模型梯度回传进共享编码器、推理零额外开销"的设计,则让这套方法在机载算力上真正跑得动。后续工作自然会走向更多人体形态、更复杂的世界模型骨干,以及把平衡木、变高踏石这类混合约束地形纳入同一框架。
金句
"在落脚受限的地形上,策略缺的不是看清脚下,而是提前知道下一步还能踩哪里——把这份'提前'学成一个循环特征,比给它一张落脚标签更便宜,也更通用。"