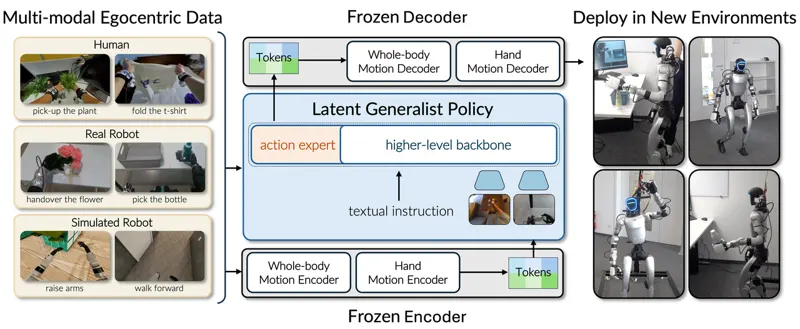
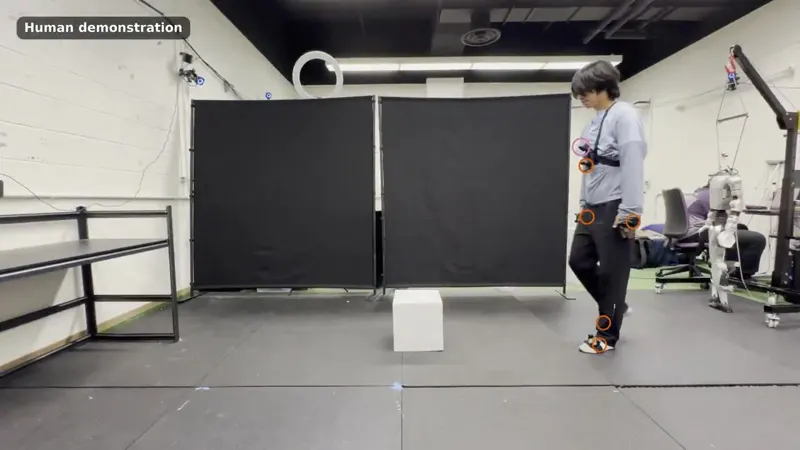
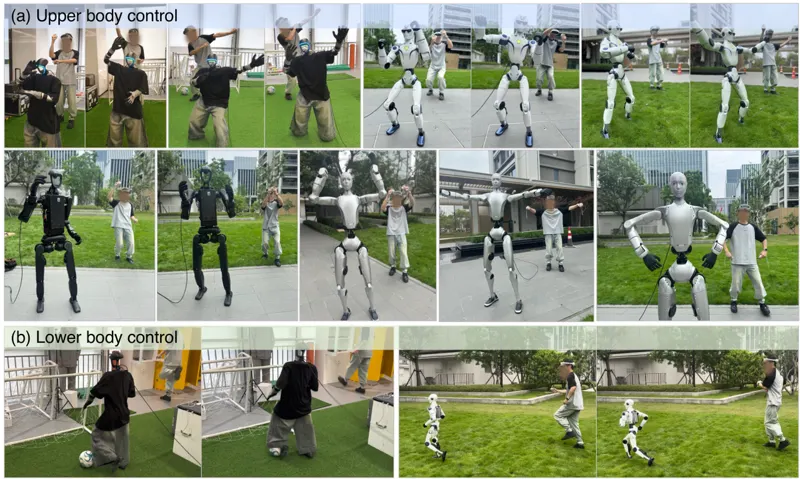
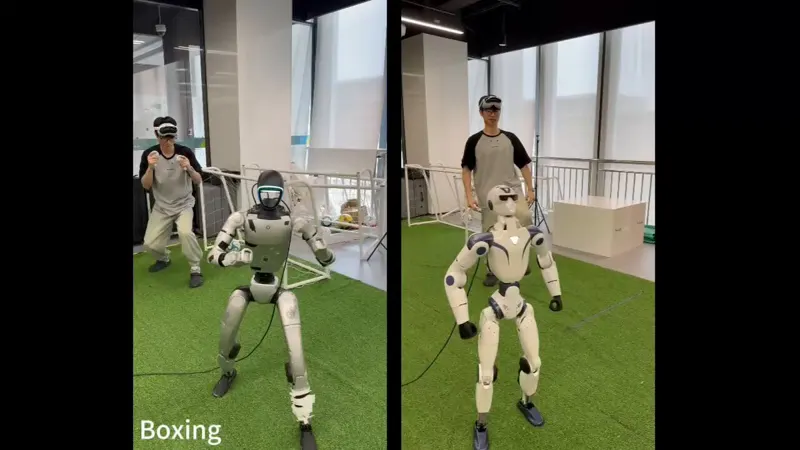
VioLA:用人类数据学通用人形控制策略VioLA 把人形通才策略的预测目标从关节指令换成身体与手部运动隐码,冻结的控制器负责执行,人类与机器人演示因此共用同一个动作空间;1.406 亿帧训练数据里 93.2% 来自人类,真机 G1 零样本运动成功率 100%、操作 88.6%。Mert Albaba, Jens Beißwenger, Anna Manasyan · 205次阅读 · 2026年10月8日人形机器人视觉语言动作模型全身控制2026年10月8日
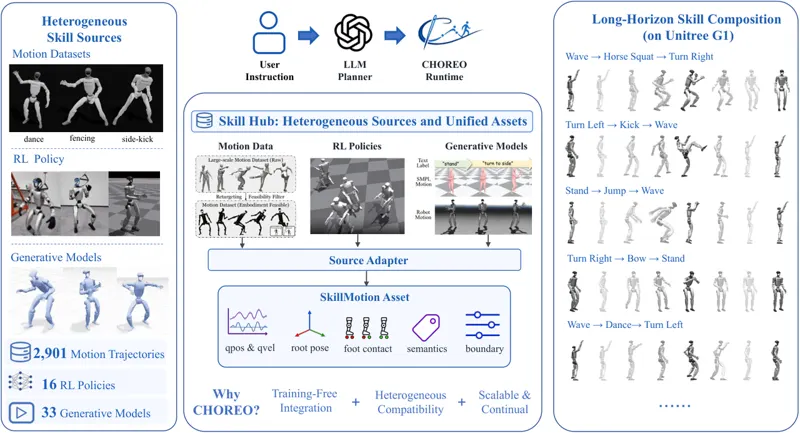
CHOREO:把每一项人形技能都表示成轨迹中国海洋大学与中科院自动化所的 CHOREO 提出免训练的人形技能组合框架:把运动库、强化学习策略与生成模型的输出统一转换成语义与边界完整的 SkillMotion 轨迹资产,用边界失配评分决定直接接缝(五次多项式匹配位置/速度/加速度)或插入预验证站立桥,再由冻结的 GMT 跟踪器在 Unitree G1 上执行。130 个多动作任务序列成功率 95.4%,八动作 93.8%,552 个边界切换成功率 96.7%,摔倒率从 41.5% 降至 4.6%,3,069 个异构实例 100% 通过注册。Ziyi Sun, Jingwen Chen, Yuxi Wang · 397次阅读 · 2026年9月11日人形机器人skill-composition运动追踪2026年9月11日
0:39Caltech 新研究:解耦导航与本体,让人形机器人走得更稳——ROM-Nav 两阶段安全导航@LeoKharon · 538次播放 · 2026-10-03人形机器人导航ReinforcementLearning
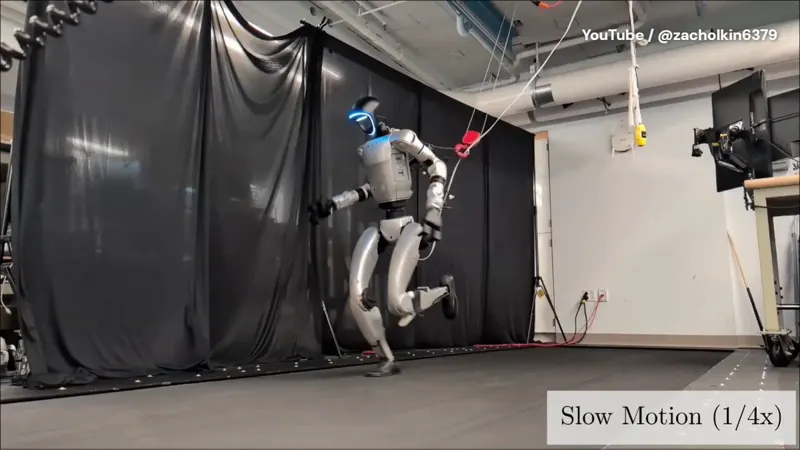
0:12IROS 2026 运动型人形机器人研讨会:上午跳舞演示,下午 4 点开放问题圆桌@ZiyunClaudeWang · 1013次播放 · 2026-09-27IROS 2026人形机器人Athletic Robotics
X-WBC:跨本体人形全身控制基础模型X-WBC 把人形全身控制重构为跨本体联合训练:以人为中心的命令 token 对齐全身人体动作、机器人参考动作与稀疏 VR 观测,共享因果 Transformer 学习可复用时序结构,轻量本体专属模块负责各机器人的状态与动作映射。九个仿真本体、外部动作与四台真机的实验表明联合训练提升跟踪精度,对齐表示支持跨命令源一致控制。Juntong Zhang, Chun Gu, Li Zhang · 746次阅读 · 2026年9月14日人形机器人全身控制Cross-Embodiment Learning2026年9月14日
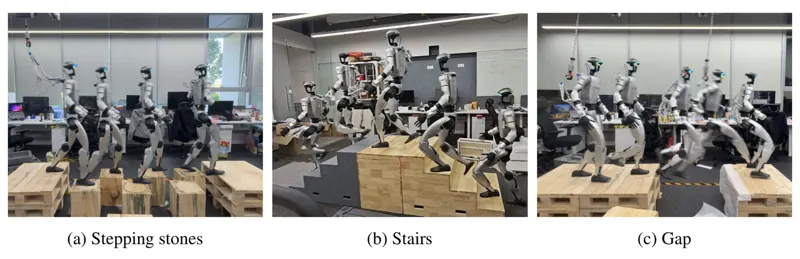
世界模型增强的人形落脚受限地形视觉运动WM-LOCO 将循环世界模型与 PPO 联合训练,仅凭本体感知与单路深度图产出预测性循环特征,在落脚受限地形大幅超越基线,真机成功率 93.3%。Liu, Yuxi, Han, Lijun, Wang, Ziming · 761次阅读 · 2026年9月2日人形机器人腿足行走世界模型2026年9月2日
LEGS:无需遥操作的仿人操作策略微调LEGS 用网格前景与三维高斯泼溅背景合成人形全身操作数据,并以运动基元自动生成演示。实验显示其训练策略在 Unitree G1 上匹敌或超过人工遥操作数据,跨场景泛化成本更低。Kim, Hojune, Chen, Timothy, Sun, Jiankai · 872次阅读 · 2026年5月31日人形机器人视觉语言动作模型3D高斯泼溅2026年5月31日
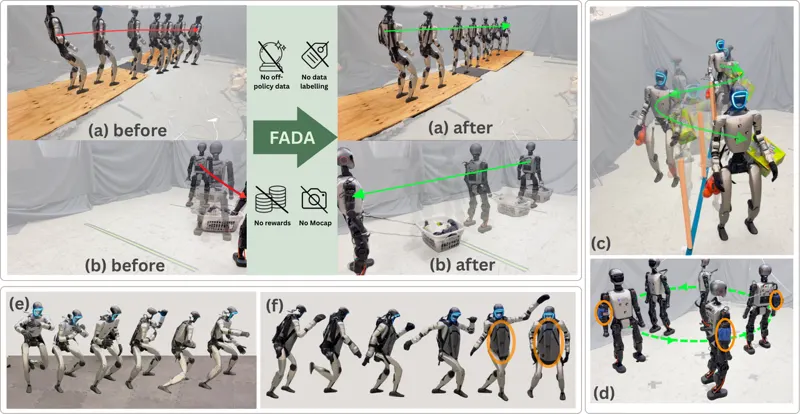
FADA:人形控制的少样本动力学适应该工作提出 Planner-IDM 框架:先用特权信息训练 oracle 策略,再通过 DAgger 蒸馏成规划器与逆动力学模型;部署时冻结规划器,仅用约2分钟目标域数据监督微调 IDM,使机器人适应坡面、负载与执行器变化。Angchen Xie, Nikhil Sobanbabu, Ishayu Shikhare · 460次阅读 · 2026年6月26日人形机器人Few-Shot Learning域适应2026年6月26日
 1:00