PAPER DEEP DIVE
记忆即计划:基于记忆锚定规划的世界-动作建模
主流机器人策略把动作预测写成马尔可夫形式,只看当前观测或固定短窗口,但长时程操作往往是非马尔可夫的:决策所需的信息早已离开视野。MaP-WAM 提出「记忆即计划」:已完成的片段被记为「语言指令 + 稀疏视觉上下文」的结构化多模态情景记录(每段均匀采样 8 帧),规划时由微调的 Qwen3.5-4B 语言规划器给出下一段语言计划,再由基于 WAN-2.2-5B 的因果世界模型从长时视觉上下文生成对应的视觉计划,两者组成记忆锚定计划;执行侧的 World-Action-Progress(WAP)模型用 Mixture-of-Transformers 架构联合预测动作块、未来视觉 latent 与执行进度,进度作为一等模态参与条件与反馈。执行器只以固定长度的计划为前缀,上下文不随历史增长,块因果注意力让规划与执行两侧都可做 KV 缓存;计划-观测对齐用当前观测与视觉计划帧的像素差校准递归进度估计,进度门控(阈值 0.95)触发片段切换并把真实观测重采样写回记忆。RMBench 九个记忆依赖任务平均成功率 83.3%(最强基线 LingBot-VA 为 77.1%),真机 Franka Research 3 两个任务 88% 与 68%、平均 78.0%;1700 帧历史下全上下文执行器显存超 80GB 直接 OOM,而 WAP 保持约 827ms 每动作块的近似恒定延迟。局限:依赖基准自带的片段标注、未做自动分段;计划-观测对齐用免训练的像素差度量,复杂视觉场景下可换学习型相似度。
论文元信息
标题:Memory as Plans: World-Action Modeling with Memory-Grounded Planning(记忆即计划:基于记忆锚定规划的世界-动作建模)
作者:Sizhe Zhao、Haozhe Xie、Weiyu Zhao、Chenchu Zhang、Huan Wang、Chenyang Wang、Qinglin Liu、Shengping Zhang(哈尔滨工业大学、南洋理工大学、山东大学、哈工大(威海)青岛研究院)
链接:arXiv:2609.11561 · 项目页 · 代码仓库 github.com/aipixel/MaP-WAM(仓库已建立,训练/推理代码与模型权重在 Release Plan 中标注为 Coming Soon,精读时尚未发布)
一句话总结:MaP-WAM 不把长时程历史塞进执行器,而是把已完成片段压缩成「语言计划 + 视觉计划」的记忆锚定计划,让执行器以固定上下文跟随计划行动,并用执行进度把规划、执行与记忆更新闭环起来。
研究背景与动机
主流机器人策略,无论是视觉-语言-动作模型(VLA)还是世界-动作模型(WAM),大多把动作预测写成马尔可夫形式:给定当前观测或一个固定的短历史窗口,直接回归下一个动作块。这个近似在反应式操作任务上足够好用,但在记忆依赖任务上会失效——决策所需要的证据可能早已离开视野:按钮的颜色在被遮住之前看过一次,积木的初始位置在交换之前记录过一次,这些信息在当前帧里都不存在。
现有的记忆机制大致分三类。第一类是语言记忆:把历史压缩成一段语言摘要或一条中间子任务指令,再交给低层策略执行,紧凑且可解释,但会丢掉细粒度的视觉与空间证据。第二类是持续更新的隐式记忆:维护可更新的潜状态或记忆库,问题是早期证据会在反复压缩与覆写中丢失。第三类是增长窗口:把历史观测直接拼进上下文,因果世界模型(如 LingBot-VA)天然适合这种形态,但逐帧历史的推理延迟与显存随轨迹长度线性增长,历史覆盖与执行效率之间形成硬权衡。
作者的关键观察是:在记忆依赖任务里,长时程视觉历史并不需要在每个控制步都作为执行器的直接输入。历史的主要用途是决定下一段的段级计划与期望的视觉演化;一旦计划确定,执行本身只需要跟随计划。这个观察把「读历史」与「做控制」解耦成两个模块:记忆锚定规划(memory-grounded planning)与计划条件执行(plan-conditioned execution)。
由此得到 MaP-WAM 的整体形态:维护一份结构化的多模态情景上下文,由任务指令、已完成片段的语言指令与稀疏视觉上下文组成;规划阶段用视觉-语言模型给出下一段的语言计划,再用因果世界模型从长时视觉上下文生成对应的视觉计划;执行阶段由 World-Action-Progress(WAP)模型在固定长度的计划前缀上联合预测动作块与执行进度。执行器上下文不随历史增长,块因果注意力还让规划与执行两侧都能做键值缓存。
但「跟随一个计划执行」带来一个新问题:一段计划需要执行多少个控制步,事先并不知道,它取决于任务难度与执行的随机性。论文的答案是把进度建模为一等模态:WAP 与动作一起生成进度序列,用进度门控决定何时切换片段;同时用视觉计划作为带时间索引的参照系,通过计划-观测对齐校准递归预测带来的进度漂移。这两点共同构成论文的第三个贡献。
预备知识
条件流匹配。对目标变量 $y$ 与条件 $c$,流匹配在流时间 $\rho\in(0,1)$ 上用高斯噪声 $\epsilon\sim\mathcal{N}(0,I)$ 插值构造噪声样本 $y^{\rho}=(1-\rho)y+\rho\epsilon$,再训练速度场模型 $v_{\theta}$ 拟合从数据到噪声的方向:
$$\mathcal{L}_{\mathrm{FM}}(y,c)=\mathbb{E}\left[\left\|v_{\theta}(y^{\rho},c,\rho)-(\epsilon-y)\right\|_{2}^{2}\right]$$
MaP-WAM 的视觉规划器与执行器都建立在这个目标之上:视觉计划、未来视觉 latent、动作块、进度序列各自作为一个流匹配目标,共享同一个条件。
Mixture-of-Transformers(MoT)。MoT 为不同模态的 token 配备各自的专家参数(独立的投影与归一化),在同一个 Transformer 主干里通过联合自注意力交换信息。MaP-WAM 在预训练视频 DiT 之外扩展出动作专家与进度专家,使视觉、动作、进度三种模态可以在一次前向里 jointly 去噪。
段级任务结构。论文把一条演示轨迹切分为语义连贯的片段,每段对应一条语言指令 $\text{l}_{k}$。RMBench 提供片段边界标注;推理时片段边界则由进度门控在线决定。这个结构是记忆组织与进度标注的共同骨架。
方法详解
问题形式化与分解。一般化的记忆依赖策略写作 $\pi(\text{a}_{t+1:t+h}\mid\text{f}_{\leq t},\text{s}_{t},\text{l})$,难点在于生成动作所需的关键信息可能只存在于历史观测 $\text{f}_{<t}$ 中。MaP-WAM 把它分解为两步:规划模块从第 $k$ 段之前的情景上下文 $\text{C}_{<k}$ 生成记忆锚定计划
$$\pi_{\mathcal{P}}(\text{C}_{k}\mid\text{C}_{<k})$$
执行模块在该计划的horizon 内预测短时程动作:
$$\pi_{\mathcal{E}}(\text{a}_{t+1:t+h}\mid\text{C}_{k},\text{f}_{t},\text{s}_{t},\text{l}),\quad[t,t+h]\subseteq\mathcal{H}(\text{C}_{k})$$
其中 $\mathcal{H}(\text{C}_{k})$ 是计划的规划horizon,不由设计者预先固定,而由后文的进度门控在线决定。由于 $\pi_{\mathcal{E}}$ 的输入与历史长度无关,执行器上下文在任务推进过程中保持恒定——这是全文效率论证的起点。
结构化多模态情景上下文。每个已完成片段 $i$ 贡献一条记录 $\text{C}_{i}=\{\text{l}_{i},\text{G}_{i}\}$:语言指令加稀疏视觉上下文,后者是从该段真实执行轨迹中均匀采样的定长帧序列($N=8$,即把片段等分成 8 个时间桶、每桶取最后一帧)。初始观测单独存为 $\text{G}_{0}=\text{f}_{0}$。规划第 $k$ 段之前,上下文前缀包含 $1+8(k-1)$ 帧,经 WAN-VAE 时间压缩后只剩 $1+2(k-1)$ 个 latent 时间步——记忆的增长被刻意压得很慢。
语言规划器。给定全局指令 $\text{l}$、已完成片段指令 $\text{l}_{<k}$,以及从 $\text{G}_{<k}$ 中抽取的紧凑关键帧集合 $\text{f}^{\star}$(初始帧加每段最后一帧),微调的 VLM 预测下一段的语言计划:
$$\pi_{\mathcal{P}}^{l}(\text{l}_{k}\mid\text{l}_{<k},\text{l},\text{f}^{\star})$$
实现上是 Qwen3.5-4B 加 LoRA(rank 32、alpha 64),提示模板把图像序列与已完成子任务列表交给模型,要求其输出「subtask k」的指令。语言计划只承担语义目标,细粒度的物体身份与空间关系交给视觉计划。
因果世界模型视觉规划器。视觉规划器 $\pi_{\mathcal{P}}^{v}$ 是一个因果世界模型(CWM),以已完成片段的长时视觉上下文 $\text{G}_{<k}$、语言计划 $\text{l}_{k}$ 与全局指令为条件,生成视觉计划 $\text{G}_{k}$,训练目标就是标准流匹配:
$$\mathcal{L}_{\mathcal{P}}^{v}=\mathcal{L}_{\mathrm{FM}}(\text{G}_{k},(\text{G}_{<k},\text{l}_{k},\text{l}))$$
CWM 的 token 按段组织成块,自注意力使用块因果掩码:块 $i$ 只能看到块 $j\leq i$,禁止跨段未来泄漏。交叉注意力里,已完成证据块只看全局指令 $\text{l}$,目标块才看段语言计划 $\text{l}_{k}$。于是已完成前缀的隐状态与目标块、与 $\text{l}_{k}$ 都无关,对应的键值状态可以一次算好、在同一 episode 的后续规划阶段反复复用。
World-Action-Progress 执行器。训练时为每个片段 $\text{f}_{i:j}$ 标注归一化进度 $\text{p}_{t}=\frac{t-i}{j-i}$,$t\in[i,j]$,作为对齐执行状态与视觉计划的连续时间坐标。WAP 在预训练视频 DiT 上用 MoT 扩展出动作专家(1.02B 参数、隐维度 1024)与进度专家(207M 参数、隐维度 256),给定段计划 $\text{C}_{k}=\{\text{l}_{k},\text{G}_{k}\}$、当前观测 $\text{f}_{t}$、本体感受状态 $\text{s}_{t}$ 与当前进度 $\text{p}_{t}$,联合预测未来视觉 latent、动作块与进度序列。视觉计划被编码为静态的干净前缀,当前观测是干净状态 token,未来视觉/动作/进度是带噪目标 token。注意力掩码允许动态 token 看计划与状态,但计划前缀不看任何动态 token,因此整个片段执行期间可以缓存;遵循 FastWAM 的做法,动作与进度 token 不看未来视觉 token,反之亦然,使未来视觉预测只作为训练期的辅助世界建模目标、推理时可以直接省略。
三个分支共享同一个流匹配条件 $c=(\text{G}_{k},\text{l}_{k},\text{f}_{t},\text{s}_{t},\text{p}_{t})$:
$$\mathcal{L}_{\mathcal{E}}^{m}=\mathcal{L}_{\mathrm{FM}}\left(y_{m},c\right),\quad m\in\{v,a,p\}$$
总损失为三分支加权和 $\mathcal{L}_{\mathcal{E}}=\lambda_{v}\mathcal{L}_{\mathcal{E}}^{{v}}+\lambda_{a}\mathcal{L}_{\mathcal{E}}^{{a}}+\lambda_{p}\mathcal{L}_{\mathcal{E}}^{{p}}$,实验中 $\lambda_{v}=\lambda_{a}=\lambda_{p}=1.0$;动作与进度分支共享同一个采样流时间步,未来视频分支用独立时间步。进度条件 $\text{p}_{t}$ 的作用很具体:它是一个显式时间锚,让执行器在不扩大观测窗口的前提下区分「视觉相似但语义阶段不同」的状态,例如按下与松开这两个几乎一样的画面。
计划-观测对齐校准进度。部署时没有真值进度,进度条件只能由 WAP 自己的预测递归更新,长时程下误差会累积。视觉计划提供了带进度索引的参照序列:每段开始时参照系由该段初始观测加 8 帧生成的视觉计划帧组成,进度从 0 到 1 线性分布在 9 帧上。每次推理动作块之前,取与当前估计 $\text{p}_{t}$ 最近的两帧参照,与执行后的当前观测 $\text{f}_{t}$ 比较 RGB 像素平均绝对差,把进度条件更新为 $\text{p}_{t}$ 与更相似参照帧进度索引的平均值。这个度量免训练、极轻量,但把执行锚定回计划的视觉演化上。
进度门控的片段切换。WAP 对最近若干动作的预测进度取平均得到完成分数 $s$,一旦 $s$ 超过阈值 $\tau=0.95$,就终止当前计划:把本段真实执行观测均匀重采样为稀疏视觉上下文 $\text{G}_{k}$,与语言计划一起作为新记录 $\{\text{l}_{k},\text{G}_{k}\}$ 追加进情景上下文,再调用规划模块生成下一段计划。注意写回记忆的是真实观测而非生成预测,上下文因此始终接地于真实世界。
flowchart TD
    A["Episodic context C_1..k-1
language records + 8-frame sparse visuals"] --> B["VLM language planner Qwen3.5-4B
predict segment plan l_k"]
    A --> C["Causal world model CWM
WAN-2.2-5B flow matching"]
    B --> C
    C --> D["WAP executor on fixed plan prefix
joint action + progress denoising"]
    D --> E["Plan-observation alignment
pixel-diff calibrates p_t"]
    E --> D
    D --> F{"mean progress score above tau = 0.95 ?"}
    F -- "no: execute next action chunk" --> D
    F -- "yes: segment complete" --> G["Resample real observations
append record l_k + G_k to memory"]
    G --> A
上图即论文 Algorithm 1 的闭环:规划只在片段切换时调用一次,执行在片段内反复查询 WAP;计划前缀在每段开始时 prefill 一次并缓存,直到进度门控触发新计划才刷新。
实验结果
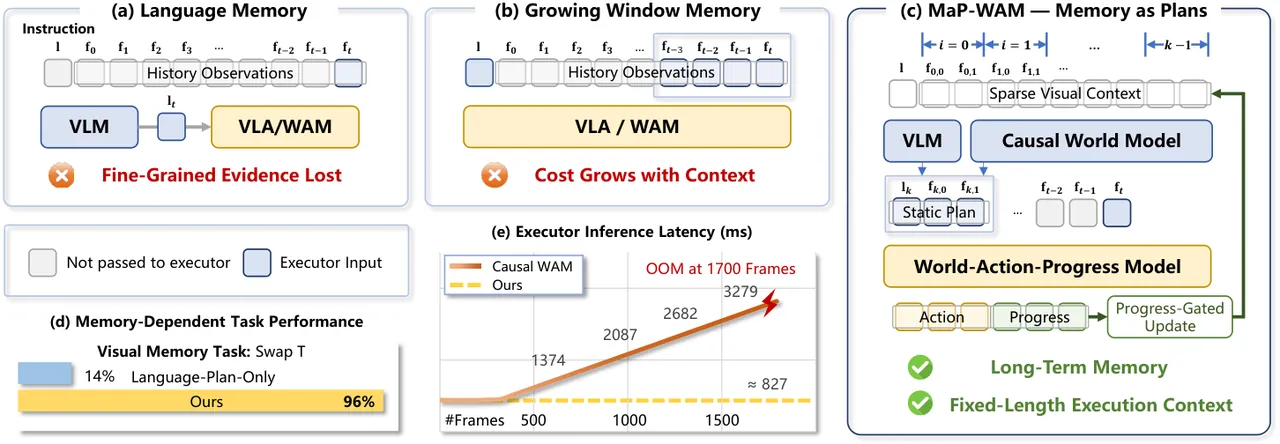
图1:语言记忆丢细粒度证据、增长窗口随上下文变贵,MaP-WAM 用稀疏视觉记忆 + 固定长度执行上下文兼顾两者。
仿真:RMBench。RMBench 是为长时程记忆依赖操作设计的仿真基准,含 5 个 M(1) 任务(决策依赖一条历史观测)与 4 个 M(n) 任务(依赖多条)。按基准协议,每个任务只用 50 条官方专家演示训练,每任务 100 次评测 rollout、全局种子 0;规划器多任务训练,WAP 按 MEM-0 的设定单任务训练。结果见下表:MaP-WAM 以 83.3% 的平均成功率超过所有基线,最强基线 LingBot-VA 为 77.1%,而 Mem-0 只有 42.0%,不带记忆的 DP、π0.5、X-VLA 均在 10% 上下。
| 任务 | TMC | DP | π0.5 | X-VLA | Mem-0 | WLA-0 | LingBot-VA | MaP-WAM |
|---|---|---|---|---|---|---|---|---|
| Observe and Pick Up | M(1) | 1% | 9% | 9% | 4% | - | 3% | 19% |
| Rearrange Blocks | M(1) | 0% | 13% | 13% | 89% | - | 100% | 66% |
| Put Back Block | M(1) | 0% | 11% | 18% | 90% | - | 100% | 100% |
| Swap Blocks | M(1) | 11% | 24% | 16% | 67% | - | 99% | 97% |
| Swap T | M(1) | 20% | 15% | 3% | 14% | - | 88% | 96% |
| Battery Try | M(n) | 10% | 16% | 26% | 28% | 45% | 41% | 82% |
| Blocks Ranking Try | M(n) | 10% | 6% | 1% | 18% | 23% | 100% | 94% |
| Cover Blocks | M(n) | 0% | 0% | 2% | 68% | 84% | 79% | 100% |
| Press Button | M(n) | 0% | 0% | 0% | 0% | 74% | 84% | 96% |
| 平均 | - | 5.8% | 10.4% | 9.8% | 42.0% | - | 77.1% | 83.3% |
逐任务看,最有信息量的是两类。其一是 Press Button 与 Swap T:前者要求区分视觉几乎相同的按下/松开阶段,后者要求记住两个 T 形积木的初始位置,MaP-WAM 分别拿到 96% 与 96%,正是进度条件与稀疏视觉记忆各自发力的地方。其二是 Observe and Pick Up:需要在几十种物体中辨别目标并联立时间上分离的观测与空间关系,每任务只有 50 条演示,MaP-WAM 把最强基线的 9% 提到 19%——绝对值仍低,说明细粒度视觉记忆任务远未解决,但方向增益是清晰的。反过来,Rearrange Blocks 上 MaP-WAM(66%)低于 LingBot-VA(100%)与 Mem-0(89%),作者未单独解释,从结构上看该任务的记忆需求较弱,固定计划前缀相对全上下文是一种约束。
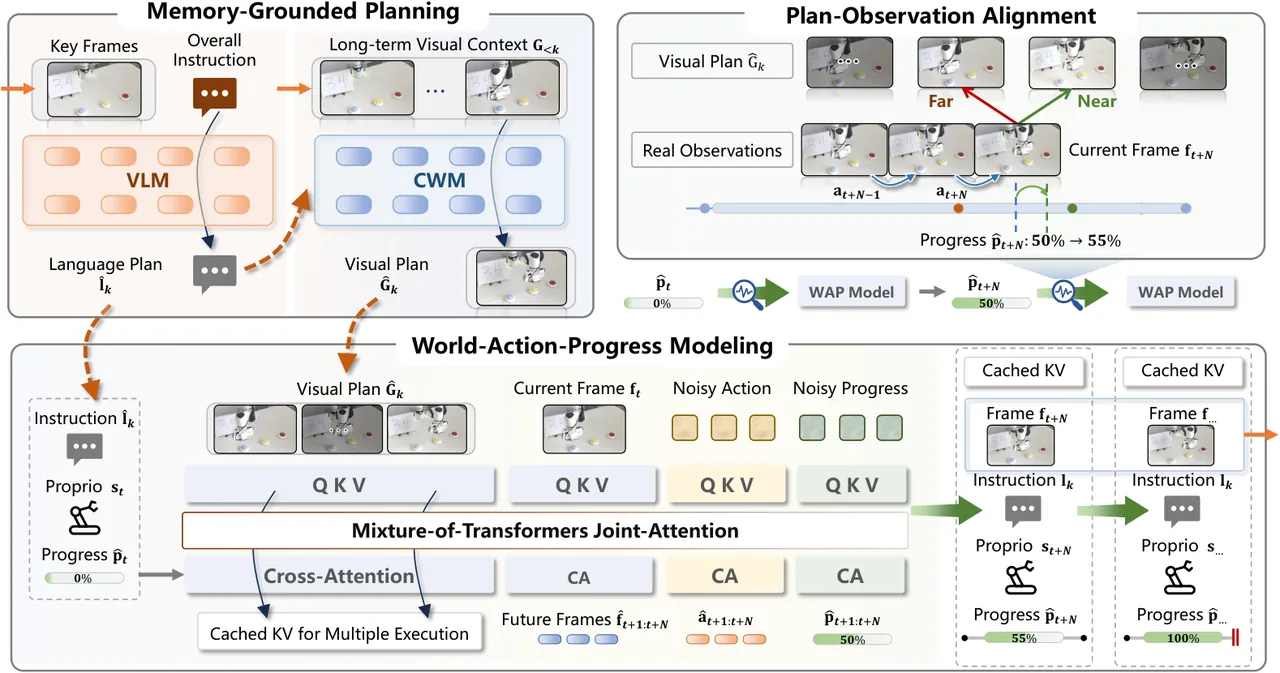
图2:框架总览。记忆锚定规划生成语言计划与视觉计划,WAP 在缓存的计划前缀上联合预测动作与进度,计划-观测对齐校准进度,片段切换时真实观测写回记忆。
真机:Franka Research 3。真机实验在 7 自由度 Franka Research 3 机械臂上进行,配第三方视角与腕部 RealSense D435i 相机。两个记忆依赖任务:Find Button 先让机器人观察一组按钮颜色,随后按钮被盖子遮住,人类在白板上给出颜色指令,机器人要打开对应盖子找到按钮;Press Buttons 要求观察白板上的两个数字,先按左、中按钮相应次数,再按右侧确认按钮。每任务采集 50 条轨迹训练、50 次独立试验评测,MaP-WAM 取得 88% 与 68%(平均 78.0%);基线在 Find Button 上靠随机选择拿到非零成功率,在 Press Buttons 上完全失败。
| 真机任务 | π0.5 | FastWAM | MaP-WAM |
|---|---|---|---|
| Find Button | 26% | 20% | 88% |
| Press Buttons | 0% | 0% | 68% |
消融一:视觉规划。在 Observe and Pick Up 与 Swap T 上比较两个变体:w/o visual plan 去掉 CWM、只给 WAP 语言计划;w/o visual memory 把 CWM 换成只看当前观测的标准世界模型。前者在两个任务上掉到 2% 与 14%,后者掉到 1% 与 13%,而完整版是 19% 与 96%。可视化显示,没有视觉记忆的规划器会生成物体身份、颜色或位置错误的视觉计划——视觉指导必须接地于长时情景证据,而不是当前帧。
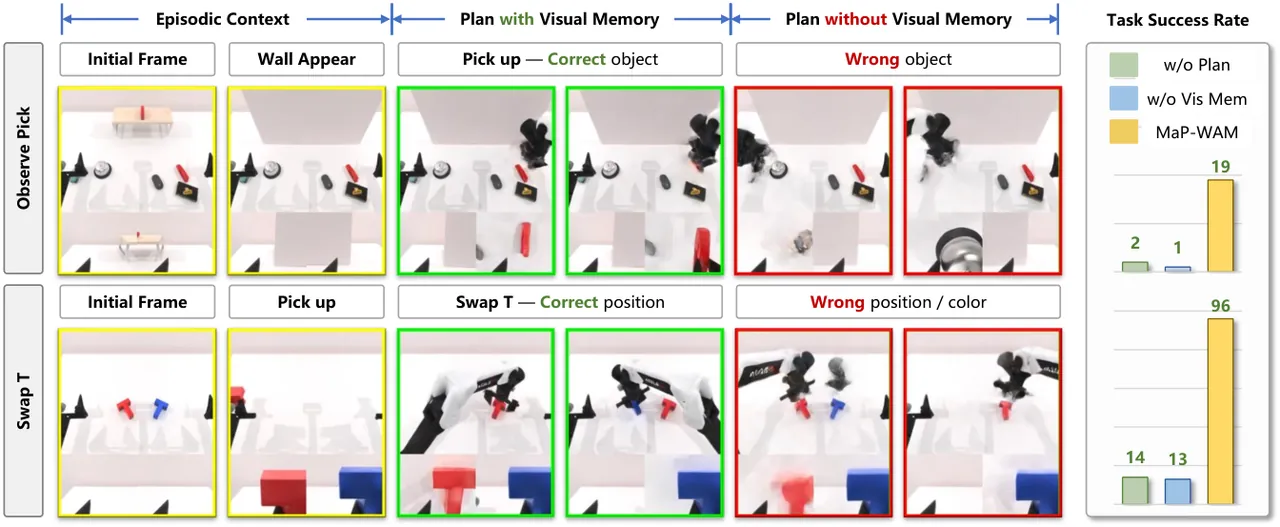
图3:视觉规划消融。同一情景上下文下,带视觉记忆的 CWM 生成物体与空间关系正确的计划;只看当前观测的世界模型生成错误物体/颜色/位置的计划。
消融二:进度建模设计。在三个较难的 M(n) 任务上比较:classification 用「本段是否完成」的分类 token 取代进度建模,平均只有 37.0%;w/o progress condition 保留进度预测但去掉条件输入 $\text{p}_{t}$,Press Button 从 96% 崩到 18%(无法区分按下与松开),平均 54.0%;w/o progress calibration 保留递归进度但关闭计划-观测对齐,在最长的 Blocks Ranking Try(子目标 swap a and b 平均 423.10 步,其余任务平均 116.32 步)上从 94% 掉到 38%,平均 73.7%;完整版 96.7%。三个数字分别对应进度作为模态、作为条件、作为闭环校准的三重作用。
| 进度建模变体 | Blocks Ranking | Cover Blocks | Press Button | 平均 |
|---|---|---|---|---|
| classification | 40% | 71% | 0% | 37.0% |
| w/o progress condition | 57% | 87% | 18% | 54.0% |
| w/o progress calibration | 38% | 85% | 98% | 73.7% |
| MaP-WAM | 94% | 100% | 96% | 96.7% |
推理效率。规划侧:稀疏视觉上下文每段只保留 2 个 latent 时间步,块因果注意力让已完成证据成为可缓存前缀,16 个连续片段后带 KV 缓存的规划延迟仍维持在约 450-470ms,无缓存则升到约 720ms;且规划只在片段切换时调用。执行侧才是延迟大头:与 Full Context 变体(同一执行器改为条件于逐帧增长的历史)相比,无缓存的全上下文延迟随历史快速增长,带 KV 缓存在 1500 帧时也约为零历史延迟的 4 倍,1700 帧时显存超过 80GB 直接 OOM;WAP 缓存固定计划前缀,在同一范围内维持约 827ms 每动作块的近似恒定延迟。记忆依赖能力的增益没有以执行效率为代价,这是该框架相对增长窗口路线最硬的卖点。
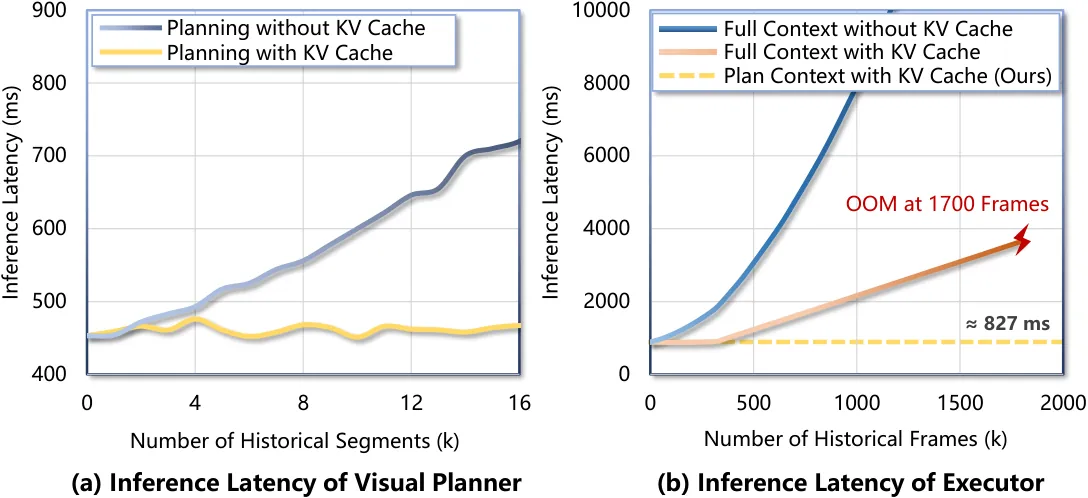
图4:延迟曲线。(a) 视觉规划器延迟随已完成片段数变化;(b) 执行器每动作块延迟随历史帧数变化,全上下文在 1700 帧 OOM,WAP 保持约 827ms。
局限性
作者自述其一:MaP-WAM 的记忆与进度组织依赖现有基准提供的片段结构,RMBench 的标注决定训练时的片段边界;把规划扩展到无分段演示需要自动片段发现,作者把它列为下一步工作。
作者自述其二:计划-观测对齐采用免训练的 RGB 像素平均绝对差作为相似度,作者承认在视觉复杂场景下学习型相似度度量可能更稳健。
补充判断:其一,WAP 按单任务训练(跟随 MEM-0 协议),执行器并未跨任务共享,真机与仿真的增益有多少来自记忆结构、多少来自每任务单独拟合,论文没有交叉验证;其二,仿真主结果里 Rearrange Blocks 明显落后于 LingBot-VA 与 Mem-0,Observe and Pick Up 绝对成功率也只有 19%,说明固定计划前缀在记忆需求弱或视觉辨别极细的任务上仍有代价;其三,真机只有两个任务、每任务 50 条演示,78.0% 的结论外推性有限;其四,语言规划器只看关键帧集合 $\text{f}^{\star}$,若下一段计划依赖片段中间的视觉细节,紧凑关键帧可能不够。
总结与展望
MaP-WAM 的贡献不在某个更强的骨干,而在一次职责重划:记忆服务于规划,规划产出计划,计划条件执行,进度闭环三者。这个划分同时解决了记忆机制的两个老矛盾——语言记忆丢视觉证据、增长窗口丢执行效率——代价是引入分段结构与进度标注的依赖。对工程实践而言,「执行器上下文恒定 + 规划/执行双侧 KV 缓存」是把长时程记忆带进实时控制的可行路径;对研究而言,自动分段发现与学习型计划-观测相似度是论文自己指出的两个自然延伸。若代码与权重按 Release Plan 放出,RMBench 上的 83.3% 与真机 78.0% 是否可复现,将是检验这套记忆范式的第一道关。
金句
「不要重放过去,而是从过去做规划。」——项目页对 MaP-WAM 核心思想的一句话概括:历史的价值不在于被反复观看,而在于被转化成下一步该做什么的计划。