Skip to content
← 标签

#世界动作模型 (43)

LoopWAM:从部署回放中闭环改进的通才机器人策略

LoopWAM:从部署回放中闭环改进的通才机器人策略

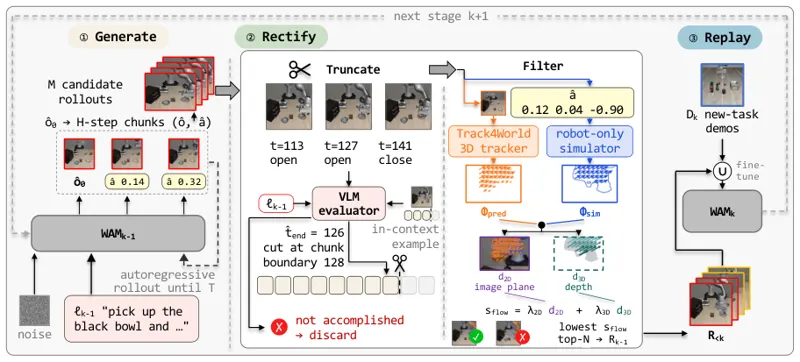
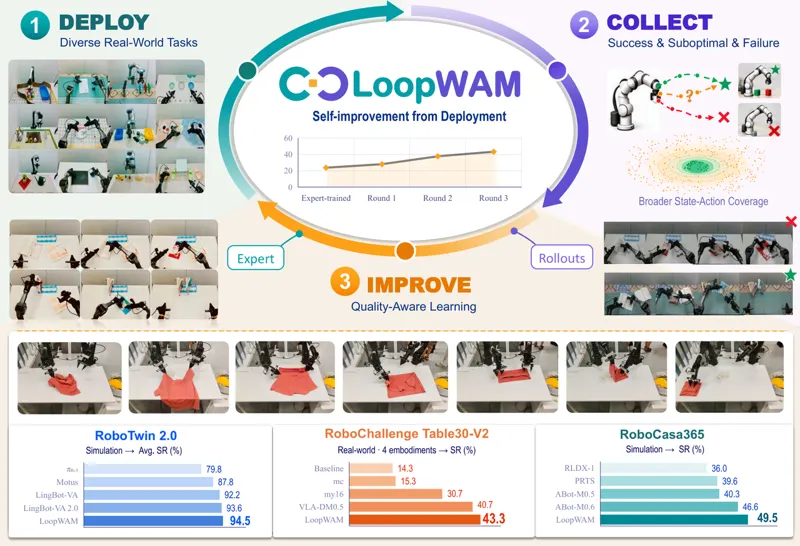
只堆专家示范,通才机器人策略并不会因为「上了真机」就变强:部署回放里既有成功,也有次优动作和彻底失败,逐个动作照抄会把坏行为一起学进去,而把失败样本直接丢掉,又丢掉了物理交互及其后果的证据。LoopWAM 是一个闭环的世界动作模型(world-action model),它直接从这份「全质量谱系」的回放里学习,回放既可以来自它自己,也可以来自别的已部署策略(X-VLA、π0.5)。方法上有三块互相咬合的设计:源相关噪声采样把行为学习与动作条件世界建模统一进同一个联合去噪目标——示范数据只对视频加噪、回放数据只对动作加噪,两条流在每一层的联合注意力里交互,学到的「后果」因此能直接参与动作生成;质量引导把质量分数写进指令后缀 Quality: q,部署时固定取最高档,使同一个模型既能被引导也能被评估;质量加权监督用 λ(q) 调节动作项的模仿强度(q=1,2 为 0.0,q=3 为 0.3,q=4 为 0.6,q=5 为 1.0),视频监督则在全质量段完整保留。模型由 Wan2.2-TI2V-5B 初始化,视频 DiT 30 层 3072 维、动作 DiT 30 层 1024 维,flow matching 训练。结果:RoboChallenge Table30-V2 上三轮「部署—采集—再训练」把成功率从 23.67% 拉到 43.33%(+19.7 个百分点),总分 36.10→56.80;RoboTwin 2.0 平均成功率 94.5%(用 LoopWAM、X-VLA、π0.5 三个策略共 22,500 条回放训练);RoboCasa365 总成功率 14.9%→49.5%,三项基准在对比方法中都是最好,且没有做额外的具身预训练。最难的叠衣服任务上,单任务后训练之后再跑两轮部署驱动改进,成功率从 13.20% 升到 55.56%。消融显示:完全不做质量引导只有 72.3%,粗粒度标注加上质量加权动作监督才到 94.5%。项目页 https://loop-wam.github.io/

Wenxuan Guo, Yingping Liang, Zhaoguo Wang · 265次阅读 · 2026年10月13日
世界动作模型自改进
2026年10月13日
Rolling-WAM:把世界动作模型的去噪摊到每个重规划周期

Rolling-WAM:把世界动作模型的去噪摊到每个重规划周期

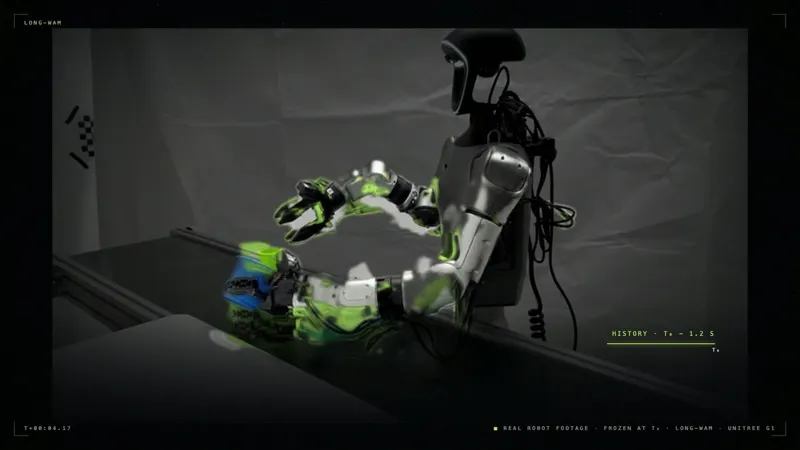
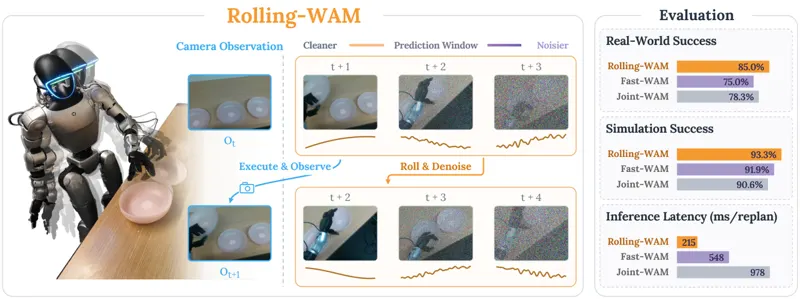
南加州大学、布朗大学、复旦大学与丰田研究院提出 Rolling-WAM。世界动作模型(WAM)把未来视觉预测与动作生成耦合,但标准做法要求每个重规划周期把整个预测视野从纯噪声完整去噪一遍,延迟巨大、闭环反应迟钝。作者指出 receding-horizon 控制实际只执行视野的开头一小段,未被执行的尾巴含有价值却被丢弃。Rolling-WAM 维护一个滑动窗口,窗口内越靠未来的 chunk 噪声越高:滚动模式下 chunk j 的噪声为 σ((j-1+τ)/W),第一个 chunk 在周期结束时变干净,且满足 σ_{j+1}(0) = σ_j(1) 的衔接条件,因此窗口前移后被保留的 chunk 恰好处于新位置的起始噪声,可直接接着去噪。每个 chunk 仍走满 N 步,但计算被摊到多个周期,稳态每周期只需 N/W 步。默认 N=10、W=5、K=16,即维持 80 个动作的预测窗口而每次更新只跑 2 步去噪。注意力掩码上,每个动作 chunk 可 attend 整个窗口的视觉特征,动作之间的直接注意力仅限同 chunk,视频 token 不 attend 动作 token,训练与推理一致。结果:稳态重规划 215 ms 对比 Joint-WAM 的 978 ms,加速 4.5 倍,比不做未来想象的 Fast-WAM(548 ms)还快,且比两个 VLA 基线(285/296 ms)更快;LIBERO 98.1%、RoboTwin 2.0 93.3%(全场最高,且无具身预训练即超过预训练的 LingBot-VA)、Unitree G1 真机三任务 85.0%。消融显示窗口 W=5 最优而 W=8 掉到 69.5%,且跨 chunk 直接动作注意力反而有害——动作应借道共享视觉未来协调。

Yinghua Zhou, Junjie Ye, Yiqi Zhao · 812次阅读 · 2026年9月24日
Rolling-WAM世界动作模型
2026年9月24日
MachEmbodied-U0:理想汽车的统一理解-生成具身基础模型

MachEmbodied-U0:理想汽车的统一理解-生成具身基础模型

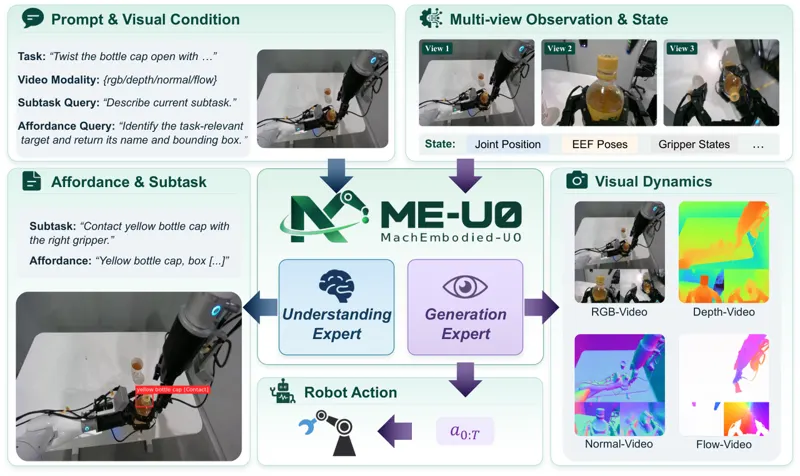
理想汽车 Foundation Model 团队提出 MachEmbodied-U0(ME-U0),一个把理解与生成专家统一进 Mixture-of-Transformers 架构的具身基础模型。理解专家以自回归文本生成输出子任务描述与可供性定位(含边界框、交互方式与交互点);生成专家用 flow matching 联合去噪未来视觉动力学(RGB、深度、表面法线、光流)与连续机器人动作,四种视觉模态共享同一个视频 VAE 隐空间与生成骨干,无需分模态预测头。Multi-rate Rotary Position Encoding(MRPE)解决动作比视频密三倍带来的时间对齐问题:保留视频隐帧的共享时间位置,给块内每个动作按次序分配不同的高度轴索引,配合 H_a = 3(H_v - 1) 的采样规则,形成每视频隐步对应 12 个动作步的一致跨模态时间结构。数据侧从约 5,700 小时机器人示范加 3,920 小时第一人称示范中精选出约 4,200 小时,覆盖四个开源数据集与六种本体(AgiBot G1 占 52.8%);三阶段清洗依次做突变检测、状态-动作一致性检查与物理边界检查;Ego2Robot 合成流水线用 Depth Anything 3、SAM3、ProPainter、SAM3D、两阶段 PPO 与 MuJoCo/Mink 逆运动学把人类示范转为机器人对齐的观测与轨迹标注。实验在下游不补任何子任务、可供性、几何与运动标注的前提下取得 RoboDojo 17.66 分(WAM 组最强,精度 23.95、长程 36.98 领先最明显)、LIBERO 99.0%、LIBERO-Plus 82.5%,并保留零样本的子任务预测、可供性接地与视觉动力学能力。作者诚实指出记忆类任务最弱(Score 8.42),因模型不显式保留观测历史。

Wen, Haoran, Wang, Wenfu, Shi, Kunsong · 1038次阅读 · 2026年9月22日
MachEmbodiedME-U0
2026年9月22日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。