Skip to content
← 标签

#流匹配 (28)

图像生成设计与前端梯顶C

FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线

Black Forest Labs 的 FLUX 家族用整流流(rectified flow)Transformer 做图像生成,并放出 Apache-2.0 的 dev 档权重,是开源侧最重要的图像基线;Kontext 一档把「按指令改这张图的局部而不动其余」做成了可用能力。采集库里另有 FLUX 3 的发布记录,厂商把它定位成统一图像/视频/音频的世界模型,这一主张记为待核验。

Apache-2.0开放权重档位(dev)厂商宣称 · 2024-08
产品Black Forest Labs官网Repo
FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线
EgoLAP:通过语言-动作推理从第一视角人类数据中学习

EgoLAP:通过语言-动作推理从第一视角人类数据中学习

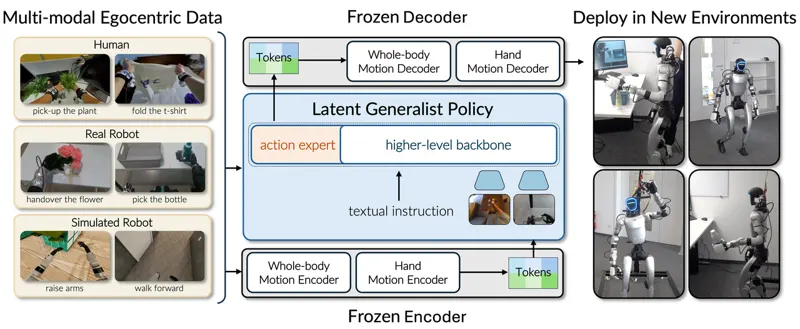
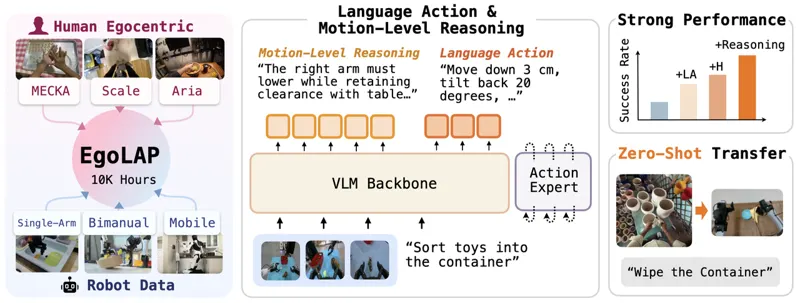
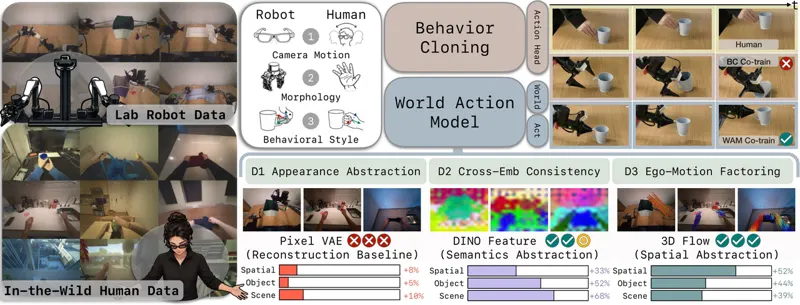
第一视角人类视频规模大、行为多样,但人手与机械臂之间的具身差异使原始人类轨迹难以直接作为机器人控制的监督信号。EgoLAP 的核心主张是:低层动作是具身特定的,但其背后的运动意图可以跨人类与机器人迁移。框架把运动意图写成两种共享的文本目标——用结构化、时间抽象的自然语言动作(language action)概括一秒内位姿与夹爪的变化,用运动级推理(motion-level reasoning)给出接触、几何与物体 affordance 层面的物理依据,二者串成一条人-机共享的语言动作思维链。模型以 PaliGemma-2B 为 VLM 主干,配一个 3 亿参数、从零初始化的动作专家,经流匹配预测连续动作块;文本目标只监督主干(知识隔离),推理期仅 rollout 动作专家、不生成任何文本,因而不牺牲实时控制。在约 1 万小时人-机混合数据(ABC、EgoVerse、OXE 等)上预训练后,EgoLAP 在定制双臂真机上取得 80.1% 的平均任务进度,比 FAST、OAT 等动作表示高 2.3 倍;在零样本双臂仿真上达 38.3%,比直接用同域真机数据训练的 ABC-VLA 高 1.8 倍。运动级推理与语言动作强协同(真机 +35.6 点),而对非语言 token 几乎无益;跨 embodiment 技能检索最多提升 25 点,表明共享文本目标重塑了表征几何。

Lihan Zha, Shresth Grover, Tenny Yin · 302次阅读 · 2026年10月6日
视觉语言动作模型操作Egocentric Vision2026年10月6日
生成、跟踪、改进:用 RL 微调运动生成器实现感知的多技能人形机器人运动

生成、跟踪、改进:用 RL 微调运动生成器实现感知的多技能人形机器人运动

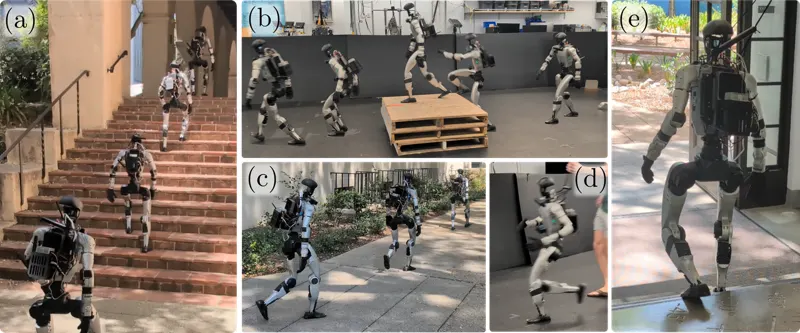
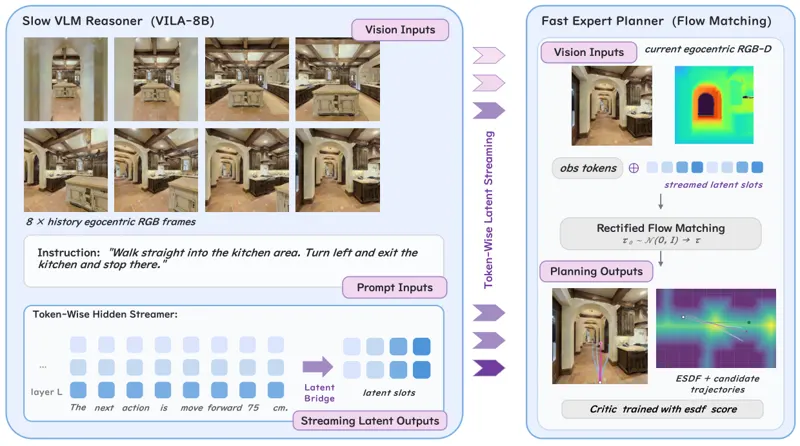
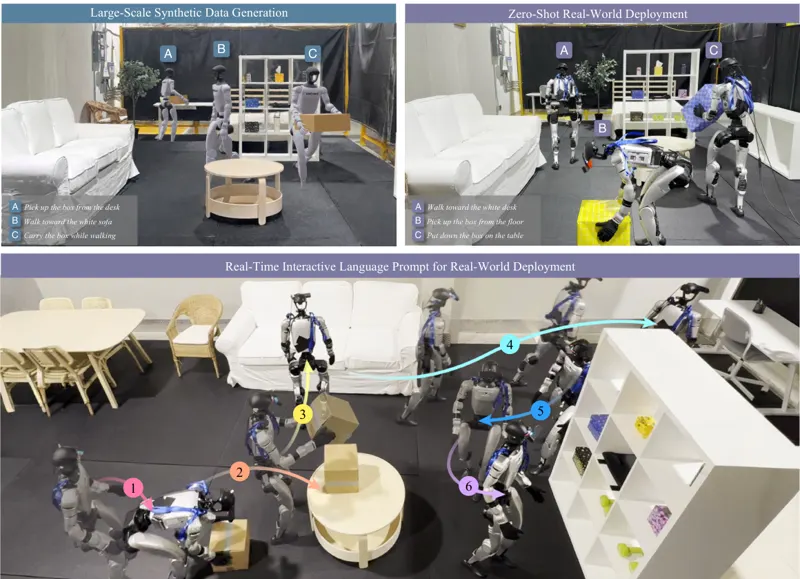
通用人形机器人需要的运动控制器必须同时具备多技能、感知、动态与足够的鲁棒性,才能去到人能去的地方。本文提出一个两层运动架构:(1)一个感知的流匹配运动生成器,从原始深度图规划全身轨迹;(2)一个用控制引导强化学习(CLF-RL)训练的感知跟踪策略,负责实时跟上这些动作。两张策略都训练在一个由动力学优化后的人体数据构建的、与地形一致的运动片段库上,因此既有准确的速度跟踪,又有与地形一致的参考。核心贡献是一个简单而有效的离线(off-policy)RL 微调环,用来改进运动生成器:配合生成器使用一种结构化搜索方法采数据,再做优势加权回归。这个离线环比在线的残差微调样本效率高得多,并且在没见过的几何与技能组合上提升了地形一致性——成功通过地形的比例最高提升 25 个百分点,技能选择最高提升 80 个百分点。因为直接用原始深度图感知环境,不需要里程计与高度图,室外部署很轻松;两个相机让策略能更早看到地形,无论指令速度是多少都能自主调速以通过地形。同一对策略让一台 Unitree G1 人形机器人在室外环境中行走、奔跑、站立、跳上跳下箱子并上下楼梯。项目主页:https://zolkin1.github.io/generate-track-improve/

Zachary Olkin, William D. Compton, Aaron D. Ames · 661次阅读 · 2026年9月25日
Humanoid LocomotionPerceptive Locomotion强化学习2026年9月25日
MachEmbodied-U0:理想汽车的统一理解-生成具身基础模型

MachEmbodied-U0:理想汽车的统一理解-生成具身基础模型

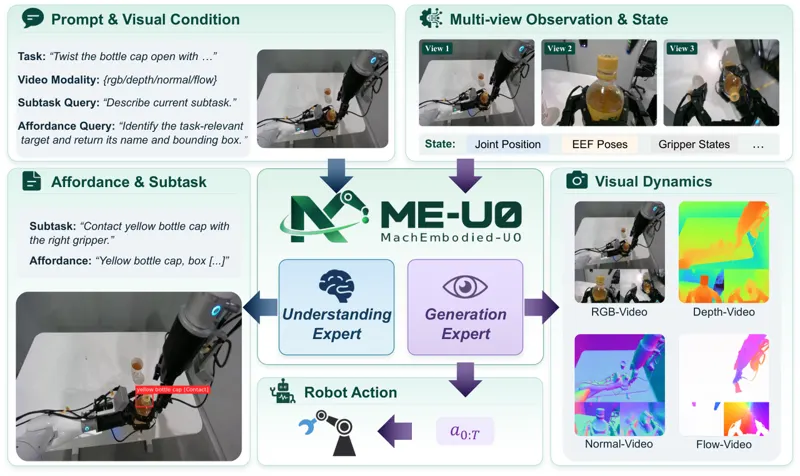
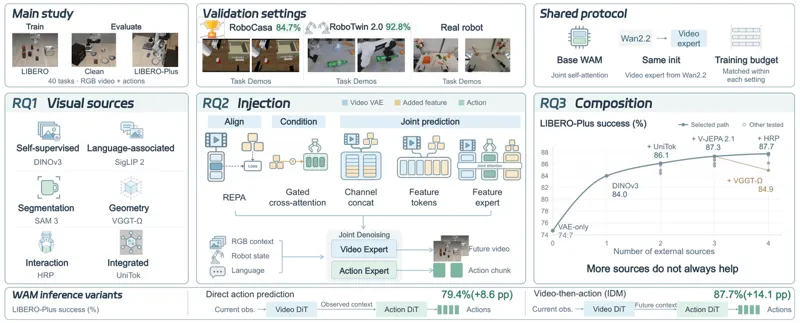
理想汽车 Foundation Model 团队提出 MachEmbodied-U0(ME-U0),一个把理解与生成专家统一进 Mixture-of-Transformers 架构的具身基础模型。理解专家以自回归文本生成输出子任务描述与可供性定位(含边界框、交互方式与交互点);生成专家用 flow matching 联合去噪未来视觉动力学(RGB、深度、表面法线、光流)与连续机器人动作,四种视觉模态共享同一个视频 VAE 隐空间与生成骨干,无需分模态预测头。Multi-rate Rotary Position Encoding(MRPE)解决动作比视频密三倍带来的时间对齐问题:保留视频隐帧的共享时间位置,给块内每个动作按次序分配不同的高度轴索引,配合 H_a = 3(H_v - 1) 的采样规则,形成每视频隐步对应 12 个动作步的一致跨模态时间结构。数据侧从约 5,700 小时机器人示范加 3,920 小时第一人称示范中精选出约 4,200 小时,覆盖四个开源数据集与六种本体(AgiBot G1 占 52.8%);三阶段清洗依次做突变检测、状态-动作一致性检查与物理边界检查;Ego2Robot 合成流水线用 Depth Anything 3、SAM3、ProPainter、SAM3D、两阶段 PPO 与 MuJoCo/Mink 逆运动学把人类示范转为机器人对齐的观测与轨迹标注。实验在下游不补任何子任务、可供性、几何与运动标注的前提下取得 RoboDojo 17.66 分(WAM 组最强,精度 23.95、长程 36.98 领先最明显)、LIBERO 99.0%、LIBERO-Plus 82.5%,并保留零样本的子任务预测、可供性接地与视觉动力学能力。作者诚实指出记忆类任务最弱(Score 8.42),因模型不显式保留观测历史。

Wen, Haoran, Wang, Wenfu, Shi, Kunsong · 913次阅读 · 2026年9月22日
MachEmbodiedME-U0理想汽车2026年9月22日
记忆即计划:基于记忆锚定规划的世界-动作建模

记忆即计划:基于记忆锚定规划的世界-动作建模

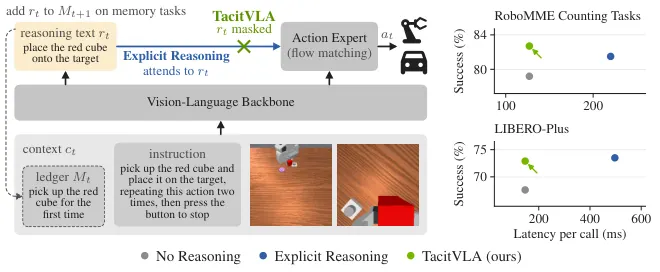
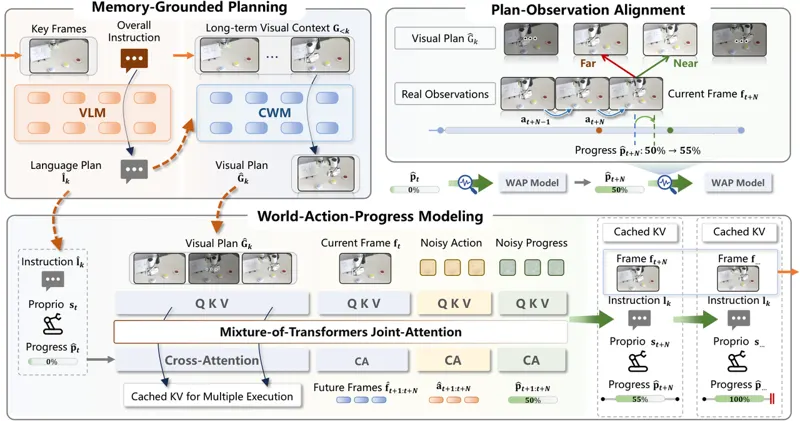
主流机器人策略把动作预测写成马尔可夫形式,只看当前观测或固定短窗口,但长时程操作往往是非马尔可夫的:决策所需的信息早已离开视野。MaP-WAM 提出「记忆即计划」:已完成的片段被记为「语言指令 + 稀疏视觉上下文」的结构化多模态情景记录(每段均匀采样 8 帧),规划时由微调的 Qwen3.5-4B 语言规划器给出下一段语言计划,再由基于 WAN-2.2-5B 的因果世界模型从长时视觉上下文生成对应的视觉计划,两者组成记忆锚定计划;执行侧的 World-Action-Progress(WAP)模型用 Mixture-of-Transformers 架构联合预测动作块、未来视觉 latent 与执行进度,进度作为一等模态参与条件与反馈。执行器只以固定长度的计划为前缀,上下文不随历史增长,块因果注意力让规划与执行两侧都可做 KV 缓存;计划-观测对齐用当前观测与视觉计划帧的像素差校准递归进度估计,进度门控(阈值 0.95)触发片段切换并把真实观测重采样写回记忆。RMBench 九个记忆依赖任务平均成功率 83.3%(最强基线 LingBot-VA 为 77.1%),真机 Franka Research 3 两个任务 88% 与 68%、平均 78.0%;1700 帧历史下全上下文执行器显存超 80GB 直接 OOM,而 WAP 保持约 827ms 每动作块的近似恒定延迟。局限:依赖基准自带的片段标注、未做自动分段;计划-观测对齐用免训练的像素差度量,复杂视觉场景下可换学习型相似度。

Sizhe Zhao, Haozhe Xie, Weiyu Zhao · 718次阅读 · 2026年9月10日
世界动作模型Long-Horizon MemoryMemory-Grounded Planning2026年9月10日
VLA-Corrector:面向自适应动作视界的轻量级检测与纠正推理

VLA-Corrector:面向自适应动作视界的轻量级检测与纠正推理

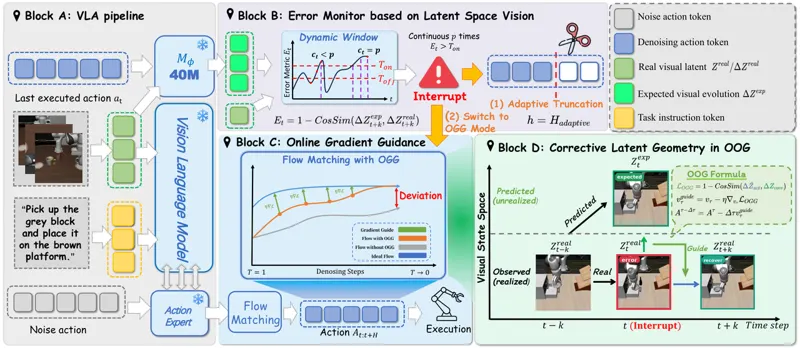
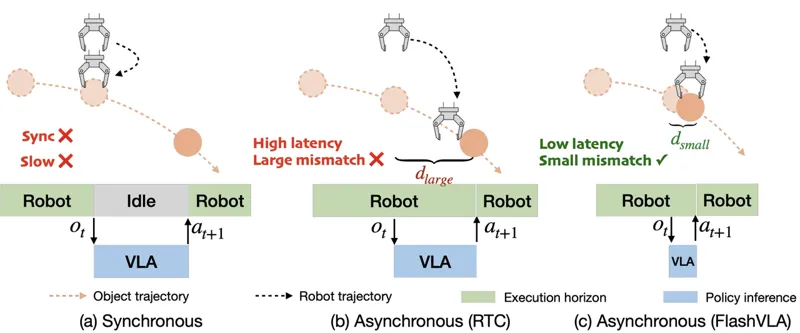
视觉-语言-动作(VLA)基础模型在具身智能上进展显著。为降低策略调用频率并保持时间连贯性,多数生成式策略采用动作块机制,在固定动作视界下以开环方式执行多步未来动作。然而这种先预测后盲目执行的范式牺牲了闭环反应性:在接触丰富的物理交互中,即使微小的局部扰动也会在开环盲区内迅速放大,导致误差复合并最终任务失败。为此本文提出 VLA-Corrector,一个面向动作块 VLA 策略的轻量纠正推理框架。在不修改主干策略权重的前提下,VLA-Corrector 引入轻量潜空间视觉监控器(LVM),持续比较预测与实际的视觉特征演化,实现在线检测视觉动力学偏差;一旦检测到持续偏差,系统触发截断事件、丢弃剩余陈旧动作,并通过在线梯度引导(OGG)发起纠正重规划。该检测-纠正机制自然诱导出事件触发的自适应动作视界:当前动作块可靠时保留长视界执行,执行开始漂移时调用短视界纠正重规划,从而缓解静态视界在执行鲁棒性与策略调用频率之间的权衡。VLA-Corrector 可在不重训 VLA 主干的情况下集成到不同 VLA 模型中,在保留动作块效率收益的同时中断复合误差,显著提升长视界、接触丰富机器人操作任务的鲁棒性。

Yi Pan, Miao Pan, Qi Lu · 580次阅读 · 2026年7月2日
视觉语言动作模型Robotic Manipulation动作分块2026年7月2日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。