PAPER DEEP DIVE
RelateAnything:任意区域输入下的实时开放词汇关系预测
开放词汇检测允许在推理时接受任意类别列表,可提示分割能在没有类别名的情况下返回区域:分类体系已经离开模型、成为输入,而关系预测尚未如此。场景图模型仍在一个标注风格的 50 或 56 个谓词上训练与评测,关系头以物体标签为条件,因而与单一检测器绑定。本文指出三个障碍:不存在既自由文本又经过验证的关系语料;以标签为条件的架构无法接受训练时没见过的词汇;标准指标奖励与训练语料的一致性,使更大的词汇量反而表现为退步。RelateAnything 是一个 5300 万参数模型,输入图像与任意来源的区域,输出在推理时以字符串形式给出的谓词词汇上的打分关系;物体标签从不作为输入,词汇是文本嵌入库而非学习出的分类器,推理速度为每帧 20 毫秒。为支撑 19103 个谓词的训练,论文提出正-未标注监督与能够区分反义词的文本编码器(对比式编码器把反义词嵌入到余弦 0.95),并构建 RA-4M:47.4 万张图像、430 万条关系、10102 个自由文本谓词,对着编号框标记生成并经几何门验证;评测上构建 OV-SGG-Bench 六轴跨数据集协议。在三个跨数据集基准与一个零样本基准上,平均召回达到同规模最强开放词汇方法的 2.3 至 3.5 倍,并以不足其 2% 的参数量超过 3B 视觉语言场景图模型;域内评测会把迁移收益高估约 5 倍。模型、语料与基准均已公开。
论文:RelateAnything: Real-Time Open-Vocabulary Relation Prediction From Any Inputs(arXiv:2609.12552v1)
作者:Maëlic Neau(独立研究者,无机构署名)
代码与数据:已发布。GitHub 仓库 Maelic/RelateAnything;HuggingFace 上有模型 maelic/relateanything 与语料 maelic/RA-4M;项目页提供浏览器内演示
内容类型:开放词汇场景图生成 / 视觉关系检测,与室内机器人感知(IndoorVG)直接相关
一句话总结
RelateAnything 把关系预测的词汇表从模型参数里搬出来,变成推理时传入的字符串:一个 5300 万参数的关系头接收图像与任意来源的区域,在 19103 条谓词嵌入库上打分,每帧 20 毫秒,跨数据集平均召回达到同规模最强开放词汇方法的 2.3 到 3.5 倍。
研究背景与动机
开放词汇检测与可提示分割已经完成了「去分类体系化」:检测器在推理时接受任意类别列表,分割模型返回区域而不需要类别名。分类体系不再是模型的一部分,而是模型的输入。关系预测却停在原地——场景图模型仍然在 Visual Genome 的 50 个谓词或 PSG 的 56 个谓词上训练和评测,关系头以物体类别标签为条件,于是模型与某一个检测器、某一种标注风格永久绑定。
论文把这种停滞归因于三个障碍,且明确指出三者都不是建模问题。第一,监督:不存在既自由文本又经过验证的关系语料,机器生成的语料从不校验自己的标注器。第二,架构:以物体标签为条件的关系头无法接受训练时没见过的词汇,换词汇表等于重新训练。第三,度量:标准召回指标奖励的是与训练语料的一致性,一个不用像素的频率查表就能赢下排行榜指标,于是更大的词汇量在旧指标下反而表现为退步。
这三个障碍彼此咬合。频率查表之所以强,是因为它复述了训练语料的标注先验;而模型一旦以物体标签为输入,就免费获得这份先验,同时继承了它不迁移的部分。论文在表 1 中给出了最直接的证据:在逐边 top-1 准确率上,无像素的频率基线在三个基准上全部超过训练好的模型约 15 个百分点;而在逐谓词宏观平均上,同一批预测让模型反超 29% 到 86%。查表返回每个类别对的多数谓词,微观指标奖励这一点,宏观指标惩罚这一点。结论很窄但锋利:一个无像素查表能赢的指标,度量的不是关系理解,而它恰好是给排行榜排序的指标。
对机器人系统而言,这个问题不是学术性的。室内场景图基准 IndoorVG、操作场景中的接触与承载关系、以及「把检测器换成跟踪器或分割器而不重训关系模型」的需求,都要求关系头与物体标签解耦。论文的回应是三件套:一个验证过的自由文本关系语料 RA-4M,一个标签无关的关系模型 RelateAnything,以及一个跨数据集的六轴评测协议 OV-SGG-Bench。
论文的立场也由此确定:不追求在旧协议下刷分,而是先论证旧协议量错了东西,再在新协议下报告所有结果。全文没有任何一个域内数字作为主结果出现,每个单元格都来自训练时排除的图像与标注,并附上训练语料与基准之间的三元组重合度,让读者自行判断一个数字里有多少是先验匹配。
预备知识:场景图评测到底在量什么
场景图生成的标准协议是:给定图像与区域(真值框或检测框),对有序物体对预测谓词,用 R@K 与 mR@K 报告召回。mR 对每个谓词单独算召回再平均,因此对长尾敏感;R@K 被头部谓词主导。论文指出召回指标有三个被奖励的先验:共享三元组质量(训练语料与基准标注了同一批三元关系)、物体类别先验(类别对几乎决定谓词)、以及标注倾向(某些配对天然更容易被标注)。
第二个被忽视的变量是评分约定。匹配器是否允许同义词容忍、是否强制一对一指派、检测器的置信阈值与框数上限,每一项对结果的影响都大于方法之间的差异。论文实测:仅检测器工作点一项,就能解释所有已发表 OvR-SGG 方法之间 4.3 个百分点的差距;配对召回对物体召回是二次的,因此检测器召回构成了任何关系模型的上限。
OV-SGG-Bench 由此定义六个机会校正轴:A1 跨数据集迁移、A2 在人工裁定负例上的精度、A3 全词汇开放度、A4 真实检测器模式、A5 无真值时的图质量、A6 对抗性空间负例。综合分取各轴机会校正值的调和平均,只有能在全部轴上运行的系统才给出综合分。
方法详解
输入契约:像素、区域、字符串
模型的输入是三样可分离的东西:一帧图像、一组区域(来自任何检测器或分割器,其类别标签被丢弃)、以及推理时以字符串形式给出的谓词词汇表。输出是带分数的三元组 (i, j, p)。两条约束随之而来:物体标签永远不是网络输入,只在两个损失项里出现(采样器的相关性损失与物体-文本接地项);文本侧没有任何学习到的变换,因为对训练词汇拟合的投影对后来传入的字符串无定义。换词汇表因此只是替换一个矩阵,不需要重训。
视觉通路:一次编码,处处池化
DINOv3 骨干(ViT-S/16+)以 448×448 编码图像,在深度 -6、-3、-1 三处读取 patch 特征,逐 tap 做 layer norm 后用学习权重融合。物体特征不靠裁剪,而靠坐标感知的软池化:由框 b_i 的傅里叶位置编码构成查询,对全部 patch token 做交叉注意力,
$$v_{i}=\mathrm{Attn}(q(b_{i}),F,F)$$
这样物体的表示可以包含它所交互的上下文。骨干以比头部低 8 倍的学习率全量微调。
对表示:把接触区当作一等特征
有序对的表示由五路特征拼接后投影到 512 维:
$$x_{ij}=\big[\,v_{i};\;v_{j};\;v_{\cup(i,j)};\;v_{\cap(i,j)};\;\mathrm{MLP}(g_{ij})\,\big]\,W_{\mathrm{proj}},\qquad x_{ij}\in\mathbb{R}^{512}$$
其中 v_∪ 池化并集框,v_∩ 池化接触区(框重叠时取交集,否则取两框之间的间隙),g_ij 是 19 维尺度不变几何特征(15 个框特征加 4 个仅掩码槽位)。随后一个小 Transformer refinement:对采样到的配对做自注意力、对场景 token 与配对自身框角 token 做交叉注意力,再接一段配对与场景的联合自注意力。最后是一个加性阶段:每对预测围绕四个锚点的采样偏移,通过零初始化门读取特征图。正是这个阶段让 parked on 由路面决定、hanging from 由主体上方的附着点决定。
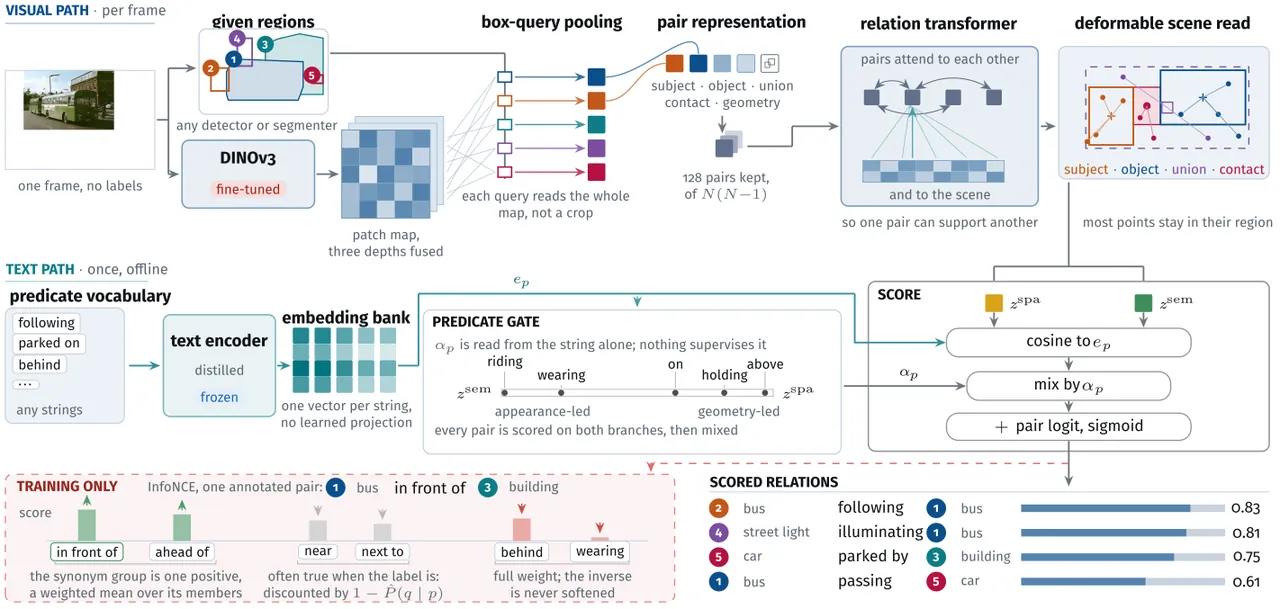
图 1:RelateAnything 总览。上带为视觉通路(区域来源不属于模型,其标签被丢弃);中带为文本通路与谓词条件门;下带为仅训练期的损失结构。来源:论文图 2 / 项目页架构图。
双分支与谓词条件门
空间关系与语义关系依赖的证据不同,头部因此对每对打两次分,并按谓词混合两个余弦通道:
$$\ell_{\mathrm{pred}}(i,j,p)=\tau\big[\alpha_{p}\cos(z^{\mathrm{spa}}_{ij},e_{p})+(1-\alpha_{p})\cos(z^{\mathrm{sem}}_{ij},e_{p})\big]+\beta$$
其中 e_p 是谓词的文本嵌入,α_p = g(e_p) 只依赖该嵌入本身,因此对没见过的字符串也有定义。门没有任何直接监督,但学到的权重强双峰:投影与邻近关系被路由到几何分支(behind 1.000、below 0.9998、above 0.970),动作路由到外观分支(carrying 0.0004、parked on 0.0008、riding 0.012),接触谓词居中(holding 0.82、on 0.64、wearing 0.22);中位数 0.002,仅 12% 的谓词超过 0.5。由于两分支在混合前各自打分,一次前向可以同时解出布局图与内容图。
采样:从 N(N-1) 到 128
两阶段采样器先用几何合理性从 N(N-1) 个有序对中保留 400 个,再用学习到的相关性分数保留 128 个,保留 99.79% 的标注正例;穷举打分的代价是 1.02 倍且无可测量收益。学习阶段被训练去预测哪些配对带标注,因此它学到的是标注倾向;其 logit 以加法形式进入最终分数,于是可以在评测时移除并单独度量它的贡献。
一万谓词下的正-未标注监督
模型对着 19103 条自由文本谓词训练:RA-4M 自己的 10102 条,加上另外三个关系语料词汇表中的 9001 条(只用词汇表,不用其关系)。主目标是批内 InfoNCE:正例是标注谓词的同义词组,组内成员按估计的同义概率加权并取加权平均;负例是批内其他谓词。在 50 个谓词下把未标注当作负例大致正确,在一万谓词下则系统性错误:若 (man, horse) 被标注为 riding,则 sitting on 与 mounted on 为真但未被写出,惩罚它们等于教模型压制正确答案。
论文的处理是正-未标注折扣:对每个有序谓词对估计「标注 p 时 q 也成立」的概率,在 706k 个多标注框对上用共现计数、文本空间余弦与频率拟合,并套用 Elkan-Noto 校正以区分「未标注」与「为假」。负例 q 的分母 logit 变为
$$\ell_{\mathrm{pred}}(i,j,q)+\log\big(1-\hat{P}(q\mid p)\big)$$
几乎必然同真的谓词对分母几乎没有贡献;带多条标注的配对按独立组合折扣。两条豁免是必需的:被标注的谓词从不降权;方向性反义(above 与 below)永远全权,因为区分上下正是最不能被软化的监督。正例侧的同义权重是对 1177 个词汇同义对在文本余弦上的 isotonic 拟合;方向性交换 hinge
$$\mathcal{L}_{\mathrm{swap}}=\max\big(0,\;m-c(i,j,p)+c(j,i,p)\big),\qquad m=0.05$$
按谓词的方向概率加权,使主宾顺序进入损失。目标中没有任何语义常数是手设的。
文本空间:反义词必须分开
头部把视觉特征回归到文本方向上,因此文本空间的几何限制了模型能表达什么。对比式文本编码器恰好在关系最依赖的维度上失败:反义词出现在几乎相同的上下文里,嵌入也几乎相同。教师编码器(dino.txt,2048 维)把 above 与 below 放在余弦 0.95,in front of 与 behind 放在 0.94,to the left of 与 to the right of 放在 0.99,与其同义对的平均 0.96 无法区分。去掉均值方向也救不了。
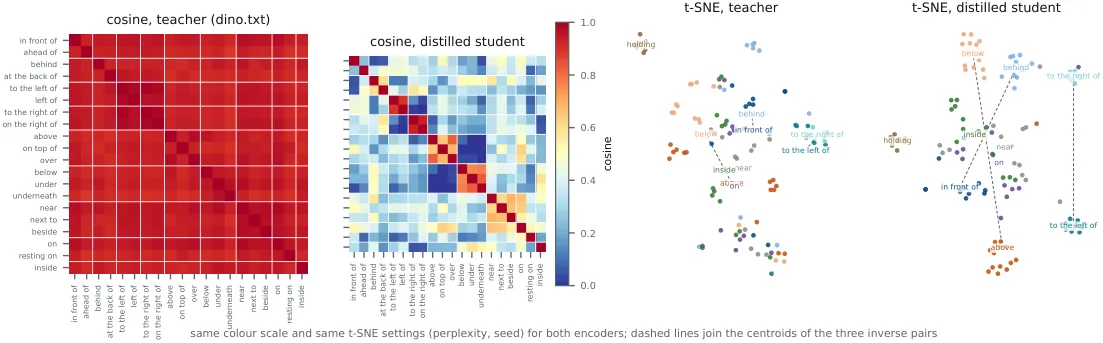
图 2:教师与蒸馏学生的文本空间。左两列为 20 个空间谓词的成对余弦,右两列为 10 个同义族的 t-SNE。教师把反义对混在同一簇里,学生保留同义块、把反义块压到近零并拆成两簇。来源:论文图 3。
解法是在完整 CLIP BPE 词表上蒸馏一个 512 维学生编码器,使任何谓词字符串都不会出词表。五个目标中,已知反义对上的反义排斥 hinge 是冻结教师给不了的;邻域保持项则阻止学生用廉价方式买到分离——没有它,学生能在有效维度 24(而非 44)上达到同样的同义/反义 AUC。蒸馏后该 AUC 从 0.85 升到 0.99,反义平均余弦从 0.92 降到 0.09 而同义保持 0.71,hubness 从 8.1 降到 1.3。学生只离线使用,推理时模型携带嵌入库。
RA-4M:可验证的机器标注
语料由开源视觉语言模型(Gemma 系)在带编号标记的图像上生成:每个框中心一个彩色圆点携带框编号,使接地成为标注器的输入而非从其输出反推。每条候选关系再过一道确定性几何门(拒绝 11.3% 的原始候选):门只在框几何逻辑上约束谓词时触发,因此拒绝是「在框标注误差内的真负例」,几何约束不了的谓词原样通过并被计为残余风险。门后 containment 关系 0%、contact 关系 0.1% 出现不相交框;语料无重复三元、无自环。方向修复是唯一不拒绝的门:left/right 与 above/below 按框交换主宾;随后每条已验证的方向关系以 1/2 概率从另一端重述,使语料方向平衡。
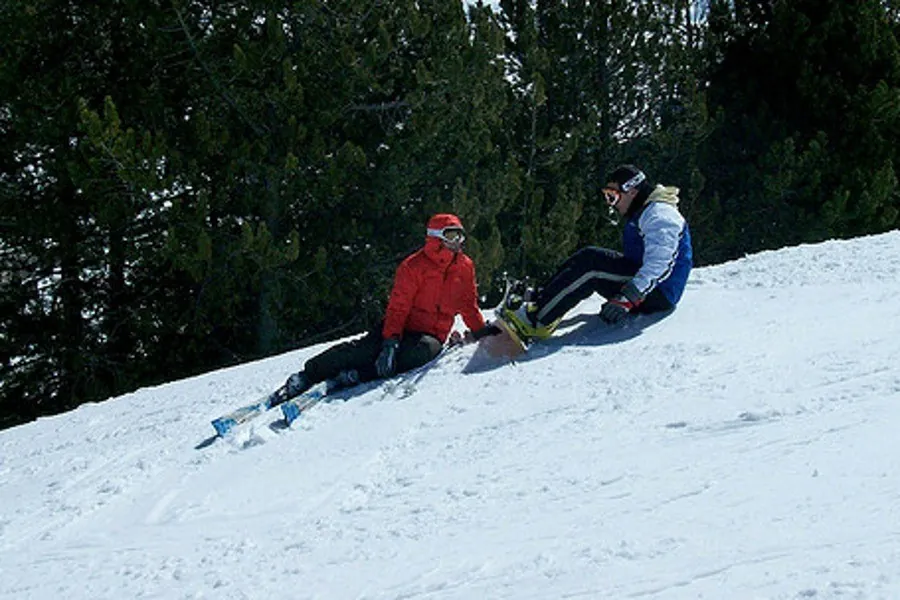
图 3:RA-4M 语料图像样例:一张图、若干区域、一条经几何门验证的自由文本关系。来源:论文图 1 左。
最终语料为 474413 张图像、4282531 条关系、10102 个不同自由文本谓词、每图 9.03 条关系,生成成本 104 GPU 小时。相对同一图像同一框上的源标注,RA-4M 密度 1.7 倍(9.03 对 5.29)、词汇量 107 倍、谓词熵高 1.4 nats,并复现 94 个源谓词类中的 73 个为精确字符串。分布仍长尾(前十谓词占 57%),但头部换成了 behind、in front of、wearing、to the right of、to the left of 这类方向平衡的空间谓词;物体平均度从 1.88 升到 3.20,单连通分量图像占比从 70.9% 升到 82.6%。
flowchart TD
  A["输入帧 448x448 无物体标签"] --> B["DINOv3 ViT-S/16+ patch 特征 taps -6 -3 -1"]
  R["任意区域来源 检测器或分割器 类别标签被丢弃"] --> P["坐标感知软池化 v_i = Attn q(b_i) F F"]
  B --> P
  P --> C["有序对表示 主体 客体 并集 接触区 几何MLP 投影到 512 维"]
  C --> S["两阶段采样 N乘N减1 到 400 再到 128"]
  S --> T["配对 Transformer 对间自注意力 场景交叉注意力"]
  T --> D["可变形场景读取 四锚点偏移 零初始化门"]
  D --> Z["双分支 z_spa 与 z_sem"]
  V["推理时谓词字符串 冻结学生嵌入 19103 条库"] --> G["谓词条件门 alpha_p = g(e_p)"]
  G --> M["按谓词混合余弦 加配对 logit 与温度偏置"]
  Z --> M
  M --> O["打分关系图 编译后每帧 20 毫秒"]
  subgraph TRAIN["仅训练期"]
    L["InfoNCE 同义词组正例 正未标注折扣负例"]
    E["学生文本编码器 反义排斥 加 邻域保持"]
  end
  E --> V
  Z --> L
图 4:按论文第 3 节绘制的真实方法流程:视觉通路、文本通路、谓词条件门与训练期目标的连接关系。
实验结果
A1:跨数据集迁移
四个基准全部跨数据集:图像、物体分布与标注风格均未见,唯一例外是标注出的 HICO-DET 行。RelateAnything 不收物体标签,基线 OvSGTR 收真值标签。结果是在每个源的每个指标上全面领先:头部召回为基线的 1.04 到 1.40 倍,平均召回 2.3 到 3.5 倍,稀有桶召回 5 到 21 倍(VG150 上基线稀有召回恰为 0.0,比值无定义)。三元组重合度列解释了差距的来源:VG150 是 OvSGTR 自己的基准,其 90.9% 的训练三元组质量与基准重合,而本文模型只有 12.8%;基线在那一行的主打数字由 21 个高频谓词携带,那正是无需视觉输入即可恢复的部分。
| 基准 | 三元组重合度 | OvSGTR R@50 | OvSGTR mR@50 | OvSGTR F1@50 | RelateAnything R@50 | RelateAnything mR@50 | RelateAnything F1@50 |
|---|---|---|---|---|---|---|---|
| VG150 | 13% | 39.9 | 10.4 | 16.5 | 53.3 | 28.2 | 36.9 |
| PSG | 11% | 28.7 | 8.8 | 13.5 | 40.1 | 30.6 | 34.7 |
| IndoorVG | 7% | 48.1 | 12.8 | 20.2 | 52.7 | 29.5 | 37.8 |
| HICO-DET(零样本塔) | — | 34.0 | 4.5 | 7.9 | 35.3 | 12.7 | 18.7 |
表 1:轴 1 跨数据集迁移(论文表 4)。测试集、真值框、图约束、同一评测器;基线获得真值物体标签,本文模型没有。
六轴与综合分
六轴上没有任何一轴是域内的。A2 在人工裁定的负例上量精度:平均 fAP 72.6 对 52.1,稀有谓词 fAP 70.7 对 44.6,说明召回优势不是靠乱断换来的。A3 把答案集收回:模型从全部 19103 条字符串作答并以同义容忍匹配,VG150 上 R@50 为 56.0,反而高于提供基准 50 条字符串时的 53.3,真值字符串在 19103 个候选中的中位排名在 VG150 与 IndoorVG 上是 1、PSG 上是 10。A4 在共享 YOLO-World 检测器下:wR@50 20.0 对 4.0,而配对召回上限只有 69.6。A6 在对抗性收集的 SpatialSense 负例上:宏观 AUC 69.0 对 59.1,仅用框的基线为 68.8,说明空间轴上模型刚刚超过「只看几何」。
| 轴 | 度量 | 最强基线 | RelateAnything |
|---|---|---|---|
| A1 迁移 VG150 | F1@50(mR@50) | 19.6(15.2)ROBIN-3B | 36.9(28.2) |
| A1 迁移 PSG | F1@50(mR@50) | 27.9(22.9)ROBIN-3B | 34.7(30.6) |
| A1 迁移 IndoorVG | F1@50(mR@50) | 22.7(21.5)ROBIN-3B | 37.8(29.5) |
| A2 精度 | 平均 fAP(稀有 fAP) | 52.1(44.6)OvSGTR | 72.6(70.7) |
| A3 开放词汇 | mR@50,VG/PSG/Indoor | 20.9 / 25.1 / 25.4 ROBIN-3B | 34.5 / 28.3 / 34.6 |
| A4 检测器模式 | wR@50(mR@50) | 4.0(6.2)OvSGTR | 20.0(20.5) |
| A5 图质量 | 真信息比特/图(占标注比) | 13.4(0.48)OvSGTR | 18.6(0.67) |
| A6 空间 | 宏观 AUC(池化 AUC) | 59.1(61.7)OvSGTR | 69.0(67.5) |
| OVS 综合 | 机会校正轴调和平均 | 11.8(仅 OvSGTR) | 40.1 |
表 2:OV-SGG-Bench 六轴与综合分(论文表 3)。基线列是两套系统的包络,综合分只对 OvSGTR 单独计算。
开放词汇轴上的自由文本系统
A3 还容纳了一类其他轴装不下的基线:以 3B 视觉语言模型为骨干的 ROBIN-3B,以及 Qwen3-VL、InternVL3.5、GLM-4.6V 等通用多模态模型。在真值区域、同一套生成结果、不同匹配器下:匹配器本身的价值超过方法差异——把自由文本映射到基准词表给 ROBIN 加 11.7 个 R@50,给本文模型加 23.2。在同义容忍匹配下本文模型宏观召回 31.3 对 ROBIN 的 25.1,而微观召回仍由 ROBIN 领先,两个指标方向相反,正是先验分析预测的形态。更稳定的是配对覆盖:本文模型 99.7%,ROBIN 45.6% 到 77.4%,通用模型 23.1% 到 35.5%——没被命名的配对不可能带上正确谓词,规模主要买的就是这个。
图质量:用信息量而不是条数
A5 面对的问题是「没有真值时如何比较两张图」。论文让视觉语言裁判只判断每条关系是否为真,再用参考分布下的 surprisal 给被接受的关系计价:
$$I=\sum_{r:\,\mathrm{judge}(r)=\mathrm{true}}-\log_{2}p_{\mathrm{ref}}\!\left(\mathrm{pred}(r)\right)$$
两个因子互相补短:只看 surprisal 会奖励随机发出的稀有谓词(裁判判假),只看真值会奖励 on(2.31 比特,而 riding 为 7.04 比特),两者都无法靠重复抬高。在等深度(每系统前十对)下,本文模型每图 18.6 真比特对基线 13.4;在各自部署深度下为 28.7 对 14.1。裁判接受率上基线略高(4.33 对 4.07 / 每图 9.8 条),但单条信息量 3.09 对 4.57 比特:基线的图更「安全」也更冗余。
解耦物体与关系:探针给出的否定答案
第 7 节回答「关系监督是否在共享骨干里留下关系表示」。答案是否定的。微调使类选择性从 0.242 升到 0.281,而关系选择性几乎不变(0.133 到 0.138);「关系伙伴比同类无关物体更相似」的概率从 0.469 降到 0.385(机会 0.500)。接触区确实变化:相对远处主体 patch 的接触优势从 0.356 升到 0.438,特征从覆盖整个人变为覆盖手与物体;但它编码的是物体身份——跨图 1-NN 检索物体类达 0.761(机会 0.068),检索动词只有 0.269(多数类机会 0.424),低于机会。
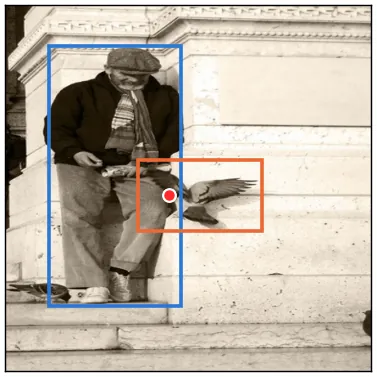
图 5:接触区相似度图。微调前手部查询高亮整个人,微调后高亮手与鸟;从鸟侧查询得到同一区域,说明该区域编码「哪个物体被操作」而非「在做什么」。来源:论文图 7。
归因侧同样干净:输入通道摘除阶梯显示去掉像素损失 44% 到 68% 的微观准确率,去掉框几何损失 6% 到 24%,而去掉物体到文本通道只损失 0.1%;语义 logit 的精确方差分解中配对上下文占 87% 到 93%,主/客特征占 0.1% / 0.0%。标签依赖实验里,基线 88% 到 90% 的输出可被「自身标签对多数谓词表」复现,打乱标签后输出统计不变;本文模型无法看到标签,其残余 69% 的查表重合是从像素恢复的类别先验(人穿衣服、杯子放在桌上)。
同一模型,两种区域来源
解耦的直接红利是区域来源可换。同一 checkpoint、同一校准工作点(p≥0.45,恰好发出 PSG 自身的每图 6.0 边密度)、同一 19103 谓词库下,YOLOE-11 的开放词汇检测框与 FastSAM 的无类别分割掩码给出两张都成立的关系图:检测行 8 条关系,分割行 18 条。物体名只用于展示,从不进入模型。
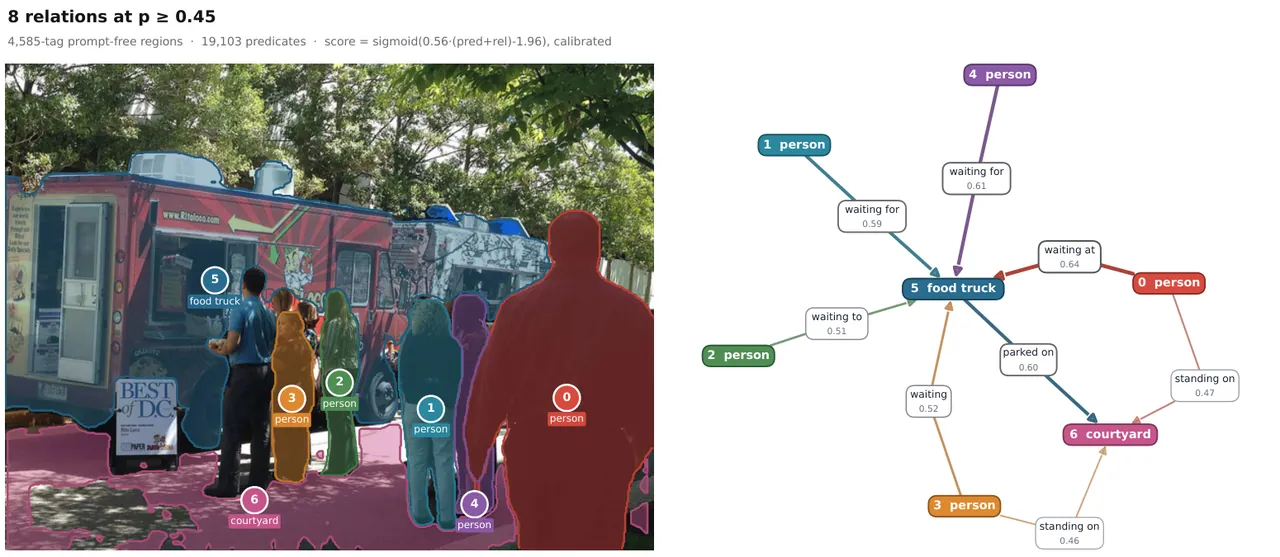
图 6:同一 checkpoint 在 YOLOE-11 检测区域上的输出(每图 8 条关系,p≥0.45)。来源:论文图 6 上。
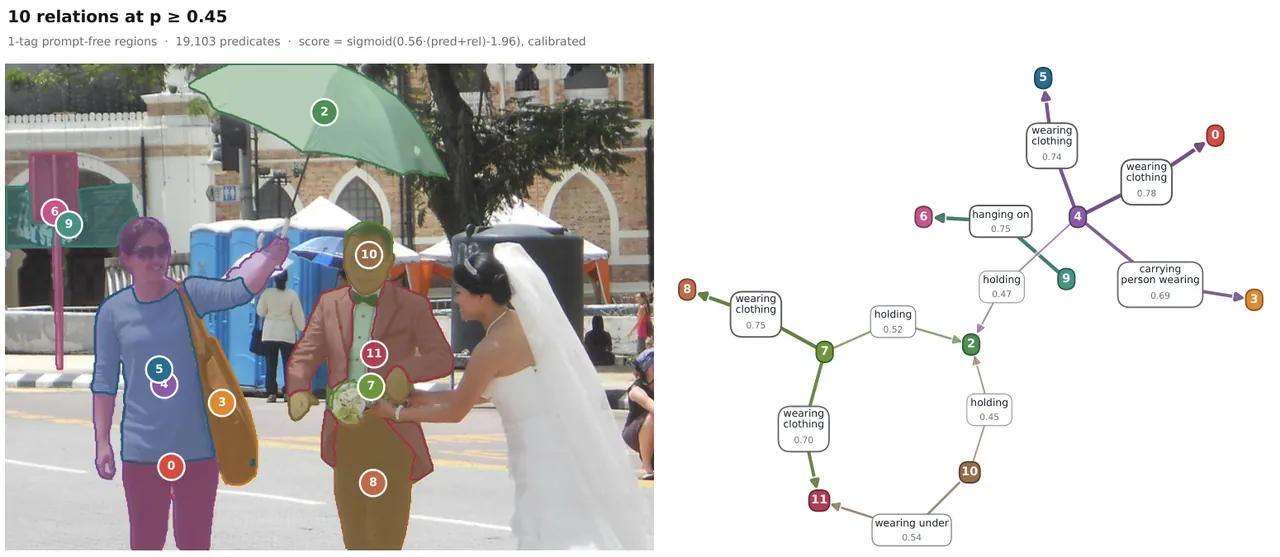
图 7:同一 checkpoint 在 FastSAM 无类别掩码上的输出(每图 18 条关系)。区域来源与类别体系完全更换,模型不重训。来源:论文图 6 下。
成本:实时不是副产品
在统一协议下(batch 1、eager PyTorch),OvSGTR Swin-T 以 177M 参数、每图 98 框、800/1333 分辨率、fp32 跑 194.0 ms(A40),即 5.1 FPS;本文系统以 231M 参数(其中关系模型 53.2M)、每图 20 框、448 px、bf16 跑 25.0 ms,即 40 FPS,端到端快 7.8 倍。批 1 代价由 kernel 派发而非算术主导:三座塔在 2.5 倍 FLOPs 范围内都是 19 到 20 ms;编译带来 1.5 到 1.8 倍收益,把含检测器与解码的整条链压到每帧 20 ms。对 19103 条字符串打分在批 1 下不足 1 ms,批处理时占吞吐 11% 到 22%。文本编码器在推理图之外、检测器不属于模型,因此同一张图可以跑在 CPU 上:fp16 构建在 8 线程下达 7 FPS,与 fp32 的 top-1 一致率 0.955。
| 系统 | 参数量 | 框/图 | A40 ms | A100 ms | H100 ms | FPS(A40) |
|---|---|---|---|---|---|---|
| OvSGTR Swin-T | 177M | 98 | 194.0 | 179.9 | 128.1 | 5.1 |
| OvSGTR Swin-B | 237M | 98 | 228.5 | 195.1 | 134.3 | 4.3 |
| RelateAnything + YOLO-World | 231M | 20 | 25.0 | 35.0 | 25.6 | 40.0 |
表 3:统一协议下的端到端成本(论文表 11)。比较的是部署配置而非架构:框预算是三项差异中最大的一项。
域内与跨数据集:被高估五倍的迁移
第 8 节把语料规模同时放在域内与迁移下读:域内验证召回随训练样本数上升,半语料臂在第三遍遍历后饱和;而迁移曲线给出的结论不同——域内测量把迁移收益高估约 5 倍,并且可能偏好那些降低迁移的改动。这是全文最不舒服也最有用的数字:它说明在旧协议下「有效」的很多改动,在部署条件下是无效甚至有害的。
局限性
语料没有人工精度审计(作者自述)。RA-4M 的所有精度论断都是结构性的:门拒绝 11.3%、拒绝在框误差内为真负例、几何约束不了的谓词被点名计数而非检查。作者明确承认缺少「由人读并打分一批生成关系」的精度估计,并称这是读者在依赖 430 万条机器标注前应当期待、也应当最先补上的测量。残余错误类也已被点名:约 22% 的 looking at / watching 标注框不相交而无法验证;先验驱动的大框标签;重叠但无关框之间的接触谓词(person wearing tent 能通过接触门)。
谓词概念并未真正留出(作者自述)。所有未标注结果都是跨数据集的,但谓词字符串不是:每个基准谓词都出现在训练词汇中。留出变体只在定义它的那个 split 上评测,跨四个基准同时留出概念的 general 变体没有跑——尽管架构允许(谓词矩阵从不学习)。部分结论只基于单种子,噪声地板 1.3% 以内的差异作者已标注。
A5 的裁判并不总是站在本文模型一边(作者自述)。逐关系精度是真实短板:在任何深度下基线都更少过度断言,不能容忍假边的部署应当选择更短的图;整图展示时裁判偏好基线的图,单条展示时裁判接受基线的比例略高,且第二个裁判重复了这一结果。方法论上,裁判感知不到重复,因此信息量必须对着参考分布量,而不能靠询问 elicited。
检测器召回是硬上限(作者自述)。基准数字与部署系统之间最大的损失来自物体检测器召回:配对召回对物体召回是二次的,任何关系模型都无法越过;而更大的关系模型只会在部署从不发出的那部分排序上买精度。
总结与展望
RelateAnything 的贡献可以读作三次「搬出去」:把词汇表搬出参数(嵌入库 + 谓词条件门),把物体标签搬出输入(坐标软池化 + 标签无关头部),把度量搬出单一语料(六轴跨数据集协议 + 三元组重合度披露)。三者共同使关系头第一次成为一个可替换检测器、可换词汇表、可实时运行的组件,这对需要把感知栈换成跟踪器或分割器的机器人系统是有直接工程意义的。
探针给出的否定结果同样重要:在本文配方下,关系监督不会在共享骨干中产生关系表示,关系 logit 几乎完全由配对上下文决定。这为「检测与关系共享骨干」的默认做法提供了一个反例,也提示下一步的方向是给 patch 级关系目标,而不是继续加大关系头。
未完成的清单同样清晰:人工精度审计、跨基准的谓词留出、多种子复现、以及在部署深度下控制假边率。论文给出的最便宜建议值得所有场景图工作采纳:在每个召回数字旁边报告训练语料与基准的共享三元组质量。
金句
「检测与分割已经摆脱了分类体系,关系预测还没有。我们论证障碍在于监督、架构与度量,并各自移除了一个。」
「一个无像素查表能赢的指标,度量的不是关系理解——而它恰好是给排行榜排序的指标。」