RelateAnything:任意区域输入下的实时开放词汇关系预测
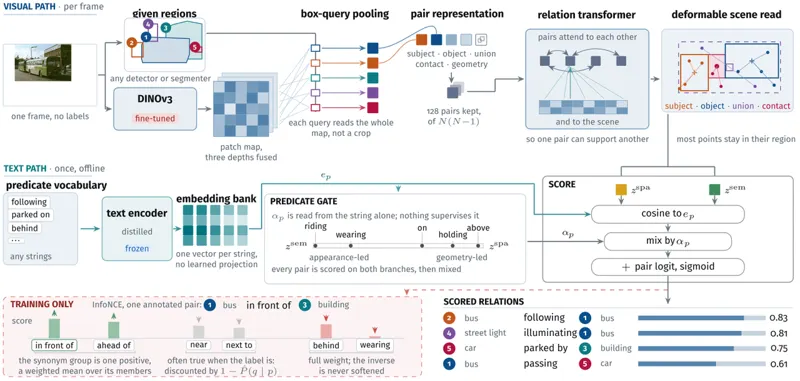
开放词汇检测允许在推理时接受任意类别列表,可提示分割能在没有类别名的情况下返回区域:分类体系已经离开模型、成为输入,而关系预测尚未如此。场景图模型仍在一个标注风格的 50 或 56 个谓词上训练与评测,关系头以物体标签为条件,因而与单一检测器绑定。本文指出三个障碍:不存在既自由文本又经过验证的关系语料;以标签为条件的架构无法接受训练时没见过的词汇;标准指标奖励与训练语料的一致性,使更大的词汇量反而表现为退步。RelateAnything 是一个 5300 万参数模型,输入图像与任意来源的区域,输出在推理时以字符串形式给出的谓词词汇上的打分关系;物体标签从不作为输入,词汇是文本嵌入库而非学习出的分类器,推理速度为每帧 20 毫秒。为支撑 19103 个谓词的训练,论文提出正-未标注监督与能够区分反义词的文本编码器(对比式编码器把反义词嵌入到余弦 0.95),并构建 RA-4M:47.4 万张图像、430 万条关系、10102 个自由文本谓词,对着编号框标记生成并经几何门验证;评测上构建 OV-SGG-Bench 六轴跨数据集协议。在三个跨数据集基准与一个零样本基准上,平均召回达到同规模最强开放词汇方法的 2.3 至 3.5 倍,并以不足其 2% 的参数量超过 3B 视觉语言场景图模型;域内评测会把迁移收益高估约 5 倍。模型、语料与基准均已公开。
Neau, Maëlic2026年9月11日
Scene Graph Generation开放词汇Relation Prediction2026年9月11日