PAPER DEEP DIVE
VT-Bridge:轻量残差适配把预训练 VLA 桥接成 VTLA
VT-Bridge 不改动预训练 VLA 的架构,只在其预测的动作块之上外挂一个 0.98M 参数的触觉残差适配器,以机器人执行频率逐步修正动作:骨干低频推理(π0 每块 153.1 ms),适配器单步 0.7 ms,两者在同一块 GPU 上时间片交错,互不抢占算力。每个任务最多 50 条双边遥操作视触演示即可完成 LoRA 微调骨干与训练适配器;残差监督取遥操作记录的期望位姿而非实际执行位姿,以补偿阻抗控制下 4-5 cm 的接触偏移,非接触样本的残差目标置零。在 π0、π0.5、SmolVLA 三个骨干与 Pump Bottle、Clean Whiteboard、Insert Plug、Flip Rocker Switch 四个接触密集任务上,平均严格成功率从 11.7% 提升到 62.9%,条件完成率提升 58.8 个百分点,12 个任务-骨干组合全部最优。代码正在整理开源。
论文元信息
标题:VT-Bridge: Bridging Pretrained Foundation VLAs to VTLAs via Lightweight Residual Adaptation
作者:Yansong Wu、Tuo Yang、Rongping Zhao、Lingyun Chen、Xiao Chen、Junnan Li、Fan Wu、Alois Knoll(慕尼黑工业大学、 Mohamed Bin Zayed 人工智能大学、上海大学)
链接:arXiv 2609.22606v1(cs.RO,2026-09-18,CC BY-SA 4.0);IEEE RA-L 版本 DOI 10.1109/LRA.2026.3692345;项目主页
代码状态:论文致谢中说明代码库正在为开源发布做整理,截至 v1 尚无公开仓库;项目主页的 Code 按钮未指向任何仓库地址。
一句话总结
VT-Bridge 不改动预训练 VLA 的任何结构,只在机器人执行频率上外挂一个 0.98M 参数的触觉残差适配器,用每个任务最多 50 条视触演示,把 π0、π0.5、SmolVLA 三个开源基础 VLA 桥接成触觉感知的 VTLA,四项接触密集操作的平均严格成功率从 11.7% 提升到 62.9%。
研究背景与动机
视觉-语言-动作(VLA)模型给出了一条通向通用机器人智能的现实路径:一个预训练策略就能读懂自然语言指令,并在多种操作场景中执行任务。借助大规模预训练,VLA 在零样本或少量演示微调下已经能完成不少操作任务。但论文指出了一个反复出现的事实:即便做过任务级微调,现有 VLA 在真实世界的接触密集操作上成功率依然很低。只靠视觉、语言和机器人本体状态这些非接触模态去预测动作,不足以支撑可靠的物理交互。
针对这一短板,近期工作开始把触觉反馈引入 VLA 架构,形成视觉-触觉-语言-动作(VTLA)模型。这些工作在融合策略与模型结构上各有取舍,在接触密集任务上带来了可观收益;若干消融研究还单独剥离出触觉的贡献,证明触觉感知是可靠物理交互中不可省略的一环。
然而 VTLA 的代价同样醒目。数据侧,公开机器人数据集中视触配对轨迹远比纯视觉数据稀缺,而采集高质量触觉演示需要操作者具备精细的力调节能力,双边遥操作的复杂度显著上升。模型侧,触觉编码器与跨模态融合模块带来额外参数与更复杂的结构,训练成本随之增加。受这两重瓶颈约束,现有 VTLA 覆盖的任务范围明显窄于 π0 这类通用 VLA。
于是论文提出了一个中心问题:能否以可控的成本,把现有开源 VLA 适配成 VTLA?VT-Bridge 的回答是「桥接」而非「重建」:保留预训练 VLA 的原始架构与权重获取的通用知识,在其预测的动作块之上叠加一个轻量残差适配器,由适配器在执行前一刻依据最新触觉反馈修正动作,从而在运行时调节接触动力学。
这一设计带来四条可验证的优势。其一,预训练 VLA 可复用且兼容:同一套适配器架构可以配不同骨干,只需为每个骨干单独训练权重,论文用 π0、π0.5、SmolVLA 三个骨干验证了这一点。其二,数据与训练门槛低:每个任务最多 50 条视触演示,就够微调骨干并训练 0.98M 参数的适配器,不需要超出 VLA 微调之外的额外大规模训练资源。其三,运行时反应性:语义推理与触觉适配在不同频率上分工。其四,收益显著且一致:平均任务完成率从任务级微调的 11.7% 提升到 62.9%,且在四个任务、三个骨干上全部成立。
预备知识:VTLA 的融合策略与慢-快推理
论文把现有 VTLA 按触觉信息的融合位置分成三类。第一类是统一 VTL 融合:视觉、触觉、语言各自编码后送入一个统一的多模态 transformer。第二类是顺序 VL-T 融合:视觉与语言先联合编码,触觉再在不同阶段介入,包括在动作预测前经 MoE 融合、在动作解码或动作专家生成过程中注入、以及对已预测动作做事后修正。第三类是其他路线:多阶段融合、把触觉转成连续软提示参与 VLA 推理、或由 VLM 预测刚度以实现柔顺执行。图 1 汇总了这些策略,并指出 VT-Bridge 是其中唯一在不改动预训练 VLA 架构的前提下实现高频触觉适配的方案。
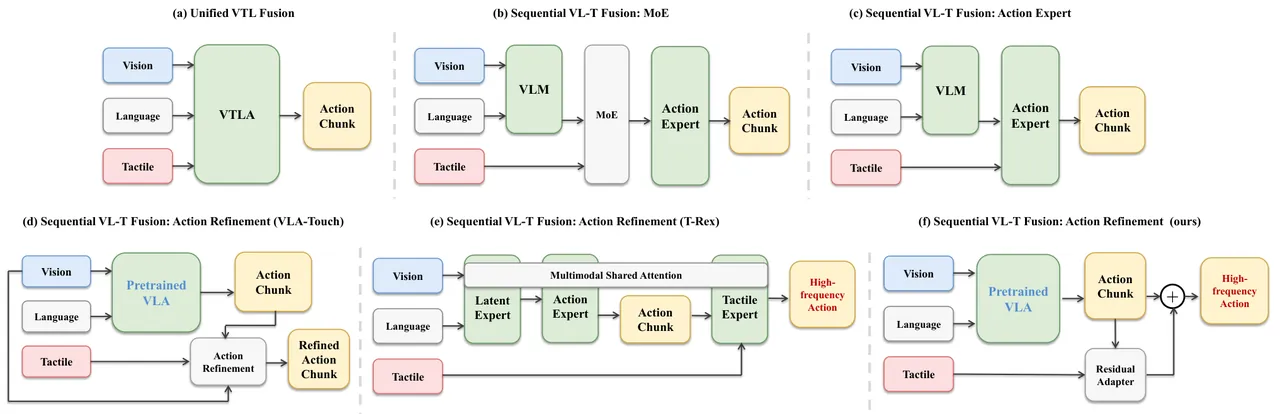
图 1:现有 VTLA 模型的代表性多模态融合策略。VT-Bridge 保留预训练 VLA 骨干且不做架构修改,同时支持高频触觉适配。
视觉与力觉在感知特性上截然不同却功能互补:视觉高维、采样频率相对低、承载全局场景语义;力觉低维、采样频率高、与局部接触动力学紧耦合。RDP 最早据此提出慢-快推理:慢策略从视觉预测潜在动作块,快解码器用最新触觉反馈生成可执行动作。但这一范式在 VTLA 中采用者寥寥,只有 T-Rex、FAVLA、UniTacVLA 等少数工作。VT-Bridge 把慢-快调度与「骨干不动、残差修正」结合起来,是它与上述融合型 VTLA 的关键差异。
另一个必要背景是阻抗控制下的位姿偏差。论文全程使用阻抗控制保证交互安全,控制器柔顺意味着「期望位姿」与「实际执行位姿」在接触时并不重合:压泵头需要约 40 N 的峰值交互力,对应的期望-执行偏差可达 4–5 cm。这一物理事实直接决定了残差监督信号该如何构造,也是第六节消融实验的伏笔。
方法详解
VT-Bridge 的整体形态可以概括为「低频骨干 + 高频残差」。预训练 VLA 骨干保持原结构不变,负责语义理解与粗粒度运动生成;残差适配器以机器人执行频率工作,对骨干预测的动作块逐步修正。两者在同一块 GPU 上按时间片交错运行,互不抢占算力。
低频骨干。给定当前观测 $\bm{o}$ 与语言指令 $\bm{l}$,预训练 VLA 策略预测一个动作块:
$$\bm{A} \sim \pi^{\mathrm{VLA}}(\cdot \mid \bm{o}, \bm{l}) \tag{1}$$
其中 $\bm{A} = [\bm{a}_1, \bm{a}_2, \dots, \bm{a}_H]$ 包含未来 $H$ 个动作,实验中 $H = 50$。这个动作块编码了任务意图与粗粒度运动趋势,是后续被修正的「名义动作序列」。
高频残差适配器的结构。适配器由两个并行的 transformer 编码器加一个 MLP 解码头组成。动作编码器处理嵌入后的动作块,输出动作特征 $\bm{z}^a$,表征 VLA 的粗运动意图与整块动作的总体趋势;该特征只在 chunk 开始时计算一次,在整个 chunk 执行期间复用,这是适配器能做到每步 0.7 ms 的关键。力编码器则从最新力觉窗口提取时序接触特征 $\bm{z}^f_t$:
$$\bm{F}_t = [\bm{f}_{t-n+1}, \bm{f}_{t-n+2}, \dots, \bm{f}_t] \tag{2}$$
其中 $n$ 为窗口长度(实验取 $n = 50$),$t$ 为当前执行步。两个特征拼接后送入 MLP 解码出残差动作:
$$\bm{a}^{\mathrm{res}}_t = \mathrm{MLP}\left([\bm{z}^a; \bm{z}^f_t]\right) \tag{3}$$
推理与执行。部署时每个动作块是一个调度单元:周期开始时骨干预测动作块 $\bm{A}$,随后骨干空闲,系统进入「适配-执行」循环。每个执行步 $t$,适配器以完整动作块与最新力窗为条件预测残差:
$$\bm{a}^{\mathrm{res}}_t = \pi^{\mathrm{res}}(\cdot \mid \bm{A}, \bm{F}_t) \tag{4}$$
残差与对应名义动作相加,得到真正下发给机器人的适配动作:
$$\bm{a}^{\mathrm{exe}}_t = \bm{a}_t + \bm{a}^{\mathrm{res}}_t \tag{5}$$
循环持续到 chunk 内动作执行完毕,适配器暂停,骨干再次被调用预测下一个 chunk。由于两个推理过程在时间上错开,它们不会争抢 GPU。实测骨干一次 chunk 推理耗时 153.1 ms(π0)、163.8 ms(π0.5)、155.4 ms(SmolVLA),而适配器侧动作块编码 0.4 ms、单步残差预测 0.7 ms,量级差异正是慢-快分工能够成立的原因。图 2 给出了三条时间线(观测、推理、执行)的交错关系。
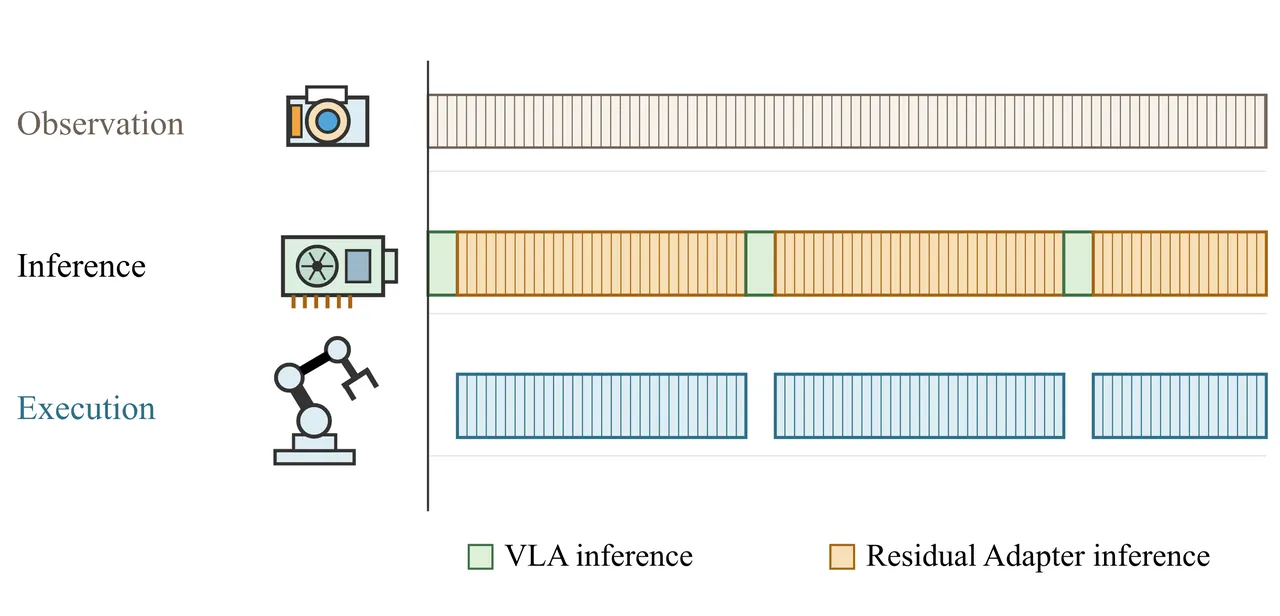
图 2:VLA 骨干、残差适配器与机器人执行器的时间调度。骨干只在 chunk 边界推理,适配器在执行频率上填补空档。
训练流程第一步:遥操作演示采集。论文采用 SharedAssembly 提出的双边遥操作策略采集接触密集任务演示:把从端机器人的交互负载回映到主端,使操作者在示教过程中能感知接触变化并实时调节施力。每条演示同步记录相机流、机器人运动状态及其对应的期望指令、以及触觉信号(估计的末端外力与外部关节力矩)。
第二步:骨干微调。用采集到的演示对预训练骨干做任务适配:相机观测、语言指令与机器人状态按各骨干原有的观测预处理与动作表示转换成训练格式,再以 LoRA 微调(30,000 步、批大小 32、约 8 小时、4 张 A100-SXM4)。微调后的骨干产出名义动作块,供下一步构造残差数据集。
第三步:残差数据集构造。让微调后的骨干在录制的观测上回放,生成名义动作块;时间对齐后,每个执行步 $k$ 的残差目标为:
$$\bm{a}^{\mathrm{res}}_k = \bm{a}^{\mathrm{desired}}_k - \bm{a}_k \tag{6}$$
其中 $\bm{a}^{\mathrm{desired}}_k$ 是遥操作时控制器的期望指令,$\bm{a}_k$ 是骨干的预测动作。用期望指令而非实际执行位姿作监督,是为了在接触存在时保留操作者的真实运动意图;这一选择的代价与收益在消融实验中量化。每条残差目标与对应的名义动作块 $\bm{A}$、接触反馈窗口 $\bm{F}_k$ 配对作为适配器输入。动作表示沿袭 π0 同时支持笛卡尔空间与关节空间:笛卡尔动作配估计的末端外力,关节动作配外部关节力矩,保证动作与触觉表示一致。此外,所有非接触样本的残差目标被置为零,促使适配器在自由空间保持骨干的原决策,把适配能力集中用在接触建立之后。
第四步:适配器训练。冻结微调后的 VLA 骨干,只在残差数据集上优化 0.98M 参数的适配器。解耦训练既保住了骨干的名义任务行为,又让接触条件下的残差修正可以独立学习。
flowchart TD
  O["观测 o 与指令 l"] --> VLA["VLA 骨干 低频推理 153-164 ms"]
  VLA --> CHUNK["动作块 A 含 H=50 个动作"]
  CHUNK --> AE["动作编码器 输出 z^a 整块复用一次"]
  AE --> MLP["MLP 解码残差 a^res_t 0.7 ms"]
  FW["最新力窗 F_t 长度 n=50"] --> FE["力编码器 输出 z^f_t"]
  FE --> MLP
  MLP --> ADD["a^exe_t = a_t + a^res_t"]
  ADD --> ROBOT["机器人 30 Hz 执行"]
  ROBOT --> DONE{"chunk 内动作执行完"}
  DONE -- 否 --> FW
  DONE -- 是 --> VLA
图 A:VT-Bridge 的慢-快交错推理流程(依据论文第 III 节绘制)。
flowchart LR
  S1["双边遥操作采集 50 条演示 记录相机流 状态 期望指令 外力与关节力矩"] --> S2["LoRA 微调 VLA 骨干 30k 步 批 32 约 8 小时 4 张 A100"]
  S2 --> S3["骨干回放录制观测 生成名义动作块"]
  S3 --> S4["残差目标 a^res = a^desired - a^pred 非接触样本置零"]
  S4 --> S5["冻结骨干 只训练 0.98M 残差适配器"]
图 B:VT-Bridge 的四步训练流水线(依据论文第 IV 节绘制)。
实验结果
实验平台为 Franka Emika Panda 机械臂加两台 Intel RealSense D435i 相机;机器人控制器运行在搭载 i7-10700 的 NUC 上,VLA 与残差策略运行在另一台配备 RTX 3090 的工作站上。四个评估任务覆盖四类物理交互形态:Pump Bottle(按压)、Clean Whiteboard(持续面接触)、Insert Plug(高精度插入)、Flip Rocker Switch(离散力触发)。每个任务采集 50 条演示,每个骨干-方法组合在每个任务上做 20 次独立试验,单次试验在满足严格成功判据或达到 90 s 时限时终止。关键配置见表 1。
| 配置项 | 取值 |
|---|---|
| 演示采样率 / 执行频率 | 30 Hz / 30 Hz |
| 关节刚度矩阵 | $\operatorname{diag}(300,300,300,200,100,60,30)$ |
| 力觉历史窗口 $n$ / 动作块长度 $H$ | 50 / 50 |
| 骨干微调 | 30,000 步,批大小 32,约 8 h(4×A100) |
| chunk 推理耗时 | π0 153.1 ms;π0.5 163.8 ms;SmolVLA 155.4 ms |
| 适配器耗时 | 动作块编码 0.4 ms;单步残差预测 0.7 ms |
表 1:实验配置摘要(论文 Table I)。
评估采用两级成功判据:严格判据要求任务完整执行,宽松判据只要求策略到达任务相关交互状态并建立预期接触。两者的区分把「没够到接触」的失败与「接触之后没做完」的失败分开。据此论文报告严格成功率 $\mathrm{SR}_{\mathrm{strict}} = N_{\mathrm{strict}} / N$、宽松成功率 $\mathrm{SR}_{\mathrm{loose}} = N_{\mathrm{loose}} / N$,以及条件完成率:
$$\rho_{\mathrm{sl}} = N_{\mathrm{strict}} / N_{\mathrm{loose}} \tag{7}$$
$\rho_{\mathrm{sl}}$ 度量的是「已经到达接近成功状态之后,把任务做完」的概率,因此它把评测焦点对准接触密集阶段本身,削弱了骨干之间在任务理解与运动生成上的差异。
Q1:总体性能。表 2 给出严格成功率。VT-Bridge 在全部 12 个任务-骨干组合上无一例外取得最高严格成功率;相对直接用同样演示微调骨干,平均严格成功率从 11.7% 提升到 62.9%,绝对提升 51.2 个百分点。值得注意的对比是 VLA-Touch:它同样走「微调骨干 + 触觉修正」路线,但平均只有 7.5%–20.0%,说明残差适配的目标构造与高频调度才是收益来源,而不是「加了触觉」这件事本身。
| 骨干 | 方法 | Pump Bottle | Clean Whiteboard | Insert Plug | Flip Rocker Switch | 平均 |
|---|---|---|---|---|---|---|
| π0 | Fine-tuned | 0.0 (0/20) | 5.0 (1/20) | 0.0 (0/20) | 20.0 (4/20) | 6.3 |
| π0 | VLA-Touch | 0.0 (0/20) | 5.0 (1/20) | 0.0 (0/20) | 50.0 (10/20) | 13.8 |
| π0 | VT-Bridge | 85.0 (17/20) | 20.0 (4/20) | 70.0 (14/20) | 85.0 (17/20) | 65.0 |
| π0.5 | Fine-tuned | 0.0 (0/20) | 35.0 (7/20) | 0.0 (0/20) | 55.0 (11/20) | 22.5 |
| π0.5 | VLA-Touch | 0.0 (0/20) | 20.0 (4/20) | 5.0 (1/20) | 55.0 (11/20) | 20.0 |
| π0.5 | VT-Bridge | 90.0 (18/20) | 40.0 (8/20) | 70.0 (14/20) | 75.0 (15/20) | 68.8 |
| SmolVLA | Fine-tuned | 0.0 (0/20) | 10.0 (2/20) | 0.0 (0/20) | 15.0 (3/20) | 6.3 |
| SmolVLA | VLA-Touch | 0.0 (0/20) | 5.0 (1/20) | 0.0 (0/20) | 25.0 (5/20) | 7.5 |
| SmolVLA | VT-Bridge | 70.0 (14/20) | 45.0 (9/20) | 65.0 (13/20) | 40.0 (8/20) | 55.0 |
表 2:严格成功率(%,论文 Table III)。
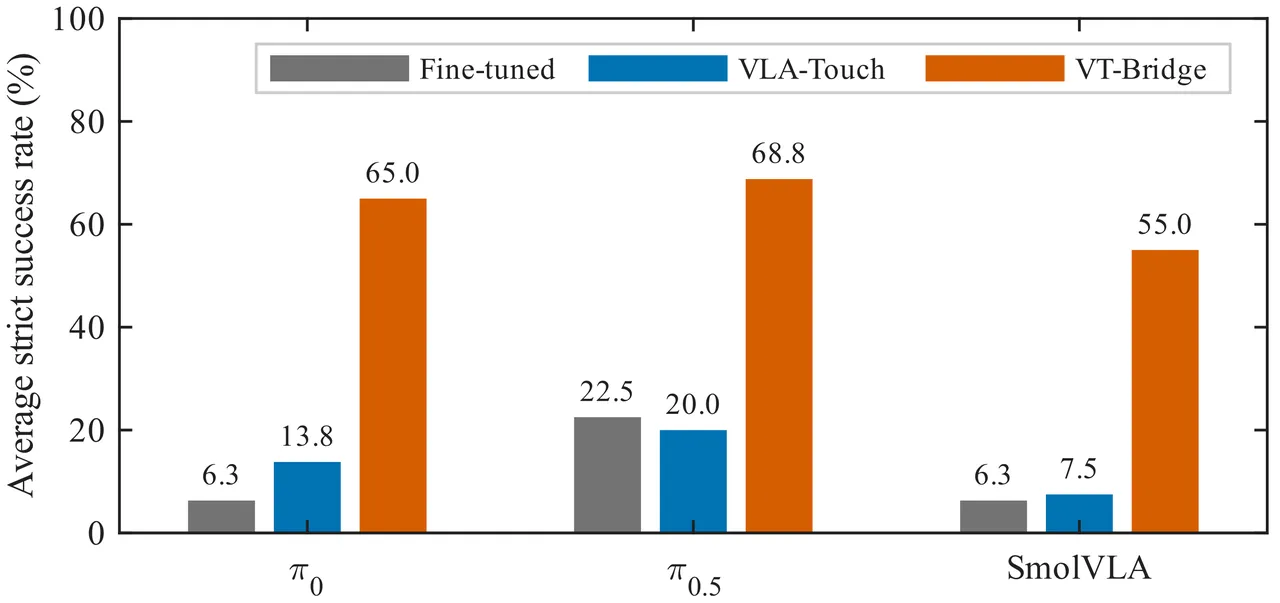
图 3:三个骨干上的平均严格成功率。VT-Bridge 相对微调基线与 VLA-Touch 的优势在三个骨干上一致成立。
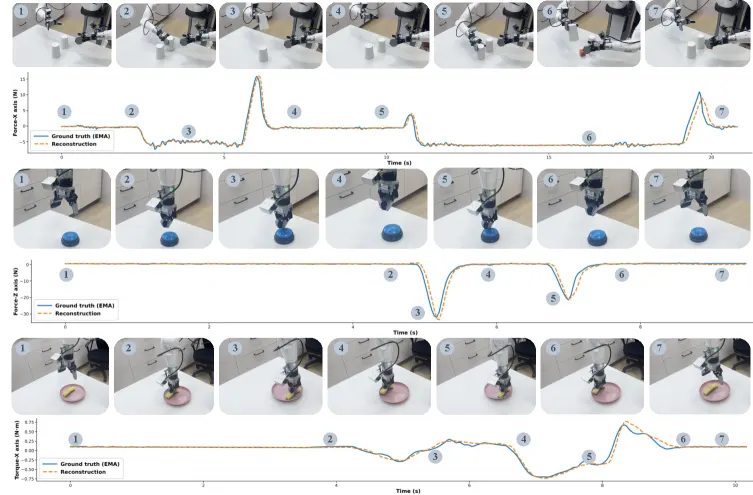
Q2:最后一英寸瓶颈。论文观察到相当一部分失败并非任务意图错误:策略常常已经接近完成,却在最后一步接触敏感环节失手,例如压下了泵头但行程不足、插头插入但未完全到位。这类执行在几何上接近成功,却没有达成功能结果。表 3 的条件完成率把这一能力量化:VT-Bridge 在全部组合上最高,宏平均比微调骨干高 58.8 个百分点。Pump Bottle 是最尖锐的例子——所有基线-骨干组合的条件完成率均为 0%,没有任何一次把「够到泵头」转化为「压出液体」,而 VT-Bridge 平均达到 90.6%。Insert Plug 上微调骨干三个骨干全为 0%、VLA-Touch 仅在一个组合上到 6.3%,VT-Bridge 平均 85.9%。图 4 的 z 轴交互剖面进一步展示了机制:演示与 VT-Bridge 成功试验都在接触段出现约 40 N 的力峰,而消融策略的力曲线在接触段几乎平坦,说明它根本没有建立起完成任务所需的接触力。
| 骨干 | 方法 | Pump Bottle | Clean Whiteboard | Insert Plug | Flip Rocker Switch | 平均 |
|---|---|---|---|---|---|---|
| π0 | Fine-tuned | 0.0 (0/19) | 5.3 (1/19) | 0.0 (0/13) | 23.5 (4/17) | 7.2 |
| π0 | VLA-Touch | 0.0 (0/5) | 5.9 (1/17) | 0.0 (0/16) | 66.7 (10/15) | 18.1 |
| π0 | VT-Bridge | 89.5 (17/19) | 20.0 (4/20) | 93.3 (14/15) | 100.0 (17/17) | 75.7 |
| π0.5 | Fine-tuned | 0.0 (0/20) | 35.0 (7/20) | 0.0 (0/16) | 100.0 (11/11) | 33.8 |
| π0.5 | VLA-Touch | 0.0 (0/10) | 20.0 (4/20) | 6.3 (1/16) | 84.6 (11/13) | 27.7 |
| π0.5 | VT-Bridge | 94.7 (18/19) | 40.0 (8/20) | 77.8 (14/18) | 100.0 (15/15) | 78.1 |
| SmolVLA | Fine-tuned | 0.0 (0/19) | 10.5 (2/19) | 0.0 (0/8) | 16.7 (3/18) | 6.8 |
| SmolVLA | VLA-Touch | 0.0 (0/4) | 6.3 (1/16) | 0.0 (0/10) | 29.4 (5/17) | 8.9 |
| SmolVLA | VT-Bridge | 87.5 (14/16) | 45.0 (9/20) | 86.7 (13/15) | 61.5 (8/13) | 70.2 |
表 3:条件完成率 ρ_sl(%,论文 Table IV)。
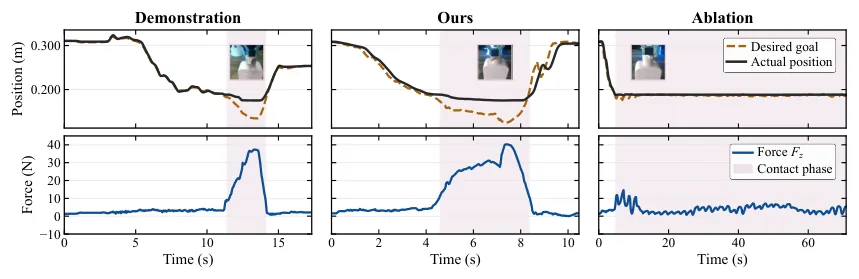
图 4:Pump Bottle 任务沿 z 轴的交互剖面(演示 / VT-Bridge / 消融)。上排为期望与实际位姿,下排为接触力;接触阶段以底色标出。
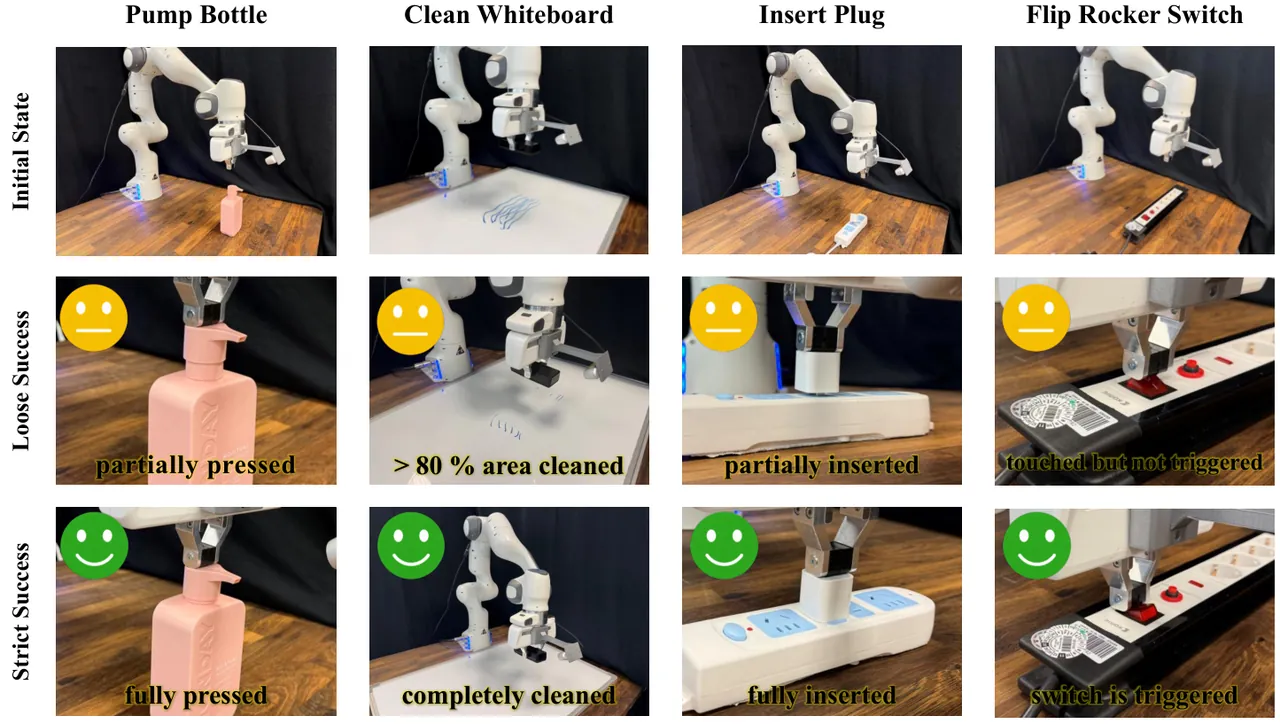
图 5:四个接触密集操作任务的初始状态,以及满足宽松与严格判据的示例。
Q3:残差目标用期望位姿还是执行位姿。默认设置用演示中记录的期望位姿与骨干预测之差构造残差目标;消融把期望位姿换成实际执行位姿,其余设置不变。图 6 显示期望位姿在全部任务-骨干组合上一致优于执行位姿,平均严格成功率从 12.1% 提升到 62.9%。机理解释与阻抗控制直接相关:压泵头需要约 40 N 峰值力,柔顺控制器下期望-执行偏差达 4–5 cm;用期望位姿作监督等于把这个与力相关的偏移显式写进训练数据,而用执行位姿作监督则把它丢掉——即便消融策略精确复现了演示中记录的执行位姿,把该位姿作为新的期望指令下发,又会在接触下产生一次新的跟踪缺口,机器人因此既复现不了演示位姿也复现不了接触力。Insert Plug 的峰值力同样接近 40 N,模式相同;Flip Rocker Switch 只需约 7 N,柔顺偏移小,消融在该任务上表现相对好些,但期望位姿仍带来 82% 的相对提升。
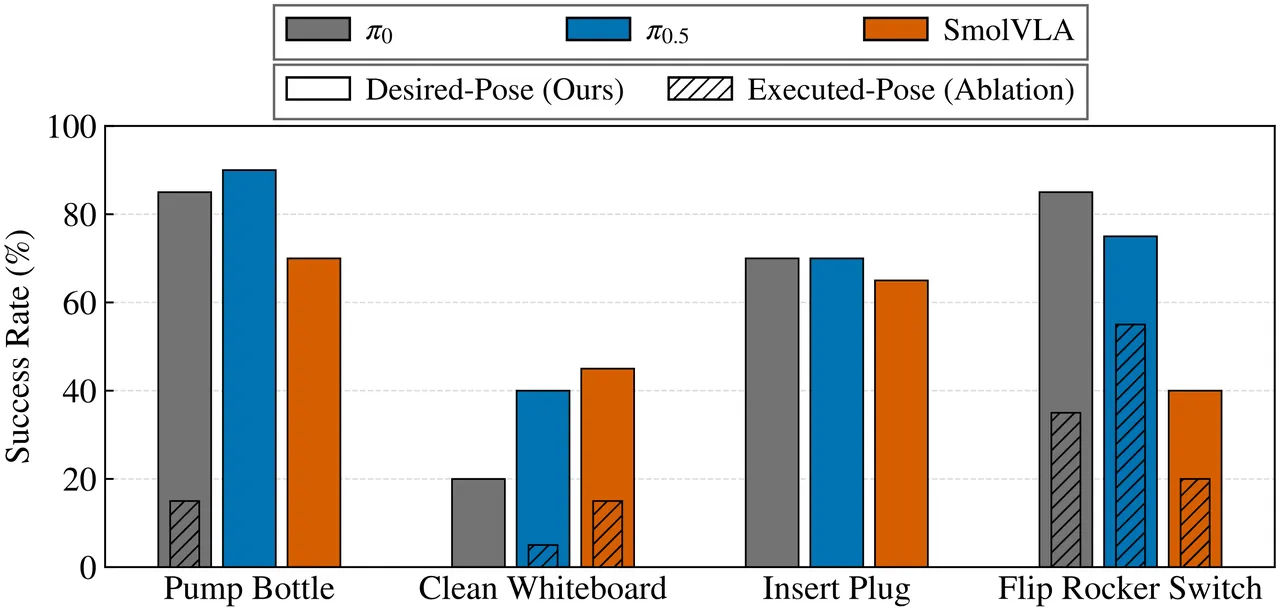
图 6:残差目标构造消融。斜纹柱为执行位姿(消融),实心柱为期望位姿(本文方法)。
局限性
其一,作者在结论中自述:后续工作将聚焦于提升残差适配器的表征与适配能力,以获得更强且更一致的收益——这等于承认当前 0.98M 的适配器在部分任务上仍是瓶颈,Clean Whiteboard 上 VT-Bridge 的严格成功率也只有 20%–45%,距离可用还有距离。其二,作者同样自述了安全与精度的权衡:提高控制器刚度可以缩小期望-执行偏移,但会放大交互力过大的风险,因此本文选择在柔顺控制下用监督信号补偿偏移,而不是换硬控制器;这一选择把问题转移到了残差数据集的质量上。其三,从实验设计看,全部结果来自单一 Franka Panda 平台与四个桌面操作任务,触觉信号只有估计外力与外部关节力矩,没有触觉阵列或触觉图像,方法对 richer 触觉模态的扩展性未被验证。其四,适配器权重按骨干分别训练,换骨干即需重训;且每个组合仅 20 次试验,表 3 中若干 $\rho_{\mathrm{sl}}$ 的分母小到 4、5 次(如 VLA-Touch 在 π0 的 Pump Bottle 上为 0/5),单格读数的统计波动不容忽略。
总结与展望
VT-Bridge 的贡献不在某个新模型,而在一条成本可控的工程路径:把触觉适配从「重训一个 VTLA」降级为「在冻结或 LoRA 微调的 VLA 之上训一个不到百万参数的残差头」。它用慢-快交错调度解决了高频触觉与低频语义推理在同一 GPU 上的共存问题,用期望位姿残差解决了阻抗控制下监督信号失真问题,用同一架构、按骨干换权重的方式验证了方法对 π0、π0.5、SmolVLA 的通用性。50 条演示、8 小时骨干微调、0.98M 适配器,换来 11.7% 到 62.9% 的平均严格成功率提升,以及 58.8 个百分点的条件完成率提升,这组数字对想把触觉引入现有 VLA 栈的团队是直接可复用的预算表。若后续工作能把适配器的表征做得更强、并把框架扩展到触觉阵列与多机器人平台,这条「桥接」路线有机会成为 VTLA 的默认做法。
金句
「几何上的接近成功不等于功能上的完成:把泵头压下去和把液体压出来之间的那一英寸,正是触觉反馈真正值钱的地方。」