PAPER DEEP DIVE
DexTacWAM:面向灵巧操作的视触觉世界-动作模型
DexTacWAM 把触觉纳入被预测的世界状态:冻结的视觉 VAE 逐指编码指尖触觉图,手指与姿态感知的触觉压缩器按 5:1 把五路指尖潜变量聚合成每只手一个潜变量,并作为额外视图注入视频扩散世界模型做联合去噪;动作专家再经逐模态 K/V 归一化,从预测出的视触联合潜特征生成含逐指力的动作。在 22 自由度双臂 Sharpa 触觉平台的六个接触富集真机任务上,它以平均 70.6 分全面领先,最强基线 RDP 为 38.0 分;消融显示去掉触觉世界建模会让四任务均值从 74.7 跌到 26.6。约 4 小时触觉编码器适配加每任务约 100 条演示即完成持续视觉到触觉学习,视觉预测质量损失被压在 0.5 dB 内,触觉压缩同时带来 2.26 倍训练与 1.29 倍推理加速。
一句话总结
DexTacWAM 把十根指尖的触觉从「策略的额外输入」变成「被预测世界状态的一部分」:冻结的视觉 VAE 逐指编码触觉图,手指与姿态感知的压缩器按 5:1 聚合成每只手一个潜变量并作为额外视图注入视频扩散世界模型,动作专家再从预测出的视触联合潜特征读出动作,在六个真机灵巧任务上平均 70.6 分,最强基线只有 38.0 分。
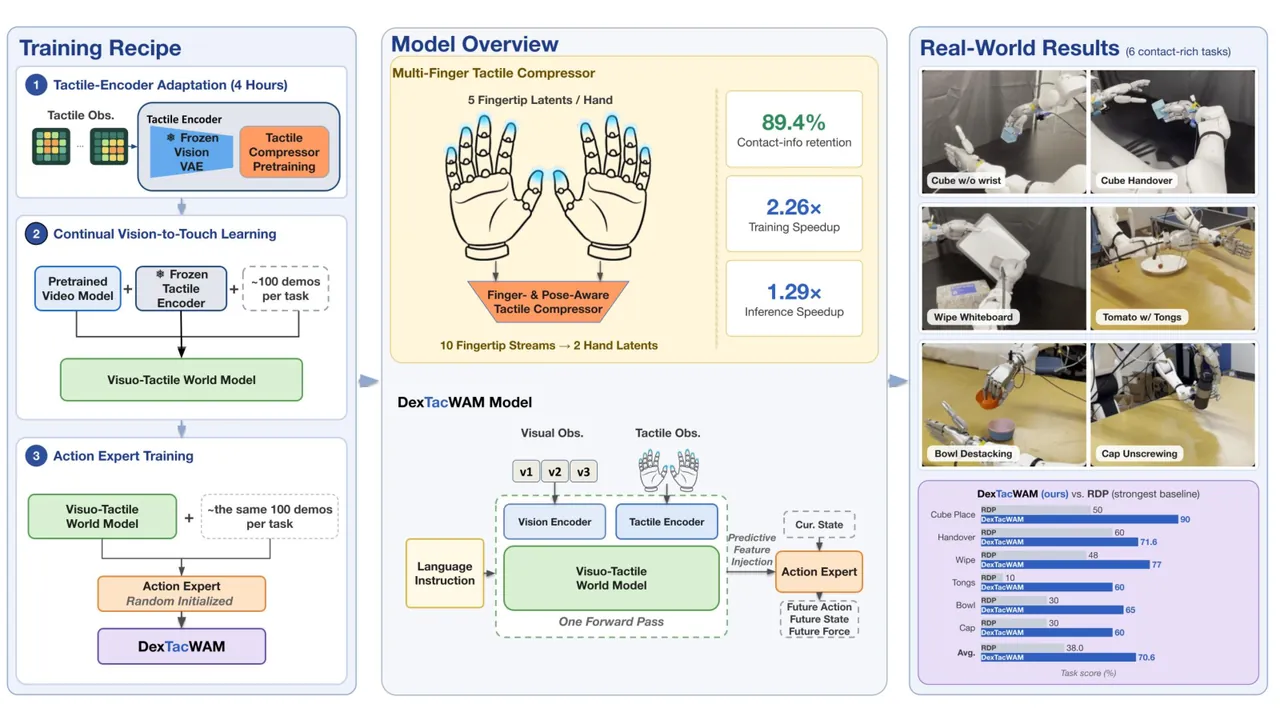
图 1:论文总览。左侧是三阶段训练配方(触觉编码器适配、视触世界建模、动作专家训练),中部给出模型概览与压缩保留率、训练与推理加速等关键数字,右侧为六个真机任务的结果快照与基线对比。
研究背景与动机
世界动作模型(World-Action Model, WAM)是近两年机器人学习的主线之一:先让模型预测动作条件下的视觉未来,再让动作头从预测潜变量中读出控制量。它与视觉-语言-动作(VLA)策略在大尺度视觉表征上的成功相互印证,在抓取、放置等任务上已经足够好用。但这条路线有一个结构性盲区:它建模的是「可见场景如何演化」,而不是「隐藏的物理交互状态如何演化」。接触、滑动、抓握稳定性这些决定接触富集任务成败的物理量,从相机里只能部分观测,甚至完全观测不到。
这个盲区在灵巧手上被成倍放大。平行夹爪的接触集中在两个夹面上,腕部一个六维力传感器大致就能描述;而灵巧手的接触分布在十根指尖的表面,随手姿、物体几何和任务阶段实时变化。要从视觉判断「拇指与食指是否已经把碗沿捏住、摩擦力是否足够」本就困难,当手臂自身遮挡物体时更是无从谈起。因此把视触世界建模从夹爪推广到灵巧手,并不是多接几路传感器通道的问题:模型必须同时保住手指身份、接触局部性、时间结构,以及随手姿变化的接触动力学。
已有的视触世界建模工作还没有回答这个问题。VTAM 在预训练视频动作模型上挂触觉流以纠正视觉估计误差;VT-WM 同时预测视觉与触觉观测,提高遮挡与歧义接触下想象 rollout 的物理保真度;OmniVTA 用更大的接触富集数据集预测短程接触演化。但它们的实验平台都停留在平行夹爪或结构简单的末端执行器上,触觉观测是局部的、结构单一的。与本文设定最接近的 ViTacFormer 在 ACT/CVAE 策略内部加了一个辅助触觉预测头,自回归地预报未来触觉 token 再喂回策略,但它不预测未来视觉,触觉预测只是策略内部的辅助过程,而非世界状态的一部分。
另一个现实约束是数据不对称。人类视频近乎取之不尽,触觉数据却必须靠真实接触、真实硬件、真实交互去采集,成本高且跨传感器异构。这让「从零预训练一个触觉基础模型」几乎不可行,也指明了本文的实践路线:复用从海量视觉数据里已经学到的空间表征与时间动态先验,用尽可能少的交互数据把它们扩展到触觉模态,同时不牺牲原有的视觉预测能力。
DexTacWAM 的回答可以浓缩为一句话:把触觉传感当作被建模世界状态的一部分,而不只是策略的辅助输入。围绕这一点,论文给出三个互相支撑的设计:复用冻结视觉 VAE 的逐指触觉编码器,加上保住手指身份与手姿信息的触觉压缩器;把左右手触觉潜变量作为额外视图、与视觉视图一起联合去噪的视频扩散世界模型;以及用逐模态 K/V 归一化稳定读取混合潜变量的动作专家。在 22 自由度双臂 Sharpa 触觉平台的六个接触富集任务上,它在每个任务都拿到最高分。
预备知识:世界动作模型与视触世界状态
在每个时间步 $t$,机器人观测到 RGB 图像 $o_{t}^{v}$、分布在手指与手之间的触觉观测 $o_{t}^{\tau}$、本体手状态 $q_{t}$,并执行动作 $a_{t}$。WAM 由两部分组成:世界模型负责在潜空间预测未来观测,动作专家负责从世界模型给出的表征中生成动作。DexTacWAM 的世界模型骨干是一个预训练视频扩散 transformer(LTX 风格的 DiT),多视图潜变量经跨视图自注意力耦合后联合去噪,训练目标为流匹配速度场。
论文的关键定义是联合视触世界状态。记视觉潜变量为 $z_{t}^{v}$,压缩后的左右手触觉潜变量为 $\hat{z}_{t}^{\tau,L}$ 与 $\hat{z}_{t}^{\tau,R}$,则
$$s_{t}=\{z_{t}^{v},\,\hat{z}_{t}^{\tau,L},\,\hat{z}_{t}^{\tau,R}\}$$与视觉中心 WAM 的差别在于:触觉潜变量不是条件输入,而是状态的组成部分,世界模型要对它的未来负责。动作专家随后条件于这个联合表征预测动作,因此它拿到的是「预测出来的接触演化」,而不是「当前时刻的触觉快照」。
这一设定带来一个部署层面的好处:动作专家只需要世界模型一次前向传播产生的预测潜特征,不需要等视觉或触觉未来被完全去噪出来。论文把这称为预测深度与延迟之间的权衡——去噪步数越多预测越完整,但控制回路等不起;而预报-再行动(forecast-then-act)式设计如 ViTacFormer 则必须先完成触觉预报才能出动作。
方法详解
1. 用冻结的视觉 VAE 逐指编码触觉
DexTacWAM 的第一个设计选择是不训练触觉 VAE,而是复用预训练视觉 VAE 作为逐指触觉特征提取器。理由来自触觉图本身的形态:Sharpa 指尖返回的是一幅灰度图,图上是可变形标记点阵,接触表现为点阵的局部压缩与剪切,而不是一个标量力读数。这种空间上有组织的局部结构——接触区域、形变图案、边缘、压力敏感的纹理变化——与图像式潜空间编码的假设天然兼容,因此视觉 VAE 提供的空间先验可以直接迁移。
工程上的衔接点很薄:每指触觉图 $o_{t,i}^{\tau}$ 是单通道,而视觉 VAE 期望三通道输入。论文用一个 $1\times 1$ 灰度转 RGB 适配器 $\phi_{g\rightarrow rgb}$ 解决,初始化时等价于把灰度图复制到三个通道上,随后送入冻结的 VAE 编码器:
$$z_{t,i}^{\tau}=E_{\mathrm{VAE}}\!\left(\phi_{g\rightarrow rgb}(o_{t,i}^{\tau})\right)$$其中 $i$ 索引手指。每只手得到五个逐指潜变量 $Z_{t}^{\tau}=\{z_{t,1}^{\tau},\ldots,z_{t,5}^{\tau}\}$,双臂共十路。VAE 全程冻结意味着触觉适配只发生在两个轻量部件上:灰度转 RGB 投影与下游压缩器,预训练的视觉潜空间本身不被扰动。附录 A.11 的探针实验支持了这一选择的合理性:仅凭冻结 VAE 加学习到的投影,右拇指 128 维特征对六个任务的 5 近邻分类准确率就达 95.6%,线性探针 99.0%,而均匀随机水平只有 16.7%。
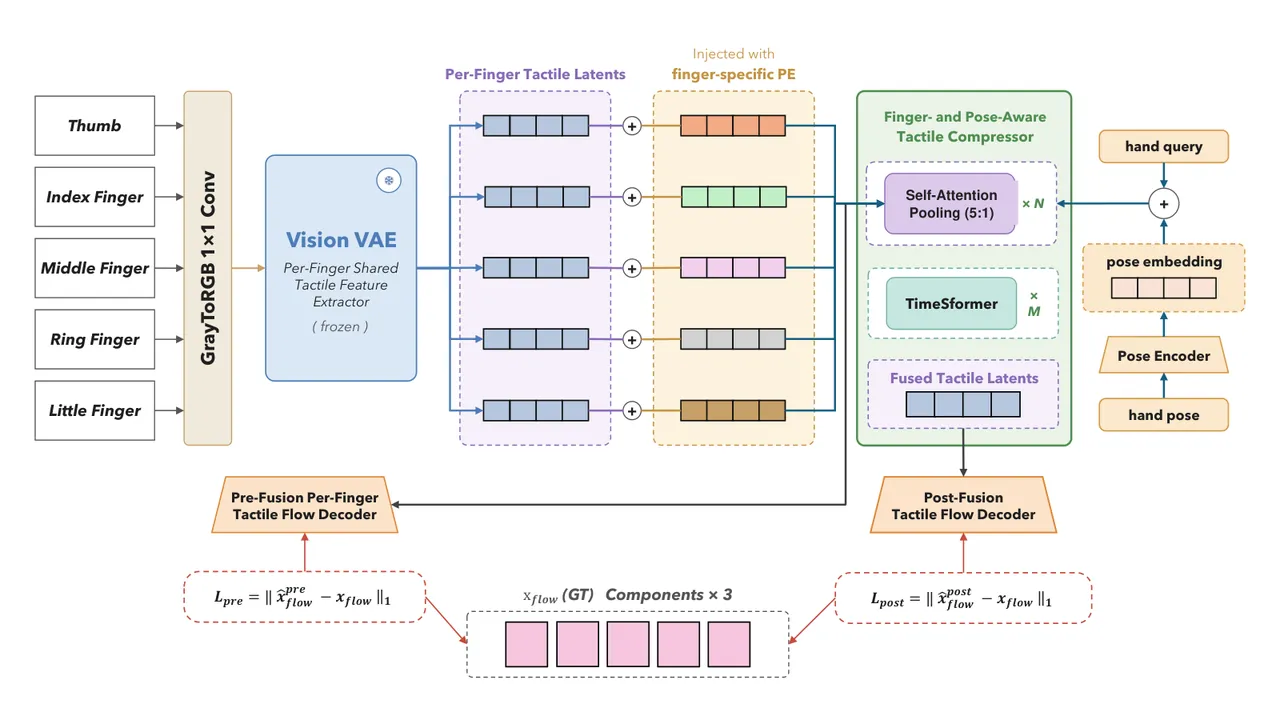
图 2:多指触觉编码器与手指-姿态感知压缩器。五根手指的触觉图经 1x1 灰度转 RGB 后共享冻结视觉 VAE;逐指潜变量加上手指身份嵌入,与手查询、姿态嵌入一起进入自注意力池化,按 5:1 压成每只手一个潜变量,再经时间细化;融合前与融合后的重建损失约束压缩结果保留局部多指接触信息。
2. 手指与姿态感知的触觉压缩
把十路指尖潜变量原样送进世界模型会让视图数与 token 数爆炸,因此论文引入触觉压缩器,把每只手的五路逐指潜变量聚合成一路手级潜变量,同时保留手指身份、手姿与接触的时间演化。聚合之前先做两件标注工作:给每个手指潜变量加可学习的手指身份嵌入 $\tilde{z}_{t,i}^{\tau}=z_{t,i}^{\tau}+e_{i}$,使 token 始终可归属到具体手指;用手姿编码器 $b_{t}^{q}=E_{q}(q_{t})$ 把当前手姿注入聚合查询,用以区分不同手形下的接触歧义。
压缩在每个时空胞 $(t,h,w)$ 上以集合编码的方式进行:取一个手查询与五个手指 token 组成六 token 集合,过一个小型自注意力集合编码器,只保留手查询的输出,即完成 5:1 压缩。为稳定训练,集合编码器的输出以残差形式加在一个 softmax 加权的手指平均上,且 logits 与残差增益初始化时使压缩器从均匀手指平均起步:
$$\tilde{z}_{t,h,w}=\sum_{i=1}^{5}\mathrm{softmax}(\ell)_{i}\,z_{t,i,h,w}^{\tau}+\alpha\,\tilde{z}_{t,h,w}^{\mathrm{set}}$$手查询本身携带可学习空间偏置 $p_{h,w}$ 与零初始化门控的姿态项 $q_{\mathrm{hand}}^{t,h,w}\leftarrow q_{\mathrm{hand}}+\alpha_{q}E_{q}(q_{t})+p_{h,w}$。融合后的手级网格再由轻量的分离时空注意力细化——时间轴上建模接触的出现、滑移、重抓与交接,空间轴上平滑邻域——输出同样经零初始化残差门加入。最终压缩器输出
$$\hat{z}_{t}^{\tau,L},\hat{z}_{t}^{\tau,R}=A_{\theta}(Z_{t}^{\tau,L},Z_{t}^{\tau,R},q_{t}),\quad \hat{z}_{t}^{\tau,\cdot}\in\mathbb{R}^{C\times T_{\mathrm{lat}}\times H^{\prime}\times W^{\prime}}$$实现中 $C=128$、空间网格 $H^{\prime}\times W^{\prime}=6\times 8$,时间长度与视觉潜变量轨道对齐:$T_{\mathrm{lat}}=\mathrm{mem\_size}+\lfloor \mathrm{chunk}/8\rfloor+1$。这让每只手的压缩触觉表示可以像一路额外相机视图那样直接接入世界模型。
3. 视触联合的视频扩散世界建模
世界模型一侧的改动同样克制:左右手触觉潜变量沿视图轴拼到视觉潜变量之后,扩散 transformer 收到 $V=V_{v}+V_{\tau}$ 路视图,DiT 结构本身不变,跨视图自注意力天然把视觉 token 与触觉 token 耦合在一起,对两种模态联合去噪。于是「场景如何演化」与「接触如何演化」成为同一个去噪问题的两个面。
训练目标采用按模态分流的流匹配损失。记干净联合状态 $s^{\mathrm{clean}}=[z^{v}\|\hat{z}^{\tau}]$,采样噪声水平 $\sigma\in(0,1]$ 并以高斯噪声 $\epsilon$ 腐蚀状态,网络预测速度 $v_{\theta}(s_{\sigma},\sigma)\approx\epsilon-s^{\mathrm{clean}}$,损失为
$$\mathcal{L}_{\mathrm{wm}}=\lambda_{v}\,\mathbb{E}\left[\left\|v_{\theta}(s_{\sigma},\sigma)_{[:V_{v}]}-(\epsilon-z^{v})\right\|_{2}^{2}\right]+\lambda_{\tau}\,\mathbb{E}\left[\left\|v_{\theta}(s_{\sigma},\sigma)_{[V_{v}:]}-(\epsilon-\hat{z}^{\tau})\right\|_{2}^{2}\right]$$其中 $\lambda_{v}=\lambda_{\tau}=1.0$。分流写法让视觉项负责全局场景演化、触觉项负责局部接触演化,二者权重可独立调节,也便于在消融中单独关闭触觉预测。
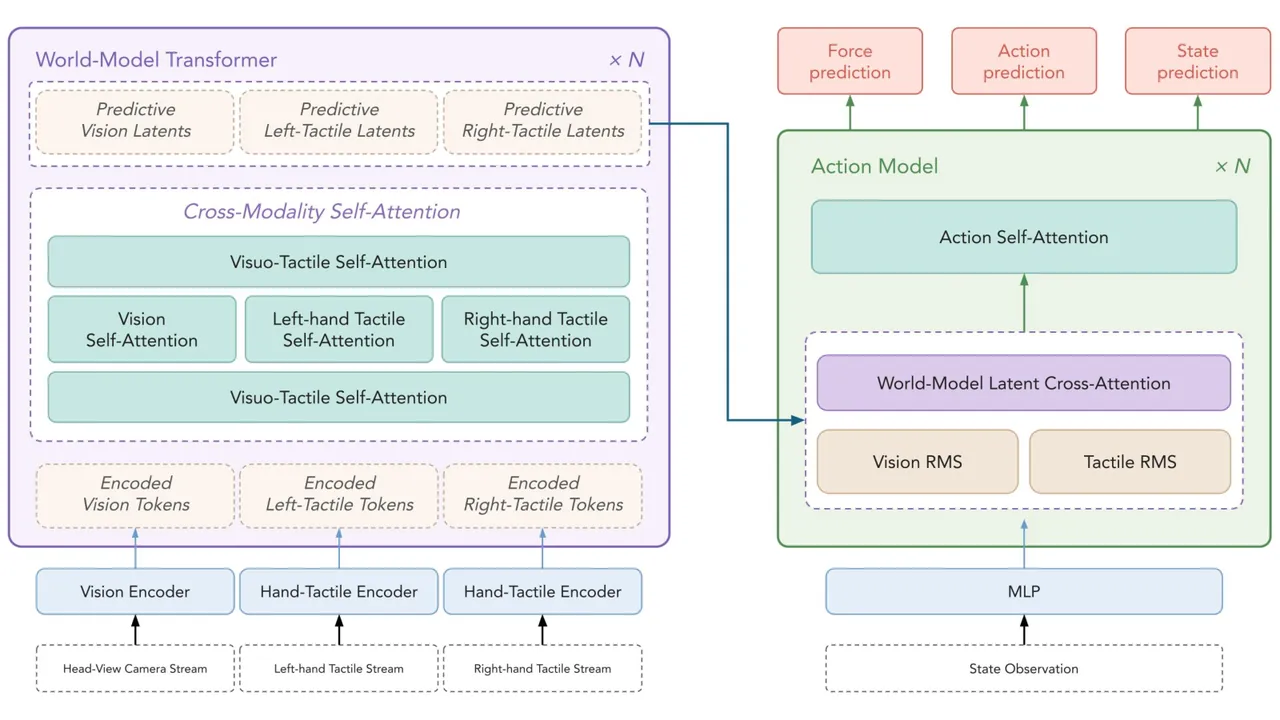
图 3:总体架构。左侧 World-Model Transformer 以逐模态自注意力与共享的跨模态自注意力融合视觉与双臂触觉 token,产出构成联合视触世界状态的预测潜变量;右侧 Action Model 以逐模态 K/V RMS 归一化的交叉注意力读取这些潜变量,并以本体状态 token 为条件,预测接触力、动作与下一状态。
4. 逐模态 K/V 归一化的动作专家
动作专家面对的核心困难是分布错配:视觉潜变量稠密、承载全局场景信息,触觉潜变量稀疏、对接触敏感,二者 token 的尺度与统计量差异显著。若把两者直接拼进同一个交叉注意力的 K/V 空间,注意力 softmax 会被量级更大的一方主导,优化病态。论文的实测结论很直接:去掉逐模态归一化,动作专家在实验中无法收敛,开环预测跟不住真值动作。
解法是在交叉注意力之前把 K/V 序列按模态切成视觉段与触觉段,各自做无参数的 RMSNorm 再拼回:
$$\widetilde{x}=\left[\mathrm{RMS}_{v}\!\left(x_{[:V_{v}L]}\right)\;\|\;\mathrm{RMS}_{\tau}\!\left(x_{[V_{v}L:]}\right)\right],\quad h^{a}=\mathrm{Attn}^{a}(h,\widetilde{x})$$注意力模块本身跨模态共享,没有可学习的模态门,也没有分开的视觉/触觉动作通路,只是在进注意力之前把两段的统计量各自拉平。这个设计用几乎为零的参数代价换来了训练稳定性,同时抑制了视觉主导。
动作目标是一个连续向量,包含逐指力、臂姿、手目标与本体状态预测:
$$a_{t}=[f_{t}^{1:N},\,a_{t}^{\mathrm{arm}},\,a_{t}^{\mathrm{hand}},\,s_{t}^{\mathrm{prop}}]$$其中力块为 60 维,对应 $N=10$ 根手指各 6 维力相关目标;臂块参数化为相对 chunk 起始实测位姿的末端执行器增量,而非绝对关节目标,使预测目标在工作空间内保持居中与尺度稳定——这一点在双臂交接这类需要精细相对对齐的任务上尤其重要。训练用单一流匹配 MSE 覆盖整个动作向量:
$$\mathcal{L}_{\mathrm{act}}=\mathbb{E}_{\sigma}\left[\left\|v_{\theta}^{a}(h,\sigma)-(\epsilon_{a}-a_{t})\right\|_{2}^{2}\right]$$值得强调的是力监督的位置:逐指力是统一动作目标的一部分,而不是额外加权的力损失;部署时动作模型不接收任何力输入,触觉只以预测潜表征的形式进入策略。力监督的作用是让动作模型在训练期无法忽略触觉通道。
5. 持续视觉到触觉学习:三阶段训练
第一阶段适配触觉编码器的可训练部件——灰度转 RGB 投影、压缩器、姿态编码器与时间细化模块——视觉 VAE 保持冻结。预训练语料 diverse-488 包含约 4 小时、488 条双臂灵巧操作 episode,取 episode 0 至 463 训练、464 至 487 留作表征分析;损失包含融合前与融合后的逐指重建项($\lambda_{\mathrm{loc}}=1.0$、$\lambda_{\mathrm{loc\_pre}}=0.3$),正是这两项把「压缩后仍要能还原每指接触」写进了目标函数。
第二阶段不做任何触觉中训练:冻结第一阶段触觉模块,对每个下游任务直接用约 100 条遥操作演示微调预训练视频模型,目标即上一节的按模态分流损失。第三阶段在同一批演示上从零初始化一个 160M 动作专家并训练,没有单独的动作预训练。整个流程的哲学是:用多样化的交互语料学一个可复用的触觉表征,再让任务级数据只负责适配世界模型与动作专家。
flowchart TD
    M1[10 fingertip grayscale tactile maps] --> M2[1x1 GrayToRGB adapter]
    M2 --> M3[Frozen LTX visual VAE]
    M3 --> M4[Per-finger latents plus finger identity embeddings]
    M4 --> M5[Per-cell set encoder: 1 hand query plus 5 finger tokens]
    Q1[Hand pose encoder] --> M5
    M5 --> M6[Softmax finger average plus residual set correction]
    M6 --> M7[Divided space-time refinement]
    M7 --> M8[Left hand tactile latent]
    M7 --> M9[Right hand tactile latent]
    R1[Head-view RGB] --> R2[Visual latent views]
    M8 --> C1[Concat along view axis: 3 latent views]
    M9 --> C1
    R2 --> C1
    C1 --> W1[Video DiT world model with cross-view self-attention]
    W1 --> W2[Modality-split flow matching over vision and touch]
    W2 --> W3[Predictive visuo-tactile latents]
    W3 --> N1[Per-modality K/V RMSNorm]
    N1 --> A1[Action expert cross-attention]
    P1[Proprioception state token via MLP] --> A1
    A1 --> A2[Action chunk: 60-D finger force, arm, hand, proprio]
图 4:DexTacWAM 的前向数据流。十路指尖触觉经冻结 VAE 与 5:1 压缩变成两路手级视图,与头部视觉视图拼接后进入视频 DiT 联合去噪;动作专家经逐模态 K/V RMSNorm 读取预测潜变量并输出含逐指力的动作 chunk。
6. 为什么视觉先验能迁移到触觉
附录 A.11 用一组探针实验回答了「冻结视觉 VAE 凭什么提供有用触觉表征」。在留集 episode 上采样 1350 个右手触觉片段,右拇指 128 维特征的 5 近邻与线性探针任务准确率分别为 95.6% 与 99.0%;经 5:1 压缩后的手级特征不降反升,达到 96.4% 与 99.6%,轮廓系数从 0.060 提高到 0.081,说明压缩没有抹掉任务相关结构。
更有意思的是时间结构:对每个任务内部做 k-means 聚类后,簇成员与片段归一化阶段的 ANOVA $R^{2}$ 在 Tongs 上为 0.75、Two-Hand Wipe 上 0.61、Cube Place 上 0.48、Cube Handover 上 0.40、Bowl 上 0.17,而与 episode 身份的调整互信息始终不超过 0.07——潜变量跟踪的是交互进度,不是录制批次。Bottle Cap 的 $R^{2}$ 只有 0.03,因为旋拧是周期动作,无法用单一起止阶段描述。另一方面,视觉与触觉潜空间依然清晰分离,模态间与模态内距离之比约 89,说明收益并非来自「两种模态被映到同一个不变表征」,而是来自视觉编码器提供的空间先验本身。
实验结果
主结果:六个接触富集任务全面领先
实验平台为双臂 22 自由度 Sharpa 触觉手,指尖提供覆盖指面的稠密接触观测。六个任务分别探针不同的接触能力:Cube Place w/ Occlusion 只开头部相机,让手臂自遮挡无法被近距视图化解;Cube Handover 考察双臂协调传递;Two-Hand Wipe 要求长时程稳定接触与压力维持;Tongs 通过工具夹取樱桃番茄,考察经工具传递的力控制;Bowl 要求拇指-食指摩擦分离叠碗;Bottle Cap 要求摩擦加扭矩的旋转接触。每个任务内所有方法的相机访问完全一致,每方法每任务 20 次真机试验,每任务约 100 条演示。
| 方法 | Cube Place (H) | Handover (H+L+R) | Wipe (H+L+R) | Tongs (H+R) | Bowl (H+R) | Bottle Cap (H+L+R) | 平均 |
|---|---|---|---|---|---|---|---|
| π0.5(无触觉) | 10.0 | 46.0 | 24.0 | 0.0 | 40.0 | 45.0 | 27.5 |
| ViTacFormer | 20.0 | 33.3 | 26.0 | 0.0 | 20.0 | 10.0 | 18.2 |
| RDP | 50.0 | 60.0 | 48.0 | 10.0 | 30.0 | 30.0 | 38.0 |
| Genie Envisioner(无触觉) | 10.0 | 30.0 | 44.0 | 5.0 | 35.0 | 40.0 | 27.3 |
| DexTacWAM(本文) | 90.0 | 71.6 | 77.0 | 60.0 | 65.0 | 60.0 | 70.6 |
表 1:六个任务的任务得分(%),每方法每任务 20 次真机试验;括号内为该任务的相机配置,任务内所有方法一致。
DexTacWAM 在六个任务上全部第一,平均 70.6 对最强基线 RDP 的 38.0。最大差距出现在 Tongs:60 对 10。这个任务里番茄被工具夹持,相机看不到夹爪与番茄之间的接触,唯一可靠的抓握证据是经钳子传递的力,因此所有以视觉为主的基线都在 10 分以下。整体模式与论文的动机假设一致:收益最大的地方,正是瞬时视觉观测最难推断任务相关物理状态的地方。
对照设计同样重要。RDP 接收与 DexTacWAM 完全相同的十指六维 wrench,但只把它们当作扩散策略的下游输入,不建模接触的演化,平均 38.0;两个无触觉条目 π0.5 与 Genie Envisioner 分别为 27.5 与 27.3。触觉条件化本身并不充分,把接触演化纳入被预测的世界状态才是差距的来源。值得注意的是,这些结果是在视频模型无触觉中训练、动作专家从零训练、无强化学习后训练的条件下取得的。
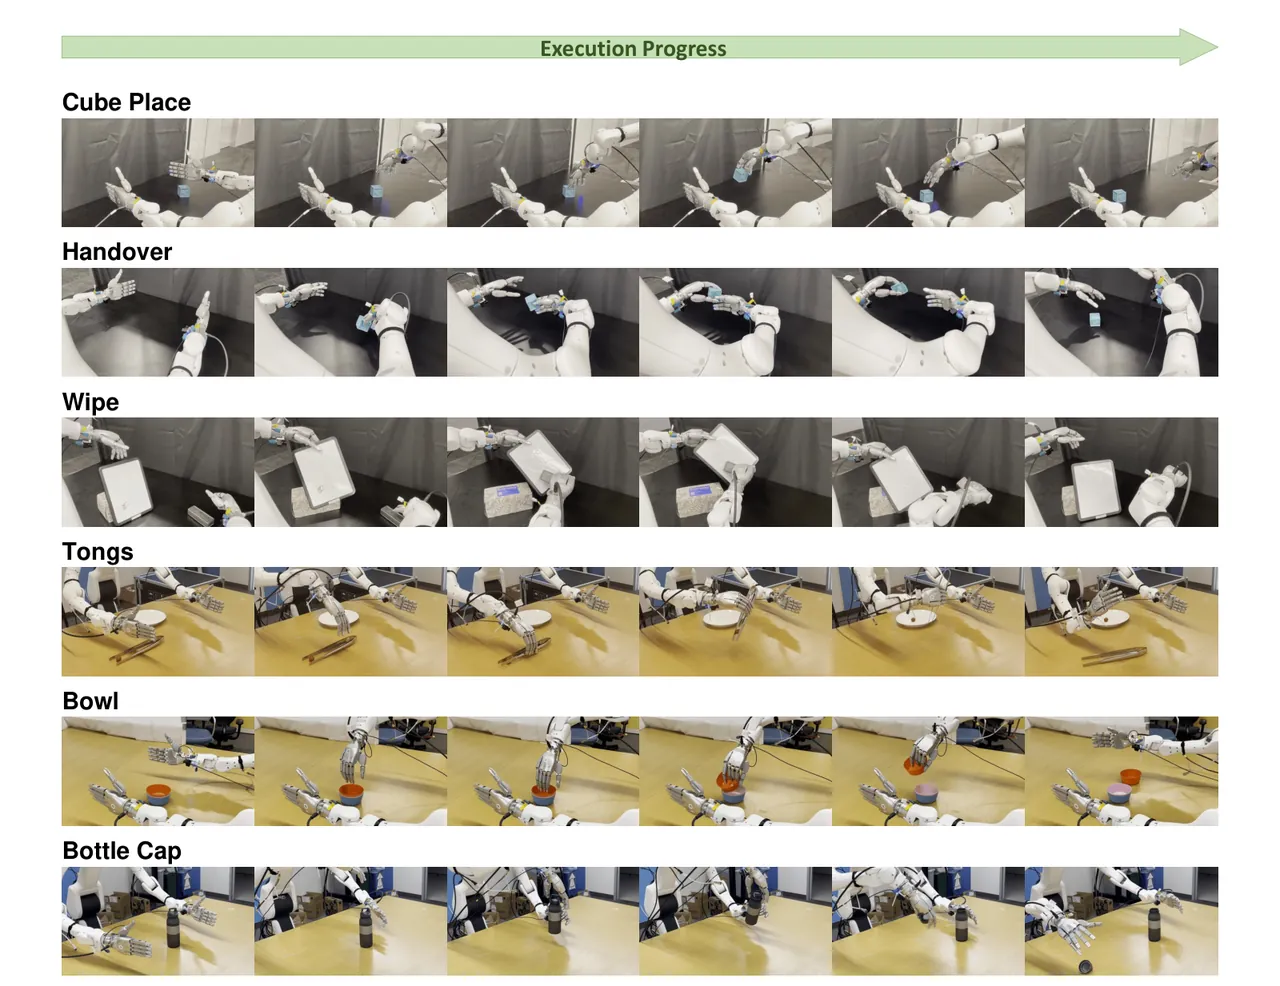
图 5:六个任务的自主闭环 rollout 关键帧,从左到右为执行进度。可以看到遮挡下的放置、双臂交接、双手擦拭、工具夹取、叠碗分离与旋拧瓶盖各自的接触形态。
统计显著性与未见配置泛化
为补足单任务 20 次试验的样本量,论文把四个二值任务(Cube Place、Tongs、Bowl、Bottle Cap)的结果池化,每方法 80 次试验:DexTacWAM 成功 55 次(68.8%),RDP 成功 24 次(30.0%);95% Wilson 置信区间分别为 [57.9, 77.8] 与 [21.1, 40.8],Fisher 精确检验 $p=1.59\times 10^{-6}$,总体成功率的优势在统计上显著。
泛化测试放在 Bowl 任务上:训练只用粉、蓝、橙三色的三碗叠放,测试换到未见过的绿、紫、黄碗时成功 13/20,与分布内表现持平;换到未见的两碗或四碗堆叠高度时成功 12/20。外观与堆叠几何同时变化而性能不掉,说明策略依赖的是接触与几何关系,而不是对训练碗的颜色记忆。
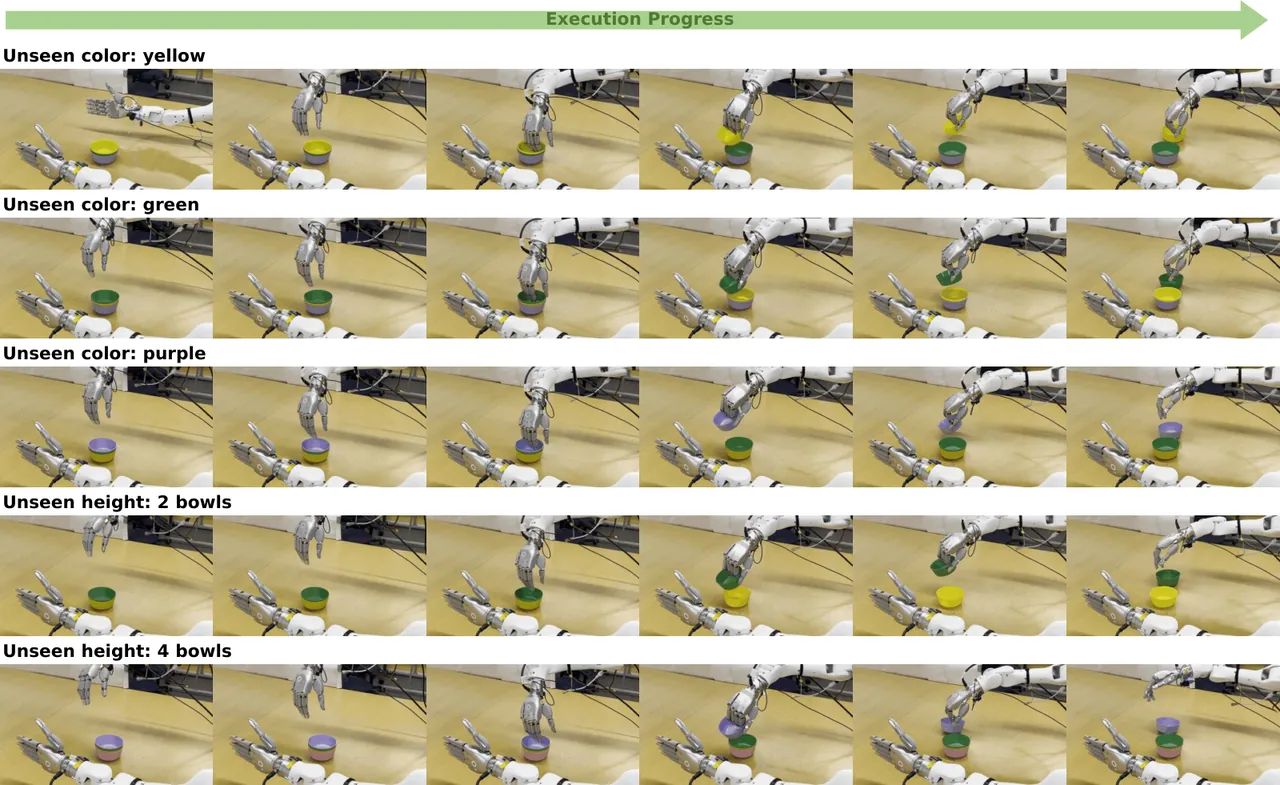
图 6:留集 Bowl 配置的 rollout。上三行为未见过的碗颜色,下两行为未见过的堆叠高度;所有情形中策略都能触及碗沿、建立拇指-食指接触并分离顶碗。
消融:触觉世界建模与逐模态归一化
策略级消融只减不加。「去掉触觉世界建模」变体保留触觉编码器、观测、动作专家、动作空间与训练数据,仅把世界模型中的触觉预测移除,让动作专家直接条件于编码后的触觉特征:四个任务的平均得分从 74.7 跌到 26.6。触觉信息含量没变,变的是「接触演化是否属于被预测的世界状态」,这直接把收益归因于预测式建模而非触觉条件化。「去掉逐模态 K/V RMS 归一化」变体则无法收敛,开环预测跟不住真值,因此没有进入闭环评测。
| 变体 | Cube Place | Handover | Wipe | Tongs | 平均 |
|---|---|---|---|---|---|
| DexTacWAM(完整) | 90.0 | 71.6 | 77.0 | 60.0 | 74.7 |
| 去掉触觉世界建模 | 20.0 | 33.3 | 48.0 | 5.0 | 26.6 |
| 去掉逐模态 K/V RMS 归一化 | 未收敛 | ||||
表 2:策略级消融,任务得分(%)。
压缩器消融:接触召回与保留率
编码器级消融在 diverse-488 的 24 条留集 episode 上用接触召回衡量,比下游任务分数更直接。论文定义保留率为融合后召回与融合前召回之比:
$$\mathrm{Retention}=\frac{\mathrm{Post\text{-}Fusion\ Recall}}{\mathrm{Pre\text{-}Fusion\ Recall}}$$从单层交叉注意力池化起步(Recall@9 为 0.492、保留率 62.9%),换成六 token 自注意力集合编码升到 0.575;加姿态注入或时间细化分别到 0.645 与 0.710;两者齐备的完整压缩器达到 Recall@1 0.748、Recall@9 0.725、保留率 89.4%。去掉手指身份嵌入后 Recall@9 降到 0.671,证实 token 必须保持可归属到手指,而不能退化成无序的接触袋。所有变体共享同一个冻结 VAE 与同样的逐指输入,差异完全来自聚合设计。
| 变体 | Recall@1 | Recall@9 | Retention@9 |
|---|---|---|---|
| 交叉注意力池化 | 0.561 | 0.492 | 62.9% |
| 自注意力池化 | 0.656 | 0.575 | 71.7% |
| 自注意力 + 姿态注入 | 0.750 | 0.645 | 79.6% |
| 自注意力 + 时间细化 | 0.748 | 0.710 | 87.3% |
| 完整压缩器(姿态 + 时间) | 0.748 | 0.725 | 89.4% |
| 去掉手指身份嵌入 | 0.702 | 0.671 | 84.9% |
表 3:触觉编码器组件消融,在留集 episode 上以接触召回与保留率衡量。
世界模型真的在预测接触演化吗
触觉信号时间上平滑,一个只会复读上一帧的预报器也能拿到好看的分数,因此论文专门与 copy-last-frame 基线对照。在留集轨迹上,预测触觉未来与真值的潜变量余弦相似度 0.967、NMSE 0.063,流空间接触精确率/召回率/F1 为 0.749/0.725/0.737,误差为复读基线的 0.561 倍——模型预测的是接触的演化,而不是利用平滑性偷懒。
| 指标 | DexTacWAM |
|---|---|
| 潜变量余弦相似度(越高越好) | 0.967 |
| 潜变量 NMSE(越低越好) | 0.063 |
| 接触精确率 / 召回率 / F1 | 0.749 / 0.725 / 0.737 |
| 相对 copy-last-frame 的误差比(越低越好) | 0.561 倍 |
表 4:留集轨迹上的触觉世界模型预测质量;接触指标在流空间计算。
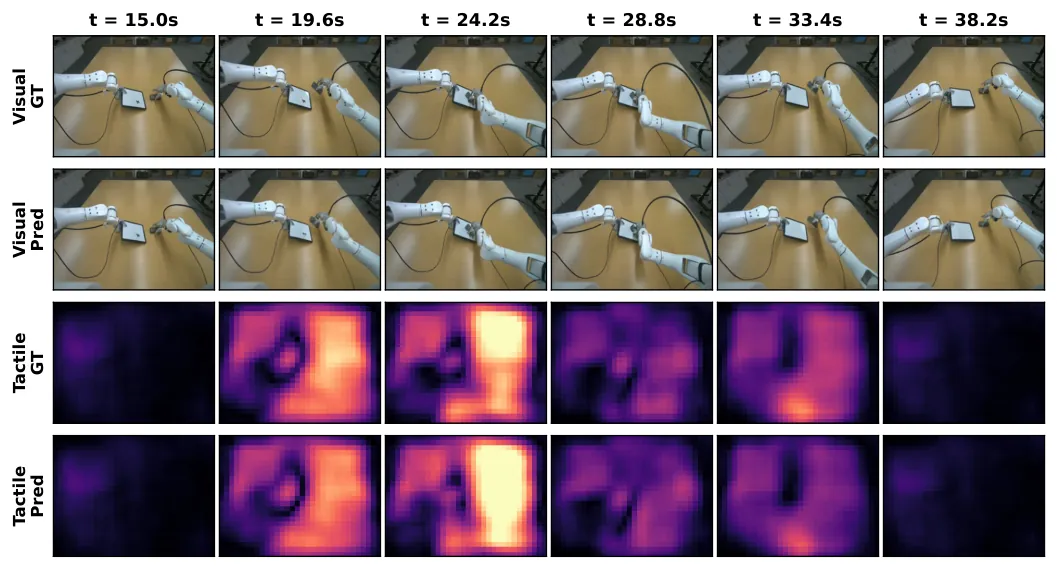
图 7:擦拭任务上视觉与触觉的联合预测。触觉行以统一色标显示右食指剪切幅度;在接近、接触、擦拭、释放六个时刻上,预测的接触斑块随交互出现、移动、消失,而不是作为静态印记残留。
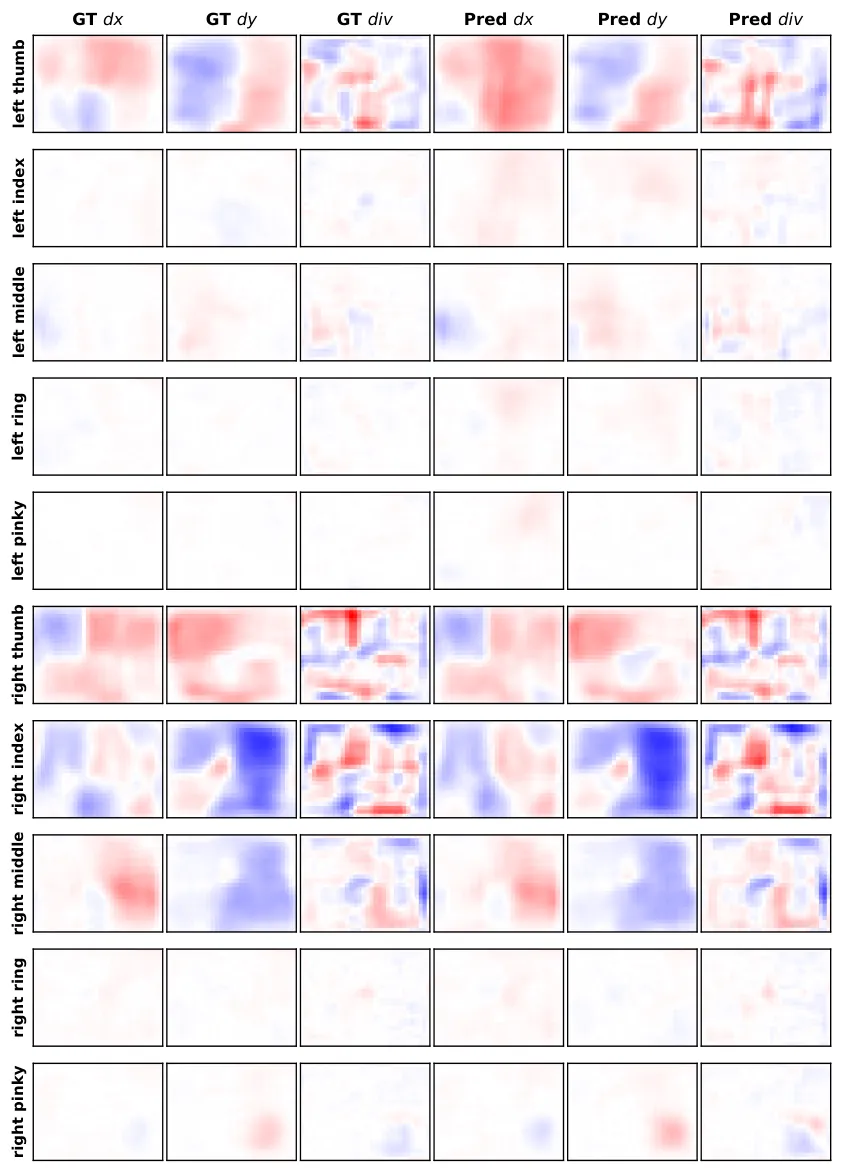
图 8:擦拭冲程峰值剪切时刻(t=24.2 s)十指的触觉流场预测,含 dx、dy 与散度通道;承载接触的手指上预测复现了主导形变模式,无接触手指预测与真值同近零,左拇指 dx 场在两个时刻之间变号也被预测跟上。
学会触觉之后,视觉预测掉了吗
持续学习的另一面是灾难性遗忘。论文为每个任务训练一个除触觉视图开关外完全相同的仅视觉对照模型,用配对 episode 差值而非不成对均值做统计:Cube Handover 上 ΔPSNR 为 +0.06 dB、Two-Hand Wipe 上为 −0.07 dB,配对 95% 置信区间分别为 [−0.16, +0.28] 与 [−0.49, +0.36] dB,SSIM 与 LPIPS 的差异同样在噪声级。考虑到 episode 难度本身带来约 2 dB 的波动,这组数据把视觉预测质量的损失上界压到了半个 dB 以内。
压缩带来的训练与部署效率
把十路指尖压成两路手级潜变量,使 DiT 关注的视图数从 11(头部 + 十指)降到 3(头部 + 双手),视图 token 从 3168 降到 864(3.67 倍);单张 RTX 4090 上端到端延迟从每 chunk 363.0 ms 降到 281.6 ms(1.29 倍),低于 1.8 s 的动作 chunk 执行时间,控制回路得以闭合;同样训练配置下迭代时间从 3.87 s 降到 1.71 s(2.26 倍),直接降低了视触世界模型规模化的成本。
失败模式
附录 A.8 的逐任务失败分析提供了诚实的对照。Two-Hand Wipe 上 DexTacWAM 的失败多表现为「擦了一部分但没擦干净」,暴露的是指令跟随与长时程进度监控的短板,而这恰是 π0.5 这类大规模预训练 VLA 的强项;反过来 π0.5 在该任务上常因左手扶不住白板而失败,因为它察觉不到板子在滑移。Cube Handover 的主要失败来自立方体初始位姿超出训练分布,误差从第一次抓取传播到交接。作者据此提出触觉知情的强化学习做闭环纠偏:接触一旦建立,指尖观测比腕部相机更直接地给出物体相对手指的位姿与抓握稳定性。
局限性
第一,传感器与 embodiment 覆盖面窄,这是作者自述的限制:全部实验只在 Sharpa 视觉式触觉手上完成,向电容、压阻、压电、磁感等其他触觉原理的迁移完全没有验证。视觉 VAE 复用策略是否对非图像形态的触觉信号(例如稀疏电极阵列或一维力序列)同样成立,是开放问题。
第二,仅成功演示的训练分布,同样是作者自述:世界模型与动作专家都只见过成功演示,对失手、滑脱、掉落等失败状态缺乏监督。附录 A.9 的定性观察与此一致——视触预测在第一次执行错误之前通常仍然合理,一旦策略进入未见失败状态,预测与动作质量同时恶化。恢复行为需要扰动、干预或强化学习提供的失败/恢复数据。
第三,评测规模与策略形态仍有保留空间:每任务 20 次试验、每任务单独微调一个模型,意味着六个任务对应六套世界模型与动作专家权重,而非一个多任务策略;动作专家从零初始化、只吃约 100 条任务演示,作者也承认动作预训练是明确的增益方向。此外全部结果来自单一实验室平台,跨机构复现尚不存在。
总结与展望
DexTacWAM 的贡献可以归结为一次视角转换:触觉不再是被策略消费的信号,而是世界模型必须为之负责的未来。围绕这一转换,论文给出了三个可独立验证的部件——冻结视觉 VAE 的逐指编码、保住手指身份与手姿的 5:1 压缩、按模态分流的联合去噪与逐模态 K/V 归一化——并用消融把收益逐一定位到「预测接触演化」而非「条件于触觉」。在数据侧,四小时触觉编码器适配加每任务约百条演示就把触觉预测能力接进了预训练视频模型,且视觉预测质量损失被压在半个 dB 内;在算力侧,压缩让训练快 2.26 倍、推理快 1.29 倍。
对机器人学习者而言,这篇工作给出了一条可复制的路径:不要为触觉另起炉灶,而是把触觉翻译成视觉先验已经听得懂的语言,再让预测目标本身承担融合的责任。下一步的自然延伸是作者指出的两个方向——跨传感器与跨 embodiment 的触觉预训练,以及用失败/恢复数据补齐自我纠偏能力;而把逐指力作为统一动作目标的一部分、部署时却不依赖力输入的做法,也为「触觉蒸馏进策略」提供了一个值得借鉴的模板。