PAPER DEEP DIVE
MachEmbodied-U0:理想汽车的统一理解-生成具身基础模型
理想汽车 Foundation Model 团队提出 MachEmbodied-U0(ME-U0),一个把理解与生成专家统一进 Mixture-of-Transformers 架构的具身基础模型。理解专家以自回归文本生成输出子任务描述与可供性定位(含边界框、交互方式与交互点);生成专家用 flow matching 联合去噪未来视觉动力学(RGB、深度、表面法线、光流)与连续机器人动作,四种视觉模态共享同一个视频 VAE 隐空间与生成骨干,无需分模态预测头。Multi-rate Rotary Position Encoding(MRPE)解决动作比视频密三倍带来的时间对齐问题:保留视频隐帧的共享时间位置,给块内每个动作按次序分配不同的高度轴索引,配合 H_a = 3(H_v - 1) 的采样规则,形成每视频隐步对应 12 个动作步的一致跨模态时间结构。数据侧从约 5,700 小时机器人示范加 3,920 小时第一人称示范中精选出约 4,200 小时,覆盖四个开源数据集与六种本体(AgiBot G1 占 52.8%);三阶段清洗依次做突变检测、状态-动作一致性检查与物理边界检查;Ego2Robot 合成流水线用 Depth Anything 3、SAM3、ProPainter、SAM3D、两阶段 PPO 与 MuJoCo/Mink 逆运动学把人类示范转为机器人对齐的观测与轨迹标注。实验在下游不补任何子任务、可供性、几何与运动标注的前提下取得 RoboDojo 17.66 分(WAM 组最强,精度 23.95、长程 36.98 领先最明显)、LIBERO 99.0%、LIBERO-Plus 82.5%,并保留零样本的子任务预测、可供性接地与视觉动力学能力。作者诚实指出记忆类任务最弱(Score 8.42),因模型不显式保留观测历史。
论文来源:arXiv:2609.25627(cs.RO),理想汽车 Foundation Model 团队,2026 年 9 月 22 日提交。项目页 machembodied.com/ME-U/ME-U0.html,代码 github.com/MachEmbodied/ME-U0。
一句话概括
ME-U0 把「理解」和「生成」两个专家塞进同一个 Mixture-of-Transformers 骨架:理解专家输出子任务描述与可供性(affordance)定位,生成专家用 flow matching 联合去噪未来视觉动力学(RGB / 深度 / 法线 / 光流)与连续机器人动作。用约 4,200 小时精选机器人 + 第一人称数据预训练,在 RoboDojo 上拿到 17.66 分,LIBERO 99.0%、LIBERO-Plus 82.5%,并且在不给下游额外标注的前提下仍保留零样本的子任务、可供性与视觉动力学能力。
1. 它到底在解决什么问题
通用机器人控制需要四件事同时成立:理解任务意图(what to do)、知道在哪里交互(where to act)、捕捉场景如何演化(how the scene evolves)、生成精确动作(how to realize it)。
现有两条路线各缺一半:
- VLA(vision-language-action):RT-1 / RT-2 / Octo / OpenVLA / $\pi_0$ / $\pi_{0.5}$ 拥有强大的语义先验,但动作中心的目标函数通常不显式建模场景在执行过程中如何变化。
- WAM(world-action model):UniPi / GR-1 / DreamZero / LaWAM / Fast-WAM 把未来观测预测与动作学习耦合,提供稠密的空间与运动监督,但仅有视觉动力学并不能保证任务相关的语义接地、交互定位或长程任务分解。
ME-U0 的立场是:这两件事不该二选一,而应该在一个架构里互为条件。语义理解为生成提供上下文,视觉生成把物理后果反馈给控制。
Task: Twist the bottle cap open"] --> U["理解专家
Understanding Expert"] V["多视角观测 + 机器人状态"] --> U V --> G["生成专家
Generation Expert"] U -->|"子任务 Subtask
可供性 Affordance
(共享多模态注意力)"| G G -->|"Flow Matching 联合去噪"| D["视觉动力学
RGB / Depth / Normal / Flow"] G -->|"Flow Matching 联合去噪"| Act["连续动作
Action Chunk $a_{t:t+H_a}$"] Act --> R["机器人执行"] D -.->|"物理后果监督"| Act
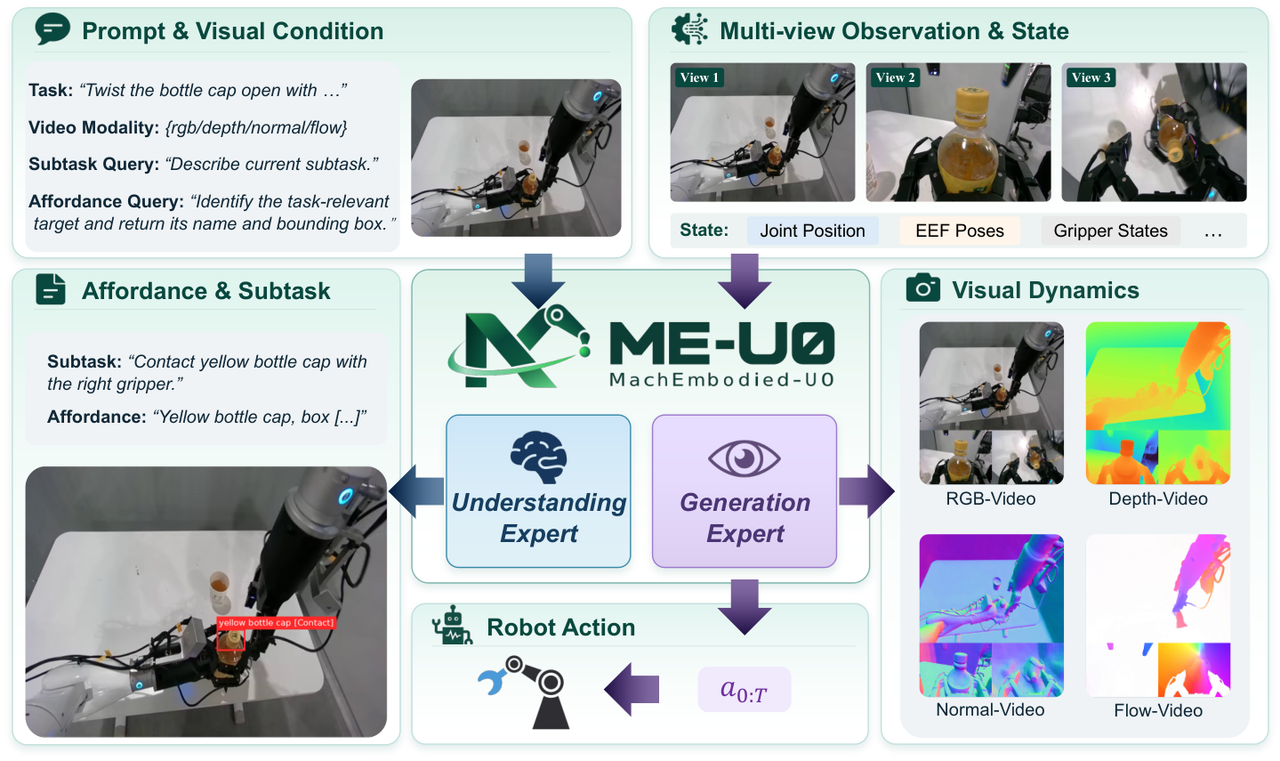
图 1:ME-U0 总览——理解专家与生成专家的协作。
2. 模型架构:MoT 双专家
2.1 整体骨架
模型从 Lance 初始化(一个已有的统一多模态理解+生成模型),再训练获得机器人能力。序列构成是:文本 token → 当前观测与机器人状态 token → 未来视觉与动作 token(含噪)。因果注意力保证文本 token 看不到未来目标;去噪时生成专家通过共享多模态注意力访问理解专家对输入图像与文本的表示。
两个专家各有一份 FFN 参数(MoT 的核心:参数分专家、注意力共享),这样语义理解与连续生成这两种差异很大的需求不会互相拖累,同时又能通过共享注意力协调。
2.2 理解专家:子任务 + 可供性
两项能力都被形式化为自回归文本生成,训练目标是下一 token 交叉熵:
$$\mathcal{L}_{\text{und}} = -\frac{1}{T}\sum_{t=1}^{T}\log p_\theta\!\left(y_t \mid y_{<t}, \mathbf{x}\right)$$
其中 $\mathbf{x}$ 包含当前图像、任务指令与上下文元数据,$y=(y_1,\dots,y_T)$ 是包含子任务与可供性标签的目标回答,损失只在被监督的回答 token 上计算。
- 子任务预测:整条任务指令在多个操作阶段里可能一字不变,但「当下这一刻的目标」随场景变化。模型被要求结合指令与当前观测描述局部操作目标——这一设计沿用 $\pi_{0.5}$ 的语义子任务监督。
- 可供性预测:对有标注的关键帧,用同样的问答形式让模型在当前图中指出任务相关目标、给出边界框、再给出预期交互方式与交互点。两项标注都齐时,可供性紧跟子任务出现在同一次回答里;没有可供性标注的样本保持原训练目标。
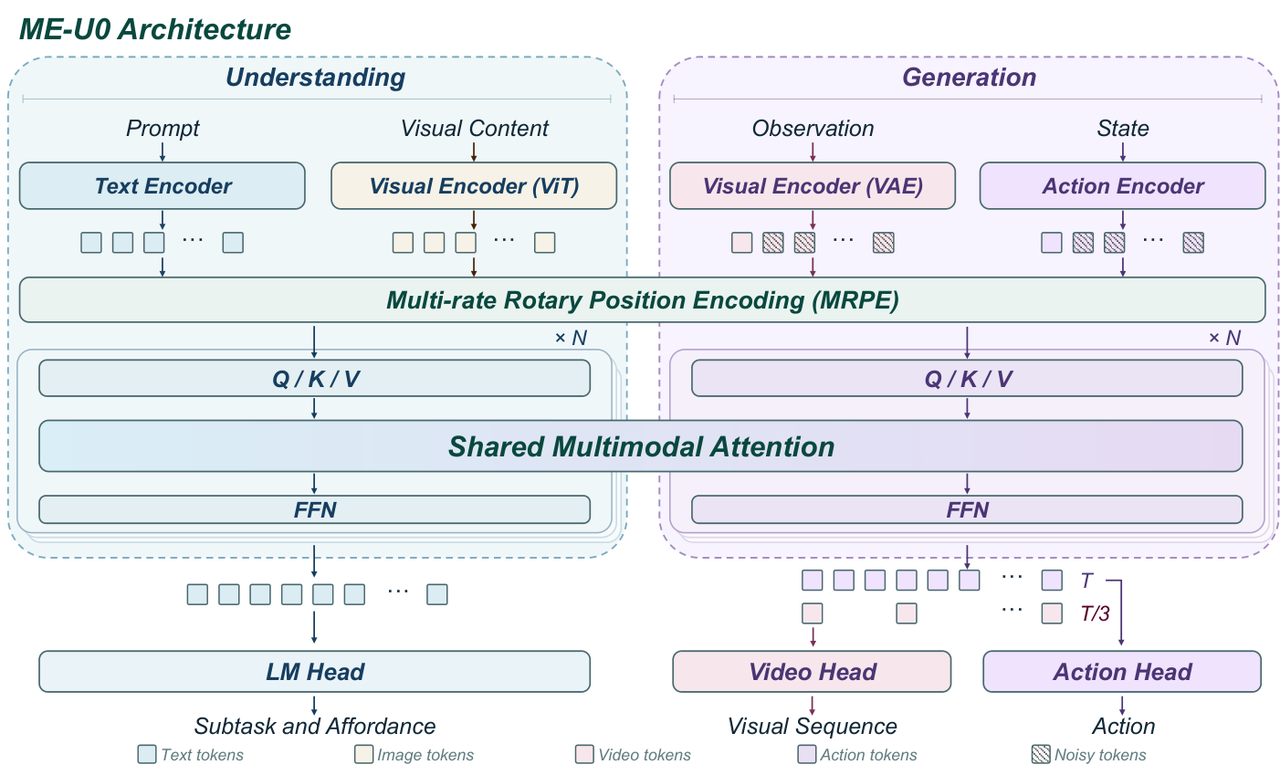
图 6:框架示意——理解专家预测子任务与可供性,生成专家通过共享多模态注意力联合预测未来视觉与动作。
2.3 生成专家:视觉动力学 + 动作联合去噪
给定条件上下文 $c$,用独立高斯噪声在时间 $\tau$ 上同时污染干净视觉目标 $z$ 与动作轨迹 $a$:
$$\tau = \sigma(u + \log 4),\quad u \sim \mathcal{N}(0,1)$$
$$z_\tau = (1-\tau)z + \tau\boldsymbol{\epsilon}_z,\qquad a_\tau = (1-\tau)a + \tau\boldsymbol{\epsilon}_a$$
这里用的是 shifted logit-normal 分布,刻意把采样质量推向更高噪声水平。带噪的视觉 token 与动作 token 一起送进生成专家,在双向自注意力中交换信息,再由各自的输出投影预测速度场:
$$(\hat{u}_z, \hat{u}_a) = v_\theta(z_\tau, a_\tau, \tau; c)$$
联合 flow matching 目标为:
$$\mathcal{L}_{\text{gen}} = \mathbb{E}\left[\lambda_z\left\|\hat{u}_z - (\boldsymbol{\epsilon}_z - z)\right\|^2_{M_z} + \lambda_a\left\|\hat{u}_a - (\boldsymbol{\epsilon}_a - a)\right\|^2_{M_a}\right]$$
其中 $\|\cdot\|^2_M$ 表示由掩码 $M$ 选出的有效元素上的均方误差。总目标把两者合起来:
$$\mathcal{L}_{\text{total}} = \mathcal{L}_{\text{gen}} + \lambda_{\text{und}}\mathcal{L}_{\text{und}}$$
为什么坚持联合去噪,而不是给动作单独配一个 denoiser?论文给的理由很直接:单独的 action denoiser 会把动作生成从共享生成过程里剥离出去,削弱「理解—视觉预测—控制」三者的架构统一性。联合去噪让动作直接参与多模态生成,在整个去噪过程中与视觉预测持续交互。
同一套骨干还能通过改变条件与预测目标来训练正/逆动力学:
$$\text{Forward: } (c, a) \rightarrow z,\qquad \text{Inverse: } (c, z) \rightarrow a,\qquad \text{Joint: } c \rightarrow (z, a)$$
2.4 多模态视觉目标:不只有 RGB
视觉动力学覆盖四种模态:未来 RGB、深度、表面法线、光流。深度与法线以三通道视觉目标表示,光流同理——分别提供几何结构、表面朝向、帧间运动的互补监督。关键在于:所有模态共享同一个视频 VAE 的隐空间与同一个生成骨干,不需要为每种模态单独设计预测头。生成时由提示里的 video-modality 字段指定要哪种。
2.5 MRPE:让动作和视频在时间轴上对齐
这是一个很容易被忽略、但工程上很关键的细节。视频 VAE 会做时间压缩,而动作的采样率比视频密三倍——每个视频隐帧对应一整块(chunk)连续动作。如果这块里的动作共用同一个位置索引,它们之间的先后顺序就无从表达。
MRPE(Multi-rate Rotary Position Encoding)在 mRoPE 基础上做了一件很小的事:保留该动作块对应视频隐帧的共享时间位置,但给块内每个动作按次序分配不同的高度轴索引,宽度轴索引固定。这样既维持了动作与视频的时间对齐,又显式编码了动作在块内的位置。配套地,采样策略保证:
$$H_a = 3(H_v - 1)$$
即 $H_a$ 个动作步、$H_v$ 个视频帧(含锚点帧),每两个相邻采样视频帧之间正好三个动作步;叠加视频 VAE 的时间压缩后,形成每个预测视频隐步对应 12 个动作步的一致跨模态时间结构。
2.6 统一动作表示:六种本体怎么塞进一个空间
本体多样性带来丰富经验,但控制约定不一致会掩盖数据间的共同结构——相同的数值在不同数据集里可能描述完全不同的物理量,甚至相反的控制方向。论文定义了统一的状态/动作接口:
| 组件 | 维度 | 共享表示 |
|---|---|---|
| 手臂:关节控制 | 6 / 7 | 关节构型,弧度 |
| 手臂:末端控制 | 9 | 笛卡尔位置(米)+ 6D 朝向 |
| 夹爪 | 1 | 归一化闭合坐标:$0$ = 全开,$1$ = 全闭 |
| 底盘 | 3 | 体坐标系平面速度 $(v_x, v_y, \omega_z)$,m/s 与 rad/s |
| 躯干:AgiBot | 2 | 俯仰与升降位置,弧度与米 |
| 躯干:Galaxea | 3 | 平面笛卡尔速度 $(v_x, v_z, \omega_y)$,m/s 与 rad/s |
| 头部 | 2 | 偏航与俯仰关节位置,弧度 |
具体例子很能说明工作量:Galaxea 原生夹爪指令是 $[0,100]$,需要反转并重新缩放到闭合坐标,而 AgiBot 的约定正好保留;AgiBot 以毫米计的夹爪状态要单独标定。Galaxea 的底盘状态记录为轮子转向角与轮速,但动作却是笛卡尔速度——需要做运动学转换,让状态与动作拥有共同的物理含义。物理含义确实不同的量(如躯干位置 vs 躯干速度)则保持显式区分,不强行合并。
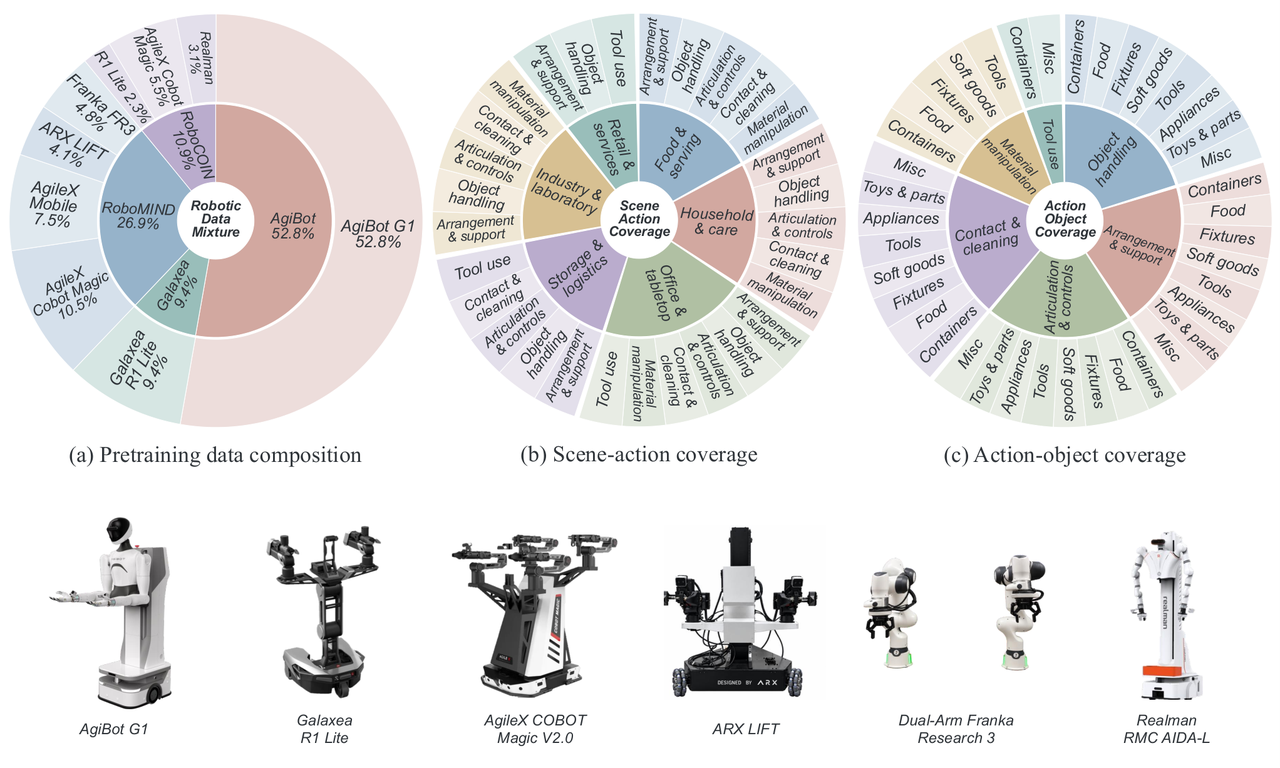
图 2:机器人数据构成与 scene–action–object 多样性。
3. 数据:5,700 + 3,920 小时怎么筛到 4,200 小时
3.1 构成
原始池约 5,700 小时机器人示范 + 3,920 小时第一人称(egocentric)示范,精挑后保留约 4,200 小时。机器人数据来自四个开源数据集:AgiBot World Beta、RoboMIND 2.0、RoboCOIN、Galaxea Open-World,覆盖六种本体(AgiBot G1 占 52.8%,另有 Galaxea R1 Lite、AgileX COBOT、Magic V2.0、ARX LIFT、Dual-Arm Franka Research 3、Realman RMC AIDA-L)。
团队还建了一套 scene–action–object 三维标签体系,聚合为六个场景组、六个动作组、八个物体组,用来确认「共享行为出现在不同任务语境里」而不是只覆盖窄窄一组特定行为。
第一人称数据(EgoDex、EgoLive、EgoVerse、HOI4D、HOT3D、Ego-Exo-4D 的手工标注部分)用于补齐机器人数据里覆盖不足的任务标签,要求具备时间对齐的第一人称观测与指尖位置、腕部位姿、手臂/肩部状态等底层人体运动标注。
3.2 三阶段清洗
按 $q_{99}-q_{01}$ 缩放各维
中值滤波+平滑作参考
残差/加速度/jerk 过大 → 剔除"] C1 --> C2["② 状态-动作一致性
平滑一阶差分互相关估指令-响应滞后
在滞后对齐且动作有变化的时刻测方向一致性
一致性低 / 动作变化时状态冻结 → 剔除"] C2 --> C3["③ 物理边界检查
人工复核的逐维物理边界
(夹爪通道豁免,开关量非平滑运动)"] C3 --> K["保留 episode
不改动原始记录,保持时间连续性"]
论文给了三个具体失败案例:桌面擦拭 29.93 s 处 J6 残差 1.907 超过阈值 0.054;滑动吧凳 9.40 s 处动作 $+0.682$ 而状态 $-0.657$ 方向相反;收纳餐具 81.07 s 处 J1 目标 $-6.26$ 低于下界 $-2.00$。
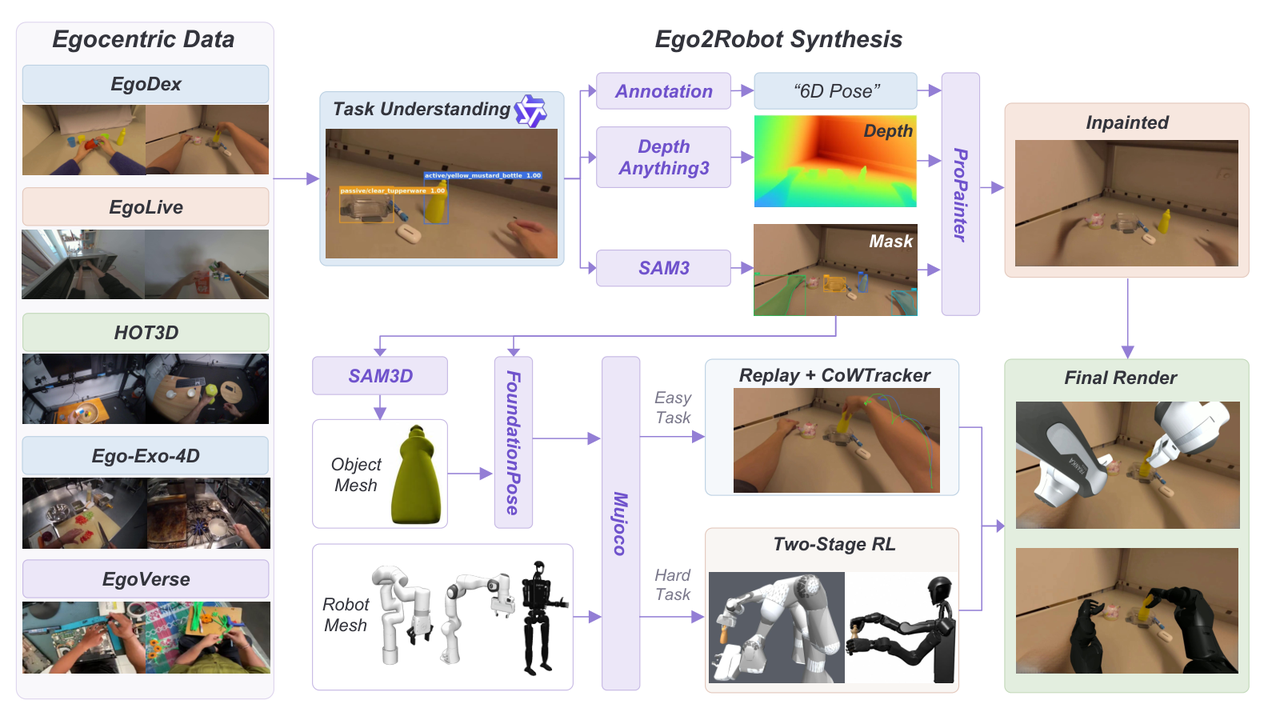
图 5:第一人称数据处理总览——Ego2Robot 合成把人类示范转为机器人对齐的观测与轨迹标注。
3.3 第一人称 → 机器人:Ego2Robot 合成
这条流水线是论文里最有工程含量的一段。先按物体属性把 episode 分为 easy(轨迹可重放) 与 hard(需接触精修) 两类:
- 共有步骤:Depth Anything 3 出度量深度 + SAM3 出掩码 → 按 Inpaint Anything 思路用 ProPainter 抹掉人体区域并补全被遮挡背景。
- easy:重放标注轨迹,用 CoWTracker 保证像素空间精度,降低 2D-3D 失配。
- hard:用 SAM3D 把被操作刚体重建为 3D 物理模型,融合掩码/深度/6D 位姿估计恢复时间一致的物体轨迹;腕部与指尖轨迹再经过两阶段 PPO 课程精修接触精度与平滑度。
- 最后:两条分支的最优轨迹通过本体专属逆运动学(Mink 求解,MuJoCo 仿真)重定向到带夹爪的本体上,机器人网格按物体深度解决遮挡后渲染回已修补的第一人称视频。
3.4 任务感知采样
数据多样 ≠ 训练暴露多样。按时间步等比例采样会把监督集中在充裕任务和长示范上。做法是全局任务感知采样:先给每个合格任务一份来自多个 episode 的初始覆盖配额,再用温度采样分配剩余预算:
$$w_k = \max(R_k, 1)^{\alpha}$$
其中 $R_k$ 是任务 $k$ 的剩余容量,$\alpha = 0.5$。次线性加权削弱大任务桶的统治地位,同时仍偏好数据更多的任务;分配始终受可用数据容量约束,避免对少样本任务激进过采样。容量不足的任务从第一人称数据补。最终从合格任务中抽取 1.2 亿训练样本。
3.5 视频-动作时间对齐的逐源配置
| 数据源 | 动作 (Hz) | 视频 (Hz) | $H_a / H_v$ | 视野 (s) |
|---|---|---|---|---|
| AgiBot World Beta | 30 | 10 | 36 / 13 | 1.20 |
| Galaxea Open World | 15 | 5 | 24 / 9 | 1.60 |
| RoboMIND 2.0: AgileX / Mobile / ARK | 30 | 10 | 36 / 13 | 1.20 |
| RoboMIND 2.0: Franka | 15 | 5 | 24 / 9 | 1.60 |
| RoboCOIN: 30 Hz 录制 | 30 | 10 | 36 / 13 | 1.20 |
| RoboCOIN: 50 Hz 录制 | 25 | 8.33 | 36 / 13 | 1.44 |
约束很明确:预测窗口落在约 1–2 秒内,动作比视频密三倍——用更细的控制监督换取更省的视频序列。
4. 训练基础设施(这部分很实在)
两个反复出现的开销被专门优化:
- 数据集初始化:episode 清单前置到数据准备阶段(记录 id、长度、任务归属、过滤信息);子任务索引可复用(保存完整标注区间,训练时按配置推导锚点,跨实验可复用);轻量 LeRobot reader 直接读原生格式。效果:全量混合集初始化从约 1 小时降到 10 分钟以内。
- 视频解码:训练样本组织为 logical shard(同一任务、相邻锚点聚合),worker 加载时合并重叠帧请求——论文例子里 12 个请求降到 6 个唯一帧,解码后留在共享内存里供多个样本拼装。再配合解码任务跨度限制、并发上限、下一 shard 异步预取,以及把解码卸载到独立 CPU 作业写入共享缓存。效果:整体训练时间减少 30% 以上。
5. 实验结果
5.1 关键前提:下游没有额外标注
这一点必须讲清楚,否则数字容易被误读。RoboDojo 和 LIBERO 都不提供子任务/可供性标注,也没有几何与运动的辅助监督;为了公平对比,后训练阶段也没有给它们补这些信号。也就是说,模型在预训练阶段学到的子任务、可供性、深度/法线/光流能力,在下游微调时处于「被闲置甚至可能被削弱」的状态——论文正是在这个「reduced-supervision」设定下汇报成绩的。
后训练配置:两个基准从同一个预训练检查点出发,各用 368 张 PPU810E 加速卡、单卡 batch size 2;LIBERO 用动作视野 24 + 末端位姿控制,RoboDojo 用动作视野 48 + 增量关节位置控制。
5.2 RoboDojo-Sim:WAM 组内最强
| 模型 | 类别 | 整体 SR | 整体 Score | 精度 Score | 长程 Score |
|---|---|---|---|---|---|
| StarVLA | VLA | 3.24 | 6.40 | 9.90 | 14.15 |
| X-VLA | VLA | 6.52 | 10.13 | 18.32 | 16.53 |
| $\pi_{0.5}$ | VLA | 6.93 | 11.44 | 12.40 | 23.54 |
| Spatial Forcing | VLA | 8.04 | 12.38 | 17.32 | 23.26 |
| Hy-Embodied-0.5-VLA | VLA | 8.80 | 13.07 | 13.81 | 25.74 |
| Xiaomi-Robotics-1 | VLA | 13.93 | 20.07 | 26.69 | 38.39 |
| GalaxeaVLA (G0.5) | VLA | 14.88 | 20.23 | 28.25 | 44.12 |
| DM0.5 | VLA | 19.34 | 24.90 | 24.82 | 33.70 |
| Fast-WAM | WAM | 2.03 | 3.48 | 1.96 | 9.14 |
| AHA-WAM | WAM | 2.39 | 4.82 | 5.86 | 8.61 |
| GigaWorld-Policy-0 | WAM | 3.27 | 6.20 | 6.15 | 15.51 |
| X-WAM | WAM | 3.83 | 7.69 | 6.72 | 17.47 |
| OpenWAM-$\alpha$ | WAM | 11.92 | 17.18 | 18.45 | 34.93 |
| ME-U0(ours) | WAM | 11.18 | 17.66 | 23.95 | 36.98 |
三个读点:
- 在 WAM 组内整体最强(17.66 vs OpenWAM-$\alpha$ 的 17.18),且在精度(23.95)与长程(36.98)两个维度上领先幅度最明显——这正对应论文主张:把联合视觉-动作动力学用子任务与可供性上下文接地,同时利好细粒度交互与长程执行。
- 只用了约 4,200 小时预训练语料,就能和成熟 VLA 基线打得有来有回(17.66 高于 $\pi_{0.5}$ 的 11.44、Spatial Forcing 的 12.38)。
- 诚实承认短板:依赖记忆的任务最弱,Score 8.42、SR 7.00%。论文归因于当前模型不显式保留观测历史——一旦任务相关信息已不在当前视野里就抓瞎。这是它自己点名的下一步方向。
5.3 LIBERO 与 LIBERO-Plus
| 模型 | 类别 | Spatial | Object | Goal | Long | 平均 |
|---|---|---|---|---|---|---|
| $\pi_{0.5}$ | VLA | 98.8 | 98.2 | 98.0 | 92.4 | 96.9 |
| OpenVLA-OFT | VLA | 97.6 | 98.4 | 97.9 | 94.5 | 97.1 |
| ABot-M0 | VLA | 98.8 | 99.8 | 99.0 | 96.6 | 98.6 |
| X-VLA | VLA | 98.2 | 98.6 | 97.8 | 97.6 | 98.1 |
| Fast-WAM | WAM | 98.2 | 100.0 | 97.0 | 95.2 | 97.6 |
| LingBot-VA | WAM | 98.5 | 99.6 | 97.2 | 98.5 | 98.5 |
| OpenWAM-$\alpha$ | WAM | 99.6 | 99.6 | 99.8 | 98.2 | 99.3 |
| ME-U0(ours) | WAM | 98.4 | 99.8 | 99.0 | 98.6 | 99.0 |
标准 LIBERO 已经接近饱和(99.0%,四个套件全部 98.4–99.8%),区分度有限。真正有信息量的是 LIBERO-Plus——同一份检查点、不做任何针对性适配,在 10,030 个扰动实例上拿到 82.5%:
| 扰动维度 | ME-U0 | 同组最优对照 |
|---|---|---|
| 光照 Light | 97.6 | ImageWAM 98.1 |
| 语言 Language | 90.4 | ImageWAM 91.4 |
| 物体布局 Layout | 84.5 | Qwen-RobotManip 87.3 |
| 背景纹理 Background | 81.9 | Qwen-RobotManip 97.7 |
| 传感器噪声 Noise | 81.3 | Qwen-RobotManip 97.7 |
| 机器人初始状态 Robot | 75.7 | OpenWAM-$\alpha$ 76.1 |
| 相机视角 Camera | 70.2 | Qwen-RobotManip 87.2 |
| 整体平均 | 82.5 | Qwen-RobotManip 89.0 / $\pi_{0.5}$ 84.4 |
结论很清楚:光照与语言扰动几乎不构成威胁(97.6% / 90.4%),相机视角变化与机器人初始状态变化是最难的两类(70.2% / 75.7%)。论文明确把这两项列为后续改进方向。
5.4 真机与零样本
真机部署用的是预训练检查点,没有做任何后训练或部署适配,推理在远程服务器上跑。三个展示任务:拿起马克笔、把纸巾放进盒子、把数字 20 挪到位完成等式 $3+17=20$(最后这个有意思——它需要把语义理解落到具体物体选择上)。论文也坦白:这些平台都在预训练语料里,考察的是熟悉本体上的部署,不是对新本体的泛化。
零样本分析(全部样本来自预训练语料之外,纯粹用于评估):
- 视觉动力学:在 RoboDojo 仿真与真机两个 split 上生成深度、法线、光流,都能捕捉有意义的场景结构与运动。真机样本上反而比仿真样本略稳定,论文猜测是仿真图像与预训练所见真实观测之间的域差所致。
- 可供性:在 RoboDojo 仿真/真机、自采数据、RDT-1B 数据上都能指出任务相关目标并给出边界框——充电器、水果、笔、吸管,以及碗内区域、桌面区域这类非物体区域。
- 子任务:同样样本上描述当前阶段该做什么,例如「用右手拿起桌上的充电器」→「用右手把充电器插进插排」这样的阶段推进。
6. 我的读法
这篇论文值得注意的地方不在某个单点指标,而在它把「理解—预测—控制」三件事放在同一个可训练对象里,并且给出了清晰的消融暗示:RoboDojo 上精度与长程两个维度的大幅领先,很难只用「数据更多」解释,更像是子任务/可供性上下文确实帮生成专家找到了该看哪里。
同时必须看到它的边界:
- RoboDojo 整体成功率只有 11.18%——这个基准本身极难(42 个任务、含开放词汇),最强 VLA 也就 19.34%,不能拿 LIBERO 的 99% 去想象它。
- 下游微调时那些漂亮的零样本能力是被「闲置」的,论文没有展示「同时保留监督」能拿到多少增益,这是一个留白。
- 记忆维度是明确短板(Score 8.42),模型不保留观测历史,本质上还是「当前帧条件」的策略。
- LIBERO-Plus 上相机视角 70.2% 说明它对视觉分布偏移并不鲁棒,真机部署范围也局限在见过的本体。
另外几个工程细节值得单独记住,它们的可迁移性很高:MRPE 用位置编码解决「多速率时间对齐」这个所有 video-action 模型都会撞上的问题;logical shard + 合并重叠帧请求把视频训练 I/O 压下来 30%;统一动作空间里对夹爪方向、轮速与笛卡尔速度的处理方式,是跨本体训练时的标准坑位清单。
7. 资源
- 论文:arXiv:2609.25627
- 项目页:https://machembodied.com/ME-U/ME-U0.html
- 代码:https://github.com/MachEmbodied/ME-U0