PAPER DEEP DIVE
World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人
香港科技大学(广州)、香港中文大学与 Knowin AI 提出 World Action Agent(WAA),一个多智能体 harness——它不改 VLM,而是改 VLM 看到什么、以及它的决策如何生效,让通用 VLM 只用点选、拖拽、预览、执行等基础工具就能驾驶机器人,所有决策都在同一个「视觉动作工作区」内完成。工作区有三个性质:其一是 Contact views,根据交互区域、遮挡、取景紧凑度、视点冗余与稳定性主动求解相机参数,且约束两个视图的水平投影正交,使任何对齐误差都能沿两个独立方向被读出,且只需基坐标系点云,因此对 RGB-D 融合、仿真渲染或 VGGT 重建等感知来源完全无关;其二是动作试演,把每个动作表示为可编辑提案,由 cuRobo 规划后以半透明机器人叠加到各视图并报告可行性,Imagination Agent 在物理场景不变的独立上下文中反复修订,只有具备可执行规划的提案才能变成物理运动;其三是视图内修正,智能体在观察到误差的 Contact view 中从参考点拖到期望位置,参考点可以是所持物体上的可见点,因此无需先把关系换算成绝对位姿。技能侧由 Learner、Editor、Reviewer 三个角色在证据与独立审核约束下从专家视频与人类 Canvas-GUI 教学中进化出关系型多模态技能库。LIBERO-Pro 上以 Gemini 3.7 Flash 为骨干、仅用 LIBERO-90 进化并冻结的技能取得 75.6% 平均成功率的 SOTA,超过 ASPIRE(72.0%)、端到端 VLA 与同骨干的 Show-Harness(6.7%),Spatial 两个切分达 80.0 / 73.3;每回合仅 31 次模型调用、150 秒、0.1996 美元,远低于 Show-Harness 的 120 次、874 秒、0.5021 美元。同一套冻结技能迁移到 robosuite 达 100.0%;用 112 条轨迹(1,774 决策步)LoRA 微调 Qwen3.5-9B 只替换主智能体,域外成功率从 1.7% 提升至 43.3%。
论文来源:arXiv:2609.29964(cs.RO),香港科技大学(广州)、香港中文大学、Knowin AI,2026 年 9 月 24 日提交,29 页。作者标注为 working in progress。
一句话概括
通用 VLM(视觉语言模型)有广博的知识和空间推理能力,但现有系统用它们的方式都很「隔」——要么让它预测约束、要么让它写程序,要么只给它看一张场景图而不是一个可以行动的世界。World Action Agent(WAA)的思路是:不改 VLM,改它看到什么、以及它的决策怎么生效。它构建了一个多智能体 harness,让 VLM 只用基础工具(点选、拖拽、预览、执行)就能驾驶机器人,且每个决策都在同一个「视觉动作工作区」(visual action workspace)里完成。这个工作区有三个性质:自动选出的 Contact views 把镜头对准当前交互处;Action rehearsal 把每个动作变成可编辑提案,执行前先在虚拟场景里试演并依据规划反馈修订;In-view correction 让智能体在「看到误差的那个视图里」直接把误差拖掉。在 LIBERO-Pro 上,仅用 LIBERO-90 进化出的技能就达到 75.6% 平均成功率(SOTA),超过端到端 VLA、code-as-policy 智能体与同骨干的视觉 harness 基线;同一套技能无需再学习即可迁移到 robosuite;用 harness 轨迹微调 Qwen3.5-9B,其域外成功率从 1.7% 提升到 43.3%。
1. 问题的提法:VLM 到底该怎么「上手」机器人
1.1 三条现有路线各自的缺口
- 端到端 VLA(RT-2、OpenVLA、$\pi_{0.5}$):把 VLM 微调成动作预测器。问题在于——为动作预测而微调 VLM,可能削弱它原有的通用理解与推理能力(Hancock et al., 2026)。
- 世界动作模型 WAM:把环境动力学与动作学习耦合。但把学到的视觉动力学落地成可执行控制,仍然需要机器人数据做动作对齐,且跨本体迁移对形态与动作空间差异敏感。
- 约束/程序路线(HAMSTER、ReKep、CaP、CaP-X):让 VLM 预测中间路径、关系约束或直接写程序。VLM 只是间接参与——它给出约束或代码,而不是用自己的空间理解直接操作机器人原语。
1.2 视觉 harness 差的那三件事
Show-Harness、VIA 这类工作往前走了一步:VLM 通过可视化机器人接口直接选择和修订动作,把操作变成交互式视觉推理问题。但作者尖锐地指出——这类接口只是「把场景显示给 VLM 看」,并没有给它一个可以在其中行动的世界。缺三样东西:
- 观测不以交互为中心。成败取决于夹爪、物体、目标之间的局部关系,但固定全局相机因为距离、遮挡、退化视角常常看不清这些关系。
- 动作不能先试再执行。每个动作一发出就生效,VLM 没机会先看到后果。
- 感知与动作不在同一个空间。在图像里看到的偏移,必须先被改写成坐标才能修正——这一步转换本身就是误差与信息损失的来源。
于是问题被重新表述为:一个通用 VLM 如何只用基础动作原语,在执行全程持续做出并修订决策,充当机器人的驾驶员?WAA 的答案是换掉「VLM 看到什么」和「决策如何生效」,而不是换掉 VLM 本身。
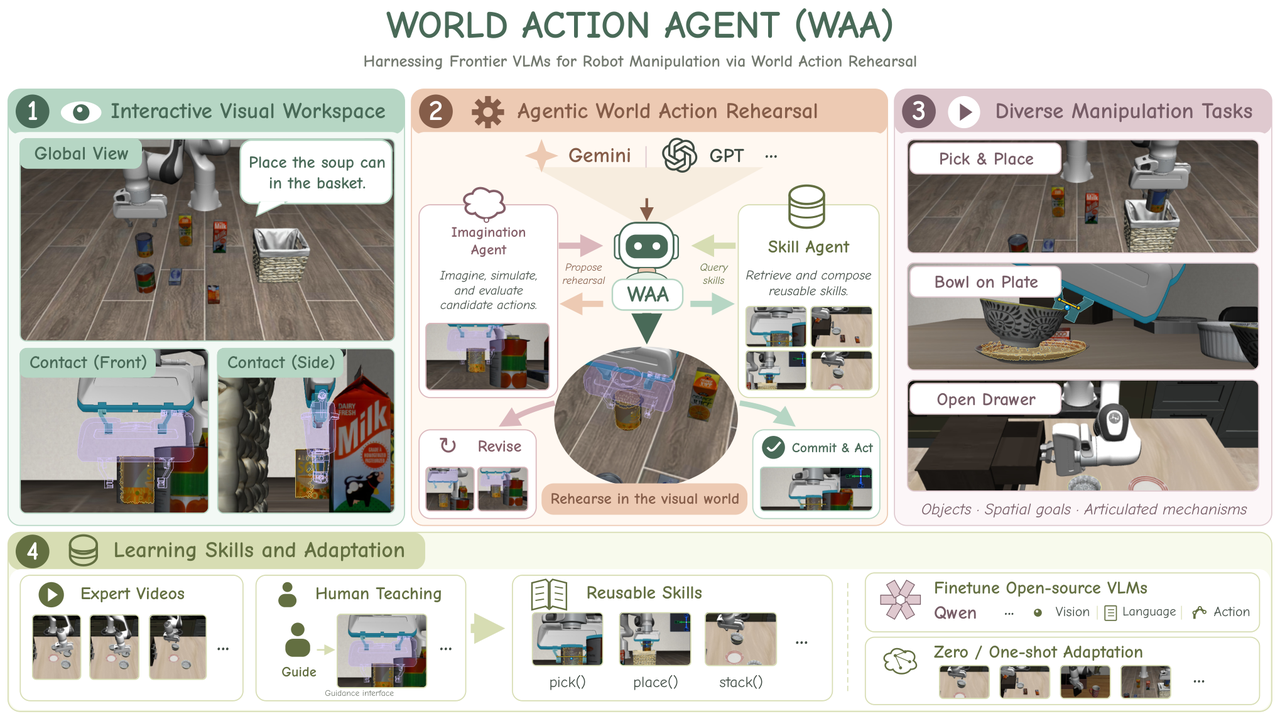
图 1:WAA 总览——视觉动作试演 + 可复用技能,让 VLM 完成多样操作任务并通过专家示范与人类指导适应。
2. 方法:视觉动作工作区
2.1 形式化
给定任务指令 $g$,智能体通过一串工具调用完成任务。在步骤 $t$,harness 呈现一个多视图 Canvas $C_t$ 与一个控制上下文 $m_t$(记录有效的空间引用、待定的动作提案 $\hat{a}_t$、以及近期的执行反馈)。策略选择工具调用:
$$u_t \sim \pi_\theta(\cdot \mid g, C_t, m_t)$$
其中 $u_t$ 指定一个工具及其参数。工具按效果分三类:
- query 工具——获取空间信息或技能指导;
- proposal 工具——构造并修订 $\hat{a}_t$,返回视觉预览与规划反馈;
- execution 工具——真正移动机器人。
关键设计:query 与 proposal 工具不改变物理世界,所以智能体可以在提交之前反复检查和修订一个动作。VLM 决定「操作什么、怎么修订提案、何时执行」,harness 负责把这些决策变成几何精确、运动学可行的机器人运动。
Global + Contact views"] --> M["Main Agent
决策:query / proposal / execute"] M -->|需要空间精修| I["Imagination Agent
独立上下文中反复编辑提案
物理场景不变"] M -->|需要程序性知识| S["Skill Agent
比对参考图像与当前 Canvas
报告适用性与差异"] I -->|返回修订后提案| P["可编辑提案 + 视觉预览
+ 规划可行性反馈"] S -->|技能指导| P P -->|"仅有可行规划的提案"| E["执行:move / release / regrasp"] E -->|新观测 + 执行反馈| O E -.->|残留偏移| C["In-view correction
在看到误差的视图里拖拽"] C --> O
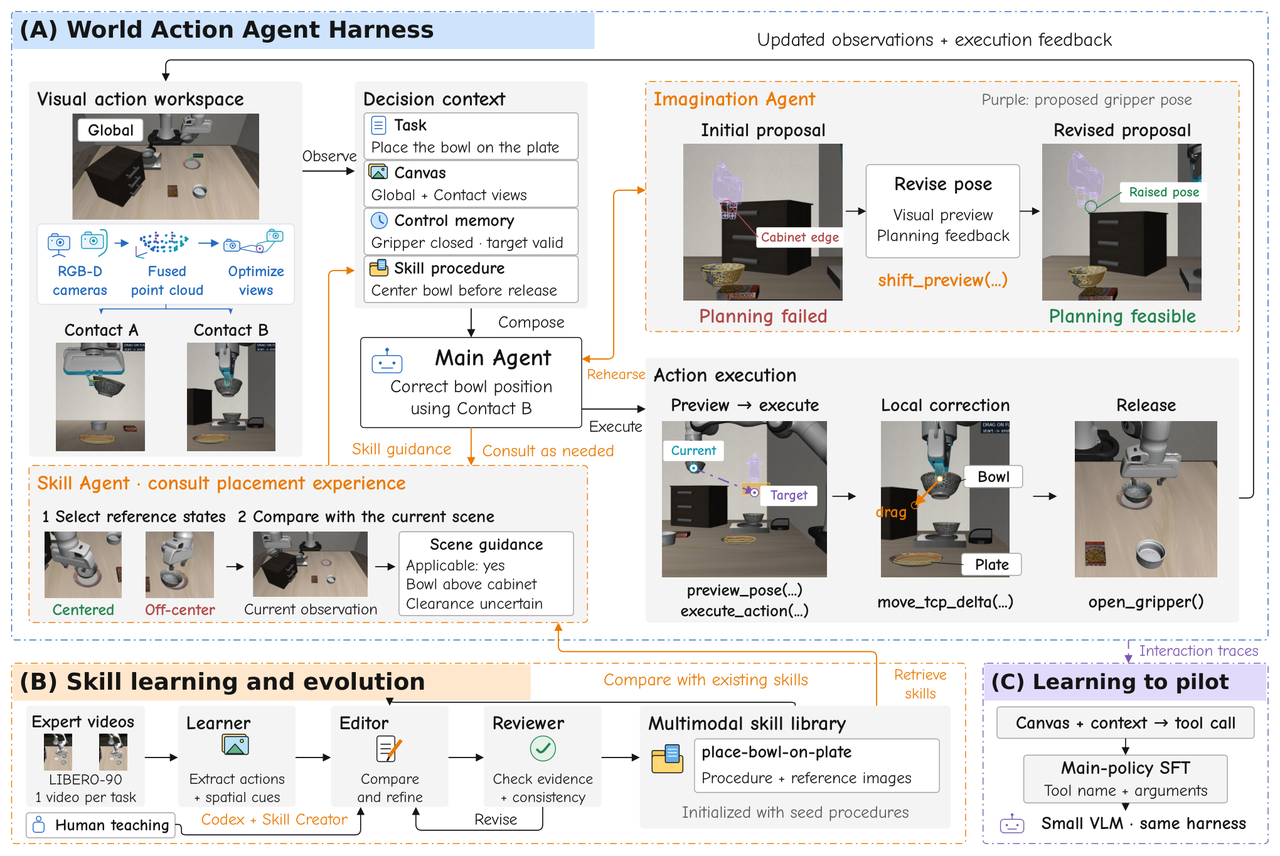
图 2:WAA harness 概览——(A) 主智能体的视觉动作工作区,(B) 技能学习与进化,(C) 用交互轨迹训练小 VLM 驾驶同一 harness。
2.2 设计一:以交互为中心的 Canvas 与 Contact views
操作成败往往取决于夹爪、物体、目标之间毫米到厘米级的关系,而固定全局相机常常因为距离、遮挡或退化视角看不到。WAA 因此根据当前交互主动选择视点。给定场景点云 $P_t$、机器人几何 $R_t$、高亮交互区域 $H_t$,harness 求解 Contact views 的相机参数:
$$c_t = \arg\max_{c \in \Omega} \left[ S_{\text{vis}}(c; H_t, R_t \mid P_t) + \lambda_1 S_{\text{frame}}(c; H_t) - \lambda_2 E_{\text{red}}(c) - \lambda_3 E_{\text{stab}}(c, c_{t-1}) \right]$$
四项含义:
- $S_{\text{vis}}$——在场景遮挡下,交互区域与夹爪的可见性;
- $S_{\text{frame}}$——鼓励紧凑取景;
- $E_{\text{red}}$——惩罚传递相同方向信息的冗余视图;
- $E_{\text{stab}}$——抑制视点跳变,使空间关系在步骤之间保持可比。
而可行集 $\Omega$ 有一个很讲究的约束:两个 Contact view 的水平投影必须正交。这一点直接对应第 1.2 节里的第三个缺口——正交意味着任何对齐误差都能沿两个独立方向被读出,不会出现「某个方向的偏移在所有视图里都恰好不可见」的情况。
这个目标函数只需要机器人基坐标系下的场景点云,因此 WAA 对点云来源完全无关:可以是仿真渲染、标定 RGB-D 相机融合、或用 VGGT 这类前馈模型从 RGB 重建。论文在实验中三种都试了。每个视图都保留自己的投影标定,图像空间的标注可以直接映射到 3D——这正是后面 in-view correction 能成立的前提。
2.3 设计二:动作试演(Action Rehearsal)
对 VLM 来说,难的往往不是「去哪」,而是判断某个具体位姿是否合适:接近方向会不会撞到旁边的物体、机器人够不够得着、这样抓是否能支撑下一步。WAA 因此把动作表示为可编辑提案,而不是一次性输出:
- 智能体在 Canvas 上定位目标并据此指定目标位姿;
- harness 解逆运动学,用 cuRobo 做运动规划;
- 把目标构型以半透明机器人叠加到每一个视图上;
- 向智能体报告该规划的可行性。
于是智能体可以在执行前审查接近方向、预期接触点与周围间隙,并据此修订位姿。对于更精细的调整,主智能体把空间意图委派给 Imagination Agent——它运行在独立上下文中,在物理场景完全不变的前提下反复编辑与重规划,只把修订后的提案返回。硬约束是:只有具备可执行规划的提案才能变成物理运动。
论文给的例子很直观:一个初始位姿运动规划不可行(Motion Plan Infeasible),Imagination Agent 通过 rotate(axis, deg) 逐步调整直到规划可行,主智能体再把它朝把手方向平移。
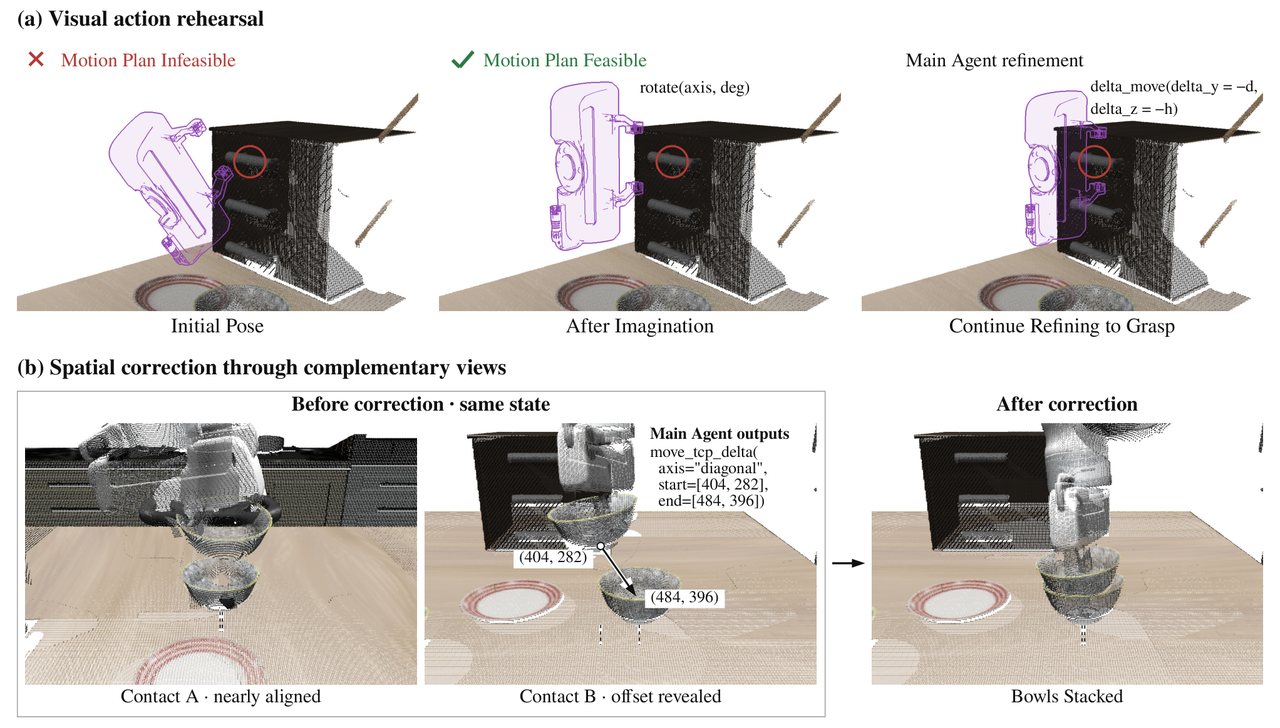
图 3:动作试演与视图内修正——(a) 运动规划不可行的位姿经调整后可行;(b) Contact A 看似对齐而 Contact B 揭示偏移。
2.4 设计三:闭环执行与 In-view Correction
目标级的规划运动适合「接近」和「搬运」这类大动作,但深度噪声、标定误差、接触扰动会留下残余误差,而这些残余误差往往决定放置成败。WAA 的做法是让智能体在观察到误差的那个视图里直接表达修正:智能体在一个 Contact view 中从参考点拖到期望位置,harness 利用该视图的标定把这个图像空间意图转换成有界的末端位移。
这里有个容易被忽略但很关键的设计:参考点可以是夹爪,也可以是所持物体上的一个可见点。也就是说智能体可以直接说「物体应该去哪」,而不必先把这个关系换算成绝对的夹爪位姿——这正是对 1.2 节第三个缺口的正面回应。两个正交 Contact view 支持沿互补方向修正。每次修正后,新的观测让智能体决定是继续调整、释放物体、还是进入下一个目标级动作。
论文图 3b 展示了这个过程的重要性:Contact A 看起来已经对齐了,但 Contact B 揭示了偏移;主智能体在 Contact B 里把碗拖向目标,harness 把拖拽转换成末端运动,最终成功堆叠。
3. 通过 Harness 学习:技能进化与驾驶员蒸馏
视觉动作工作区让 VLM 能观察并作用于空间关系,但没告诉它如何用这些能力完成任务——这需要 VLM 预训练很少覆盖的具身程序性知识:先建立哪个接触、释放前该验证哪个关系、抓取失败怎么恢复。WAA 沿两条互补路径获取这些知识。
3.1 多模态技能库
纯文本程序很难传达「对齐到什么程度算够」这类判断,而视觉参考可以为状态识别与验证提供证据。因此每个 WAA 技能包含四部分:适用条件、程序、带参考图像的关键状态、可观察的结果检查。程序描述的是夹爪/物体/目标应满足的关系、所需的接触与间隙、以及失败如何恢复,而不是固定坐标或位移。物体、目标位置与运动量始终在当前场景中求解,数值只作为需要根据观测反馈调整的暂定范围。
这一点是与 ASPIRE 那类技能库的本质区别:后者注册逐物体验证过的参数(抓取高度偏移、偏航角),而 WAA 的关系型指导可以跨物体实例、布局与视点迁移。执行时主智能体按名称与描述选技能,把解释工作委派给独立上下文中的 Skill Agent:它挑选相关的程序状态与参考图像,与当前 Canvas 比对,报告适用性、场景差异与尚无法确认的关系。
一个很细的工程考虑:主智能体收到完整的文本程序,而参考图像留在 Skill Agent 的上下文里。这样既避免历史图像被误认为当前场景,也保持主上下文紧凑。场景相关的建议在其关联的观测或控制状态变化时失效,防止智能体依据过期指导行动。
3.2 从示范与教学中进化:Learner / Editor / Reviewer
技能库从 Codex(GPT-5.5)依据 harness API 写出的纯文本种子技能起步,然后为每个 LIBERO-90 源任务各补充一条专家轨迹(其场景与评估场景不同)。学习由三个 GPT-5.5 驱动的角色完成:
| 角色 | 职责 | 关键约束 |
|---|---|---|
| Learner | 在观测到的状态变化处切分视频,把接触、物体运动、支撑变化解释为 harness 动作,抽取知识候选 | 不读已有技能文本,新证据不被既有结论带偏;候选必须引用来源帧 |
| Editor | 把候选与现有程序及参考图像比较,以来源帧为视觉证据进行新增、修订、退役或暂缓 | 每次编辑都必须带证据 |
| Reviewer | 独立核查修订后的技能是否与其来源证据一致,把具体问题退回 Editor | 只有被支持、且不破坏既有适用条件的改动才能入库 |
示范只展示成功行为,很少揭示如何从失误中恢复。为此 WAA 提供了 Canvas-GUI:人类看到与智能体完全相同的多视图 Canvas,用同样的工具操作机器人(在视图中指点、在 Contact view 中拖拽、预览并执行提案)。人类像操作 GUI 一样驾驶机器人,harness 以与智能体交互完全相同的格式记录这些显式动作。Learner 对比「智能体失败前的尝试」与「人类在同样状态下的纠正」,识别出造成结果差异的关系(接触位置、对齐方向、释放时机),蒸馏成恢复指导,再走同样的 Editor–Reviewer 流程。
3.3 学习驾驶:把轨迹蒸馏进小模型
大型专有 VLM 驾驶效果好但成本高、延迟大。WAA 因此把交互轨迹蒸馏进一个更小的 VLM,让它操作同一个 harness。训练样本来自成功回合(只保留没有冗余操作的干净执行),并额外纳入单独审核过的恢复片段(如空抓后重新抓取)。每个样本把「动作前的 Canvas、任务指令、控制上下文、可用技能指导」与「被执行的工具调用」配对,不包含教师的推理过程或任何特权仿真状态。训练目标是式(1)策略的最大似然:
$$\max_\theta \sum_{(g, C_t, m_t, u_t) \in \mathcal{D}} \log \pi_\theta(u_t \mid g, C_t, m_t)$$
重要边界:微调只更新主策略,视觉动作工作区与子智能体保持不变——模型学的是「使用这个接口」,而不是「取代这个接口」。
4. 实验
4.1 设置
基准:LIBERO-Pro(Object / Goal / Spatial 三个切分,各含初始位置交换 Pos. 与任务扰动 Task 两种,每切分 10 个任务;每个 WAA 设定每切分评估 60 回合、每任务 6 回合)与 robosuite(cube lifting / stacking / restacking)。骨干为 Gemini 3.7 Flash,三种设定:无技能(zero-shot)、纯文本种子技能、进化后技能库。技能库只从 LIBERO-90 学习,且在评估前冻结——没有任何 LIBERO-Pro 或 robosuite 的回合、失败日志或标签会更新技能、提示或模型参数。每回合限制 50 个主智能体轮次、50 次物理操作、1 小时,每次 Imagination Agent 调用最多 6 轮。
4.2 主结果:LIBERO-Pro
| 方法 | 类别 | Obj. Pos. | Obj. Task | Goal Pos. | Goal Task | Spa. Pos. | Spa. Task | 平均 |
|---|---|---|---|---|---|---|---|---|
| OpenVLA | 端到端 VLA | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 | 0.0 |
| $\pi_{0.5}$ | 端到端 VLA | 17.0 | 1.0 | 38.0 | 0.0 | 20.0 | 1.0 | 12.8 |
| CaP-Agent0 (CaP-X) | code-as-policy | 22.0 | 18.0 | 26.0 | 17.0 | 12.0 | 14.0 | 18.2 |
| CaP-Agent0 (Playful) | code-as-policy | 27.0 | 31.0 | 29.0 | 16.0 | 13.0 | 23.0 | 23.2 |
| RATs (Playful) | code-as-policy | 61.0 | 63.0 | 43.0 | 36.0 | 29.0 | 31.0 | 43.8 |
| ASPIRE | code-as-policy | 98.0 | 95.0 | 81.0 | 45.0 | 51.0 | 60.0 | 72.0 |
| Show-Harness | 视觉 harness | 13.3 | 16.7 | 0.0 | 10.0 | 0.0 | 0.0 | 6.7 |
| WAA(zero-shot) | 本文 | 53.3 | 46.7 | 30.0 | 23.3 | 13.3 | 6.7 | 28.9 |
| WAA + 种子技能 | 本文 | 83.3 | 70.0 | 26.7 | 40.0 | 16.7 | 23.3 | 43.3 |
| WAA(进化技能) | 本文 | 95.0 | 93.3 | 63.3 | 48.3 | 80.0 | 73.3 | 75.6 |
| WAA(进化技能 + RGB-D) | 本文 | 88.3 | 91.7 | 56.7 | 45.0 | 76.7 | 68.3 | 71.1 |
| WAA(进化技能 + VGGT) | 本文 | 90.0 | 88.3 | 53.3 | 45.0 | 65.0 | 71.7 | 68.9 |
四个读点:
- 75.6% 是当前 SOTA,超过 ASPIRE 的 72.0%,且它的技能只从 LIBERO-90 学来、评估前已冻结。
- 优势最大的是 Spatial 两个切分(80.0 / 73.3),那里成败取决于厘米级放置关系;ASPIRE 在两个 Object 切分和 Goal Pos. 上仍更强。
- 同骨干、同样无技能的公平对比下,Show-Harness 只有 6.7%(Spatial 全败),zero-shot WAA 是 28.9%。两者都让 VLM 选择和修订动作,差别在于「行动前能观察到什么、能试什么」。
- 端到端 VLA 在任务扰动下几乎完全崩溃($\pi_{0.5}$ 从 17.0 掉到 1.0),因为陌生的指令与物体组合超出其训练分布;WAA 保留了 VLM 的通用理解并把每个决策接地到当前 Canvas。
4.3 成本:便宜且快得多
| 方法 | API 成本 ($) ↓ | 模型调用次数 ↓ | 耗时 (s) ↓ | 输入 token (K) ↓ | 输出 token (K) ↓ |
|---|---|---|---|---|---|
| Show-Harness | 0.5021 | 119.80 | 874.12 | 347.10 | 62.90 |
| WAA | 0.1996 | 31.05 | 150.47 | 193.62 | 5.45 |
每回合 31 次模型调用 / 150 秒,对 Show-Harness 的 120 次 / 874 秒;输出 token 只有对方的 1/12。作者把这归功于:把空间意图表达为视图中的拖拽而不是长段坐标推理,以及 Imagination Agent 在独立上下文里消化掉大量试错。
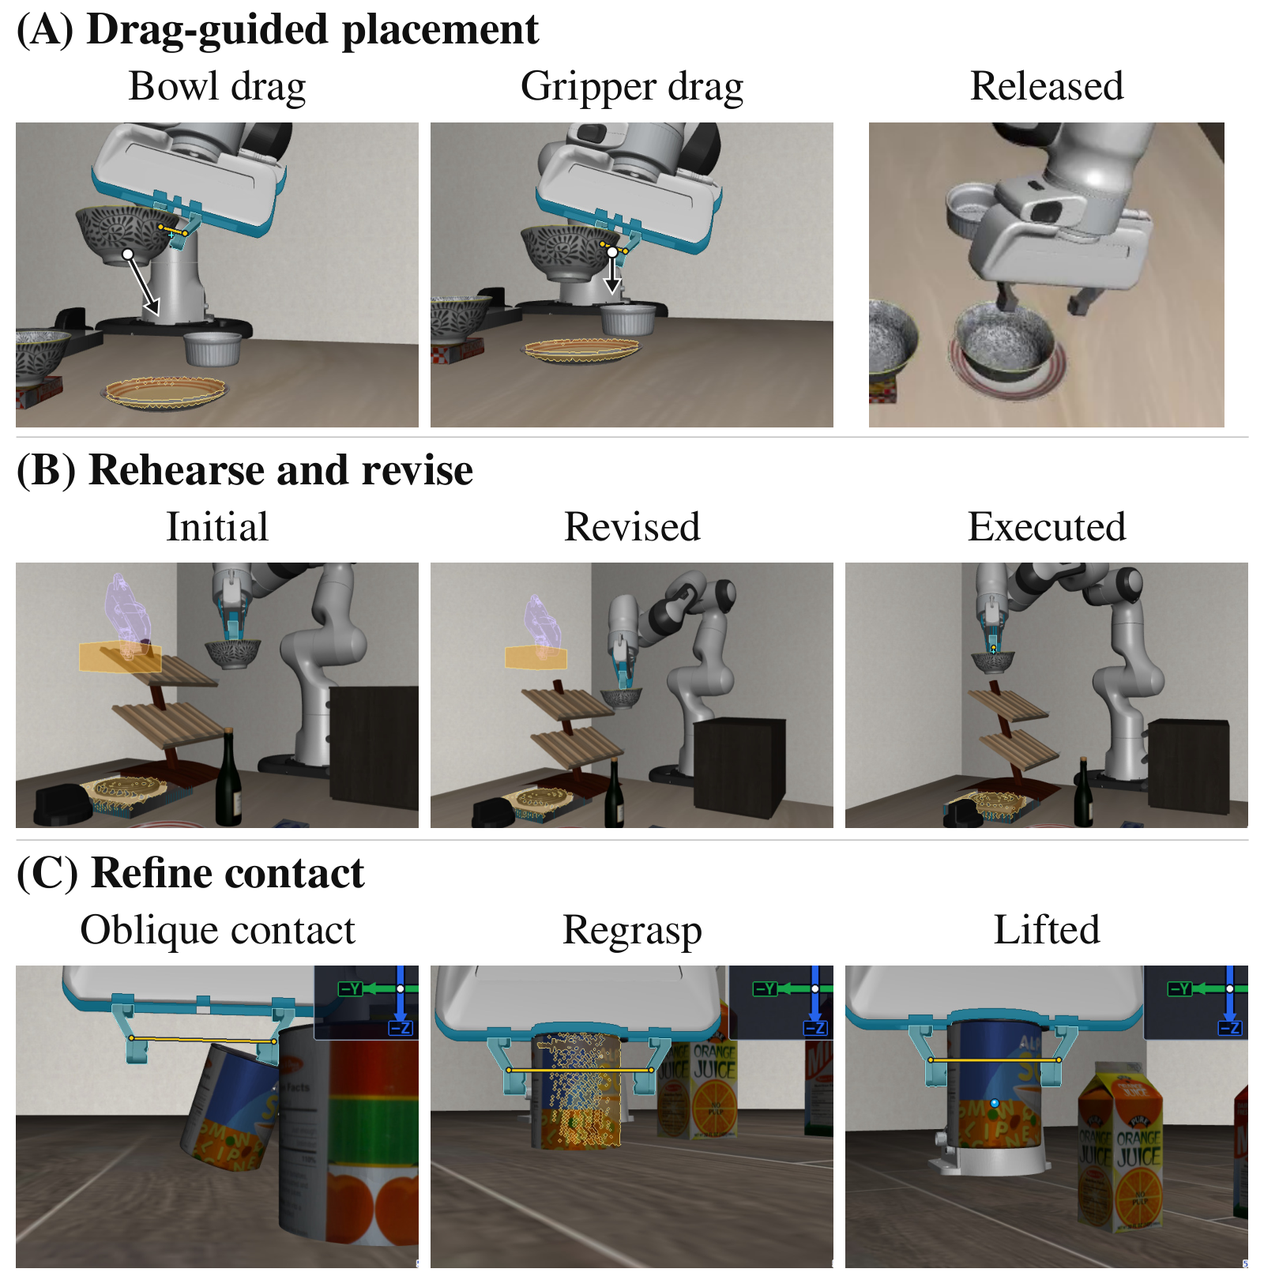
图 4:WAA 定性示例——(A) 拖拽引导放置,(B) 试演并修订,(C) 修订接触后成功提起汤罐。
4.4 技能学习、迁移与通用性
- 进化的多模态技能贡献了最大增益:平均成功率 28.9%(无技能)→ 43.3%(种子技能)→ 75.6%(进化技能);Spatial 从 13.3 / 6.7 提升到 80.0 / 73.3。纯文本种子技能效果不稳定,甚至略微拉低了 Goal Pos.,而进化技能在全部六个切分上都有提升。
- 一条示范就够学会一个新技能。从没有任何炉灶相关程序的纯文本种子库起步,仅用一条 LIBERO-90 的炉灶示范,学到的技能让 WAA 在 LIBERO-Pro 炉灶任务上十次执行全部成功。值得注意的是:Reviewer 否决了第一版草稿,因为它「把旋钮转动当作成功」;被接受的技能改为要求明确的激活信号——这说明独立审核确实拦住了过于宽泛的结果检查。
- 在 LIBERO 学到的技能可迁移到 robosuite。后者的场景、物体、相机布置都不同:WAA 无技能时已在全部抓取与堆叠试验中成功、restacking 达 60.0%;冻结的 LIBERO 技能把 restacking 抬到 100.0%(平均 100.0%),而 CaP-Agent0 配 RATs 技能平均只有 63.3%。
- 对点云来源不敏感。把仿真点云换成融合 RGB-D 或 VGGT 重建,平均只降到 71.1% 与 68.9%(掉 4.5 和 6.7 分),且两种设定在两个 Spatial 切分上仍超过所有基线。因为 Contact view 选择只需要基坐标系下的点云,更换感知源无需改动智能体或技能。
- 更小的 VLM 能学会驾驶同一个 harness。用 112 条 harness 轨迹(1,774 个决策步)以 LoRA(rank 8、10 epoch、学习率 $5\times10^{-5}$)微调 Qwen3.5-9B,仅替换主智能体,子智能体与接地仍用 Gemini 3.7 Flash:域内 0.0% → 55.0%,域外 1.7% → 43.3%。
5. 我的读法
这篇论文真正的贡献不在指标,而在它把「接口设计」当成研究对象。WAA 没有改模型、没有训策略,它只是重新设计了 VLM 与机器人之间的那一层——但正是这一层决定了 VLM 的空间理解能不能兑现成可执行动作。75.6% 这个数字最有说服力的地方不是它比 ASPIRE 高,而是同一骨干、同样无技能时,Show-Harness 只有 6.7% 而 WAA 有 28.9%:差的就是那三个设计。
三个设计里,我认为最值得记住的是 in-view correction,尤其是「参考点可以是所持物体上的可见点」这一条。它把智能体从「必须先把看到的关系换算成绝对位姿」这个负担里解放出来——在哪个视图看到误差,就在哪个视图里修掉,感知与动作因此落在同一个空间。配合「两个 Contact view 水平投影必须正交」这个约束,等于在接口层面保证了误差不会被视角盲区藏起来。这是一种很干净的几何思维。
另外几个点也值得单独拎出来:
- Learner 不读已有技能文本——这个反直觉的约束防止了新证据被既有结论带偏,配合 Reviewer 的独立核查,是对「技能库越学越退化的常见毛病」的一个具体工程解。
- 参考图像留在 Skill Agent 上下文、不进主上下文,避免历史图像被误认为当前场景——这是多模态智能体系统里一个很实际的坑。
- Canvas-GUI 让人类用完全相同的工具操作机器人,于是人类纠正与智能体轨迹同格式,天然可当监督信号。这个设计让「从人类教学中学习」不需要额外的数据管线。
- 只微调主策略、不动接口,模型学的是「用界面」而不是「取代界面」——这保证了接口改进能持续惠及所有驾驶员。
局限也是明说的:性能上界受骨干限制,Gemini 3.7 Flash 在部分任务上多视图信息融合仍不完善,导致 WAA 表现不稳定——但作者指出这是骨干的感知问题而非接口问题,更强的多视图 VLM 会直接带来收益。成本方面:WAA 比 code-as-policy 更频繁地闭环(每个决策都接地到新观测),虽然 Flash 级骨干比前沿专有模型便宜,一个回合仍需数十次模型调用,因此训练更小 VLM 来驾驶 harness 是降本降延迟的主要方向。
最后提醒一句:论文标注为 working in progress,且 LIBERO-Pro 上的对比中部分基线数字引自原论文(只有 Show-Harness 是作者用同样 30 回合/切分的设定重跑的),跨论文比较时应留意这一差异。
6. 资源
- 论文:arXiv:2609.29964
- 机构:HKUST(GZ)、CUHK、Knowin AI
- 状态:Working in progress