World Action Agent:让 VLM 在视觉动作工作区里驾驶机器人
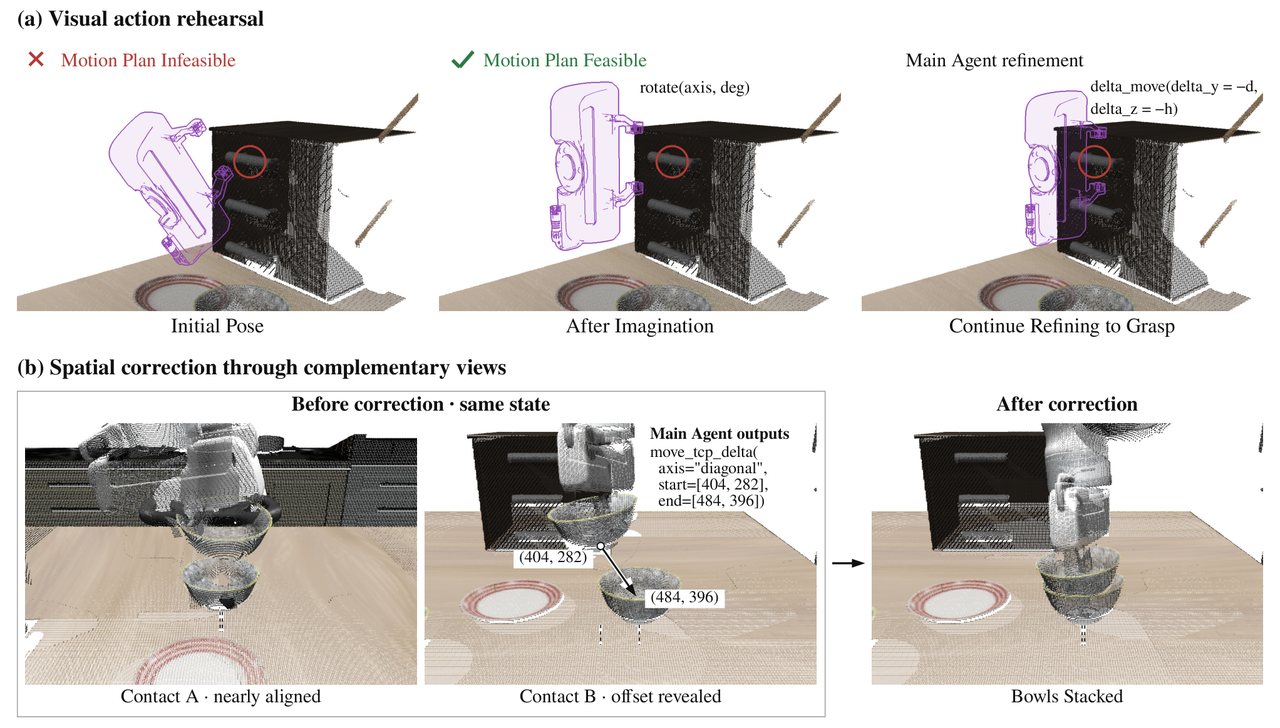
香港科技大学(广州)、香港中文大学与 Knowin AI 提出 World Action Agent(WAA),一个多智能体 harness——它不改 VLM,而是改 VLM 看到什么、以及它的决策如何生效,让通用 VLM 只用点选、拖拽、预览、执行等基础工具就能驾驶机器人,所有决策都在同一个「视觉动作工作区」内完成。工作区有三个性质:其一是 Contact views,根据交互区域、遮挡、取景紧凑度、视点冗余与稳定性主动求解相机参数,且约束两个视图的水平投影正交,使任何对齐误差都能沿两个独立方向被读出,且只需基坐标系点云,因此对 RGB-D 融合、仿真渲染或 VGGT 重建等感知来源完全无关;其二是动作试演,把每个动作表示为可编辑提案,由 cuRobo 规划后以半透明机器人叠加到各视图并报告可行性,Imagination Agent 在物理场景不变的独立上下文中反复修订,只有具备可执行规划的提案才能变成物理运动;其三是视图内修正,智能体在观察到误差的 Contact view 中从参考点拖到期望位置,参考点可以是所持物体上的可见点,因此无需先把关系换算成绝对位姿。技能侧由 Learner、Editor、Reviewer 三个角色在证据与独立审核约束下从专家视频与人类 Canvas-GUI 教学中进化出关系型多模态技能库。LIBERO-Pro 上以 Gemini 3.7 Flash 为骨干、仅用 LIBERO-90 进化并冻结的技能取得 75.6% 平均成功率的 SOTA,超过 ASPIRE(72.0%)、端到端 VLA 与同骨干的 Show-Harness(6.7%),Spatial 两个切分达 80.0 / 73.3;每回合仅 31 次模型调用、150 秒、0.1996 美元,远低于 Show-Harness 的 120 次、874 秒、0.5021 美元。同一套冻结技能迁移到 robosuite 达 100.0%;用 112 条轨迹(1,774 决策步)LoRA 微调 Qwen3.5-9B 只替换主智能体,域外成功率从 1.7% 提升至 43.3%。