PAPER DEEP DIVE
机器人上下文学习:方法与应用
通用机器人必须推断新任务的要求,并把这种理解转化为恰当的物理动作。机器人上下文学习(ICL)用示范与交互来引导已有能力,并在部署期间冻结神经参数。这份综述围绕「把上下文证据连接到执行」的接口来组织文献,区分出四大家族:上下文条件策略、几何示范迁移、基于世界模型的控制、技能与智能体执行。比较这些接口可以厘清各自的迁移假设,以及训练、对应关系与记忆在让上下文变得可用时扮演的角色。在操作与导航两类场景中,我们考察当物体、环境与执行条件发生变化时,这些机制如何保留教学所设定的要求。这一分析把方法设计与评测实践连接起来,区分「对教学敏感」「物理可迁移」与「从保留经验中获益」三种不同的主张。由此形成的研究议程把组合式任务获取与忠实迁移,同物理递归自我改进联系起来——在后者中,经验提升的是学会后续任务的能力。全文逐条编码 412 条参考文献(其中 260 条为方法类),并记录 14 组已报告对照。
论文:In-Context Learning for Robots: Methods and Applications(arXiv:2609.36012,arxiv.org/abs/2609.36012,2026-09-28 提交,cs.RO)
作者:Haojian Huang、Zexi Li、Junhao Guo、Yehang Zhang、Wenxuan Peng、Bohan Zhou、Weilin Ruan、Leyi Wu、Chenxu Wang、Jianchong Su 等 39 位作者(Knowin AI、香港科技大学广州、香港中文大学、同济大学、清华大学、哈尔滨工业大学深圳、西湖大学、天津大学;Ying-Cong Chen 与 Yinchuan Li 为通讯作者)
代码与资源:提供项目页与 GitHub 仓库 awesome-robots-icl,随附逐条语料普查与「已报告对照」补充材料 Supplement S1;本文为文献综述,不含可训练模型代码。
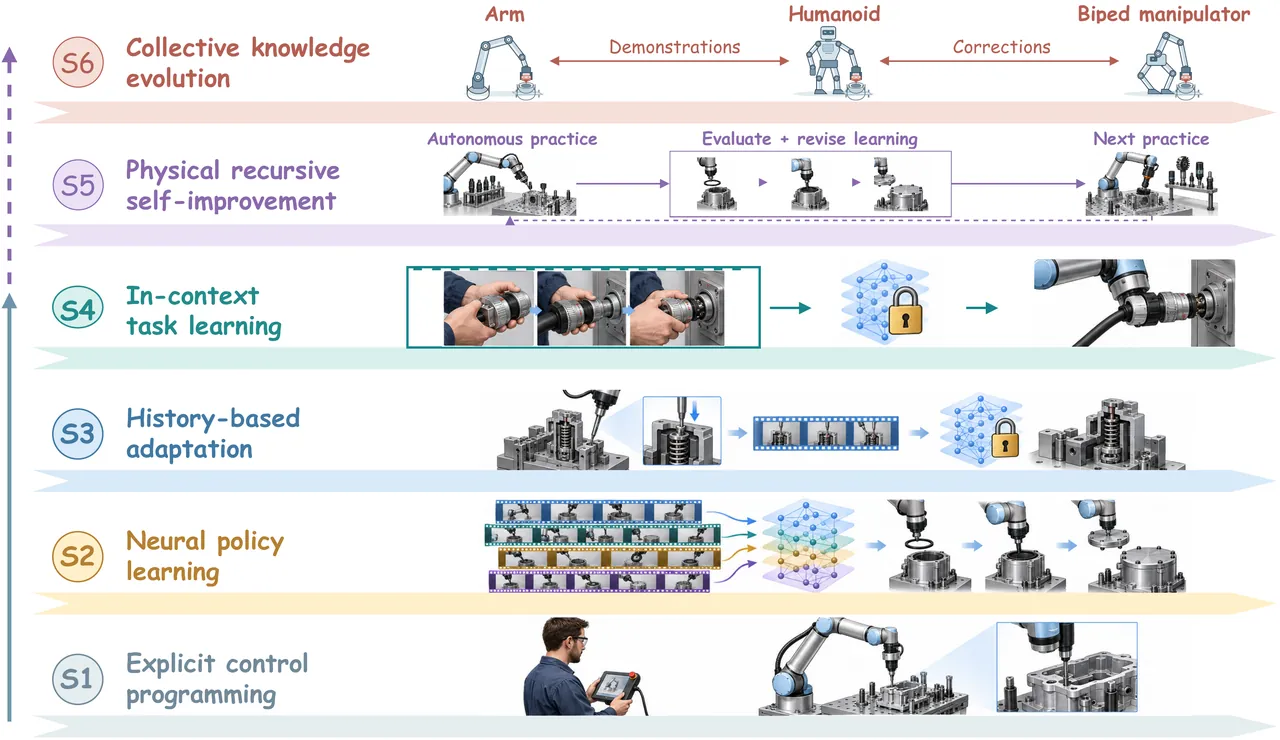
图 1:六个学习时程。S1 显式编程控制;S2 学习可复用策略;部署期神经参数冻结时,S3 依据交互结果自适应,S4 依据教学推断任务要求;S5 改进「后续任务如何被学会」,S6 把这一过程扩展到跨形态、经校验的知识交换。
一句话总结
这篇约 100 页、412 条参考文献的综述把「机器人上下文学习(ICL)」界定为:在部署期冻结神经参数的前提下,用示范与交互把既有能力导向当前任务;它按「上下文如何变成动作」划分出四个方法家族,并给出一套能把「对教学敏感」「物理可迁移」「保留经验有收益」三者区分开的评测控制,最终把议程指向组合式任务获取与物理递归自我改进。
研究背景与动机
机器人可能「会动」却仍「不知道该做什么」。一个码垛机械臂也许已经能抓起所有零件,却仍需要一段示范来确定装配顺序、需要历史来确认哪些放置已完成、需要接触证据来适应更紧的配合。同一个可见场景因此可能要求不同动作。作者把这类缺口称为「决策相关的歧义」,并指出它无法靠更大的运动能力单独消解:预训练供给可复用的感知与控制,但当前场景可能让多个程序都可行、可能掩盖先前事件、也可能对陌生材料的响应几乎不提供信息。
微调与上下文学习是处理新证据的两条路。微调用任务数据把预训练参数更新为任务参数;ICL 则把证据放进推理时的输入,让神经参数在部署期保持不变。两者的差别不只是工程上的:任务信息存到哪里,决定了获取成本、持久性与重置行为。一个被保留的纠正能否在下一次尝试继续起作用,取决于它存为上下文、外部工件还是权重。
两条历史脉络支撑起一个宽泛的「上下文」概念。其一是一次性模仿:从示范推断意图行为;其二是元强化学习:从结果推断任务或动力学。序列模型保留轨迹与学习历史,多模态提示把任务规格与感觉运动样例结合。随着先验变宽,教学可以指挥通才动作、预测未来或可执行程序;物理实验则为修正执行提供证据。语言以指令、样例、纠正与保留摘要的形式全程参与。
已有综述各有侧重:按教学接口与所学策略组织示范学习、按样例与交互审视 ICL 与 in-context RL、比较人类视频向控制迁移的信息、按内容/推断目标/适应机制/迁移组织操作 ICL、区分单体与分层的 VLA 集成。本文的组织问题不同:新证据如何消解既有能力所未决定的东西,以及这一消解如何在物理执行中存活。四个家族把这一负担放在不同的中间量上;对应、训练与记忆决定这些中间量能否保留所需信息。
由此得到三项贡献:一是四大家族加共享对应与记忆机制的分类法;二是对「训练关系如何建立上下文使用、对象替换/陌生环境/执行条件如何限制迁移」的论述,把「更宽的运动能力」与「更强的通过教学学习的能力」分开;三是对已报告对照与评测控制的综合,把上下文依赖、迁移与保留经验收益三者分离,并引出组合式学习与可教性改进。
预备知识:六个学习时程与统一接口
作者用六个学习时程组织「先验能力—上下文自适应—从保留经验中学习」的关系。S1 显式控制编程编码任务逻辑、控制律与规划模型;S2 神经策略学习通过模仿与强化获得可复用行为;S3 基于历史的自适应用交互记忆推断任务或动力学信息;S4 上下文任务学习从教学(指令、示范、文本样例、纠正)推断新任务要求。S3 与 S4 是 ICL 的两种互补证据来源,都在部署期冻结神经参数。S5 物理递归自我改进指经验改进「下一个任务如何被学会」;S6 集体知识演化把这一学习循环扩展到一组机器人之间。
形式化上,决策步 $t$ 的当前尝试有历史 $h_t=(o_1,a_1,\ldots,a_{t-1},o_t)$,观测 $o_t$ 含图像、本体感觉、力、触觉或惯性测量与反馈消息。任务相关上下文 $C_t$ 可含指令、目标参照、多模态支持示范 $D^{\mathrm s}$、文本输入输出样例、纠正、检索到的片段或交互记忆。策略提出长度为 $H$ 的动作块 $A_t$。部署参数为 $\theta$ 时:
$$A_t \sim \pi_\theta(\,\cdot \mid h_t, C_t). \tag{1}$$
只有真正执行的动作进入后续历史;新观测可以替换动作块中未执行的部分。当 $C_t$ 本身携带未来决策所需状态时,一次记忆更新会并入动作与其观测后果:
$$C_{t+1}=U_\theta(C_t,o_t,a_t,o_{t+1}). \tag{2}$$
ICL 的核心约束是部署期参数不动:
$$\theta_{t+1}=\theta_t=\theta_0,\qquad h_{t+1}=(h_t,a_t,o_{t+1}). \tag{3}$$
式 (3) 是全文的分水岭:任何在部署期改动 $\theta$ 的方法(在线微调、元学习的快权重更新)都不属于严格意义的 ICL,而只是提供对照。图 2 把这一点画成对照:微调用任务数据更新 $\theta$,ICL 则把支持示范 $D^{\mathrm s}$ 作为 $C_t$ 而 $\theta$ 不变,两者都用观测—动作历史预测下一个动作块。
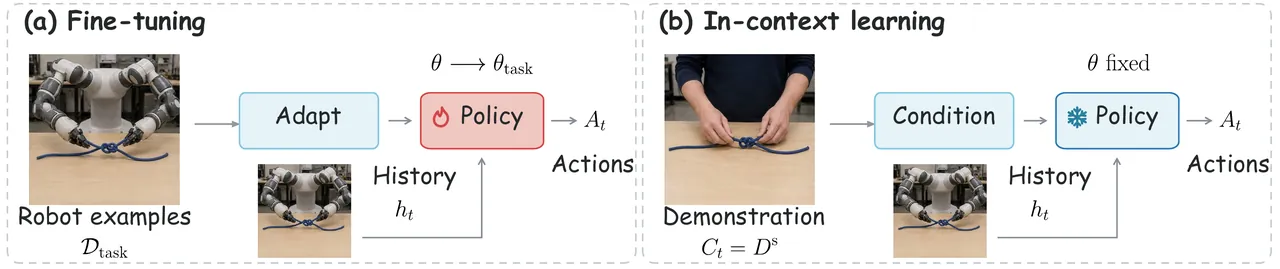
图 2:微调与上下文学习。(a) 任务数据把 $\theta$ 更新为 $\theta_{\mathrm{task}}$;(b) 一段示范供给 $C_t=D^{\mathrm s}$ 而 $\theta$ 固定。两条路线都用观测—动作历史 $h_t$ 预测下一个动作块 $A_t$。
自适应可以落在三种位置:上下文状态、保留的外部工件、或神经参数。图 3 把这五种位置与时间尺度并排:(a–c) 供给的上下文、循环状态、检索到的片段在参数冻结下条件化策略;(d) 快权重改变而基座冻结;(e) 更新后的权重为后续任务保留。蓝色边框与雪花标记冻结参数,红色边框标记被更新的参数。
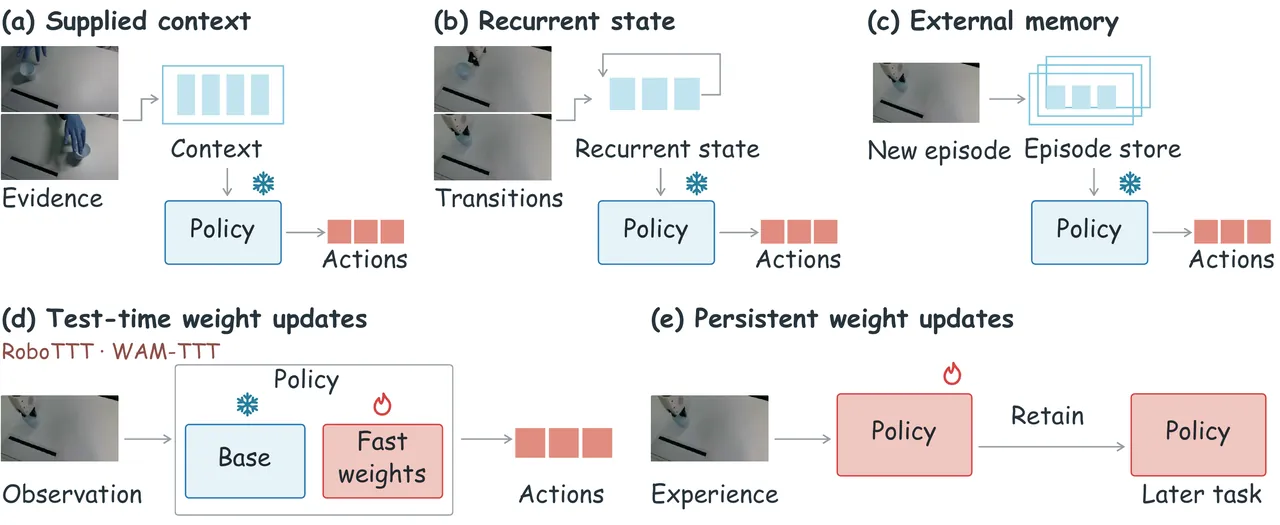
图 3:自适应的五个位置与时间尺度。(a–c) 上下文、循环状态、检索片段在冻结参数下条件化策略;(d) 快权重更新而基座不变;(e) 更新后的权重保留到后续任务。
| 时程 | 改变系统的什么 | 证据来源 | 代表机制 |
|---|---|---|---|
| S1 显式控制编程 | 任务逻辑 / 控制律 / 规划模型 | 人工编码 | STRIPS、行为树、操作空间控制 |
| S2 神经策略学习 | 策略权重 | 离线训练数据 | 视觉运动策略、模仿 / 强化学习 |
| S3 基于历史的自适应 | 上下文 / 循环状态 | 交互结果 | 元 RL、提示式决策 Transformer |
| S4 上下文任务学习 | 上下文 / 检索工件 | 教学(指令、示范、样例、纠正) | VIMA、Vid2Robot、UniSkill |
| S5 物理递归自我改进 | 后续学习的获取过程 | 跨会话经验 | LMPC 后继训练、程序修订、自主练习 |
| S6 集体知识演化 | 跨形态共享知识 | 机器人间经校验的交换 | 共享进度表示、跨形态迁移、池化策略 |
| S3/S4 共同点 | 部署期 $\theta$ 冻结 | — | 式 (3) 的约束 |
方法详解:从上下文到动作的四个接口
综述的组织轴不是「用什么模态」,而是「上下文经过哪个中间量变成动作」。图 4 给出四个技术范式:(a) 直接动作推断、(b) 几何运动参照迁移、(c) 预测条件化控制、(d) 技能或工具执行;代表实现分别是 Vid2Robot、SemAnCorr、Zero-WAM 与 UniSkill。四个家族在 260 条方法类参考文献中的占比为 123 / 24 / 22 / 91。
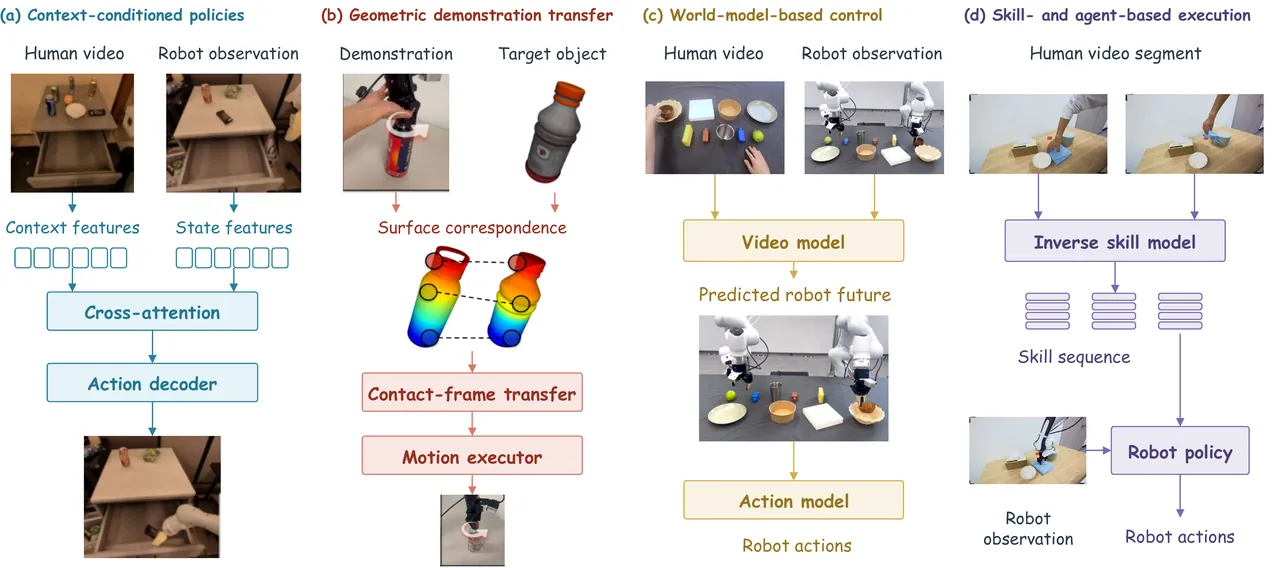
图 4:四个技术范式如何把上下文变成动作。(a) 上下文条件策略:交叉注意力加动作解码器;(b) 几何示范迁移:表面对应、接触帧迁移、运动执行器;(c) 世界模型控制:视频模型预测机器人未来再交给动作模型;(d) 技能与智能体执行:逆技能模型产出技能序列再交给机器人策略。
家族一:上下文条件策略(123 条)
这一家族把上下文直接编码进策略的条件。通用形式是先由编码器把历史与上下文压成一个任务表示,再由动作头解码:
$$r_t=E_\theta^{\mathrm c}(h_t,C_t),\qquad \pi_\theta(A_t\mid h_t,C_t)=q_\theta^{\mathrm a}(A_t\mid h_t,r_t). \tag{4}$$
检索式变体把动作分布写成对候选动作块的混合:
$$\pi_\theta(\,\cdot\mid h_t,C_t)=\sum_{j\in J_t}\beta_{tj}\,\delta_{\bar A_j},\qquad \beta_{tj}\geq 0,\ \sum_{j\in J_t}\beta_{tj}=1. \tag{5}$$
其中 $\bar A_j$ 是检索到的候选动作块,$\beta_{tj}$ 是混合权重。注意力式变体对支持示范加权:
$$\alpha_{ti}=\frac{\exp s_\theta(h_t,d_i^{\mathrm s})}{\sum_{k=1}^{L}\exp s_\theta(h_t,d_k^{\mathrm s})},\qquad r_t=\sum_{i=1}^{L}\alpha_{ti}\,e_\theta(d_i^{\mathrm s}). \tag{6}$$
式 (6) 揭示这一家族的关键假设:相似度 $s_\theta$ 必须把「任务语义相近」而非「场景外观相近」的示范排到前面。LIBERO-CF 的发现正打在这里——当场景本身就能暴露任务身份时,被测 VLA 往往继续做与场景关联的任务,而不是教学指定的任务。因此对示范 ICL,替换一段视频必须改变意图的顺序或关系,而不只是扰动外观。
家族二:几何示范迁移(24 条)
这一家族不学语义表示,而是把示范当作可重定向的几何参照。先从示范提取运动参照,再按当前观测与身体重定向,最后由控制器执行:
$$\zeta_{1:L}=E_\theta^{\mathrm m}(D^{\mathrm s}),\qquad g=\operatorname{Retarget}(\zeta_{1:L},o_t,\mathcal B),\qquad A_t=\kappa(g,o_t). \tag{7}$$
刚性相对变换是其中的经典构件:把示范坐标系下的末端轨迹换算到目标物体坐标系:
$${}^{W}T_{E,b}^{\mathrm q}(\sigma)={}^{W}T_{O_b}^{\mathrm q}\bigl({}^{W}T_{O_b}^{\mathrm s}\bigr)^{-1}\,{}^{W}T_{E,b}^{\mathrm s}(\sigma). \tag{8}$$
视觉伺服则把几何误差闭环成速度命令:
$$\boldsymbol e_t=\boldsymbol s_t-\boldsymbol s_t^\star,\qquad \dot{\boldsymbol q}_t=-k_{\mathrm{vs}}\,J_{\mathrm{vis},t}^{\dagger}\,\boldsymbol e_t. \tag{9}$$
这一家族的迁移假设最明确也最脆弱:它要求交互几何可用。一个无把手的容器也许能满足「倒水」的目标,却无法保留「必须抓把手」这一被显式要求的关系。因此几何迁移擅长暴露接触与运动约束,却难以表达顺序与前置条件。
家族三:世界模型控制(22 条)
这一家族先预测后果、再据以行动。预测与动作解耦为两个分布:
$$v^+\sim p_\theta^{\mathrm v}(\,\cdot\mid C_t,h_t),\qquad A_t\sim q_\theta^{\mathrm v}(\,\cdot\mid v^+,C_t,h_t). \tag{10}$$
对预测边际化即得端到端策略:
$$\pi_\theta(A_t\mid h_t,C_t)=\int q_\theta^{\mathrm v}(A_t\mid v^+,C_t,h_t)\,p_\theta^{\mathrm v}(v^+\mid C_t,h_t)\,\mathrm dv^+. \tag{11}$$
模型预测控制变体则在候选动作上最大化期望回报:
$$A_t^\star\in\arg\max_{\widehat A_t\in\mathcal A_t}\ \mathbb E_{v^+\sim p_\theta^{\mathrm d}(\cdot\mid h_t,\widehat A_t,C_t)}\bigl[\mathcal R(v^+,C_t)\bigr]. \tag{12}$$
训练期常用动作损失加预测损失的联合目标:
$$\theta^\star\in\arg\min_\theta\bigl[\mathcal L_a(\theta)+\lambda\,\mathcal L_v(\theta)\bigr]. \tag{13}$$
这一家族的收益取决于预测是否「可实现」:预测的未来必须落在执行器能到达的范围内。Zero-WAM 的做法是先训视频与动作两个分支、再冻结两者、用生成视频替换录制的未来视频,从而把「预测」与「执行」的接口固定下来。
家族四:技能与智能体执行(91 条)
这一家族把上下文翻译成可执行的规格,再交给既有执行器:
$$g=f_\theta(C_t,h_t),\qquad A_t=\kappa(g,o_t). \tag{14}$$
规格 $g$ 可以是技能序列,也可以是合成程序:技能组合取 $g=(z_1,\ldots,z_{N_g})$ 并由 $\kappa(z_{\ell_t},o_t)$ 逐步执行;程序合成取 $g=f_\theta(C_t,h_t)$ 并由 $\operatorname{Run}(g,h_t)$ 运行。GPT-Policy 是这一支的具体接口:一个通用 VLM 接收教学、通过固定的机器人工具请求笛卡尔目标或夹爪命令、并读取返回的执行反馈。它的插塞重插实验把对应的价值量化得很直白:仅视频的三次试验成功 0 次,加入对齐的末端位姿、夹爪状态与命令后三次成功 2 次。
横切机制:对应、记忆与外部知识修订
对应(correspondence)与记忆(memory)是跨家族的共享机制。记忆把短期状态、长期库、检索结果与任务上下文组装起来:
$$m_{t+1}=u_\theta(m_t,x_t),\quad M_{t+1}=w_\theta(M_t,x_t),\quad R_t=\rho_\theta(h_t,M_t),\quad C_t=b_\theta(C_t^{\mathrm{task}},m_t,R_t). \tag{15}$$
预算化检索决定哪些片段进入上下文:
$$J_t\in\arg\max_{J\subseteq\{1,\ldots,N_t\},\,|J|\leq K}\ \sum_{j\in J}\bigl[s_\theta(h_t,\xi_j)-\eta\bigr],\qquad R_t=(\xi_j)_{j\in J_t}. \tag{16}$$
其中 $\eta$ 是每条目的代价、$K$ 是预算。外部知识修订则把「候选工件 + 校验」写成一次带接受判据的更新:
$$\widetilde B_{n+1}\sim F_\theta(\cdot\mid B_n,\mathcal T_n),\quad B_{n+1}=\begin{cases}\widetilde B_{n+1},&\chi_n=1\\ B_n,&\chi_n=0\end{cases},\quad \theta=\theta_0. \tag{17}$$
式 (17) 的关键是 $\chi_n$:一个未经验证就提交的修订可能比不修订更糟。FARE 的「每步都搜」消融(91.0%,低于完整系统的 93.2%,也低于基座的 91.5%)正是这一点的实证——在每一步都触发恢复搜索,反而不如只在该触发时触发。
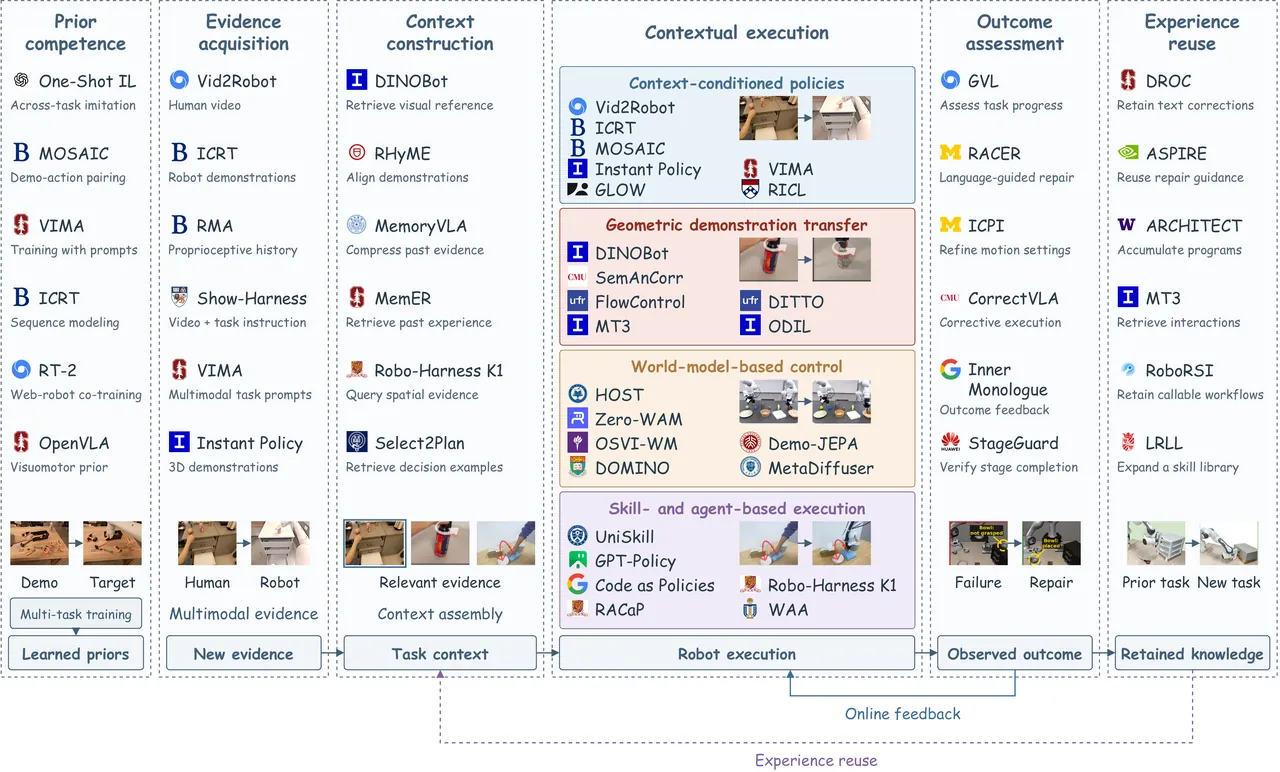
图 5:机器人 ICL 的完整工作流。先验训练供给能力;部署期获取证据、构建上下文、经四个方法家族生成动作;结果评估向执行提供在线反馈,保留的经验又回馈后续上下文构建。
flowchart TD
  EV[Deployment evidence
instruction / demo D^s / correction / interaction history] --> CC[Context construction C_t
retrieval + memory update U_theta]
  CC --> F1[Family 1 context-conditioned policy
r_t then action head q^a]
  CC --> F2[Family 2 geometric transfer
zeta then Retarget then kappa]
  CC --> F3[Family 3 world-model control
predict v+ then act or MPC argmax]
  CC --> F4[Family 4 skill / agent execution
g then kappa or Run]
  F1 --> AT[Action block A_t
theta fixed at deployment]
  F2 --> AT
  F3 --> AT
  F4 --> AT
  AT --> OA[Outcome assessment
success / contact / progress]
  OA -->|online feedback| CC
  OA --> MEM[Retained experience
m and M and artifacts B_n]
  MEM -->|later context construction| CC
图 6:四个上下文到动作的接口与反馈回路(依据图 5 与图 4 绘制)。部署期 $\theta$ 冻结;结果评估既在线修正执行,也把可复用经验写回上下文构建。
数据:上下文从哪里来
上下文不是凭空出现的。配对训练目标把支持示范与查询轨迹绑定到同一任务规格:
$$\mathcal L(\theta)=\mathbb E_{(D^{\mathrm s},\tau^{\mathrm q})\sim P_{\mathrm{pair}}}\Bigl[\frac{1}{|I^{\mathrm q}|}\sum_{t\in I^{\mathrm q}}\ell_\theta\bigl(A_t^{\mathrm q};h_t^{\mathrm q},D^{\mathrm s}\bigr)\Bigr]. \tag{18}$$
式 (18) 的实践含义是:要数「可区分的教学问题」而不只是轨迹条数。如果当前场景已经决定了所有训练动作,损失无需读示范即可最小化;只有「相似场景、不同有效程序」才让教学具有预测价值。BPP 的受控分配实验把多样性与数量的权衡量化了:固定 10,000 条绘制示范,500 个任务各 20 条示范的平均 Chamfer 误差为 9.5 像素,1,000 个任务各 10 条为 5.1,2,000 个任务各 5 条为 3.4——任务越多样、单任务示范越少,反而学得越好。
规模数据同样说明问题。AgiBot World 2025 年 3 月版含 1,001,552 条轨迹、2,976.4 小时、217 个任务、106 个场景,并带子任务与恢复记录。EgoScale 用 20,854 小时带动作标签的人类数据,经对齐的中期训练与下游后训练连接到机器人行为。XR-2 把 531.7 小时遥操作与约 1,000 小时双 UMI 示范混合,并通过分离策略动作与人类接管,在三轮重训中把叠衣从 58% 提到 93%。S1 的缩放实验则给出一个警示:在 1k–100k 训练小时区间,示范提示在未见任务上从 1% 升到 66%,而语言提示只从 0% 升到 9%——相似的已见任务表现可以掩盖对新任务教学的不同回报。
| 资源 / 实验 | 规模或对照 | 关键读数 |
|---|---|---|
| AgiBot World(2025-03) | 轨迹 / 小时 / 任务 / 场景 | 1,001,552 / 2,976.4 / 217 / 106 |
| EgoScale | 带动作标签人类数据 | 20,854 小时 |
| EgoDex | 手—物体跟踪 | 829 小时 |
| RoboCasa365 | 任务 / 厨房场景 / 人操示范 / MimicGen | 365 / 2,500 / 612 h / 1,615 h |
| XR-2 | 遥操作 + 双 UMI;三轮重训叠衣 | 531.7 h + ~1,000 h;58% → 93% |
| BPP 多样性分配 | 500 / 1,000 / 2,000 任务(共 10,000 示范) | Chamfer 9.5 / 5.1 / 3.4 像素 |
| S1 缩放(未见任务) | 示范提示 vs 语言提示(1k–100k h) | 1% → 66% vs 0% → 9% |
| GPT-Policy 插塞重插 | 仅视频 vs 视频 + 对齐状态动作 | 0/3 vs 2/3 |
应用:上下文必须消解哪种不确定性
作者把应用组织为「上下文必须消解什么」,而不是「用在哪个场景」。操作中的不确定性在于意图交互未被指定:一段示范要传达的是对象—目的关系、顺序还是接触;导航中的不确定性在于路线或局部空间结构被隐藏;长程序中的不确定性在于已完成的前置条件被隐藏;陌生身体中的不确定性在于其对动作的响应未知。
操作侧,示范的价值取决于用户需要指定什么。一张最终图只能指定可见终点;一段示范额外传达所需路径或顺序。BPP 的 DrawAnything 研究表明更广的绘制任务多样性带来更好的示范条件泛化,而其三任务洗衣研究里语言反而比行为示范更可靠——视频在「传达短标签或目标图所未决的选择」时最有价值。个性化行为则把持久约定加入任务规格:「轻放」应约束后续所有放置,而对某件物品位置的一次纠正不必。
导航侧,作者把证据归为四类上下文:路线示范(依次去哪)、环境观测(地点与物体在哪)、指令—决策样例(如何解释请求)、结果反馈(修正下一步尝试)。四者保留的东西不同、失效边界也不同:新目标可复用地图但替换路线;新建筑使局部位置失效而解释约定仍有用;地形变化可使先前的通过性估计失效。
长程序把教学问题从「选一个动作」变成「维护依赖结构」。未完成的一步、已完成的一步、失败的前置条件,在当前图像相似时仍要求不同的续行动作。不可逆操作进一步约束恢复方式:重复一次插入与重复一次给药后果不同,因此信息性下一次交互必须同时尊重所教的依赖结构与中间产物的状态。身体与动力学自适应则隔离物理响应:方向或速度命令已指定目标,近期动作后果揭示当前身体与地形如何响应。
任务换线(changeover)把这些需求与获取、复用成本结合:两个配料订单可用相同零件与抓取,却要求不同放置顺序;跨批次时所选顺序持续而完成步记忆重置;换工具要求新的物理估计而顺序可能仍有效。换线因此度量的是完整获取过程,包括验证所需证据。
落地与恢复:上下文何时失效
物体可能移动、抓取可能失败、阻力可能在任务被正确解释之后改变。恢复的目标是保留所教要求、同时修订状态估计与续行。作者区分三种失败与三种不同的恢复证据:视觉遮挡需要一个恢复缺失几何的视角;抓取丢失需要在继续搬运前检查接触;选错目标需要回到指令与示范的对应。每种修补针对一个不同的缺失事实。
恢复从评估到诊断再到纠正。评估需要一个「本该发生什么」的参照——对 ICL 而言这个参照来自当前教学,因此一个陌生但有效的顺序可以定义期望进度。诊断把失败检测变成修补选择:错位的对准与看不见的障碍需要不同干预;意图不确定靠澄清,阻力不确定靠感知或交互。纠正的粒度应匹配失败原因:选错目标要改任务选择,接近点偏移要空间更新,位移不足也许只需幅度调整。
复用则保留一条带条件的教训:哪个干预在何种条件下纠正了哪种失败。语言纠正记忆保留任务约束,动作—效果历史保留物理响应;工作单元重置清除完成步记忆,而换连接器或工具可使响应估计失效但装配顺序完好。对一个卡死的连接器,由测得阻力证成的调整不应在原因是错位时被复用。
评测:上下文何时有用
评测追踪「从改变证据到物理成功」的贡献链。上下文干预测试对教学的敏感性:在固定检查点、场景与执行器时改变样例,检验其任务要求是否影响行为;在匹配状态清空历史则测试对先前证据的访问。中间干预沿四个控制接口定位失败:对上下文策略供给相关示范段、对几何迁移供给正确对应与参照、对预测控制供给任务一致的未来、对智能体供给正确的可执行规格。
跨尝试的收益用一次受控差来度量。对试次记忆自适应,第 $n$ 次尝试的复用增益为:
$$\Delta_n^{\mathrm{reuse}}=S_n^{\mathrm{keep}}-S_n^{\mathrm{reset}}. \tag{19}$$
其中 $S_n$ 是同一预定义成功率或遵循率,上标表示保留或清空记忆。该比较固定任务分布、物理初始化、执行器、其他保留工件、先前尝试数与执行预算,只改变对这些尝试证据的访问。逐尝试比率隔离保留证据的收益,而累计成功还会从独立重试中获益——两者不可混用。
补充材料 Supplement S1 逐条记录了 14 组「已报告对照」,是全文事实密度的核心。它们分三组。第一组是训练与任务证据:ICRT 只用 DROID 子集训练的变体在留出测试任务上毫无进展;LMAct 把专家片段从 0 加到 512 条,收益往往很小;Show-Harness 在动作名任意、又不给书面约定时只有 1/20 个回合成功、动作映射正确率 23.3%;NOLO 抽掉场景预览视频后,Habitat 成功率从 43.65%±1.09% 掉到 33.58%±0.92%(三个随机种子)。第二组是迁移与物理实现:把整身形变换成部件级形变,杯—架任务的成功对象对从 11/27 升到 23/27;RAPID 打开「可行场景变体校验」后平均成功率从 53.2% 升到 75.9%。第三组是保留经验与后续学习:Zeva 去掉持久交互记忆(只留简短交互痕迹)后五个真实任务掉 10–20 个百分点;RTCF 从冻结基座的 86.4% 升到对齐记忆纠正的 88.4%;TraceFlow 在单个真实有序码垛任务上从 21/50 升到 39/50;FARE 基座 91.5%、完整系统 93.2%,而「每一步都触发恢复搜索」的消融只有 91.0%;LMPC 训练后继策略把测试成功率从 39.4% 提到 66.3%,成功会话的平均对话轮数从 2.4 降到 1.9。
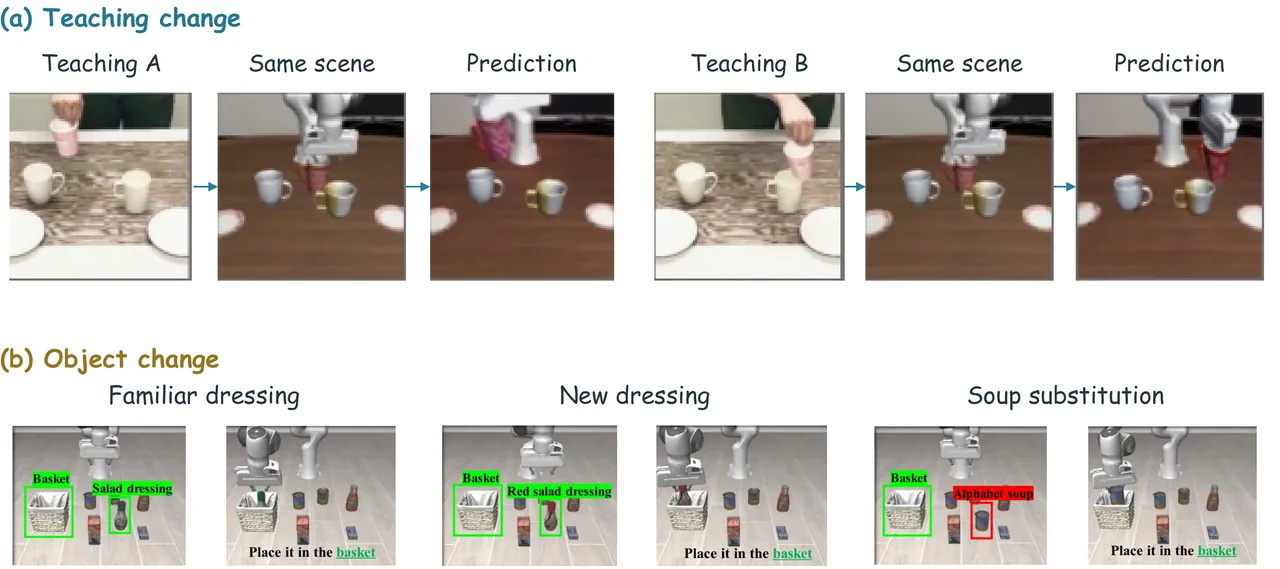
图 7:上下文迁移的两类测试。(a) 固定机器人场景、只改变示范,就会改变 UniSkill 预测的续行动作;(b) LIBERO-PRO 更换物体以测试目标选择。这两条轴合起来要求一类新的测试设计:独立地变化教学与物体身份,同时度量被推断出的任务要求与它的物理实现。
| 研究 | 对照 | 读数 | 设置 |
|---|---|---|---|
| ICRT | 仅 DROID vs 多任务训练 | 仅 DROID:无进展 | 共享测试任务 |
| LMAct | 0 → 512 条专家片段 | 常常收益甚微 | 游戏 / 仿真控制 |
| Show-Harness | 任意名且无约定 | 1/20 成功;映射 23.3% | 固定 harness |
| NOLO | 无视频 → 有视频 | SR 33.58 → 43.65 | Habitat;3 种子 |
| 部件级迁移 | 整身形变 → 部件形变 | 11/27 → 23/27 | 杯—架放置;部件提示由人给 |
| RAPID | 场景变体校验 关 → 开 | SR 53.2 → 75.9 | 8 任务 × 50 场景 × 3 次 |
| Zeva | 持久记忆 关 → 开 | +10–20 个百分点 | 5 个真实任务 |
| RTCF | 记忆纠正 关 → 开 | SR 86.4 → 88.4 | 固定库;2,000 片段/变体 |
| TraceFlow | 基座 → 轨迹引导 | 有序 21/50 → 39/50 | 1 个真实码垛任务 |
| FARE | 基座 → 选择性修订;每步都搜 | 91.5 → 93.2;每步都搜 91.0 | RoboTwin Easy;基座检查点冻结 |
| LMPC | 基座 → 后继 | SR 39.4 → 66.3;轮数 2.4 → 1.9 | 留出教学任务 |
flowchart LR
  A[Change teaching
same scene and executor] -->|does behavior follow evidence| B[Context dependence]
  B --> C[Substitute objects / environments / bodies] --> D[Transfer boundary]
  D --> E[Clear vs retain memory
matched physical resets] --> F[Retained-experience gain]
  F --> G[Successor comparison
same new teaching] --> H[Improved teachability S5]
图 8:评测控制阶梯(依据第 7 节绘制)。从「对教学敏感」到「物理可迁移」到「保留经验有收益」再到「后继更可教」,每一级都需要不同的干预与读数。
语料普查:这份综述的证据基础
综述对 412 条编号参考文献逐条编码,其中 260 条为方法类。四大家族在方法子集中的分布为:上下文条件策略 123、几何示范迁移 24、世界模型控制 22、技能与智能体执行 91。其余 152 条非方法类参考文献承担数据资源(44)、评测(39)、基础与综述(40)、训练与表示(29)等角色。时间分布高度右偏:2022 年 24 条、2023 年 33 条、2024 年 47 条、2025 年 53 条,而截至 2026 年 9 月 29 日的部分年份已达 197 条——72.1% 的参考文献发表于 2024 年及以后。这既说明领域之新,也意味着任何家族占比都会随下一次刷新而移动。
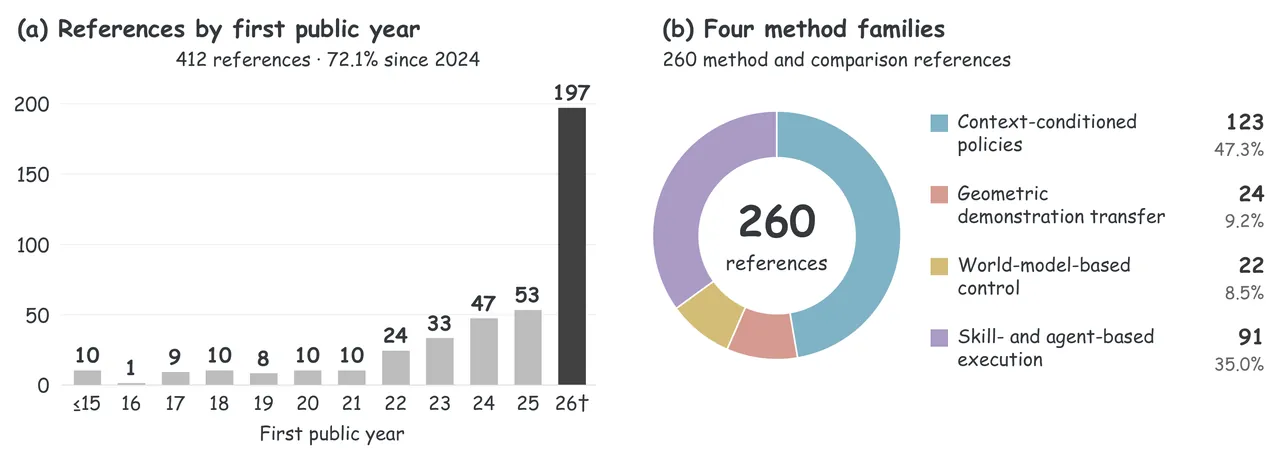
图 9:被综述文献的构成。(a) 全部 412 条参考文献的首次发表年份;(b) 260 条方法类参考文献的四家族分布。首箱覆盖至 2015 年;† 标记截至 2026-09-29 的部分年份。
| 角色 | 参考文献数 | 占 412 的比例 |
|---|---|---|
| 上下文条件策略 | 123 | 29.9% |
| 技能与智能体执行 | 91 | 22.1% |
| 几何示范迁移 | 24 | 5.8% |
| 世界模型控制 | 22 | 5.3% |
| 数据资源 | 44 | 10.7% |
| 基础与综述 | 40 | 9.7% |
| 评测 | 39 | 9.5% |
| 训练与表示 | 29 | 7.0% |
局限性
作者自述的第一类局限是语料的时效与编码粒度:72.1% 的参考文献来自 2024 年及以后、197 条来自尚未结束的部分年份 2026,家族占比与年度曲线会随刷新移动;分支级编码把 ReCAP 的 Cosmos Policy 支归入预测式世界—动作建模、ENPIRE 归入程序修订、GPT-Policy 归入上下文工具使用,这些归类本身是可争议的判断。
第二类局限来自证据本身:14 组已报告对照都是「研究内」比较,条件跨研究不同、不可直接横向相加;多个读数缺少不确定度(如 FARE 的三个成功率未报告方差),LMAct 的平坦曲线可能源于早期饱和、弱上下文使用或控制不足三者之一,仅凭该曲线无法区分。作者因此把「提议的控制」而非「跨研究排名」作为评测章节的产出。
第三类是我们的判断:综述以接口为轴,代价是对单个具体系统的端到端剖析较薄;读者若想知道某个 VLA 在某个基准上的绝对数字,仍需回到原始论文。此外,六时程中 S5/S6 的证据主要来自少数工作(LMPC、RoboRSI、REVOLVE 等),「物理递归自我改进」目前更接近议程而非已被复现的现象。
未来方向与总结
研究议程有四个相连目标:推断陌生规则、通过抽象保留有约束力的物理约束、在条件变化时修订已保留的纠正、改进后续任务被学会的方式。图 10 把这四条画成 (a) 推断所教的关系、(b) 组合任务步骤、(c) 在物理变化中保留功能、(d) 使用纠正反馈。作者特别强调一个可检验假设:任务关系的覆盖与可执行运动的覆盖对上下文迁移的贡献并不相同——更宽的预训练可能支持陌生的任务要求,而接地的配对训练建立精确的动作对应;只要独立地变化预训练规模与显式配对、同时固定执行器与任务信息,就能把两者的贡献分开。
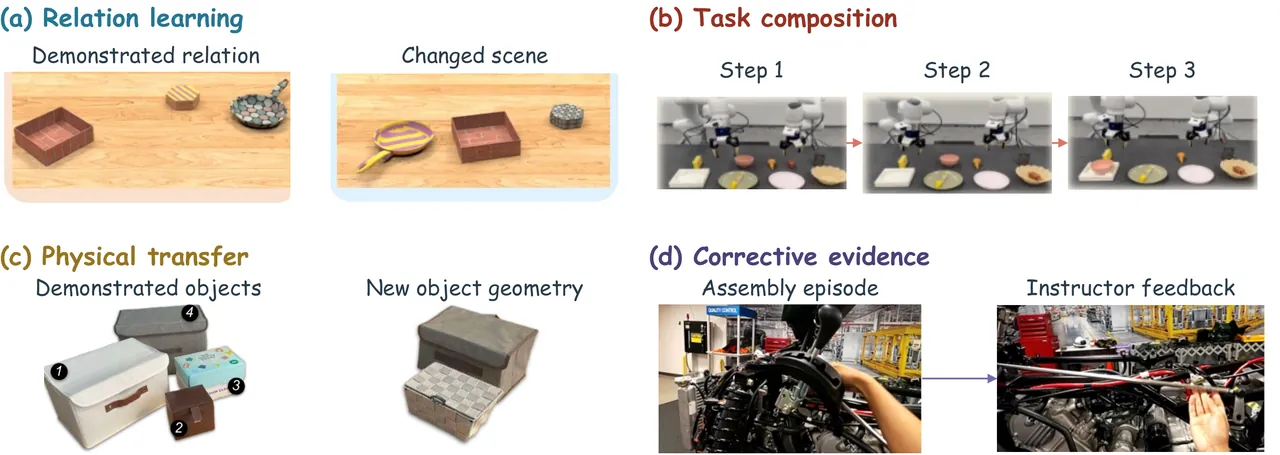
图 10:四个研究方向。(a) 推断所教关系;(b) 组合任务步骤;(c) 在物理变化中保留功能;(d) 使用纠正反馈。它们共同把上下文学习推向对任务要求的解释、迁移与保留。
在更长的学习周期上,S5 物理递归自我改进的判据是「后继从新教学中学到了什么」,而非当前求解器变强:LMPC 跨会话训练后继、把测试成功从 39.4% 提到 66.3% 是目前的代表证据;TraceFlow 的堆叠增益在最后一轮前见顶、HarnessPAI 的公开序列止于策略精化,都说明「一轮更强」不等于「循环成立」。S6 集体知识演化则要求双向度量迁移:一条机械臂示范放置关系、一个人形在不同运动学约束下实现、接收方返回经校验的执行或纠正——交换的教训保留任务顺序与对象关系,同时允许抓取与平衡控制改变。
总结与展望
机器人 ICL 处理的是「拥有可复用能力」与「知道如何在当前任务中应用它」之间的缺口;教学与交互在部署期神经参数冻结的前提下消解这一缺口。四个接口把信息带入动作:上下文动作推断、几何参照迁移、后果预测、技能或程序执行;它们的收益分别取决于兼容的表示、可用的交互几何、可实现的预测与足够的执行器能力。对应与记忆把证据跨情境、跨时间连接起来;落地(grounding)确立它是否仍然可用。
中心综合是:上下文学习依赖于把任务相关的区分从证据一路保留到执行。在选择、解释、实现或复用任一环节的丢失,都指向不同的数据、表示或控制能力。下一阶段的挑战是让这些依赖可迁移:推断陌生的要求组合、只修订受反馈影响的约束、丢弃条件已不成立的经验;而物理递归自我改进与集体知识演化,最终都要用「后继学到了什么、总共花了多少教学/交互/训练成本」来评估。
上下文学习的价值不在于模型多大,而在于它能否把任务相关的区分从证据一路保留到执行——丢在选择、解释、实现或复用任何一环,都是不同性质的失败。