PAPER DEEP DIVE
VLA-Precision:非对称协同自举让 VLA 真机在线 RL 高效又稳定
中科大团队提出 VLA-Precision,解决真机在线 RL 微调大 VLA 的两大瓶颈(价值信号不可靠诱发策略漂移、大模型开销限制吞吐)。ACoB 算法建立跨时间尺度的非对称协同自举:早期用人类介入引导的行为学习快速提升性能,全局回报传播与局部偏好排序渐进校准价值,相对优势改进配合参考正则化抑制漂移——其中局部排序专门修正『被人类纠正覆盖的原提案动作』的价值高估。ACoB-Stream 架构以不变状态解耦与按需流式传输带来最高 10.9× 吞吐提升。9 个高精度化学实验任务、4 种机器人本体上,98.3% 平均成功率、单任务平均 45.8 分钟,回合 27.6 秒(VLA 基线 1.2×、RL 基线 1.8× 速度)。
一句话总结
预训练 VLA 模型操作面广,但在要求精度与可重复性的任务上仍不可靠。真机在线 RL 能让 VLA 超越示范数据的天花板,却卡在两个瓶颈:价值信号不可靠会诱发策略漂移,以及大 VLA 的计算开销限制吞吐与样本效率。VLA-Precision 用 ACoB 算法 + ACoB-Stream 架构同时解决:ACoB 建立跨时间尺度的「非对称协同自举」——早期用人类介入引导的行为学习快速拉高性能并提升在线经验质量,随后用全局回报传播与局部偏好排序逐步校准价值估计,产出相对动作优势用于参考正则化的策略改进并抑制漂移;ACoB-Stream 以「不变状态解耦」与「按需流式传输」为设计原则,带来最高 10.9× 吞吐与计算效率提升。在 4 类共 9 个高精度化学实验任务、4 种机器人本体上,98.3% 平均成功率、单任务平均 45.8 分钟,回合耗时 27.6 秒,分别是 VLA 与 RL 基线的 1.2× 与 1.8× 速度。
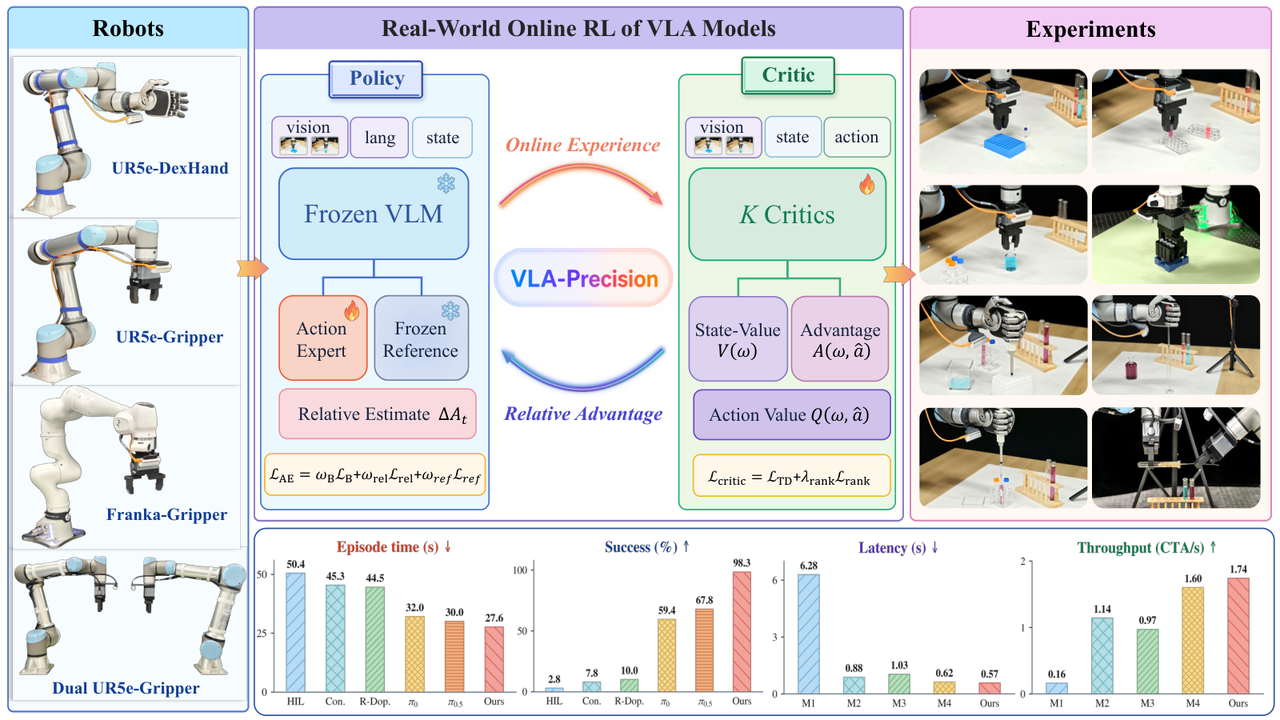
图 1:框架总览。VLA-Precision 在闭环的经验—策略架构中,把快速行为学习、渐进式价值校准与参考正则化的相对优势策略改进结合起来,实现大 VLA 的稳定高效真机在线 RL。
研究背景:为什么真机在线 RL 难
近年来 VLA 模型通过在异质多模态数据上的大规模预训练获得了广泛可迁移能力,只需少量任务示范就能执行多样操作并在环境变化间泛化。但广泛的适应性无法保证精确与可重复的任务完成:关键阶段的微小残余误差仍会导致间歇性失败。
行为克隆(BC)直接从示范的稠密动作标签学行为,但在示范分布之外误差会累积,且性能上界被示范质量锁死。相比之下,强化学习通过时间信用分配从交互中学长期动作价值,因而把 RL 用于 VLA 后训练,可以借助交互衍生的回报信号持续优化策略,缓解误差累积并突破示范数据的天花板。
现有真机 RL 方法按模型规模分两类:面向大型预训练 VLA 的,与面向紧凑机器人策略的。论文指出真机 VLA-RL 始终受两个关键瓶颈制约:
- 算法稳定性:不可靠的价值估计会诱发策略漂移;
- 系统效率:大 VLA 的计算开销限制训练吞吐,降低整体在线 RL 效率。
此前的应对主要用示范或介入的行为克隆约束来正则化 RL 更新(如 ConRFT、RL-Co),虽保留先验行为、稳定探索,但对价值估计的改善有限。而 ConRFT 的 Q 最大化会牺牲先验性能并允许策略漂移;Robo-Dopamine 用大规模进度奖励模型,但 OOD 幻觉可能误导优化;RL-100 每任务平均需要 12.1 小时真机 rollout;π*0.6 虽然多数任务超 90% 成功率,却每任务平均需要 1000+ 次真机 rollout;RL Token 加速关键阶段吞吐最多 3×,但仍需每任务 400–1000 个在线回合,且外部化改进与策略交接限制了端到端适应。
方法:ACoB 算法 + ACoB-Stream 架构
问题形式化:两阶段后训练
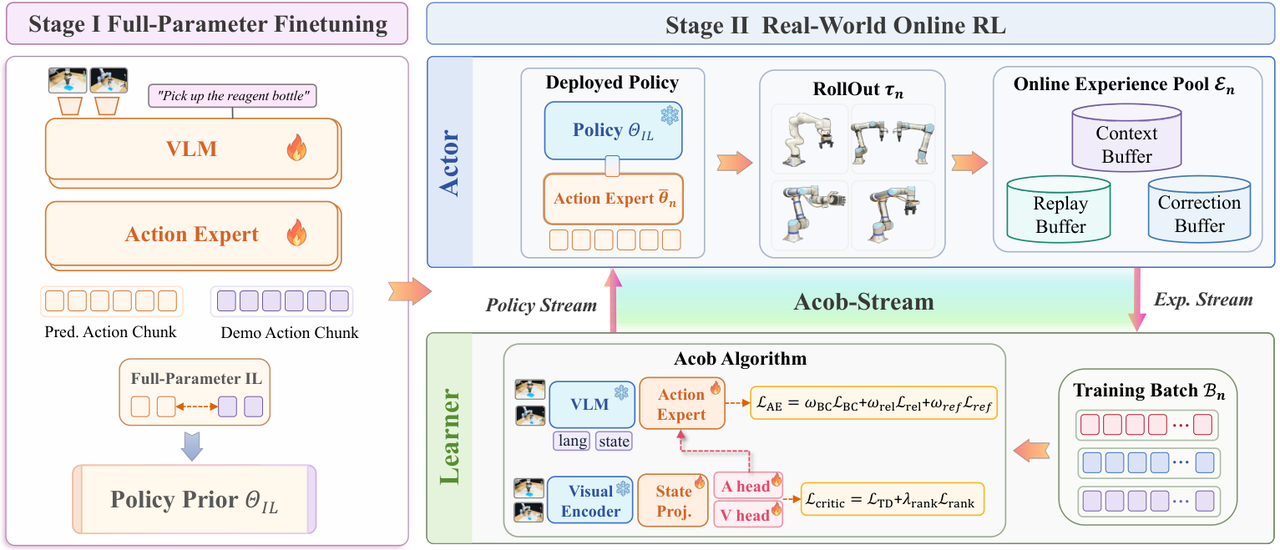
图 2:两阶段后训练流水线。阶段一在示范上做全参数模仿学习得到任务特定策略先验;阶段二从该先验初始化真机在线 RL,在异步 actor–learner 系统中rollout 产生在线经验、learner 优化产出动作专家更新后重新部署。
在任务指令 $\ell$ 下把物理交互建模为标准 MDP:
$$\mathcal{M}_\ell = (\mathcal{S}, \mathcal{A}, P, r, \rho_0, \bar{\gamma})$$
决策步 $t$ 的状态 $s_t = (o_t, q_t, \ell) \in \mathcal{S}$ 由视觉观测 $o_t$、机器人状态 $q_t$ 与任务指令 $\ell$ 组成。VLA 的一次动作是 $H$ 步动作块 $a_t = (u_{t,0},\dots,u_{t,H-1})\in\mathcal{A}\subseteq\mathbb{R}^{H\times d}$。执行该块诱导 $s_{t+1}\sim P(\cdot\mid s_t,a_t)$ 并产生累积奖励:
$$R^{(H)}_t = \sum_{h=0}^{H-1} \gamma^h r_{t,h}$$
其中 $\gamma$ 是元动作步折扣因子,$\bar{\gamma}=\gamma^H$。策略从任务微调后的 $\pi_{0.5}$ 初始化,只优化动作专家中的 LoRA 参数 $\theta\in\mathbb{R}^p$,冻结多模态前缀参数 $\Theta_f$ 与阶段一继承的动作专家参数 $\psi$。动作块生成为:
$$a_t = G_{\psi,\theta}(z_t, \epsilon_t) \sim \pi_{\Theta_f,\psi,\theta}(\cdot\mid s_t), \qquad \epsilon_t\sim\mathcal{N}(0,I)$$
这里 $z_t = F_{\Theta_f}(o_t,\ell,q_t)$ 是由视觉观测、任务指令与机器人状态编码出的任务条件多模态前缀上下文,$G_{\psi,\theta}$ 是流式(flow-based)动作专家。在线 RL 目标为最大化回报:
$$\theta^\star = \arg\max_{\theta\in\mathbb{R}^p} J(\theta),\qquad J(\theta) = \mathbb{E}_{\tau\sim p(\tau\mid\pi_{\Theta_f,\psi,\theta},P,\rho_0)}\Big[\sum_{t=0}^{T-1}\bar{\gamma}^t R^{(H)}_t\Big]$$
ACoB 之一:渐进式价值校准
ACoB 把价值模型实例化为 $K$ 个任务特定 critic 的集成,每个采用价值—优势分解:
$$Q_{\phi_k}(\omega, \hat{a}) = V_{\phi_k}(\omega) + A_{\phi_k}(\omega, \hat{a})$$
其中 $\omega_t = (o_t, q_t) = \text{proj}_{o,q}(s_t)$ 是状态的视觉—本体感知分量。对任意动作块 $a$,$\hat{a} = \mathcal{C}(\mathcal{T}_t(a))$ 是其扁平化的 critic 表示。
全局回报传播。令 $a^{\text{exec}}_t$ 为机器人最终执行的动作块(来自自主推理或人类纠正),诱导转移 $\xi_t = (s_t, a^{\text{exec}}_t, r_t, s_{t+1}, d_t)$。自举动作与 TD 目标构造为:
$$\hat{a}^{\theta_n}_{t+1} = \mathcal{C}\big(\tilde{G}_{\psi,\theta_n}(z_{t+1},\epsilon)\big),\qquad y_t = R^{(H)}_t + \bar{\gamma}(1-d_t)\min_k Q_{\bar{\phi}_k}(\omega_{t+1}, \hat{a}^{\theta_n}_{t+1})$$
集成 TD 目标为:
$$\mathcal{L}_{\text{TD}}(\phi) = \mathbb{E}_{\mathcal{B}^{\text{RL}}_n}\Big[\frac{1}{K}\sum_k \big(Q_{\phi_k}(\omega_t, \hat{a}^{\text{exec}}_t) - \text{sg}(y_t)\big)^2\Big]$$
通过递归自举,该目标沿已执行轨迹传播长时程回报。
局部偏好排序。论文发现一个关键漏洞:纠正动作可以把一次 rollout 救回成功,但沿已执行轨迹的 TD 无法修正「被覆盖的原提案」的价值——原提案可能仍被高估并误导动作专家优化。ACoB 用状态匹配的局部偏好排序解决:介入前部署的 VLA 提出 $a^{\text{prop}}_t$,有效介入标记为 $i_t=1$ 并提供纠正块 $a^{\text{hum}}_t$,于是
$$a^{\text{cmd}}_t = \begin{cases} a^{\text{prop}}_t, & i_t = 0 \\ a^{\text{hum}}_t, & i_t = 1 \end{cases}, \qquad a^{\text{exec}}_t = \text{Exec}(s_t, a^{\text{cmd}}_t)$$
仅当 $i_t=1$ 且 $\lVert \hat{a}^{\text{exec}}_t - \hat{a}^{\text{prop}}_t \rVert_2 > \varepsilon_a$ 时置 $c_t=1$。因为 $a^{\text{prop}}_t$ 没有观测到的后继状态,它被排除在 TD 学习之外,只用于状态匹配排序目标:
$$\mathcal{L}_{\text{rank}}(\phi) = \mathbb{E}_{\xi_t\sim\mathcal{B}^{\text{RL}}_n \mid c_t=1}\Big[\frac{1}{K}\sum_{k=1}^{K}\big[m_c - \Delta A^{\text{pair}}_{t,k}\big]_+^2\Big],\qquad \Delta A^{\text{pair}}_{t,k} = A_{\phi_k}(\omega_t, \hat{a}^{\text{exec}}_t) - A_{\phi_k}(\omega_t, \hat{a}^{\text{prop}}_t)$$
其中 $m_c\ge 0$ 是排序间隔,$[x]_+=\max(x,0)$。总 critic 目标为:
$$\mathcal{L}_{\text{critic}} = \mathcal{L}_{\text{TD}} + \lambda_{\text{rank}} \mathcal{L}_{\text{rank}}$$
TD 把 critic 锚定在长时程回报上,局部排序则直接校准纠正与原提案的相对价值,解决长时程 TD 传播无法处理的局部信用模糊性。由于采用 $Q=V+A$ 分解,$V$ 是跨动作共享的纯状态分量,而排序损失只作用于 $A$——这把动作相关的差异从纯状态分量中隔离出来,使信号与动作专家优化对齐。
ACoB 之二:相对优势策略改进
直接最大化绝对 $Q$ 值会放大早期价值估计误差,把策略推向虚假高价值动作。ACoB 用相对优势改进替代绝对值追逐:关注动作之间的改善,降低对价值尺度与乐观估计误差的敏感度。但价值信号的可靠性必须随在线经验积累逐步建立,单靠这个间接 RL 信号,早期动作专家更新会又慢又不稳定。
于是 ACoB 把相对优势改进与流式匹配行为克隆耦合。与先前主要用 BC 约束策略分布的方法不同,ACoB 在训练早期用关键阶段的人类纠正来驱动 BC——快速吸收高质量纠正来改进动作专家,同时通过更好的经验加速 critic 校准。随后长时程回报传播与局部偏好排序持续校准价值估计,在介入逐步退场时提供越来越可靠的自主改进指导。这就建立了快速行为克隆与渐进式价值校准之间的「非对称协同自举」。与此同时,任务微调后的动作专家被保留为冻结参考,参考正则化把在线精修聚焦在执行精度上,而不是重塑行为,从而保留既有能力并抑制价值诱发的策略漂移。
ACoB-Stream:不变状态解耦 + 按需流式传输
为了让 ACoB 跑在大 VLA 上,论文设计了闭环的经验—策略架构 ACoB-Stream,围绕状态生命周期组织,以不变状态解耦与按需流式传输为核心设计原则。在线经验池由回放缓冲 $\mathcal{R}$、纠正缓冲 $\mathcal{C}$ 与上下文缓冲 $\mathcal{K}$ 组成:actor 生成轨迹 $\tau_n$,把所有转移存入 $\mathcal{R}$、有效纠正存入 $\mathcal{C}$、多模态前缀上下文存入 $\mathcal{K}$;learner 用 ACoB 在批次上优化 $\theta_n$ 得到 $\theta_{n+1}$ 再部署为 $\bar{\theta}_{n+1}$。整体闭环写成:
$$\text{Actor}: \bar{\theta}_n \xrightarrow{\text{Rollout}} \tau_n \xrightarrow{\text{experience}} \mathcal{E}_n \ni \mathcal{B}_n,\qquad \text{Learner}: (\theta_n, \mathcal{B}_n) \xrightarrow{\text{ACoB}} \theta_{n+1} \xrightarrow{\text{policy}} \bar{\theta}_{n+1}$$
论文特别强调:与 EXPO-FT、RL Token 等「不把 RL 梯度传过 VLA、转而去优化残差动作编辑或轻量 token 条件策略」的做法不同,ACoB-Stream 让改进累积在统一策略内部;与靠集群/云边扩展堆吞吐的做法也不同,它降低的是每次更新的大 VLA 计算量本身。实测最高 10.9× 吞吐与计算效率提升。
实验结果
硬件与任务设置
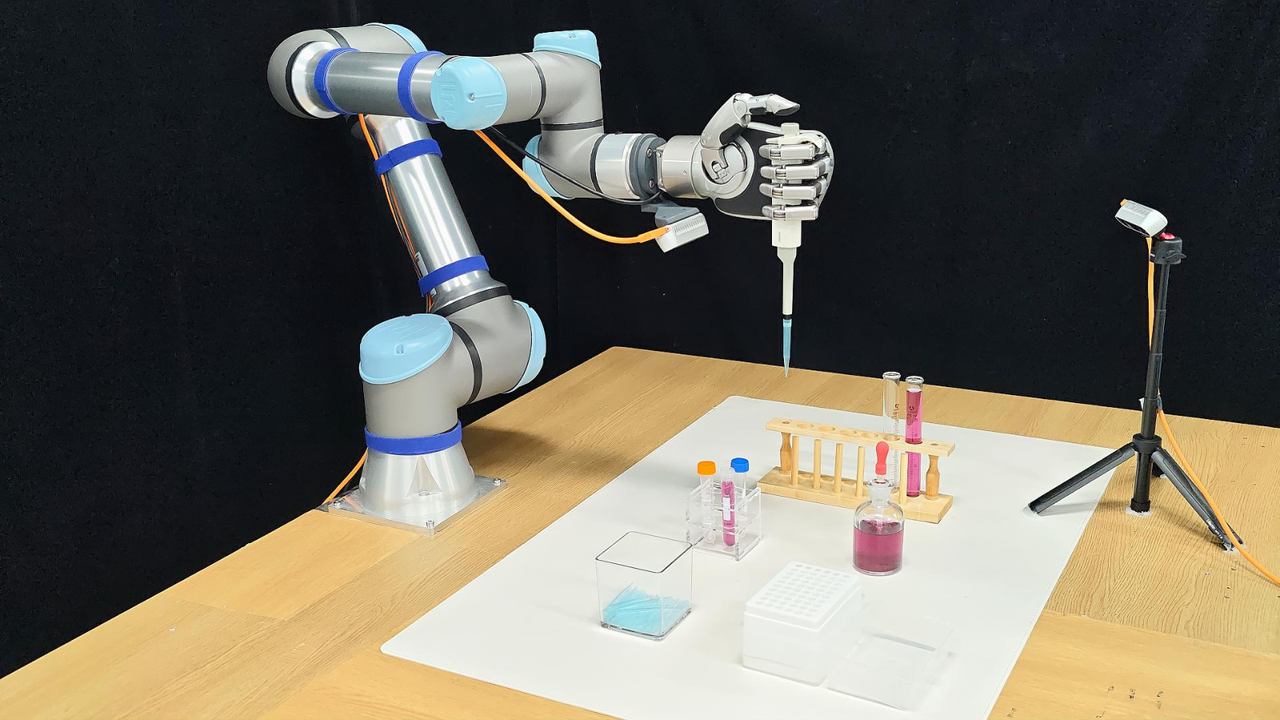
图 3:硬件平台。单臂平台配一个腕部相机与一个外部相机,双臂平台配两个腕部相机与一个外部相机。
四个机器人平台:(1) UR5e + PGI-140-80 二指平行夹爪;(2) UR5e + LinkerHand L20 灵巧手;(3) 双臂 UR5e,各配 PGI-140-80 夹爪;(4) Franka Research 3 + PGI-140-80 夹爪。设计 9 个化学实验室高精度操作任务,覆盖四类:富接触、轻接触、无接触、双臂协调。为严格评估泛化,每个任务都刻意变化物体位姿与初始臂位姿(变化范围在论文 Table II / III 中给出)。训练使用 4× NVIDIA A800 GPU。
主结果(9 个化学操作任务)
| 方法 | 平均训练(min) | 平均成功率 | 平均回合时间(s) |
|---|---|---|---|
| HIL-SERL | — | 2.8% | 50.4 (×0.6) |
| ConRFT | — | 7.8% (+5%) | 45.3 (×0.7) |
| Robo-Dopamine | — | 10% (+7.2%) | 44.5 (×0.7) |
| π0 | — | 59.4% (+56.7%) | 32.0 (×1.0) |
| π0.5 | — | 67.8% (+65%) | 30.0 (×1.1) |
| VLA-Precision | 45.8 | 98.3% (+95.6%) | 27.6 (×1.2) |
(括号内为相对 $\pi_0$ 基线的提升/速度倍率。)VLA-Precision 在每任务平均 45.8 分钟在线训练后达到 98.3% 平均成功率,成功回合耗时 27.6 秒,分别是 VLA 基线的 1.2×、RL 基线的 1.8× 速度。逐任务看:试管架上料、2 mL 小瓶转移、酒精灯熄灭、移液器吸头安装、胶头滴管转移、移液与排液 6 个任务达到 100%;橡胶塞插入 100%(HIL-SERL 仅 5%)、比色皿转移 90%、试管刷洗 95%($\pi_0$ 仅 5%、$\pi_{0.5}$ 仅 10%)。
值得注意的是纯 RL 基线在这些高精度任务上几乎全线崩溃(HIL-SERL 2.8%、ConRFT 7.8%、Robo-Dopamine 10%),而纯 VLA 监督微调基线($\pi_0$ 59.4%、$\pi_{0.5}$ 67.8%)受限于示范质量。这两组数字恰好印证了论文的动机:示范锁死上界,而朴素 RL 在真机高精度场景中不稳定——必须把两者以正确方式耦合起来。
共享超参数
| 超参数 | 取值 |
|---|---|
| $\lambda_{\text{rank}}$ | 50 |
| $(w_{\text{BC}}, w_{\text{rel}}, w_{\text{ref}})$ | (0.25, 0.50, 0.25) |
| 初始重置范围 | $x,y,z$ 各 3 cm |
| 训练 GPU | 4× NVIDIA A800 |
意义与局限
任务示范 → 策略先验 Θ_IL"] --> B["阶段二:真机在线 RL
仅训练动作专家 LoRA θ"] B --> C["Actor rollout
自主推理 或 人类介入纠正"] C --> D["经验池:回放 R + 纠正 C + 上下文 K"] D --> E["Critic:全局回报传播 L_TD
沿已执行轨迹传播长时程回报"] C --> F["Critic:局部偏好排序 L_rank
纠正 > 原提案(状态匹配)"] E --> G["相对优势改进
关注动作间差异,非绝对 Q"] F --> G G --> H["参考正则化
冻结 Θ_IL 作参考,抑制漂移"] H --> I["部署 θ̄_{n+1} → 继续 rollout"] I --> C
最值得借鉴的是「局部偏好排序」这个设计。它抓住了一个很容易被忽略的漏洞:人类介入把一次 rollout 救回成功后,被覆盖掉的那个「原提案动作」虽然没有被执行、没有后继状态,但它在此前的价值网络里可能已经被学成了高价值;如果不显式压低它,这个错误估值会持续误导策略。ACoB 用状态匹配的成对排序(纠正 > 原提案)补上这一课,而且因为 $Q=V+A$ 分解,排序损失只作用于优势 $A$,不会污染状态价值 $V$。
另外三个工程要点。其一,「非对称」体现在时间尺度上——行为克隆快、价值校准慢,早期靠前者拉性能并用更好的经验反哺后者,后期靠前者退场、后者接管,这比「用 BC 当正则项约束 RL」的常见做法更主动。其二,冻结阶段一的动作专家作为参考,把在线精修限制在「执行精度」而非「重塑行为」,这是抑制漂移的一道廉价而有效的保险。其三,ACoB-Stream 降低的是每次更新的大 VLA 计算量本身,而不是靠堆机器人和加速器——与集群扩展路线正交,可以叠加。
局限方面,从设计与实验设置可以看到几点边界:方法依赖训练早期的人类介入(需要人类在环的遥操作纠正阶段),介入的质量与时机直接影响后续自举;任务集虽然是 4 类 9 个化学实验操作、4 种本体,但都集中在实验室台面尺度的高精度操作,向更长的移动操作或更开放场景的迁移未验证;超参数如 $\lambda_{\text{rank}}=50$、$(w_{\text{BC}},w_{\text{rel}},w_{\text{ref}})=(0.25,0.50,0.25)$ 在全部任务上共享,跨任务是否需要调整未做敏感性分析;critic 集成规模 $K$ 与排序间隔 $m_c$ 的选取影响亦未展开消融。