PAPER DEEP DIVE
Juno:为视觉-语言-动作模型驯服预测性潜变量
Juno 把同一个动作条件 JEPA(LeWM,ViT-Tiny 约 15M 参数)用在三个位置:控制对齐的表征骨干、策略学习期的预测教师、部署期的可适配动力学模型。预训练用 Dynamic CLS 损失把冻结 patch 监督者的运动加权 patch 变化搬进紧凑的 CLS 状态;策略学习用 patch 级融合加 MoT 解耦推理分支,把 K 个未来 CLS 状态一对一蒸馏进隐序列,并与流匹配动作损失在同一条隐序列上汇合;部署期两阶段测试时适配先用全部转移(含失败)全参数更新世界模型,再冻结适配后的教师、只在验证成功的执行上以 LoRA 重对齐策略。SimplerEnv 平均成功率 68.5%(最强基线 Qwen3GR00T 为 60.9%,适配后 72.7%),RoboCasa-GR1 24 任务 59.6%(赢下 21 个),真机冻结策略在累积偏移下保持 75/70/70 而基线归零。
论文元信息
标题:Juno: Taming Predictive Latents for Vision-Language-Action Models
作者:Yuchen Zhu、Chenyi Xu、Yulin Zhang、Gang Xu、Wentao Zhu(中国科学技术大学、东方理工(宁波)、杭州电子科技大学、上海科技大学)
链接:arXiv:2610.09940(v2,2026-10-11)· 项目主页 · 代码仓库 · HuggingFace 模型入口 LightningNO1/Juno
代码状态:仓库公开了 Bridge/Fractal 策略学习阶段的完整训练栈——juno-policy 模型(含 JEPA 接口、patch 融合、MoT 推理分支)、LeRobot 数据混合与变换、trainer 与 launcher,MIT 许可(衍生自 StarVLA,LICENSE 保留 StarVLA 署名条款)。README 的 TODO 中 JEPA 预训练代码、TTT 代码与 checkpoint 发布仍未勾选,docs/reproducibility.md 也明确声明公开 launcher 只覆盖策略学习阶段、README 的成绩是论文报告值而非仓库跑分;复核时应以 configs/bridge_fractal_jepa7_mot_1005.yaml 为准。
一句话总结:Juno 把同一个动作条件 JEPA(LeWM,ViT-Tiny 约 15M 参数)放进三个位置——控制对齐的表征骨干、策略学习期的预测教师、部署期的可适配动力学模型——用 Dynamic CLS 损失把 patch 级运动搬进紧凑的 CLS 状态,用 patch 融合加 MoT 解耦推理分支把未来潜状态蒸馏进动作生成,再用「失败只教世界、成功才教动作」的两阶段测试时适配,在 SimplerEnv 上把平均成功率从 60.9% 抬到 68.5%(适配后 72.7%),真机累积扰动下保持 70–75% 而最强基线归零。
研究背景与动机
预测性潜变量对 VLA 有天然的吸引力:JEPA 一族模型在表征空间里预测被掩码或未来的观测,不重建像素,学出的状态天然带有「接下来会发生什么」的信息。但作者指出,把这类潜变量真正用进 VLA 的预训练、策略学习与部署三个阶段,会撞上三种失败。第一种是与 embodiment 控制不匹配:在通用视频上预训练的编码器(如 V-JEPA 2)对机器人-物体交互的局部响应迟钝,Fig.2(a) 里它的 patch 级时间余弦距离图近乎均匀,而 LeWM 的 patch 图清楚地亮在操作区域;Fig.2(b) 里 LeWM 的 CLS 状态在拾取-放置阶段(t 大于 14)也几乎不动,说明「全局状态」会被静态背景稀释。第二种是预测目标干扰动作学习:把未来预测硬塞进 VLA 主干,会扰动那套本来用于动作生成的表征,消融里「去掉 patch 融合但保留预测分支」跌到 53.9%、比不加任何组件的基线 60.9% 还低,正是这种干扰的直接证据。第三种是分布偏移下教师失准:强观测噪声或突变光照下,冻结的 JEPA 教师自己就不可靠,与它耦合的策略随之崩塌。
已有工作各解决了一角。VLA-JEPA 等把 JEPA 特征接进 VLA,但预测与动作生成之间的通路仍是串行的或浅层的;WAM-ttt、TTT-VLA、VANE 等测试时方法在部署期调整潜变量或提示,但多数只信任成功回放,或把世界模型当作固定的评分器。Juno 的回答是「一个模型、三个角色」:同一个动作条件 JEPA 先在 embodiment 匹配的轨迹上做控制对齐预训练,再在策略学习期作为冻结教师蒸馏未来状态,最后在部署期作为可全参数适配的动力学模型吸收全部交互——包括失败。
预备知识
动作条件 JEPA 世界模型(LeWM)。JEPA 用编码器把观测映到潜状态、用潜空间预测器预测未来观测的潜状态,而不是解码像素。LeWM 是其中面向机器人控制的轻量实现:端到端从像素训练,ViT-Tiny 配置约 15M 参数,预测器以当前 CLS 状态与动作为条件。Juno 沿用它的接口:编码器输出 CLS token 与 patch token 网格,预测器输出下一帧 CLS 的预测值。
VLA 策略与流匹配动作头。策略把观测与语言指令(必要时加本体状态)映到动作分布;Juno 的实例化是 Qwen3-VL-4B-Instruct 主干加 GR00T 式流匹配 DiT 动作解码器,动作以 16 步 chunk 预测,训练时每个 chunk 采 8 个噪声/时间样本,推理用 4 步欧拉积分。
Mixture-of-Transformers(MoT)。视觉-语言分支与预测推理分支各自持有非嵌入参数(注意力投影、MLP、layernorm),但共享同一张因果注意力图:两条分支在每一层互相看见,却用各自的变换处理自己的 token。这让「预测未来」可以拥有一套独立参数,而不污染用于动作生成的表征。
方法详解
一个动作条件 JEPA 的接口
记轨迹 $\tau=\{(o_t,a_t,o_{t+1})\}_{t=1}^{T}$,编码器与预测器为 $f_\theta$、$g_\phi$:
$$[c_t,P_t]=f_\theta(o_t),\qquad \hat{c}_{t+1}=g_\phi(c_t,a_t),\qquad \mathcal{L}_{\mathrm{JEPA}}=\mathcal{L}_{\mathrm{pred}}(\hat{c}_{t+1},c_{t+1})+\lambda_{\mathrm{reg}}\mathcal{R}(c), \tag{1}$$其中 $c_t\in\mathbb{R}^D$ 是 CLS token,$P_t=[p_{t,1},\ldots,p_{t,M}]\in\mathbb{R}^{M\times D}$ 是 patch token 网格,$\mathcal{R}$ 是潜空间正则(实现为 SIGReg,权重 0.2、1024 个投影、17 个结点)。预测值 $\hat{c}_{t+1}$ 由 $(c_t,a_t)$ 算出,目标 $c_{t+1}$ 由真实下一帧编码——这一「动作条件」结构是后文测试时适配能复用同一目标函数的前提。LeWM 为规划效率只用 $c_t$ 作状态、丢弃 $P_t$,而 Fig.2(b) 显示 CLS 在拾取-放置期间几乎不变:稀疏的物体或接触变化被静态背景稀释了。Juno 的第一刀就切在这里。
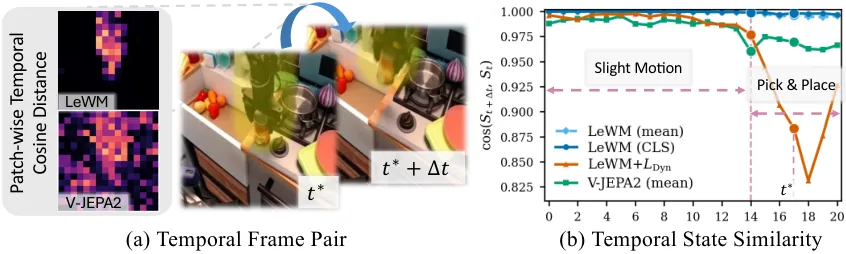
图1:动机证据(论文 Fig.2)。(a) 帧 $t^\star$ 与 $t^\star+\Delta t$ 之间的 patch 级时间余弦距离:LeWM 的响应集中在操作区域,V-JEPA2 近乎均匀;(b) 整集的时间状态相似度 $\cos(c_t,c_{t+\Delta t})$:轻微运动段(t 不超过 14)与拾取-放置段(t 大于 14)之间,LeWM(CLS) 几乎水平,而加上 Dynamic CLS 损失的 LeWM+L_dyn 在拾取-放置段明显响应,mean-pooled 基线仅作参照。
控制对齐预训练:Dynamic CLS 损失
思路是用 patch 级的变化监督 CLS token,分两阶段。第一阶段按标准目标 $\mathcal{L}_{\mathrm{JEPA}}$ 训练 LeWM,此时 patch token 已能可靠响应局部交互;第二阶段把这个编码器冻结为 patch 监督者 $\bar{f}$,记 $[\bar{c}_t,\bar{P}_t]=\bar{f}(o_t)$,在它提供的稳定目标下继续训练可训练编码器——冻结的监督者是一个不会漂移的 stop-gradient 参照。对每个转移,第 $i$ 个冻结 patch 的变化与其幅度为
$$\Delta\bar{p}_{t,i}=\bar{p}_{t+1,i}-\bar{p}_{t,i},\qquad m_{t,i}=\frac{\lVert\Delta\bar{p}_{t,i}\rVert_2}{\sqrt{D}}. \tag{2}$$再做运动感知聚合:把相对幅度归一化后经温度 softmax 变成软权重
$$\widetilde{m}_{t,i}=\frac{m_{t,i}}{\max\!\left(M^{-1}\sum_{j=1}^{M}m_{t,j},\,\epsilon\right)},\qquad \alpha_{t,i}=\frac{\exp(\widetilde{m}_{t,i}/\tau)}{\sum_{j=1}^{M}\exp(\widetilde{m}_{t,j}/\tau)}, \tag{3}$$其中 $\tau$ 为温度(实现取 0.5)、$\epsilon$ 防除零、$M$ 为 patch 数。运动加权的 patch 目标为 $u_t=\sum_{i=1}^{M}\alpha_{t,i}\Delta\bar{p}_{t,i}$,可训练编码器的 CLS 转移为 $\Delta c_t=c_{t+1}-c_t$,辅助损失即
$$\mathcal{L}_{\mathrm{dyn}}(\theta)=\mathbb{E}_{(o_t,a_t,o_{t+1})\sim\mathcal{D}}\left[\lVert\Delta c_t-u_t\rVert_2^2\right]. \tag{4}$$注意 $a_t$ 不直接进入这个辅助目标,它仍留在式 (1) 的动作条件 JEPA 目标里。第二阶段总目标为
$$\mathcal{L}_{\mathrm{LeWM+Dyn}}=\mathcal{L}_{\mathrm{JEPA}}+\lambda_{\mathrm{dyn}}\mathcal{L}_{\mathrm{dyn}}. \tag{5}$$效果是保留 LeWM 的单 CLS 接口(下游只吃一个紧凑状态),同时让 $c_t$ 对 $P_t$ 捕捉到的局部变化更敏感。训练细节:窗口为步长 2 的四帧(三个上下文、一个预测目标),转移条件化为夹在中间的 14 维动作;全局 batch 2048、AdamW 5e-5;Dynamic CLS 权重 0.2、温度 0.5,patch 目标来自源编码器的冻结副本;策略使用第 36 个 epoch 的导出权重。
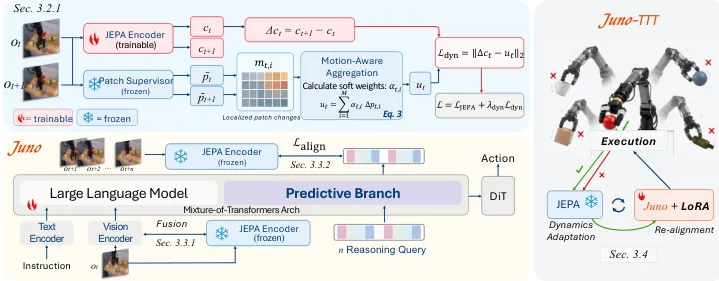
图2:方法总览(论文 Fig.3)。左上:Dynamic CLS 预训练——可训练 JEPA 编码器的 CLS 转移对齐冻结 patch 监督者的运动加权 patch 变化(式 3、4),总目标为式 5;左下:Juno 策略——冻结 JEPA 编码器经 patch 融合注入视觉 token,MoT 预测分支用 K 个推理查询蒸馏未来 CLS 状态(式 6),与流匹配动作损失联合(式 7);右:Juno-TTT——执行数据先全参数适配世界模型,再冻结适配后的教师、只在验证成功的执行上重对齐策略。火焰与雪花图标分别表示可训练与冻结模块。
解耦预测推理:patch 融合 + MoT 蒸馏
预训练完成后冻结 JEPA 编码器记为 $E_J$,它在三个位置继续工作。第一处是 patch 级融合:当前帧 patch 特征经一个可训练两层 MLP 投到 VLA 隐宽度,再通过交叉注意力融进原生视觉 token,残差连接带固定增益 $\gamma$——空间信息进了 VLA,原 token 序列的结构不变。第二处是预测分支:以 MoT 解码块实例化,视觉-语言分支与预测推理分支各自持有非嵌入参数、共享一张因果注意力图,前者保住用于动作生成的表征,后者专职预测未来 JEPA 状态。第三处是教师:向序列追加 $K$ 个可学习推理查询,记最终推理状态为 $H_{R,t}^L$,可训练投影 $g_r$ 产出预测的未来状态 $\widehat{Z}_t=g_r(H_{R,t}^L)$;冻结编码器对 $K$ 个未来观测给出 detached 的 CLS 目标 $Z_t^+=E_J^{\mathrm{cls}}(o_{t+\Delta:t+K\Delta})$。查询数与未来目标数相同,于是可以一对一对齐:
$$\mathcal{L}_{\mathrm{align}}=\frac{1}{BK}\sum_{b=1}^{B}\sum_{k=1}^{K}\left[1-\operatorname{cos}(\widehat{z}_{b,k},z^+_{b,k})+\lambda_{\mathrm{sl1}}\operatorname{SmoothL1}_\delta(\widehat{z}_{b,k},z^+_{b,k})\right], \tag{6}$$实现取 $\lambda_{\mathrm{sl1}}=\delta=0.1$、$K=8$ 与 8 个步长 2 的未来帧一一对应。关键在于梯度通路:完整隐序列(视觉-语言状态加推理状态)共同条件化流匹配动作解码器,因此推理分支同时收到未来状态对齐与动作生成两路梯度——这正是「对齐的状态能被解码成动作」而不只是「能预测未来」的原因。联合目标为
$$\mathcal{L}_{\mathrm{VLA}}=\mathcal{L}_{\mathrm{FM}}+\alpha\,\mathcal{L}_{\mathrm{align}}, \tag{7}$$其中 $\alpha$ 按课程调度:线性 warmup $W$ 步、平台 $P$ 步、再半余弦衰减 $D$ 步到 0.05(Bridge/Fractal 与 RoboCasa 为 5k/30k/70k,100k 预算内衰减尚未触底)。推理时未来目标通路被移除,预测分支只看当前观测与指令。
代码把这三处落得很具体。JEPAInputResidualFuser 是 LayerNorm 加一个标量门,融合权重为 $\tanh(\text{gate})$,公开配置里门初始化为 0——融合从「关闭」状态自己学出强度;JEPAPatchCrossAttentionFuser 对 query/key 各做一次 LayerNorm 后走 8 头交叉注意力,残差增量乘一个 scale 缓冲(论文正文写 $\gamma=0.2$,公开配置 input_xattn_scale: 0.5)。MoT 的「解耦」在 _make_mot_layer 里是逐层 deepcopy Qwen 解码层的 q/k/v/o 投影、q_norm/k_norm、MLP 与两个 layernorm——既保证形状 dtype 一致,又用预训练权重 warm-start 推理分支;_make_mot_forward 则把序列末尾 $K$ 个 token 路由进这套副本参数,而注意力本身仍是 V+L+查询共享的一次联合注意力。detach_alignment_target=True 保证教师目标不带梯度,_curriculum_weight 逐字实现式 (7) 的 $\alpha$ 调度。一处需要提醒复核者的差异:论文正文的 $\alpha$ 平台期为 1,而公开配置 align_loss_weight_max: 0.2、且 config 注释说明该「1005 working tree」实验用的是 ViT-Base 冻结 CLS 目标——released recipe 是论文系统的一个变体,不是逐字复现。
flowchart TD
  TRAJ["embodiment-matched trajectories
BridgeData V2 + Fractal windows
4 frames stride 2, 14D action condition"] --> S1["Stage 1 control-aligned pretraining
LeWM ViT-Tiny ~15M, Eq.1
then frozen patch supervisor
Dynamic CLS Eq.2-4, L = L_JEPA + 0.2 L_dyn Eq.5"]
  S1 --> EJ["frozen JEPA teacher E_J
CLS c_t + patch grid P_t"]
  EJ --> FUSE["patch-level fusion
2-layer MLP + cross-attention
gated residual gain gamma"]
  EJ --> TEACH["detached future CLS targets
Z+ over K=8 future frames stride 2"]
  VLA["Qwen3-VL-4B visual+language tokens"] --> FUSE
  FUSE --> MOT["MoT decoupled reasoning branch
K learnable queries, shared causal attention
separate non-embedding params"]
  MOT --> ALIGN["one-to-one future distillation
L_align Eq.6 cosine + 0.1 SmoothL1"]
  MOT --> HID["full hidden sequence V+L+reasoning"]
  HID --> FM["flow-matching DiT action decoder
16-step chunks, 4 Euler steps"]
  FM --> LVLA["L_VLA = L_FM + alpha(s) L_align Eq.7
alpha: 5k warmup / 30k plateau / 70k decay to 0.05"]
  ALIGN --> LVLA
  TEACH --> ALIGN
  LVLA --> POL["frozen Juno policy"]
  POL --> ROLL["deployment rollouts
D_ok verified success + D_fail failures"]
  ROLL --> TTT1["Juno-TTT stage 1 Eq.8
full-param world-model update on D_ok + D_fail
10 epochs AdamW 1e-6"]
  TTT1 --> EJ2["frozen adapted teacher E_J^ttt"]
  EJ2 --> TTT2["Juno-TTT stage 2 Eq.9
policy re-aligned on D_ok only
LoRA rank 32 + trainable action head, 400 steps"]
  TTT2 --> ADAPT["adapted policy Juno-TTT"]
图3 补充:三阶段流水线的数据流。同一个动作条件 JEPA 先在 embodiment 匹配轨迹上做控制对齐预训练,冻结后同时充当 patch 融合源与未来状态教师;部署期它再次解冻,先用全部转移(含失败)做动力学适配,再冻结为教师、只在验证成功的执行上重对齐策略。
Dynamics-first 测试时适配:失败只教世界
控制对齐预训练与解耦推理已经给出强冻结策略,对中等程度的背景、布局、物体实例偏移也稳健;但强观测噪声或突变光照下冻结教师本身失准,耦合的策略崩塌。Juno-TTT 的出发点是一句观察:失败的动作教不会机器人该做什么,却忠实见证了世界如何回应。失败的 rollout 仍然如实记录了「执行的动作如何改变环境」,这些转移不需要专家纠正、也不需要任务奖励就能被利用。部署缓冲被清成两个不相交子集:验证成功的转移 $\mathcal{D}_{\mathrm{ok}}$ 与失败转移 $\mathcal{D}_{\mathrm{fail}}$(轻量清洗剔除无效片段),全缓冲记为 $\mathcal{D}_{\mathrm{ttt}}=\mathcal{D}_{\mathrm{ok}}\cup\mathcal{D}_{\mathrm{fail}}$。
阶段一(动力学适配)在全缓冲上用与预训练相同的动作条件目标做全参数更新,$f_\theta$ 与 $g_\phi$ 从预训练权重出发:
$$\theta^\star,\phi^\star=\arg\min_{\theta,\phi}\;\mathbb{E}_{(o_t,a_t,o_{t+1})\sim\mathcal{D}_{\mathrm{ttt}}}\Big[\mathcal{L}_{\mathrm{pred}}\big(g_\phi(c_t,a_t),\,c_{t+1}\big)+\lambda_{\mathrm{reg}}\mathcal{R}(c)\Big], \tag{8}$$该目标只监督「执行动作的后果」,因此失败轨迹在这一阶段提供与成功轨迹完全相同的学习信号。阶段二(策略重对齐)冻结适配后的编码器 $E_J^{\mathrm{ttt}}\triangleq f_{\theta^\star}$,由它替代原教师产出未来目标 $\widetilde{Z}_t^+=E_J^{\mathrm{ttt,cls}}(o_{t+\Delta:t+K\Delta})$,策略只在 $\mathcal{D}_{\mathrm{ok}}$ 上用与训练相同的复合目标重对齐:
$$\mathcal{L}_{\mathrm{ttt}}(\psi)=\mathbb{E}_{\mathcal{D}_{\mathrm{ok}}}\Big[\mathcal{L}_{\mathrm{FM}}(\psi)+\lambda_{\mathrm{ttt}}\,\mathcal{L}_{\mathrm{align}}(\psi;\widetilde{Z}^+)\Big]. \tag{9}$$为在稀缺的测试时数据上保持稳定,策略经 LoRA 适配器更新(rank 32、$\alpha=64$、dropout 0.05,作用于主干与预测分支的注意力与 MLP 投影),预训练骨干保持冻结;动作头不用 LoRA、完全可训练;所有测试时更新用更低学习率(阶段一 10 个 epoch、AdamW 1e-6;阶段二 400 步,主干 LoRA 5e-7、其余 LoRA 与动作头 5e-6,10 步 warmup 余弦衰减到 5e-8)。两阶段的不对称是全文最锋利的一笔:动力学适配吃下每一个转移,策略重对齐只信验证成功的执行——失败的动作永远不成为模仿目标;冻结 $E_J^{\mathrm{ttt}}$ 则让对齐目标在整个策略适配期间保持不动。
实验结果
基准与实现细节
三条战线覆盖仿真与真机。SimplerEnv(WidowX):策略在 BridgeData V2 与 Fractal 的 LeRobot 格式数据上训练(53,192 / 87,212 集,采样先以 1/2 概率选源再在源内均匀抽帧),单视角 RGB 224x224,16 步动作 chunk 配 8 个步长 2 的未来帧用于潜对齐,评测为 4 次运行的均值。RoboCasa-GR1 Tabletop:24 个任务等权采样的单策略,自视角 RGB、无本体状态,29 维动作(双臂双手加腰),每任务 50 集。真机:AgileX Cobot Magic(ALOHA 式 leader-follower)右 PiPER 臂,60 条「把红立方放进蓝碗」示范(三个固定立方体位置各 20 条)初始化自 SimplerEnv 策略;评测每条件 20 次试验,且所有条件(含 in-domain)都使用示范之外的立方体位置;部署 15Hz、执行完整 16 步 chunk(约 1.07 秒)后再观测重规划,增量经阻尼最小二乘 IK 转换,IK 残差超过 0.01m 或 0.10rad 的动作被跳过。优化侧三套配方共享 Qwen3-VL-4B-Instruct + GR00T 流匹配解码器、AdamW(0.9,0.95)、余弦衰减到 5e-7、BF16、DeepSpeed ZeRO-2;Bridge/Fractal 与 RoboCasa 为 100k 步、全局 batch 128/64,主干 1e-5、预测分支与动作解码器 1e-4;PiPER 微调 50k 步、主干与预测分支走 LoRA 1e-4、动作解码器 1e-5。
SimplerEnv:对最强基线 +7.6,适配后 +11.8
| 方法 | 平均 | 勺放毛巾 | 萝卜放盘 | 叠绿块 | 茄子入篮 |
|---|---|---|---|---|---|
| OpenVLA-OFT | 41.8 | 34.2 | 30.0 | 30.0 | 72.5 |
| CogACT | 51.3 | 71.7 | 50.8 | 15.0 | 67.5 |
| VideoVLA | 53.1 | 75.0 | 20.8 | 45.8 | 70.8 |
| π0 | 53.1 | 29.2 | 62.5 | 29.2 | 91.6 |
| VLA-JEPA | 57.3 | 75.0 | 70.8 | 12.5 | 70.8 |
| π0.5 | 57.1 | 49.3 | 64.7 | 44.7 | 69.7 |
| Isaac-GR00T-N1.6-Bridge | 57.1 | 64.5 | 65.5 | 5.5 | 93.0 |
| Qwen3GR00T | 60.9 | 72.9 | 60.4 | 14.6 | 95.8 |
| Juno | 68.5 | 86.5 | 59.4 | 31.3 | 96.9 |
| Juno-TTT | 72.7 | 94.8 | 62.5 | 37.5 | 95.8 |
表1:SimplerEnv(WidowX)成功率 %,节选自论文 Table 1(4 次运行均值)。Juno 对最强基线 Qwen3GR00T 平均 +7.6 个百分点,增益集中在基线最弱的叠绿块(14.6 到 31.3)与勺放毛巾(72.9 到 86.5);萝卜放盘一列 Juno 59.4 低于 Qwen3GR00T 的 60.4 与 VLA-JEPA 的 70.8,是少数落后格。TTT 在 nominal 条件(无偏移)再抬到 72.7,说明即使没有分布偏移,策略自己的 rollout 也提供了有用的动力学监督。
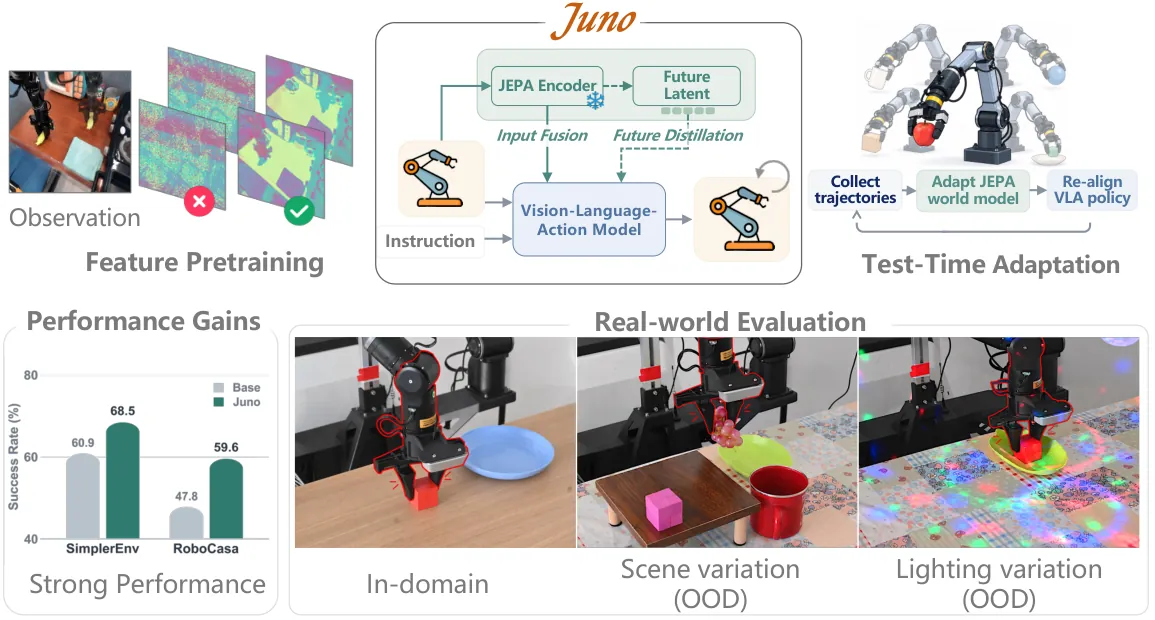
图4:全文总览(论文 Fig.1)。上排为三个角色:特征预训练(观测与 patch 图)、Juno 核心(JEPA 编码器加未来潜变量,经输入融合与未来蒸馏接入 VLA)、测试时适配(采集轨迹—适配 JEPA 世界模型—重对齐 VLA 策略);左下为 SimplerEnv 60.9 到 68.5、RoboCasa 47.8 到 59.6 的成绩柱;右下为真机三档评测快照(in-domain、场景偏移、光照偏移)。
RoboCasa-GR1:24 任务中赢下 21 个
| 方法 | PnP+Close | Cuttingboard | Placemat | Plate | Tray | 平均 |
|---|---|---|---|---|---|---|
| GR00T-N1.6 | 24.2 | 56.9 | 51.9 | 57.6 | 55.1 | 47.6 |
| Qwen3PI | 42.3 | 46.0 | 43.5 | 44.0 | 44.0 | 43.9 |
| Qwen3OFT | 43.7 | 50.4 | 41.5 | 61.0 | 49.2 | 48.8 |
| Qwen3FAST | 35.0 | 50.4 | 33.5 | 45.0 | 32.0 | 39.0 |
| Qwen3GR00T | 50.3 | 52.8 | 38.0 | 58.5 | 39.2 | 47.8 |
| Juno | 57.3 | 64.8 | 55.5 | 68.0 | 53.6 | 59.6 |
表2:RoboCasa-GR1 Tabletop 五个任务组的组内无加权平均成功率 %(论文 Table 2,平均为 24 任务总平均)。Juno 59.6 对 Qwen3GR00T 47.8、Qwen3OFT 48.8,五个组里四个第一;逐任务统计赢下 24 个任务中的 21 个。Tray 组 53.6 低于 GR00T-N1.6 的 55.1,是组级的唯一落后。
真机:冻结策略的偏移稳健性
| 方法 | In-Domain | 背景偏移 | +高度 | +高度+物体 |
|---|---|---|---|---|
| Qwen3GR00T | 40.0 (8/20) | 0.0 (0/20) | 0.0 (0/20) | 0.0 (0/20) |
| Juno | 100.0 (20/20) | 75.0 (15/20) | 70.0 (14/20) | 70.0 (14/20) |
表3:冻结策略真机评测(论文 Table 3,每条件 20 次试验,偏移累积:换桌布/立方颜色/碗形色,再抬高工作平面 10cm,再把立方换成葡萄并更新指令)。Juno 在 in-domain 20/20,基线 8/20,差 60 个百分点;三档偏移下 Juno 保持 75/70/70,基线全部归零。两策略此处均冻结,因此增益只能归于学到的表征本身。
| 方法 | 高斯观测噪声 | 动态光照 |
|---|---|---|
| Juno(冻结) | 40.0 (8/20) | 55.0 (11/20) |
| + Juno-TTT | 65.0 (13/20) | 70.0 (14/20) |
表4:真机测试时训练(论文 Table 4,每条件单独采集 40 条 rollout 并单独适配)。高斯噪声下 40 到 65、动态光照下 55 到 70;偏移越重,部署数据的边际价值越大,与「失败转移也是动力学监督」的主张一致。
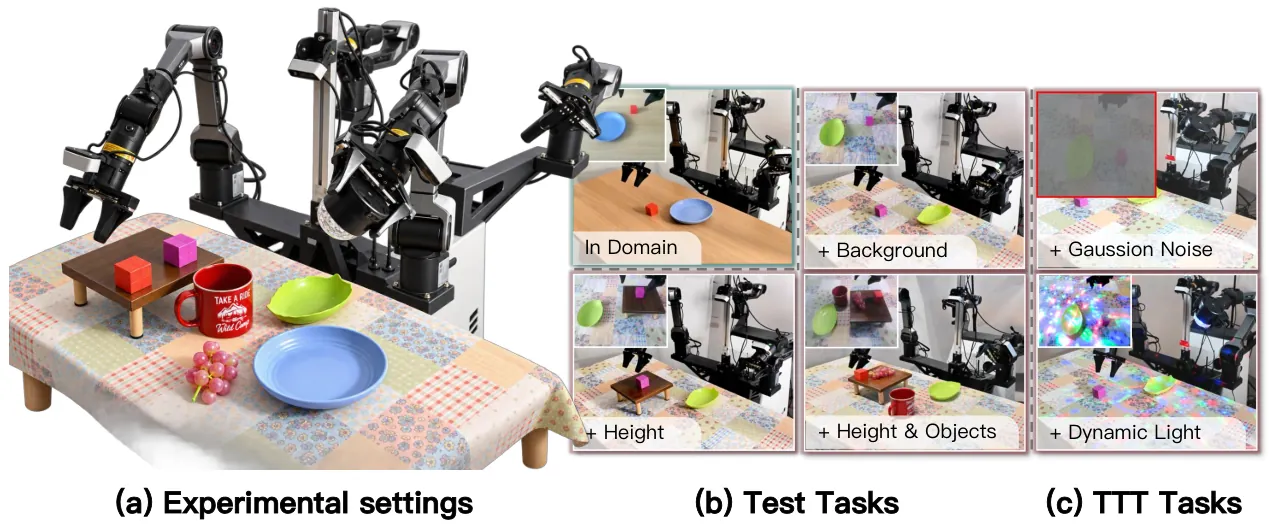
图5:真机设置与条件(论文 Fig.4)。(a) AgileX Cobot Magic 平台,仅用右 PiPER 臂;(b) 冻结策略的累积偏移条件(in-domain、+背景、+高度、+高度与物体);(c) 测试时训练的两档条件(高斯观测噪声、动态彩色光照)。
消融:融合与 MoT 是一对耦合件
| patch 融合 | MoT 分支 | L_align | L_dyn | 平均成功率 |
|---|---|---|---|---|
| 去掉 | 有 | 有 | 有 | 53.9(降 14.6) |
| 有 | 去掉 | 有 | 有 | 65.4(降 3.1) |
| 有 | 有 | 去掉 | 有 | 60.8(降 7.7) |
| 去掉 | 去掉 | 有 | 有 | 60.4(降 8.1) |
| 有 | 有 | 有 | 去掉 | 65.6(降 2.9) |
| 有 | 有 | 有 | 有 | 68.5 |
表5:SimplerEnv 留一消融(论文 Table 5)。单去掉 patch 融合跌幅最大(53.9,甚至低于基线 60.9),但融合与 MoT 一起去掉反而回到 60.4——没有接地的 patch 通路时,预测分支把未来状态目标强加在未接地的表征上,是有害的;单去掉 MoT 只跌 3.1,说明它的价值要通过融合实现。去掉 L_align 后模型与基线持平(60.8 对 60.9):预测分支只有在预测被直接监督时才帮得上忙。Dynamic CLS 贡献较小但稳定(降 2.9)。
表征分析:教师为什么合格
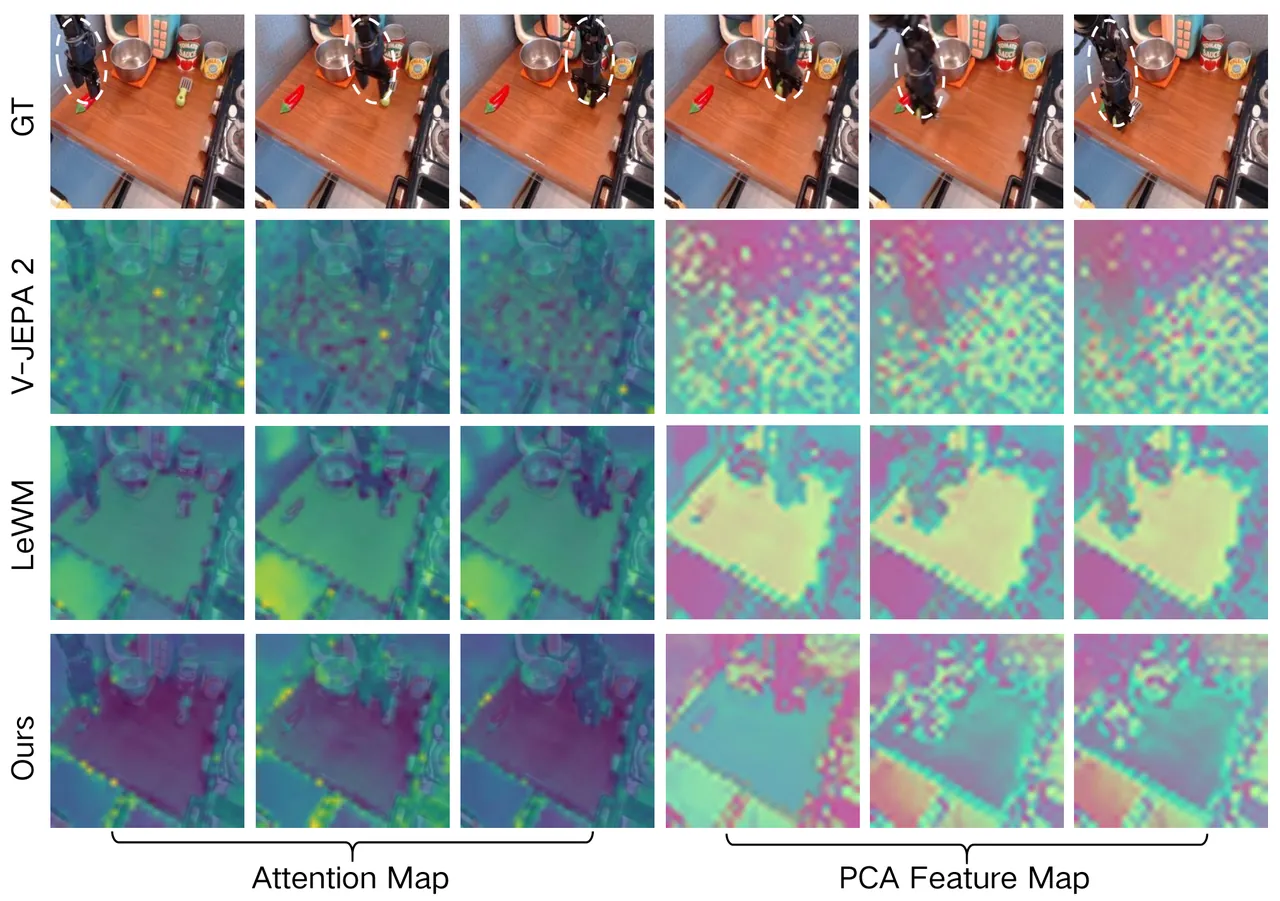
图6:空间特征结构(论文附录 A 图5)。GT 行之下依次为 V-JEPA 2、LeWM、加 Dynamic CLS 的本文编码器:V-JEPA 2 的注意力散布全场景、PCA 呈细尺度噪声状;LeWM 聚焦操作区域并能区分机器人、碗、物体与桌面;本文编码器在机器人与被操作物体边界上的注意力更集中,同时保留前景-背景分离。PCA 在各编码器内单独拟合,颜色只在同一编码器内可比。
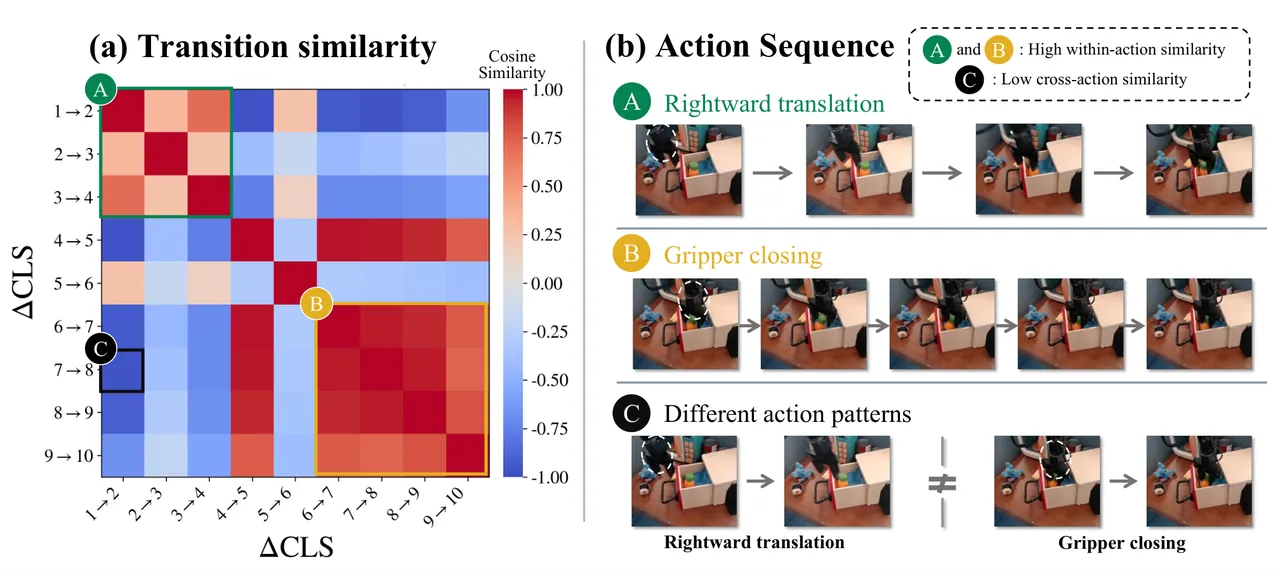
图7:CLS 转移相似度(论文附录 A 图6)。(a) 九个转移向量 $\Delta c_t=c_{t+1}-c_t$ 的两两余弦相似度:绿色块 A(右移转移 1 到 2 至 3 到 4)与黄色块 B(夹爪闭合转移 6 到 7 至 9 到 10)内部偏暖,跨模式的 C 格偏冷;(b) 对应观测序列。全局 token 的变化因此能区分动作模式、在同模式内保持一致——正是 Dynamic CLS 损失想把运动信息写进全局状态的动机。
局限性与开放问题
其一,表征分析的解释边界(作者自述)。附录 A 明确声明:这些对比「评估的是所研究控制设定下教师的适配性,并没有把预训练数据、架构与目标作为独立因素分离」;注意力与 PCA 图「指示信息在哪里被表示,但不识别下游策略实际使用的像素」;转移相似度矩阵「只刻画表征空间中的转移方向,不度量转移幅度,本身也不能隔离损失的效果」。换言之,「控制对齐」的因果证据仍是间接的。
其二,规模与 embodiment 覆盖(作者自述)。结论段承认未来工作才会在更大数据集、更广任务与多种 embodiment 上扩展训练与评测;当前真机只有一种平台、一个任务族的 60 条示范,SimplerEnv 与 RoboCasa 也各只有一种动作空间配置。冻结策略的偏移稳健性结论因此建立在单臂桌面操作这一窄切片上。
其三,组件耦合带来的调参脆弱性。消融显示 patch 融合与 MoT 分支是一对耦合件:单去掉融合跌到 53.9(低于不加组件的 60.9),两者一起去掉反而回到 60.4;去掉 L_align 后预测分支的收益完全消失。这意味着预测分支在缺乏接地通路或直接监督时是净负贡献,三个组件必须同时在场——对想复用这套结构的后来者,这是一条不便宜的调参约束。
其四,TTT 是离线协议且依赖成功判定。Juno-TTT 先采集固定 rollout、离线跑两阶段适配、再冻结评测,并非在线持续适配;SimplerEnv 上的 TTT 只在 nominal 条件测量(为隔离部署数据本身的收益),偏移条件下的收益证据只来自真机两档。阶段二还需要「验证成功的执行」这一外部判定(轻量清洗剔除无效片段),成功/失败口径一旦不可靠,$\mathcal{D}_{\mathrm{ok}}$ 与 $\mathcal{D}_{\mathrm{fail}}$ 的划分就会把错误写进教师与策略。
其五,公开复现的边界。仓库只发布 Bridge/Fractal 策略学习阶段;JEPA 预训练代码、TTT 代码与 checkpoint 在 README TODO 中未勾选,docs/reproducibility.md 明说 README 成绩是论文报告值、不应在跑过规定数据切分与评测协议之前归于这份代码。且公开配置与论文正文存在可查的差异(对齐权重上限 0.2 对 1、交叉注意力 scale 0.5 对 0.2、ViT-Base 冻结 CLS 目标对 ViT-Tiny 教师),逐字复现论文数字需要额外的未公开资产。
总结与展望
Juno 的贡献不是又一个世界模型接口,而是把「同一个动作条件 JEPA」用成了三件不同的工具:预训练期它被 Dynamic CLS 损失塑形,让紧凑的 CLS 状态带上 patch 级运动;策略学习期它冻结为教师,经 patch 融合与 MoT 解耦分支把未来状态蒸馏进动作生成,且对齐梯度与动作梯度在同一条隐序列上汇合;部署期它再次解冻,先吃下全部转移(含失败)做动力学适配,再冻结为教师、只让验证成功的执行触碰策略。SimplerEnv 68.5(TTT 72.7)、RoboCasa 59.6、真机冻结 100/75/70/70 对基线 40/0/0/0 的成绩,加上「失败只教世界」的消融与 TTT 增益,让这条「预测性潜变量必须被控制问题驯服」的主张有了可复核的证据链;公开的策略学习阶段代码与逐条可查的配置,则把复核门槛压到了同类工作里较低的一档。下一步的问题也很清楚:控制对齐能否在跨 embodiment 的规模上保持、TTT 能否在线化并摆脱成功判定的外部依赖、以及这套潜空间教师能否长出可供规划与检视的高保真未来。
金句:失败的动作教不会机器人该做什么,却忠实见证了世界如何回应——Juno 让同一个 JEPA 在预训练、策略学习与部署三处各尽其职,把部署期的每一次失败都变成动力学模型的教材,而只让验证过的成功触碰策略。