PAPER DEEP DIVE
SuperNav:面向任意任务与任意场景的智能体导航系统
SuperNav 给一个预训练多模态大模型套上专用 agent harness,全程不做导航微调:MLLM 只负责解读请求、理解场景与做决定,移动交给可替换的运动后端(几何执行器 / 学习执行器),两者由统一的视觉点接口连接——模型直接在观测图像中点出目的地,并从执行反馈中修正决定。harness 另提供 Navigation Skills、面向 agent 的工具、任务进度记录与上下文管理,以支撑长程交互。在 Habitat-GS 单目标 / 有序多目标 / 需求驱动任务上成功率达 78.00% / 34.00% / 59.50%(最强基线分别为 34.00% / 4.00% / 37.50%),HM3D-OVON 120 集 val-unseen 上 1 m 阈值取得 73.33% SR / 0.4105 SPL,并在 Unitree Go2 四足真机上完成搜索与多目标拜访演示。
SuperNav: An Agentic Navigation System for Any Task in Any Scene
Jinkai Zhang、Jingyi Xu、Yuanhong Yu、Jiarui Guo、Hujun Bao、Xiaowei Zhou、Sida Peng†(浙江大学 / 深圳大学 / Causa Robotics,† 通讯作者)
arXiv:2610.12126v1 [cs.RO],提交于 2026-10-08 · arXiv:2610.12126 · 项目页 · 代码仓库 zju3dv/SuperNav(许可证为自定义 Other)
代码状态:agent 运行时、导航工具与 Skills、实验配方与评测已开源,Learned Executor 权重在 HuggingFace the0xka1/SuperNav-Learned-Executor,InteriorGS 单目标/多目标测试集在 yyh929/HabitatGS-Benchmark;README 的发布清单里「AI2-THOR 需求驱动基准」与「真机(Unitree Go2)部署」两项仍未勾选,仓库不含真机驱动。
一句话总结
SuperNav 不做导航微调,而是给一个现成的多模态大模型套上专用 agent harness:MLLM 只负责解读请求、看懂场景、做决定,移动交给可替换的运动后端;一个统一的视觉点接口让模型直接在观测图像里点出目的地,再从执行反馈里修正决定。在单目标导航上它拿到 78.00% 成功率(最强基线 UniNaVid 只有 34.00%),需求驱动导航 59.50%(OmniNav Action Former 37.50%),HM3D-OVON 120 集 val-unseen 上 1 m 阈值 73.33% SR / 0.4105 SPL,并在真机 Unitree Go2 上跑通。
一、问题:任务泛化与场景泛化,被两条老路各自卡住
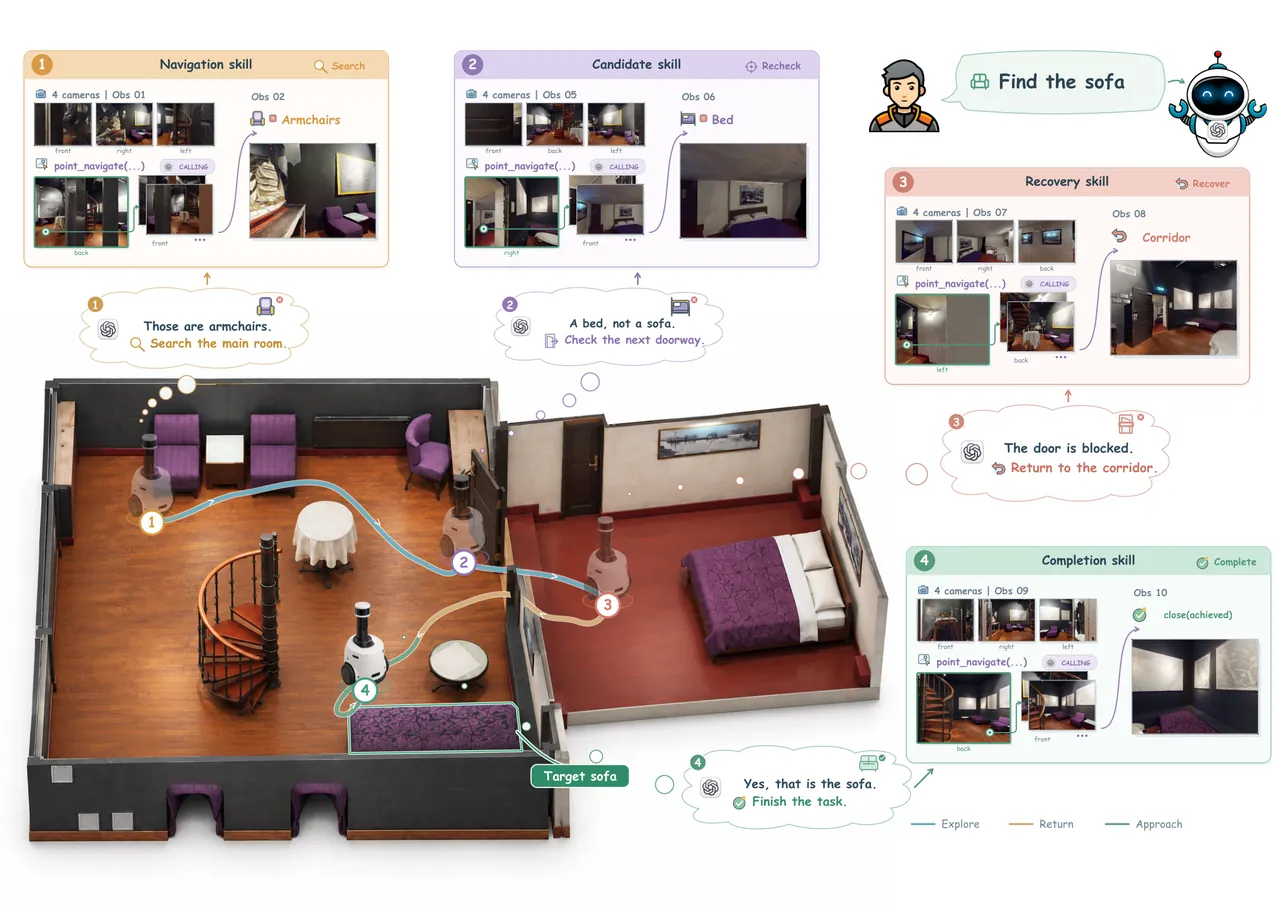
图1(论文 Fig.1):Skill 引导的沙发搜索。Agent 复核候选、从被堵的门洞恢复、并验证任务是否完成——整个闭环由 MLLM 的判断驱动。
通用服务机器人需要的导航,不是「走到坐标」,而是「满足一句人话」。找某个特定物体、按顺序拜访多个目标、或者「找个能歇脚的地方」这类高层需求,差别不只在找什么,还在怎么探索、怎么记账、怎么判定完成。论文把这种能力拆成两维:任务泛化(适配不同请求)与场景泛化(在训练和开发时没见过的环境里照样工作)。
模块化零样本导航(SemExp、VLFM、ApexNav 一类)用预训练视觉语言模型给观测打语义相关分,再喂给目标导向的探索分数。分数能跟着新观测自适应,但任务逻辑是写死的:模型何时参与、探索何时切换到目标确认、执行何时结束,都由流水线预先规定。请求一旦从「找类别」变成「找实例」「拜访多个」「满足抽象需求」,目标解读、进度跟踪、完成条件全都变了,这套工作流就得跟着改。
端到端方法(NaVid、UniNaVid、StreamVLN 一类)想在单一模型里覆盖多种任务,但泛化被导航训练数据的覆盖面锁死:它们在「指令—轨迹」配对上微调预训练 VLM,学到的是观测、指令、行为之间的关联;换一种视觉外观、空间布局、交互条件,这些关联是否还有用就成了问题。论文的跨环境评测直接给出了证据——被评方法在没见过的环境里任务完成率大幅塌方(见第四节)。
SuperNav 的出发点是一条分工原则:让 MLLM 用它已有的通用能力去解读请求、理解视觉观测、推理下一步动作,而把运动执行外包给导航工具,全程不对 MLLM 做任何导航微调。这个思路借鉴了通用 computer-use agent 的成功经验——harness 支撑持续的工具调用与上下文管理。于是「适配新请求、新场景」不再靠改模型或改流水线,而靠 MLLM 在运行时自己选择、组合可用能力。
二、Harness 的三块积木:Agent 循环、面向 agent 的工具、Navigation Skills
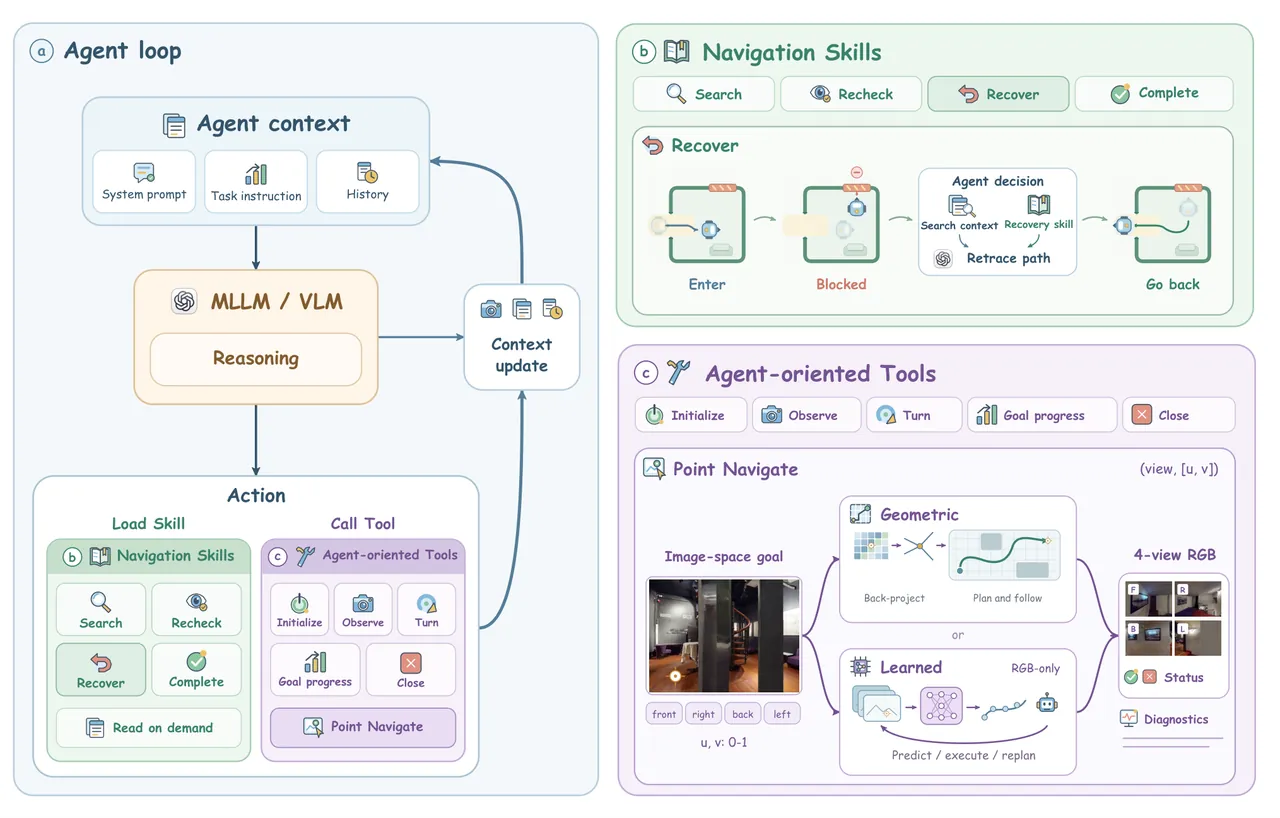
图2(论文 Fig.2):(a) Agent 循环为 MLLM 推理维护上下文、Skill 加载与工具调用;(b) Navigation Skills 指导搜索、候选复核、恢复与完成;(c) 面向 agent 的工具支撑观测、运动、目标进度与任务收尾,点导航在几何与学习两类后端之间共享同一套图像空间目标接口。
Agent 循环把请求、视觉观测、交互历史组织成一个持续推进的过程。初始化打开会话、返回第一帧观测,MLLM 据此解读目标与完成条件;之后每一步,它结合当前上下文与任务进度,在「观测、移动、更新目标状态、读 Skill」之间选一个操作。工具返回与检索到的指令进入上下文,供下一步决策——执行反馈因此能真正改变计划:靠近一个候选后,MLLM 检查新图像、判断它是否满足请求,要么记录完成、要么继续找。
长程执行要求局部决定与早期证据、未完成目标保持连接。目标记录维护「待找/已找到」清单,文本交互历史保留看过的区域、候选线索、失败尝试。为控制不断膨胀的图像上下文,harness 采用只剪媒体的策略:一张图像一旦被处理、被更新的观测取代,就从后续请求里移除其媒体载荷,但保留文本历史、任务状态与图像路径,MLLM 需要时可以回工作区取旧图。这样既省了重复传图,又不丢证据。
面向 agent 的工具是 MLLM 决策与可执行环境操作之间的桥。工具集覆盖初始化、观测、转向、视觉点导航、目标进度管理、收尾。设计原则是「输入让 MLLM 好填、返回对下一步决策有用、目的地表示在各运动后端间保持一致」。核心观测—运动接口把这两条原则落到实处:一次观测返回相对机器人航向标记为 front / right / back / left 的四张 RGB 图;MLLM 通过
$$\mathrm{PointNav}(d,\,[u,v]),\qquad u,v\in[0,1] \tag{1}$$
选定目的地,其中 $d$ 指认视图,$[u,v]$ 是从该图左上角归一化的水平、垂直坐标。Agent 可以点候选物体,也可以点可见地面,用于接近目标或换取新视角。工具在内部执行移动,并返回新的四视图、执行状态与简明诊断;转向工具返回同类型反馈。于是「选点」与「视觉复核」被直接连起来,不必每次移动后单独再调一次观测。
可替换的运动后端是视觉点接口的红利:选点与执行机制解耦。几何后端(Geo-based Executor)用深度、相机标定与位姿把选中的像素关联到环境位置,再规划并跟随一条到可达目标的路径;仿真用渲染深度与导航网格,真机用感知几何与定位。学习后端(Learned Executor)受 NoMaD 的目标条件生成式策略启发,但把「目的地图像目标」换成「参考观测上的标记点」,从选中的图像—点对与近期 RGB 观测预测局部位移增量与停止信号。两个后端都接受视觉目的地、都返回带执行反馈的观测,因此 Agent 的决策工作流完全不变。
Navigation Skills把可复用的导航经验组织成 MLLM 按需读取的程序性指导。每个 Skill 是一个 Markdown 包,描述适用情形、要检查的证据、推荐步骤与链接引用;整捆包含主导航 Skill、按后端的工具使用说明、以及探索/恢复/入口搜索等引用,覆盖搜索、恢复、完成三类反复出现的决策。harness 暴露 Skill 的名字与描述供 MLLM 发现,再把它或它的引用加载进决策上下文。关键是:Skill 只通过进入上下文来影响决策,不增加环境能力、也不在程序上强制动作序列或语义判断——每一步操作仍由 MLLM 依据当前请求与反馈自己选。
flowchart TD
    REQ[human request] --> INIT[open session and first 4-view observation]
    INIT --> LOOP{agent loop}
    LOOP -->|read| SKILL[Navigation Skills markdown guidance]
    SKILL --> LOOP
    LOOP -->|observe| OBS[4-view RGB front right back left]
    OBS --> LOOP
    LOOP -->|PointNav d u v| NAV[motion backend]
    NAV --> GEO[Geo-based Executor depth and navmesh]
    NAV --> LEARN[Learned Executor flow policy]
    GEO --> FB[new 4-view plus status and diagnostics]
    LEARN --> FB
    FB --> LOOP
    LOOP -->|update| PROG[goal progress pending or found]
    PROG --> LOOP
    LOOP -->|prune media only| CTX[context keeps text history state image paths]
    CTX --> LOOP
    LOOP -->|judge satisfied or blocked| CLOSE[termination tool closes session]
三、判定口径:什么叫「到了」,什么叫「完成」
实例级任务的到达判据是导航网格测地距离。对目标 $g$,设 $V_g$ 为其批准的视点集合,$d_{\mathrm{nav}}$ 为场景导航网格上的最短测地距离,位置 $p$ 处到达要求
$$\min_{v\in V_g} d_{\mathrm{nav}}(p,\,v) < 1\,\mathrm{m}. \tag{2}$$
单目标成功要求最终保存位置满足该测试并显式 STOP;多目标成功要求保存的轨迹位置按顺序满足各目标、随后显式 STOP,早期目标不必仍留在终点附近。评测在每阶段用 Habitat 的 MultiGoalShortestPath 检查完整批准视点集,不在保存位置之间插值;初始位置可以满足某个目标,一个位置也可以连续满足多个阶段。评分在执行之后进行,不作为策略反馈返回——这一点把「评测」与「策略能看到的信号」严格分开。
SPL 的参考路径用数据集自带的全局参考:多目标任务按固定目标顺序、在批准视点上的最短路线,用动态规划算出;单目标任务局部与全局参考重合。参考到达视点位置本身,不缩短到 1 m 到达区域;当参考长度非零时分子封顶使 SPL 不超过 1。所有方法在每个任务上共享同一参考,SR 与 SPL 在每套 150 个任务上平均;失败任务 SPL 记 0。
四、Learned Executor:把「图像里一个点」变成一串局部位移
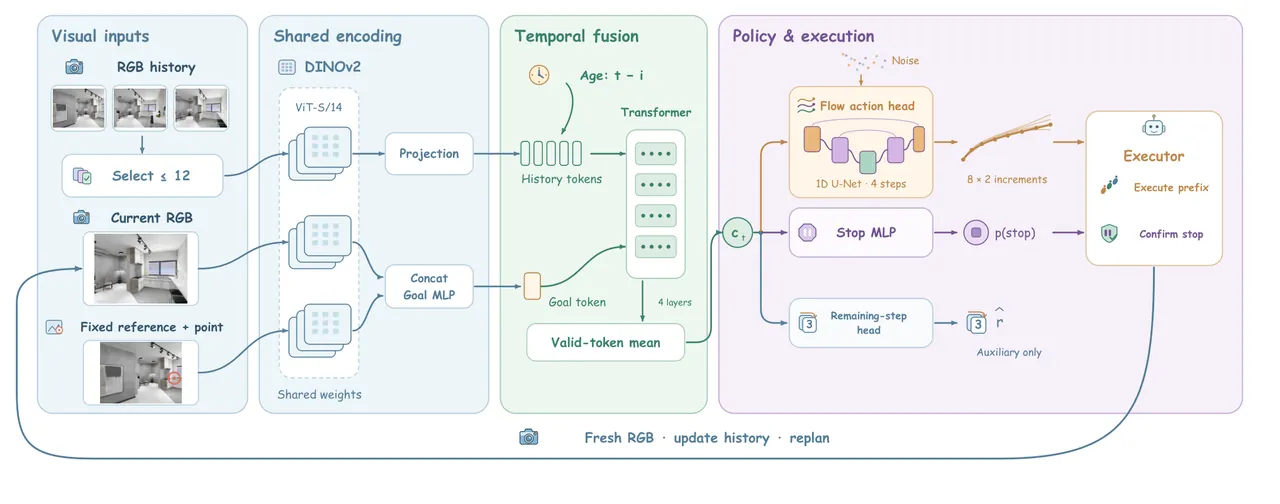
图3(论文 Fig.6):Learned Executor 架构。固定参考图像上选中的点与有界、年龄感知的 RGB 历史融合;策略预测位移增量与停止分数;执行器把增量转成运动并返回新观测供重规划。
一个局部请求指定一张参考 RGB 图 $I^{\mathrm{ref}}$ 与一个归一化像素 $q\in[0,1]^2$,二者在整个请求期间保持不变,而当前观测 $I_t$ 随运动变化。图像缩放到 $224\times 224$,在 $q$ 处画一个带中心点的红环得到 $\widetilde{I}^{\mathrm{ref}}=\mathrm{Mark}(I^{\mathrm{ref}},q)$;用 ImageNet 统计归一化后,由共享的 DINOv2 ViT-S/14 骨干 $\phi$ 编码,产出 384 维全局特征。观测投影与目标 MLP 产出 256 维 token:
$$z_i = W_o\,\phi(I_i),\qquad g_t = \mathrm{MLP}_g\!\left([\phi(I_t);\ \phi(\widetilde{I}^{\mathrm{ref}})]\right). \tag{3}$$
目标 MLP 的维度为 $768\to 256\to 256$,线性层之间夹一个 ReLU。$g_t$ 把当前特征与标记参考特征拼起来,于是固定目的地与当前视角的关系仅由 RGB 输入建立,不需要深度或网格。
机器人一动,选中的目的地可能离开当前视野,早期观测就成了有用上下文。在观测索引 $t$ 处选一个历史索引集 $\mathcal{S}_t$,含初始帧与当前帧,$K_t=|\mathcal{S}_t|\leq 12$。选取从步长 2 的序列加当前帧开始;超预算时反复对较老的一半做稀释、保留端点,从而在整个局部请求内保留观测、且越靠近现在采样越密。因为被选帧不等间隔,用投影正弦嵌入 $\psi$ 编码每帧年龄:
$$h_i = z_i + \psi(t-i) + e_o,\qquad c_t = \mathrm{Mean}_{\mathrm{valid}}\!\left(\mathrm{Transformer}\big([\{h_i\}_{i\in\mathcal{S}_t};\ g_t+e_g]\big)\right). \tag{4}$$
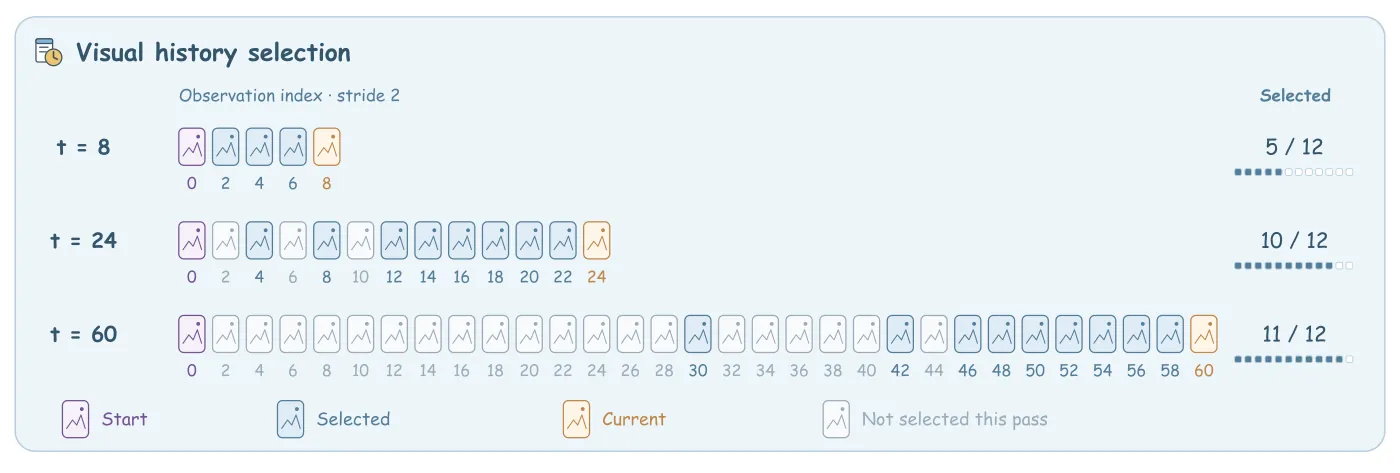
图4(论文 Fig.7):可变长度视觉记忆。每行在共享观测索引轴上列出所有步长 2 候选;彩色为本次融合选中,灰色本轮省略但仍留在历史里。对较老候选半区反复稀释,把输入限制在最多 12 个观测:$t=8,24,60$ 时分别选 5、10、11 帧。
融合用一层宽 256、前馈 1024 的四层四头 Transformer;padding 不参与注意力与池化,目标 token 参与均值。推理时投影图像特征在加年龄嵌入之前缓存,于是被选帧可以带着更新后的年龄复用。12 观测预算作用于每次融合,特征缓存则保留局部请求内更早的观测。
策略预测 8 个二维位移增量,全部在预测时刻的机器人坐标系下表达(前为 $x$、左为 $y$)。设 $P$ 为专家地平面位置、$T$ 为目标帧索引、$R_t$ 为世界平面位移到 $t$ 时刻机器人坐标系的变换,归一化训练目标为
$$A_k = \mathrm{clip}\!\left(\frac{R_t\big(P_{\min(t+k,\,T)} - P_{\min(t+k-1,\,T)}\big)}{0.25\,\mathrm{m}},\ -1,\ 1\right),\quad k=1,\ldots,8. \tag{5}$$
clip 逐分量进行,终点之后的增量置零。预测乘 0.25 m 即得米制位移增量;在固定预测坐标系下累加即得相应相对路点。一个一维 U-Net 以融合视觉表征 $c_t$ 为条件生成增量序列;按 flow matching,在归一化序列 $A$ 与高斯噪声 $\epsilon$ 之间插值并回归对应流速度:
$$x_\tau = (1-\tau)A + \tau\epsilon,\qquad \mathcal{L}_{\mathrm{flow}} = \frac{1}{16}\,\mathbb{E}\!\left[\left\|v_\theta(x_\tau,\tau,c_t) - (\epsilon - A)\right\|_F^2\right], \tag{6}$$
其中 $\tau\in[0,1]$,系数 $\tfrac{1}{16}$ 对序列分量取平均;流网络内部接收重缩放后的时间。为做无分类器引导,10% 的训练样本把目标 token 换成学到的 null token、但保留观测历史。另有独立头从 $c_t$ 预测停止概率 $p_t$ 与辅助剩余步数估计 $\hat r_t$;监督用专家观测索引间隔 $r_t=T-t$ 与停止标签 $y_t=\mathbf{1}[r_t\leq 2]$(间隔含转向原语)。总目标为
$$\mathcal{L}_{\mathrm{flow}} + 0.5\,\mathcal{L}_{\mathrm{stop}} + 0.002\,\mathcal{L}_{\mathrm{remaining}}, \tag{7}$$
停止用正类权重 3 的二元交叉熵,剩余间隔用平方误差。训练 45,000 步、全局批 256、AdamW,策略层学习率 $10^{-4}$、预训练视觉骨干 $10^{-5}$,权重衰减 $10^{-6}$,500 步 warmup 后余弦衰减;bfloat16 混合精度、梯度范数裁剪 1、EMA 衰减 0.999;视觉骨干与策略联合微调,推理用平均权重。
闭环执行时,新目标先保存参考图并把机器人对齐到该视图的采集方向。每次重规划从 $x_1\sim\mathcal{N}(0,I)$ 出发、走四步 Euler:
$$x_{\tau-1/4} = x_\tau - \tfrac{1}{4}\,v_{\mathrm{guided}}(x_\tau,\tau,c_t),\qquad v_{\mathrm{guided}} = v_u + 2\,(v_c - v_u), \tag{8}$$
其中 $v_c$ 保留目标 token、$v_u$ 用 null 目标配同一观测历史。执行器从 16 条采样序列里按「端点方向一致性 + 路径直度」选一条;选中的增量乘 0.25 m 后通常只执行前三个增量,每个增量的方向与长度决定航向变化与行进距离,由仿真适配器拆成「先转后走」的原语序列。随后取新 RGB 观测、朝同一参考目标再预测一轮。当 $p_t\geq 0.1$ 在至少连续两次重规划调用上成立、且运动进度条件满足时,确认局部停止;该条件要求(i)累计至少执行 4 个原语、且当前连续段内自首个超阈预测起至少 3 个,或(ii)上一周期未执行原语。低于阈值的预测会重置连续段;辅助剩余步数估计不参与停止门控。
五、实验:四类任务、两种后端、一张真机
主实验用 GPT-5.6 Terra 配 Geo-based 或 Learned Executor,报告 SR(%) 与 SPL(0–1)。Habitat-GS 与 AI2-THOR 上对比 NaVid、UniNaVid、StreamVLN 与 OmniNav 的 Action Former,各基线保留原生输入与历史机制(表 2 给出其观测配置)。仿真侧 Habitat-Sim 提供 $640\times 480$ RGB-D、水平视场 $90^\circ$、相机高 1.25 m;InteriorGS 评测中 MLLM 收到的图像为 $256\times 192$。Geo-based Executor 默认 standoff 0.7 m、候选吸附距离上限 0.75 m、follower 目标半径 0.3 m、200 步 follower——这些局部执行上限与基准成功阈值是两回事。
表 1(论文 Table 1):单目标 / 多目标 / 需求驱动导航结果。实例任务用视点测地距离 <1 m;需求驱动用 2 m 包围盒区域;括号内为任务数。
| 方法 | 单目标 SR | 单目标 SPL | 多目标 SR | 多目标 SPL | 需求驱动 SR | 需求驱动 SPL |
|---|---|---|---|---|---|---|
| NaVid | 24.67 | 0.1599 | 2.67 | 0.0216 | 17.00 | 0.0920 |
| UniNaVid | 34.00 | 0.1833 | 1.33 | 0.0131 | 25.00 | 0.0943 |
| StreamVLN | 13.33 | 0.1036 | 0.00 | 0.0000 | 25.50 | 0.0775 |
| OmniNav (Action Former) | 27.33 | 0.2133 | 4.00 | 0.0275 | 37.50 | 0.1213 |
| SuperNav + Geo-based | 78.00 | 0.4127 | 34.00 | 0.1388 | 59.50 | 0.1801 |
| SuperNav + Learned | 68.00 | 0.2059 | 34.00 | 0.0862 | 45.00 | 0.1603 |
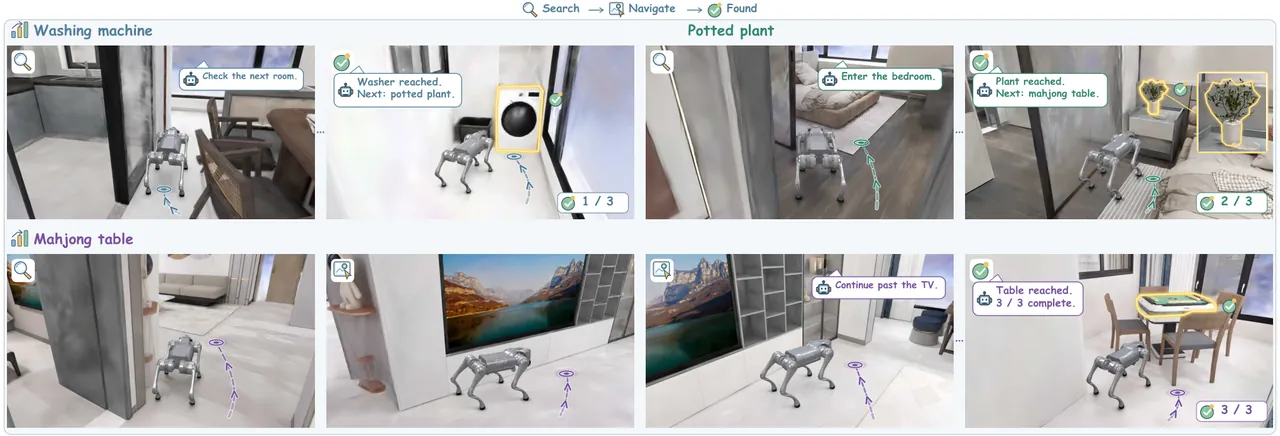
图5(论文 Fig.3):仿真中的有序多目标导航。Agent 依次拜访洗衣机、盆栽与麻将桌。
单目标上 Geo-based 的 78.00% 对最强基线 34.00%,是 2.3 倍;需求驱动上 59.50% 对 37.50%。多目标上两种后端 SR 相同(34.00%),但 Geo-based 路径更高效(SPL 0.1388 对 0.0862)。有序进度(论文 Table 4)显示 SuperNav 在多目标每个阶段都领先:SR5 上 Geo-based 39.47%、Learned 34.21%,而四个基线全为 0.00——基线在第五个目标上完全失效,说明「按序完成长链条」正是端到端微调方法的软肋。需求驱动侧 Geo-based 在前五个阶段领先(SR5 24.32%),但六阶段及以上无人完成: eligible 任务里六/七/八阶段分别只有 3/2/1 个,长序列仍是开放问题。
表 2(论文 Table 2 节选):HM3D 类别级导航。阈值为最终位置到最近目标视点的最短可导航路径距离;外部条目为已发表结果。
| 方法 | OVON 0.25m SR | OVON 0.25m SPL | OVON 1m SR | OVON 1m SPL | HM3Dv2 0.2m SR | HM3Dv2 1m SR |
|---|---|---|---|---|---|---|
| MTU3D | 40.80 | 0.1210 | — | — | — | — |
| SoftNav | 66.70 | 0.2570 | — | — | — | — |
| AstraNav-Memory | — | — | 62.50 | 0.3490 | — | — |
| ApexNav | — | — | — | — | 76.20 | — |
| MSGNav | — | — | — | — | — | 74.10 |
| SuperNav + Geo-based | 68.33 | 0.3837 | 73.33 | 0.4105 | 80.30 | 86.50 |
| SuperNav + Learned | 65.00 | 0.1355 | 70.83 | 0.1443 | 79.00 | 85.40 |
在 120 集 HM3D-OVON val-unseen 上,SuperNav 不做任何 OVON 专用训练或适配,1 m 阈值拿到 73.33% SR / 0.4105 SPL,0.25 m 阈值 68.33% / 0.3837。Learned Executor 保住了大部分成功率但丢路径效率(SPL 0.1355 / 0.1443)。论文特意说明:MTU3D、AstraNav-Memory 与 OmniNav 慢系统的 A-star 分支,用的正是与 Geo-based Executor 同源的导航网格路径查询 + follower 机制,因此主对比选 Geo-based;而已发表结果的评测子集与协议与本文不同,横向读数需谨慎。
表 3(论文 Table 3 + Table 6):OVON 消融与交互统计。每变体 120 集、GPT-5.6 Terra (high),除非注明;Table 6 的均值含全部 120 集(成败都算)。
| 变体 | 0.25m SR | 0.25m SPL | 1m SR | 1m SPL | 调用数 | 其中导航 | 转向 | 路径(m) |
|---|---|---|---|---|---|---|---|---|
| w/o Navigation Skills | 35.00 | 0.2460 | 54.17 | 0.3894 | 7.43 | 5.33 | 0.10 | 7.56 |
| w/o Agent-oriented Tool Design | 52.50 | 0.2230 | 65.83 | 0.2855 | 30.28 | 10.72 | 17.56 | 23.60 |
| w/o Skills and Tool Design | 31.67 | 0.1870 | 54.17 | 0.3417 | 15.37 | 5.61 | 7.72 | 10.47 |
| Grounding Motion Tool | 55.83 | 0.3201 | 62.50 | 0.3624 | — | — | — | — |
| SuperNav (GPT-6 Astra medium) | 71.67 | 0.4579 | 79.17 | 0.4974 | — | — | — | — |
| SuperNav (GPT-5.6 Terra high) | 68.33 | 0.3837 | 73.33 | 0.4105 | 11.17 | 8.76 | 0.41 | 16.44 |
消融读出了三条清晰的结论。其一,去掉 Navigation Skills 的杀伤力大于把接口限制为前视:0.25 m 阈值 SR 从 68.33% 掉到 35.00%,而仅前视(保留 Skills)掉到 52.50%——程序性指导比四视图本身更值钱。其二,工具设计与 Skills 互补:保留 Skills 但只给前视时,SR/SPL 下降且显式转向次数暴涨(17.56 对完整版的 0.41),调用数从 11.17 涨到 30.28、路径从 16.44 m 涨到 23.60 m——Agent 被迫用「转一圈」代替「直接看」。其三,外部语言接地不如 Agent 自己点:基于 LocateAnything 的 Grounding Motion Tool(55.83% / 62.50%)低于直接点选(68.33% / 73.33%)。最后是模型可替换性:harness 不动、把 Terra(high) 换成 Astra(medium),SR 与 SPL 反而都升(71.67% / 79.17%),说明这套 harness 与决策模型是解耦的。
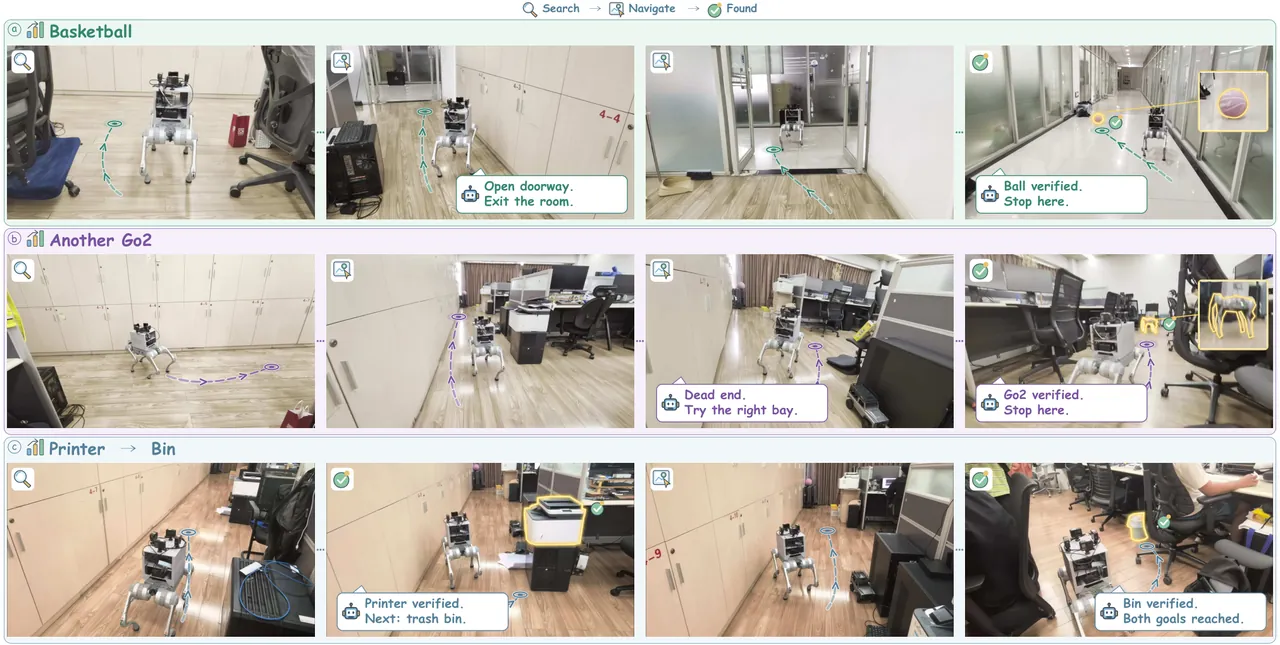
图6(论文 Fig.5):Unitree Go2 真机导航。机器人搜索 (a) 一个篮球、(b) 另一台 Go2,并 (c) 先拜访打印机再拜访垃圾桶。
真机侧,Go2 用四个方向 RGB 相机加机器人自带 LiDAR 与里程计做几何执行:相机内参、安装外参与观测对应的机器人位姿把图像空间目标关联到 LiDAR 地图;体素栅格地图把 LiDAR 累积成基于高度的二维通行代价图,体素与栅格分辨率默认 0.05 m;ReplanningAStarPlanner 规划路径,前视 follower 用比例航向控制以 10 Hz 输出线速度/角速度指令;定位直接用机器人上报里程计,软件里没有额外的闭环 SLAM。SuperNav 在被堵通道处改线、复核目标、在目标间切换,验证了 harness 从仿真到真机的可迁移性。
六、运行时:Codex CLI + MCP,以及一组硬超时
Agent 循环用 Codex CLI 实现,环境操作通过 MCP 暴露。每个非交互 Codex 进程带任务专属工作目录与 CODEX_HOME 启动,内含配置、Skill 快照与日志;原生 Skill 加载需要文件系统读,执行用 danger-full-access 并关闭交互审批。指令层要求只读访问规定 Skill 包、场景感知与动作必须走 MCP 工具,禁止用文件系统或 shell 窥探场景资产、真值标注、轨迹与评测元数据;MCP 白名单限制暴露的环境工具。基准配置设 3,600 s 每次 Codex 执行、180 s MCP 启动、300 s 每次工具调用;harness 只在成功收尾后接受 hab_close_session 的 achieved/blocked 结论,缺失或失败收尾单独记录,批处理 runner 在继续下一任务前处理超时等异常。Skill 快照清单记录文件清单、文件哈希与整捆哈希,安装或复用前校验;可见性探针校验被发现的名字、描述与源路径,失败即阻断启动。
七、局限与风险
作者自述的局限。SuperNav 的语义判断完全依赖底层 MLLM,因此被其能力上限锁死;几何执行依赖可得地图或场景几何;MLLM 推理带来计算开销与显著的时延波动,使任务时长难以预测;需求驱动评测度量的是「按序导航到相关目标」,而非底层活动本身的完成;扩展到更多真机场景、提升长导航序列的可靠性是未来方向。
本文视角的补充局限。其一,多目标与长链条仍是明显短板:多目标 SR 仅 34.00%(即便单目标 78.00%),需求驱动六阶段及以上全部为 0——harness 解决了「判断」的泛化,但没有解决「长程序贯执行」的可靠性,进度记账越往后越容易漂。其二,成本与可复现性:每个 episode 预算 3,600 s、决策走商用 MLLM API,评测的重放成本与供应商耦合度高;论文自己也承认时延波动使任务时长不可预测,这对真机部署是实打实的工程障碍。其三,横向对比的协议异质性:HM3D 表里外部结果的子集、阈值、步数预算各不相同(500/2000/4000 动作、0.25/1/0.2 m),论文虽做了说明,但单表读数仍易被误读为同协议对比。其四,真机部分只有定性演示(图6),没有真机定量基准,几何后端对 LiDAR+里程计的依赖在无结构户外场景是否成立未经验证。
八、代码与可复现性
仓库 zju3dv/SuperNav 提供 agent 运行时、导航工具与 Skills、实验配方与评测工具,面向 Habitat-GS 与 AI2-THOR;CLI 为 supernav,内置浏览器 demo(supernav web --demo)。发布清单已勾选:运行时/工具/Skills/配方/评测、Learned Executor 权重(HuggingFace the0xka1/SuperNav-Learned-Executor)、InteriorGS 单/多目标测试集(yyh929/HabitatGS-Benchmark,各 150 集带参考轨迹);未勾选:AI2-THOR 需求驱动基准、真机部署(仓库无真机驱动)。 bundled 配方默认用 gpt-6-astra + medium 推理;任务清单与真值与源码包分开分发。对想复现主表数字的读者,注意 InteriorGS 场景资产需从 spatialverse/InteriorGS 另取并做转换,Habitat 需独立 venv 装 CUDA SDK。
九、总结
SuperNav 的贡献不在某个更强的导航模型,而在一条清晰的职责划分:把「解读请求、理解场景、做决定」留给预训练 MLLM 的通用能力,把「移动」下沉为可替换的工具,再用视觉点接口、进度记账、上下文剪枝与 Markdown Skills 把两者缝合成一个能持续工作的 agent。它用 78.00% / 59.50% / 73.33% 三组数字说明:不做导航微调,也能在实例级、多目标、需求驱动与类别级任务上全面超过微调派与模块化派;用 Astra 替换 Terra 仍涨点说明 harness 与模型解耦;用 Go2 真机说明接口从仿真到现实可迁移。它同时诚实地暴露了长程序贯执行与 MLLM 时延这两道还没跨过去的坎——而这恰恰是 agentic 导航下一步真正的主战场。
金句
「Our key insight is to let the MLLM focus on interpreting requests, understanding scenes, and making decisions while preserving its general-purpose capabilities and delegating motion execution to navigation tools.」——把判断留给通用模型、把移动交给工具,是 SuperNav 全部设计的原点。