PAPER DEEP DIVE
MultINav:超越可达性的交互式导航基准与智能体框架
MultINav 统一「开门改变连通、开容器改变可见」两类交互及其顺序依赖,发布 3000 回合 MultINav-Bench 与三阶段智能体 MultINav-Agent;混合任务成功率 24.1%,较 MoMa-LLM 提升 22.4 个百分点。
论文:Interactive Navigation Beyond Reachability: Benchmark and Agentic Framework(arXiv:2610.17089v1,cs.RO,2026-10-12)
代码:github.com/ZGCA-HMI-Lab/MultINav · 项目页:zgca-hmi-lab.github.io/MultINav · 数据集:huggingface.co/datasets/Piqiuni/MultINav-Bench
一句话总结
MultINav 把「交互」请回导航任务:一扇关着的门可能切断通往目标的唯一路径,一个关着的冰箱可能藏着近在咫尺的目标——论文统一了「开门改连通、开容器改可见」两类交互及其顺序依赖,发布了 3000 回合的 MultINav-Bench 基准,并提出基于持久交互图的三阶段智能体,在混合任务上把成功率从 MoMa-LLM 的 1.7% 提到 24.1%。
研究背景与动机
PointGoal、ObjectGoal 和视觉语言导航推动了具身导航的持续进步,但这些任务测的是定位、建图、搜索与指令跟随,普遍默认一件事:episode 内机器人的可通行性和物体状态保持不变。这个抽象漏掉了室内环境的一个基本属性——交互会同时改变机器人能走的空间和能看的目标。
一扇关着的门可能让目标房间变成孤岛,也可能只是让路线绕个远;一个关着的冰箱、橱柜或抽屉,可能把近在咫尺的目标藏得严严实实。更关键的是,这些效果有顺序依赖:先开门才能进房间,进了房间才够得着冰箱,开了冰箱才看得见目标。智能体因此必须推理「每一次交互改变了什么、使能了什么」,而不是把交互当成路径上的附带动作。
已有工作打下了基础:Interactive Gibson 研究可移动障碍物与「路径效率—物理扰动」的权衡;Interactive Visual Navigation 测自由空间恢复;CaMP 等把交互引入点目标导航。但一个共同缺口是任务层的判断——一次交互究竟是恢复了连通性、揭示了目标,还是根本没必要做?现有基准要么只评可达性,要么只评扰动,没有把「交互必要性」本身当作被测对象,也没有把连通性变化与可见性变化放进同一个任务定义。
论文的切入正是把这个缺口形式化为 MultINav 问题:统一通道交互(改变空间连通性)、容器交互(改变目标可见性)以及它们的顺序依赖,并要求一个「导航—决策」框架联合推理两类交互及其先后次序。智能体要同时回答四个问题:要不要交互、选哪个物体、何时动手、以及怎么利用交互后的状态变化继续向目标推进。
这个定位让 MultINav 与「非交互导航」和「为交互而交互」都划清了界限:开门本身不构成成功——开了门却没找到目标,episode 依然失败;反过来,场景里大量可交互物体中,大多数交互是不必要的,乱开一通则要计入成本。交互的价值只能由它对「到达或看见目标」的贡献来度量。
MultINav-Bench 基准设计
MultINav-Bench 是一个诊断型 ObjectGoal 基准:在 MolmoSpaces 中冻结 3000 个轻量 episode,覆盖 639 栋房屋,按通道 / 容器 / 混合三类均衡切分(各 1000),带显式的交互必要性标注、干扰物体与 oracle 演示路径。它评的是「智能体在到达目标的同时,是否有目的地决定何时交互、与什么交互」。
任务与交互分类。具身状态记为 $s_{t}=(x_{t},M_{t},z_{t})$:$x_{t}$ 是机器人状态,$M_{t}$ 是几何/语义地图,$z_{t}$ 是交互物体的关节状态。动作分两类:导航动作 $\mathcal{A}_{\mathrm{nav}}$ 更新 $x_{t}$,物理交互 $\mathcal{A}_{\mathrm{int}}$ 更新 $z_{t}$,从而改变可通行性或目标可见性。每个 episode 给定场景 $\mathcal{S}_{i}$、初始状态 $(x_{i}^{0},z_{i}^{0})$、目标物体 $g_{i}$、标注的必要交互 $\mathcal{I}_{i}^{\star}$、oracle 计划 $\pi_{i}^{\star}$,以及必要性标签 $y_{i}\in\{\texttt{required},\texttt{unnecessary}\}$。
终端成功判据把「距离」与「可见」绑在一起:$S_{i}=\mathbb{1}[d_{i}^{\mathrm{pass}}\land v_{i}^{\mathrm{pass}}]$,即停在目标平面距离阈值内且目标在头部相机中可见。物理交互带来状态变化,但不直接构成成功——开了门却没定位到目标,$S_{i}=0$。中间的交互过程由 ISR、IP 和归一化总成本单独衡量。
三类任务。通道交互(合页门)管空间可达性,包含关键关闭门(required)、干扰门(unnecessary)与复合布局;容器交互(冰箱、橱柜、抽屉)暴露被遮挡目标,提供导航完成所需的可见性;混合 episode 强制顺序组合,比如先穿过一道关闭的门,再去开一台关闭的冰箱。3000 个 episode 中 2654 标注为 required,346 个为 unnecessary 的负对照——后者的存在让「不必要的交互尝试」可被测出来,而不至于把一切探索都算成执行错误。
数据生成。从 ProcTHOR-10K 房屋与 NavToObj 种子出发,候选用反事实检查合成:关闭一个通道必须切断到目标的最短路径;把目标藏进容器必须让初始可见性失效。候选还要过关节状态回读、目标身份核验与 oracle rollout 验证,最后每域冻结 1000 个均衡 episode。除冻结的轻量评测集,管线还支持完整采集模式,记录同步的第一/第三人称视觉流、连续底盘轨迹、6D 末端目标与关节状态,统一成 HDF5 记录,可作为 VLA 模型的专家预训练语料。
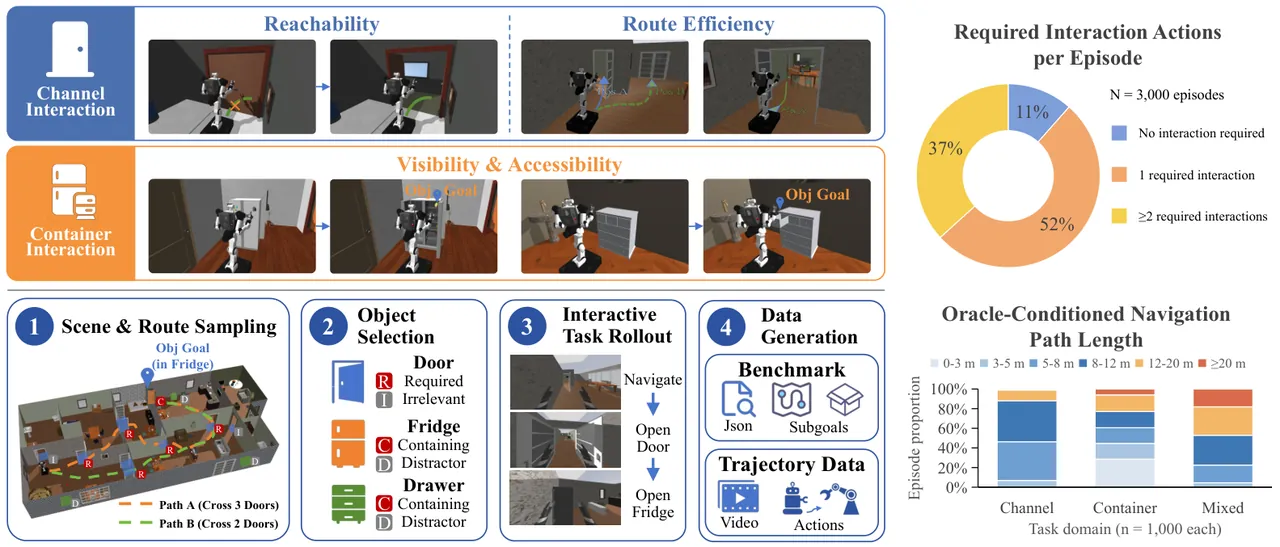
图2:MultINav-Bench 的构建与组成。上:通道交互改变可达性(含缩短路线的子集),容器交互改变可见性与可达性;下:构建与采集流水线;右:3000 回合的必要交互次数与可行路线长度分布。
五项指标。评测把终端目标达成与中间交互效率解耦:SR(终端 ObjectGoal 成功率)、SPL(以 oracle 可行路线为参照、按成功加权的平面路径效率)、ISR(required episode 上已验证必要交互效果的平均占比,有效计划的部分完成给部分分)、IP(类别级交互精度,尝试中产生目标交互类已验证物理效果的比例)、总成本 $\min((L_{i}+0.3A_{i}+E_{i})/30,1)$($L$ 为路径长、$A$ 为交互尝试、$E$ 为无 qualifying 物理效果的尝试,失败恒为 1,归一化常数 30 在评测前固定)。
MultINav-Agent 框架
智能体维护一张持久的、状态条件化的交互图 $\mathcal{G}_{t}=(\mathcal{V}_{t},\mathcal{E}_{t})$,把语义感知、动作选择与交互后验证连成一个环:验证过的变化更新图,更新后的图再指导下一次导航、探索或交互。
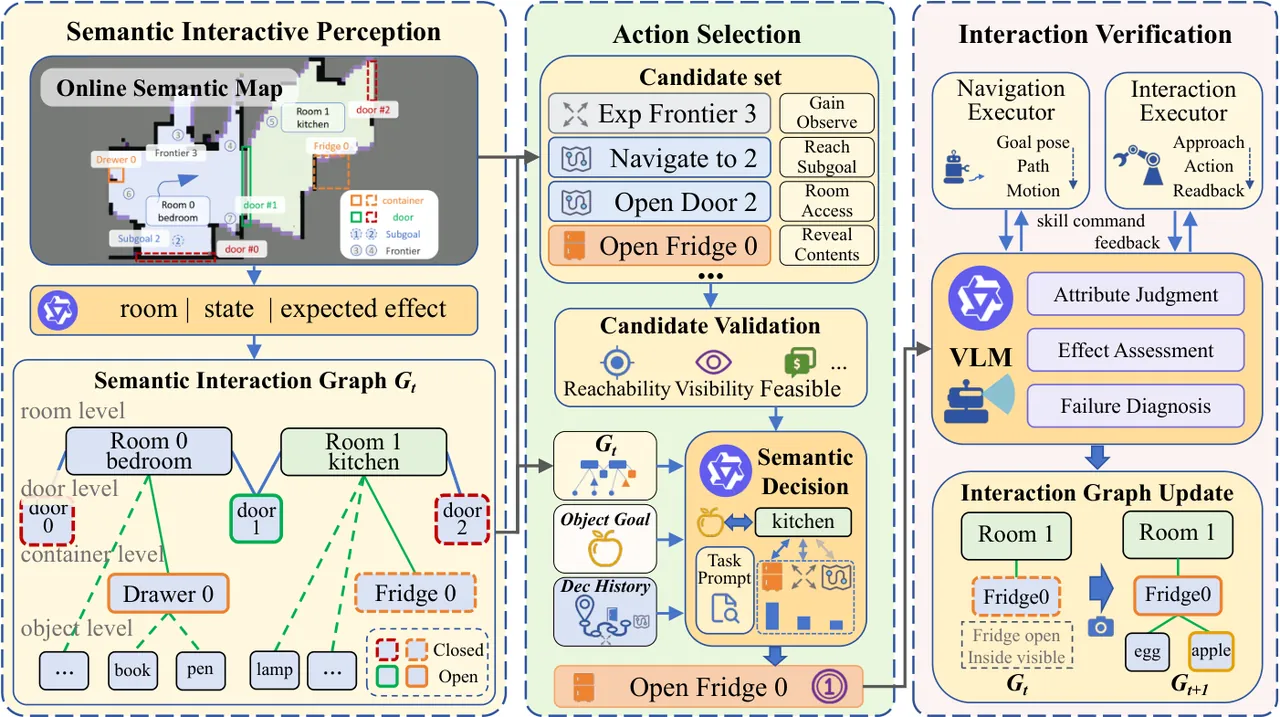
图3:MultINav-Agent 框架总览。
阶段一:语义交互感知。图中的节点是房间、可交互实体、物体与机器人,边是连通、包含与可见关系。感知模块把跨观测的实体关联起来,视觉属性推断估计交互类别与粗状态(开、关、不确定)。交互节点同时保存候选操作、观测置信度与新近度。图是「状态条件化」的,因为关系的有效性取决于观测到的交互状态:一扇关着的门阻断它中介的房间连接,而一个验证过的开门动作就允许通行;打开容器允许检查内部,但目标可见性只有在目标真正被观测到之后才成立。新观测的实体扩展图,已观测的实体即使当前不在视野里也持续存在——存储的状态与关系为后续决策提供上下文,置信度与新近度则把历史估计与新证据区分开。
阶段二:效果引导的动作选择。每个决策点上,图与导航图共同生成导航、前沿探索与交互三类候选。交互候选指定实体、操作与接近视角;资格检查用路线可行性、可用视觉证据与状态可靠性筛掉当前不可执行的候选——但被记住的实体即使暂时不能交互也留在图里。每个交互候选带有由交互类别与图关系推出的粗粒度预期效果:开一个通道可能使能通行,开一个容器可能揭示内容。这描述的是「可能发生的变化」,不假设未见目标一定存在。视觉语言模型(Qwen3.6-35B-A3B-FP8)接收目标、相关子图、候选状态与效果、路线成本与决策历史,按「对到达或观测目标的预期贡献」给可行动作排序,同时考虑路线前提、合理目标位置与既往尝试。当交互对任务进展帮助不大时,导航与探索始终是可选项。
阶段三:交互验证与图更新。对选中的交互,机器人先到接近视角,从当前视图 grounding 可操作区域与操作,再由导航与交互技能执行规格。交互后的验证把新鲜视觉观测与执行反馈对账,评估实际达成的状态与预期图效果:置信度高的证据更新实体状态,冲突或被遮挡的证据标为 uncertain。通道更新修订房间连通性;容器更新把新观测物体及其包含、可见关系通过感知并入图。失败或不确定的尝试留在决策历史里,避免立即重复。更新后的图重新生成候选,进入下一轮。
这个循环支撑顺序交互依赖:开门使能进入房间,房间里的观测可能引入容器候选,验证过的开容器暴露的物体又支持下一条导航决策。每一步都在组合「连通性变化」与「可见性变化」:
graph TD
  START["决策点 t"] --> PERC["语义交互感知
实体关联 / 状态与置信度估计"]
  PERC --> GRAPH["持久交互图 G_t=(V_t,E_t)
房间·门·容器·物体 / 连通·包含·可见"]
  GRAPH --> CAND["候选生成
导航 / 前沿探索 / 交互(实体+操作+视角)"]
  CAND --> FILTER["资格检查
路线可行 · 视觉证据 · 状态可靠"]
  FILTER --> VLM["VLM 效果引导排序
按预期连通性/可见性贡献"]
  VLM --> SEL{"选中交互?"}
  SEL -- "否(交互收益低)" --> NAV["导航或前沿探索"]
  SEL -- "是" --> EXEC["接近视角 → grounding → 执行交互"]
  EXEC --> VERIFY["交互后验证
视觉观测 × 执行反馈对账"]
  VERIFY --> UPDATE{"证据置信度"}
  UPDATE -- "高" --> APPLY["更新实体状态
通道→连通性 / 容器→内容并入图"]
  UPDATE -- "冲突/遮挡" --> UNC["标记 uncertain"]
  UNC --> HIST["写入决策历史
失败尝试不立即重复"]
  APPLY --> HIST
  HIST --> GRAPH
  NAV --> GRAPH
论文的案例研究把这个循环走了一遍:机器人连续打开两扇门扩大可达范围,导航到冰箱并打开它揭示目标;逐步插图显示验证过的状态更新如何引导连续重规划。Fig. 4 的右下角给出最终交互图与轨迹(蓝色为导航/探索,橙色为交互)。
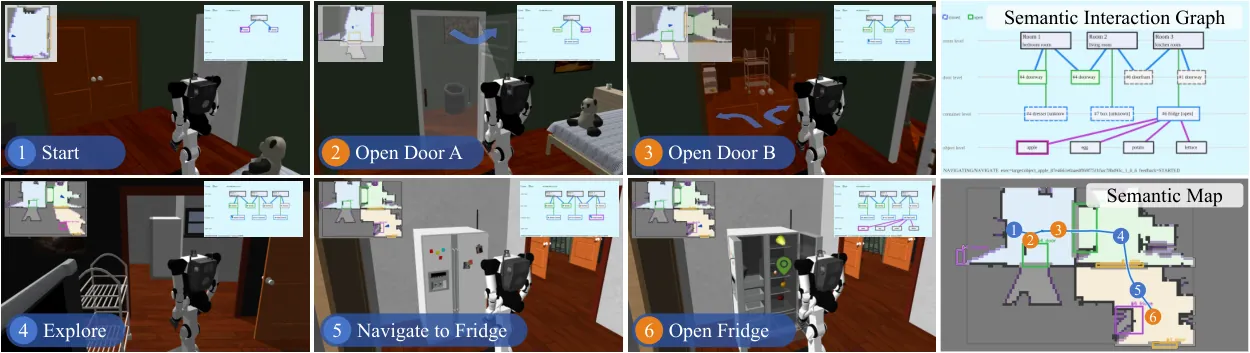
图4:顺序交互与图更新案例。开两扇门到达冰箱、开冰箱揭示目标;插图展示语义地图与交互图的演化,右侧为最终图与轨迹。
实验结果
设置。非交互对照在 MolmoSpaces NavToObj 上评,交互对比在 MultINav-Bench 上评。基准提供原始图像感知与受限真值(RGT)两种感知模式;主对比对两个交互方法用同一 RGT 接口(提供 episode 内可见物体的 ID、类别与空间观测),把感知与实例关联误差从「交互感知与决策」的评测中剥离——智能体仍要自己探索、选交互、从观测结果更新信念,但隐藏物体、仿真器关节元数据与 oracle 计划都不给。交互基线是 MoMa-LLM 的 MolmoSpaces 适配版,两者共用同一交互执行器与 Qwen3.6-35B-A3B-FP8 高层决策模型。
非交互 NavToObj。不交互时,MultINav-Agent 在 MolmoSpaces NavToObj 上拿到 53.0% SR(2000 任务,ProcTHOR 域),高于 RING 的 48.0%(榜单)与 DualVLN 的 21.0%(Habitat 域);本地评测的 SPOC 20.15%、VLFM 11.90% 更低,论文指出这些基线执行的都是合法指令,分数差距主要来自连续控制迁移时缺少滑动接触反馈。
交互任务主结果。MultINav-Bench 上,MultINav-Agent 在通道、容器、混合三类任务上的 SR 分别为 55.80%、45.00%、24.10%,比 MoMa-LLM 高出 36.20、34.70、22.40 个百分点:
| 方法 / 任务类型 | SR (%) ↑ | SPL ↑ | ISR (%) ↑ | IP (%) ↑ | Cost ↓ |
|---|---|---|---|---|---|
| MoMa-LLM · 通道 | 19.60 | — | 54.28 | — | — |
| MultINav-Agent · 通道 | 55.80 | 更高 | 60.09 | 更高 | 更低 |
| MoMa-LLM · 容器 | 10.30 | — | 2.00 | 2.37 | — |
| MultINav-Agent · 容器 | 45.00 | 更高 | 46.70 | 38.91 | 更低 |
| MoMa-LLM · 混合 | 1.70 | — | 25.37 | — | 0.9951 |
| MultINav-Agent · 混合 | 24.10 | 更高 | 45.07 | 更高 | 0.9493 |
表1:MultINav-Bench 主结果(按任务类型分组)。容器任务的 ISR 差距最大(46.70% 对 2.00%),IP 差距 38.91% 对 2.37%。
通道任务上,两者的 ISR 只差 5.81 个百分点(60.09% 对 54.28%),SR 却差了 36.2 个——「做到了交互效果」和「最终到达目标」之间的落差被指标设计清楚地暴露出来。容器任务的 ISR 差距最大(46.70% 对 2.00%),MoMa-LLM 几乎学不会「开对容器」。混合任务对两者都最难:MoMa-LLM 的 ISR 有 25.37%,SR 只有 1.70%;MultINav-Agent 的 ISR 45.07%(含部分分)背后,只有 24.70% 的 episode 真正完成了全部必要交互。
交互到目标的落差。ISR 是部分完成度的平均,不必与终端 SR 同步。完整版的数据是:通道任务 393/654 个 required episode 完成了全部必要效果,其中 297 个(75.6%)到达目标;容器任务 466/1000 完成效果,435 个(93.3%)到达;混合任务 247/1000 完成,223 个(90.3%)到达。对容器与混合任务,难点在「凑齐必要的交互链」;通道任务则在效果达成后还剩更大的导航缺口。
效率与失败模式。MultINav-Agent 在每个切分上都有更高 SPL 与更低归一化成本,但混合任务上两者成本都接近天花板(0.9493 对 0.9951)——失败 episode 成本恒为 1,759 个混合失败贡献了 0.759 的均值。探索停滞(exploration stall)的分布也值得注意:混合 516 次、容器 304 次、通道 158 次,顺序组合的子目标进展是后续研究的明确方向。论文同时提醒,这些终态标签不建立因果失败机制。
消融。在 1,000 个混合任务中固定 200 episode、165 栋房屋的子集上(按容器类别与 oracle 参考路径长度按比例无放回抽样,episode 列表在评测前冻结):
| 变体 | SR (%) ↑ | ISR (%) ↑ | IP (%) ↑ | SPL ↑ | Cost ↓ |
|---|---|---|---|---|---|
| 完整模型 | 23.0 | 41.8 | 40.4 | 0.107 | 0.961 |
| 扁平物体记忆(替下图记忆) | 21.0 | 43.8 | 26.7 | — | — |
| 贪心选择(替下 VLM 排序) | 22.0 | — | 36.9 | 0.134 | 0.933 |
| 仅感知更新(去掉执行验证) | 5.5 | 26.6 | 36.6 | 0.033 | 0.988 |
表2:消融研究。仅感知更新造成最大跌幅(SR 从 23.0% 掉到 5.5%);图记忆的优势主要体现在交互精度而非效果完成度。
三个变体暴露的是不同的权衡而非一致增益。扁平物体记忆把 IP 从 40.4% 拉到 26.7%,ISR 反而从 41.8% 升到 43.8%——图记忆最清晰的优势在交互精度,关系上下文帮助选中「对目标类别有效」的交互,而部分进展多并不等于能到达目标。贪心选择 SPL 更高、成本更低,SR 与 IP 略低,全集只多完成 2/200 个 episode——语义选择没有建立起决定性的成功率优势,换来的是 SR 与 IP。最有力的证据来自状态更新:仅感知更新使 SR 从 23.0% 崩到 5.5%(17.5 个百分点),SPL 掉到 0.033——丢掉执行反馈的图更新,通道与容器交互的协同就组织不起来。论文也提醒,记忆与选择上的较小差异在这个固定子集上应谨慎解读。
真机演示。在室内环境用 Unitree Go2 四足机器人找苹果:起点在一扇关闭的门前,门在人协助下打开,机器人进入新可达区域探索、扩展语义地图与交互图,随后导航到冰箱,同样在人协助下打开并检查内容找到苹果。一次目标搜索任务里串起了两类状态变化:开门改变空间连通性,开冰箱暴露先前被遮挡的内容。
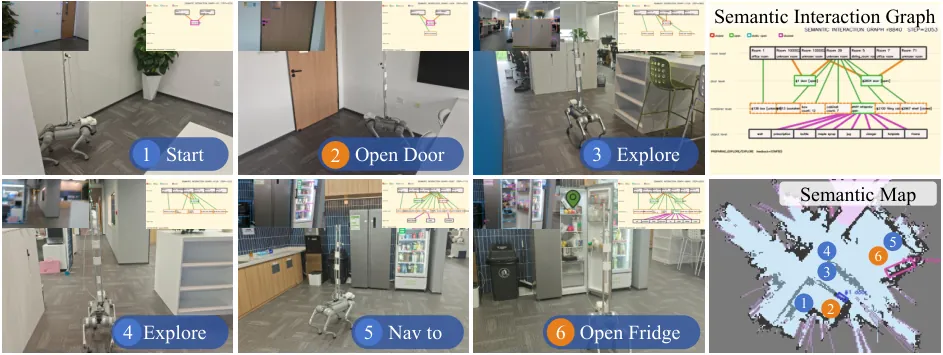
图5:真机导航找苹果。蓝色标记为导航/交互位置,橙色为交互;门与冰箱的开启有人工协助。
局限性
作者与论文自述的局限。其一,消融中记忆与选择的较小 SR 差异在这个固定子集上应谨慎解读,不构成统计显著的增益;其二,ISR 的「部分完成」口径意味着它不必追踪终端 SR,混合任务 45.07% 的 ISR 背后只有 24.70% 的 episode 完成全部必要交互;其三,Cost 在混合任务上接近天花板(0.9493),聚合成本同时反映完成度与轨迹效率,并不能分离「成功条件下的执行成本」;其四,探索停滞等终态标签不建立因果失败机制。
主对比的感知口径。主结果用受限真值(RGT)模式剥掉感知与实例关联误差,好处是干净地测交互表示与决策,代价是结论不能直接外推到纯视觉输入——论文自己把完整图像模式留作开放问题。真实部署中,视觉属性推断与状态估计的误差会直接进入图的更新链路。
真机演示的人为假设。Go2 演示中门与冰箱的开启均有人工协助,交互执行层尚未在真机上闭环;此外基准场景来自 ProcTHOR-10K 房屋合成,与真实家庭的杂乱度和门的物理多样性仍有距离。
总结与展望
MultINav 的贡献是双份的。基准侧:把「交互必要性」变成一等公民——三类任务(通道、容器、混合)、required/unnecessary 标注、五项解耦指标(SR/SPL/ISR/IP/Cost),加上可自动化的数据生成管线,让「导航中该不该交互」第一次有了系统的测量方式。智能体侧:三阶段框架把感知、选择与验证挂在同一张持久交互图上,验证过的状态变化驱动下一轮候选生成,顺序依赖因此可以逐环组合;消融显示图记忆的价值在交互精度(IP 40.4% 对 26.7%),执行验证的价值在任务成败(SR 23.0% 对 5.5%)。
后续的方向也清楚:完整图像感知模式下的鲁棒性、混合任务 24.1% 成功率背后暴露的子目标进展问题(516 个探索停滞 episode)、真机上闭环交互执行,以及把完整采集模式产出的 HDF5 专家轨迹用于 VLA 预训练。导航的下一个台阶,很可能就在于机器人不再把门和抽屉当作障碍,而是当作可以改写的世界状态。
金句:「开门不是成功,找到目标才是;但不开门,可能永远找不到。」MultINav 让交互的价值由它对目标的贡献来度量——大多数门不该开,少数一扇不开就满盘皆输。