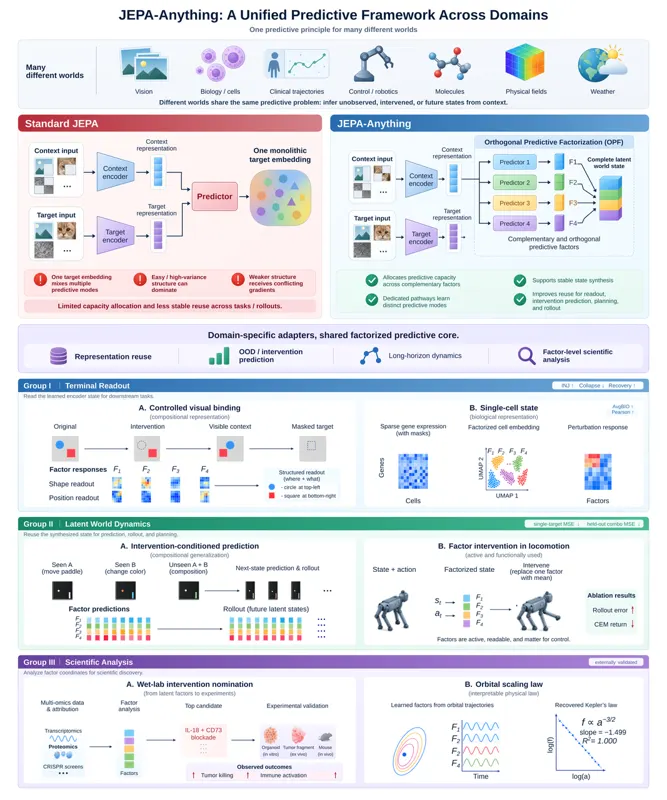
JEPA-Anything 用正交预测分解把世界模型的潜变量拆成互补因子,以独立路径预测并在七个异质领域验证,在控制与分子动力学等任务上改善长时预测和干预误差。
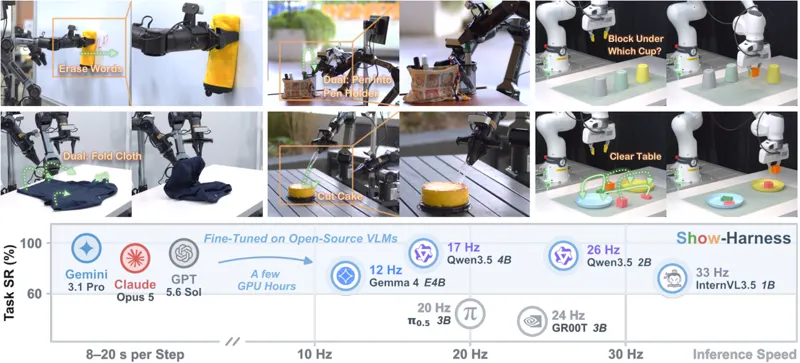
基础视觉语言模型(VLM)对世界已有广泛认知,但把这种认知转成机器人控制仍然困难。我们提出 Show-Harness——一套「具身 harness」,通过连接意图与动作的紧凑语义接口,让 VLM 直接「玩」机器人。Show-Harness 对外暴露 VLM 天然可推理的离散语义动作单元,再由机体专属的解释器把它们确定性地接地为局部机器人动作,使 VLM 始终对细粒度物理决策负责。基于同一接口,我们验证了两条路径:(1)直接解锁闭源前沿 VLM 实现零样本机器人控制;(2)只需几 GPU 小时微调,即可把小规模开源 VLM 适配为低成本部署的策略。我们进一步做出 GUMI(GUI 操作界面),把同一语义动作空间延伸到基于 GUI 的演示采集,让人类与智能体无需专用遥操作硬件即可跨机体「玩」机器人。大量实验表明,装配 Show-Harness 的 VLM 智能体在任务、机体与环境之间稳健泛化,优于代表性的 agentic 与 VLA 范式。这些结果说明:合适的接口本身就能从基础 VLM 中释放大量具身能力,无需额外的模型容量,也无需昂贵的机体专属预训练。
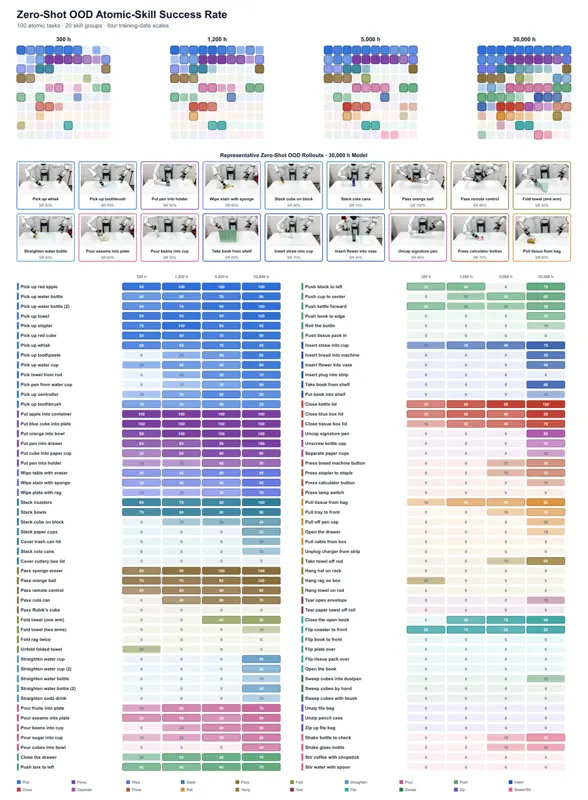
GE-Act 2.0 以控制导向自编码器、单步视觉规划器和逆动力学模型构建世界-动作系统,并用 KASO 对齐生成未来与动作监督。共享操作数据从 300 扩充到 30,000 小时后,G1-OP 与 G2-90D 的零样本分布外成功率分别达到 44.1% 和 31.1%。
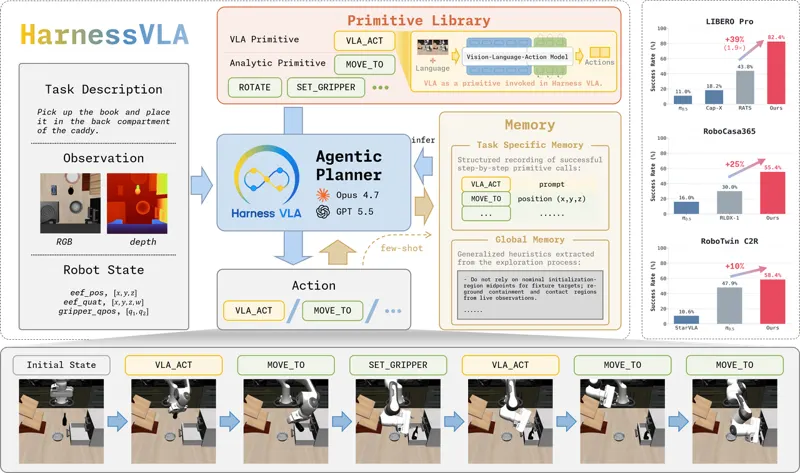
语言条件操作既需要精确的富接触控制,也需要对语言、场景和长时程的稳健推理。端到端视觉-语言-动作(VLA)模型提供强大的局部视觉运动技能,但它们是在分布内任务轨迹上训练的,在语义重定向、目标重绑定、空间布局偏移和局部接触不稳定等部署扰动下常常失效。LLM 编码智能体提供互补的语义与组合推理,但纯解析原语在不规则抓取、受限放置和铰接物体交互上表现很差。本文提出 Harness VLA,一个记忆增强的智能体框架:它把一个冻结的 VLA 暴露为可重试的富接触原语,并与一个小型固定的解析原语库组合,用于接地、暂存、搬运、导航和释放。框架不去扩大技能库,而是从任务特异的执行轨迹、全局成功规则和失败模型中学习这些固定原语的工作范围。通过把语义重接地、非接触执行和 VLA 重暂存上提到规划器,同时把冻结 VLA 留给局部富接触阶段,Harness VLA 在不微调的前提下把预训练 VLA 扩展到其原始轨迹分布之外。在被扰动的桌面操作、家庭厨房操作和 clean-to-randomized 双臂操作上,Harness VLA 在 LIBERO-Pro 和 RoboCasa365 上分别比最强相关基线高出 38.6 和 27.1 个百分点,并在 RoboTwin C2R 上达到 58.4%。代码开源于 https://github.com/RLinf/RPent 。
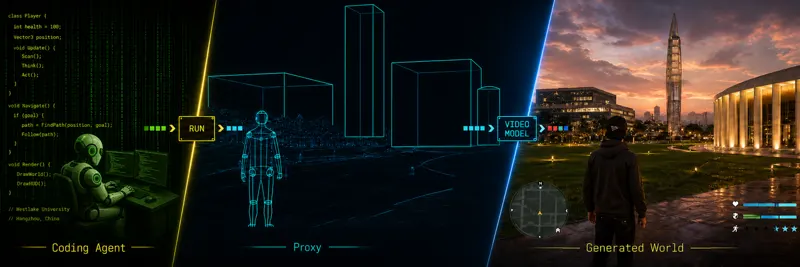
编程智能体以可执行代码维护持久世界状态,代理视频传递逐帧时空约束,视频模型负责高保真视觉实现。
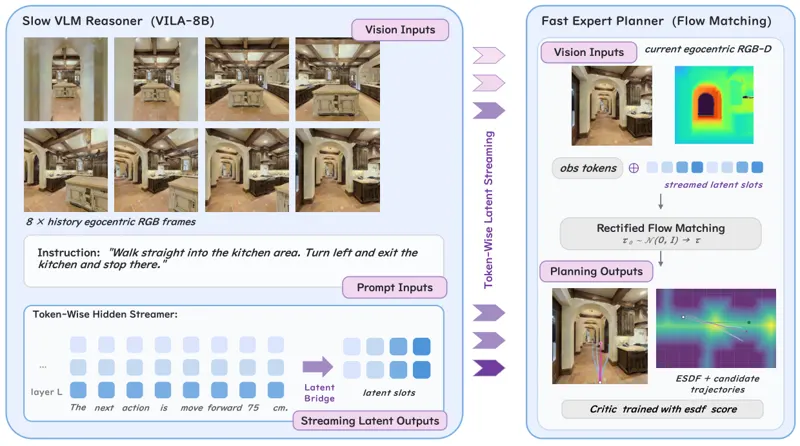
冻结的 VILA-8B 慢推理器把逐 token 多层隐状态流式汇成 8 个潜槽,实时条件化流匹配快规划器;动态行人导航基准上理想/真实两阶段成功率 41.6%/34.8%,碰撞率最低。
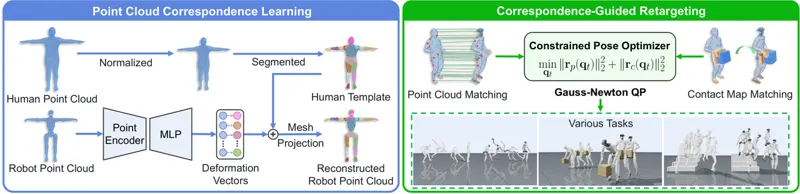
UMR 框架通过学习稠密点云对应关系实现人形运动重定向,无需手动映射,提升可扩展性与细节还原能力。
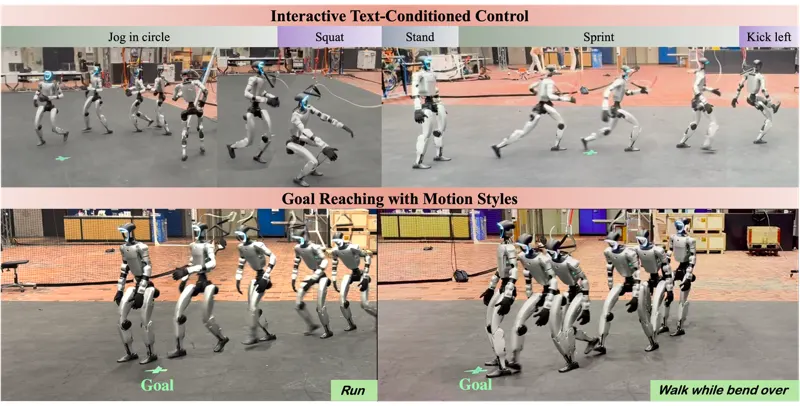
苏黎世联邦理工提出 ADAPT:文本条件扩散技能先验加约束残差强化学习,在 Unitree G1 上实现实时指令切换的端到端全身控制,并可通过噪声引导复用冻结先验完成风格保持的目标到达。
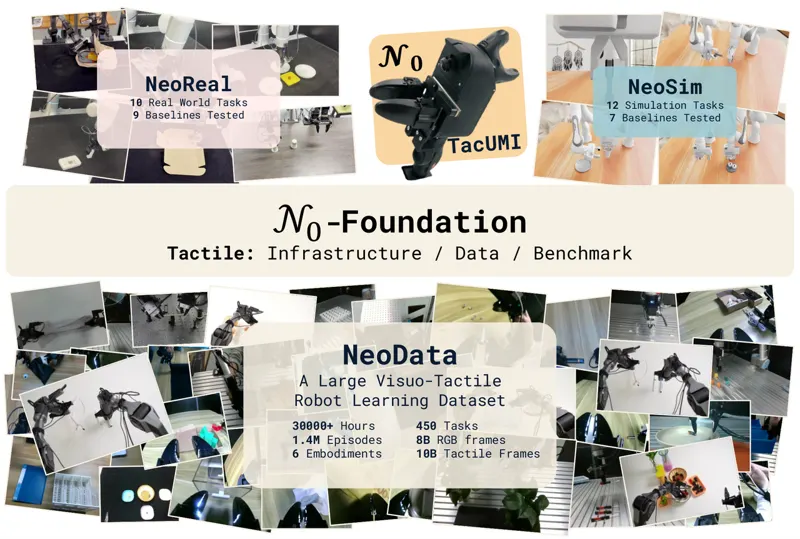
论文提出面向触觉具身操作的一体化范式 N₀-Foundation,覆盖硬件、数据、表示与评测四层:自研相机式触觉传感器与无机器人采集设备 N₀-TacUMI,构建超 3 万小时、6 种本体、450+ 任务的视触同步数据集 NeoData 并开源 5000 小时子集 OpenNeoData;提出以三轴稠密力场为统一监督的视触表示模型 NeoForce,实现跨传感器可迁移触觉表示;并给出真机 NeoReal(10 任务)与仿真 NeoSim(12 任务)双基准。实验表明策略收益来自物理接触状态而非触觉信号的设备外观,NeoForce 条件化使 π₀.₅ 在 NeoReal 的平均渐进分从 38.1% 提升至 47.5%。
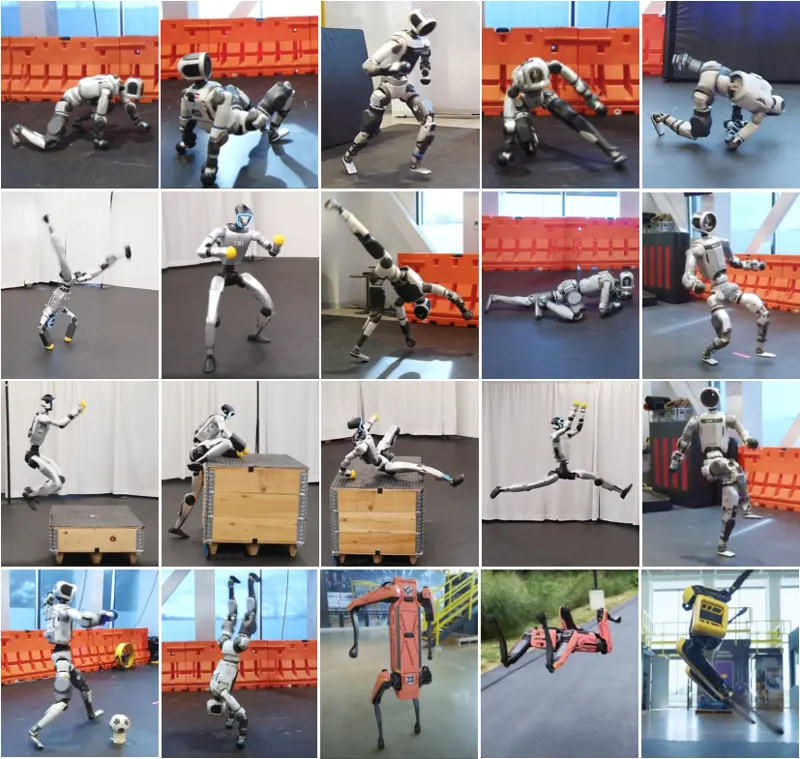
ZEST 用单阶段强化学习,把动作捕捉、单目视频和关键帧动画三类异构参考动作统一训练成模拟策略,零样本部署到 Atlas、Unitree G1 和 Spot,实现全尺寸人形机器人上首个动态多接触技能,无需接触标签、状态估计器或逐技能调参。
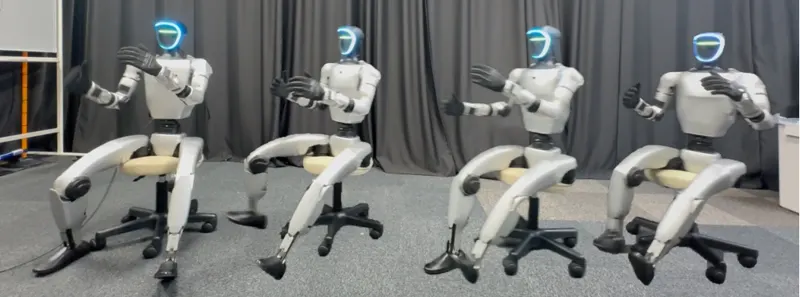
研究人形机器人在被动椅上的全向坐姿移动。策略仅用本体感知,速度跟踪优于站立。分析了正则化对收敛与误差的影响。
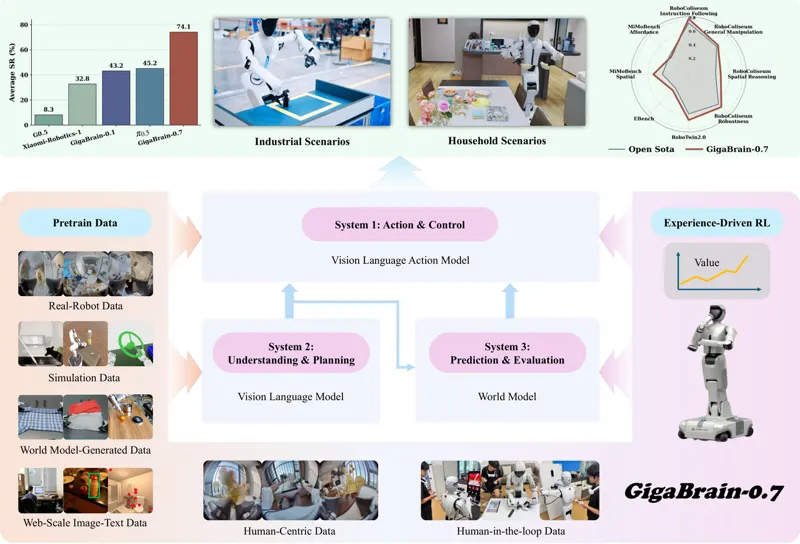
GigaBrain-0.7 统一任务理解、未来预测、价值评估与连续动作控制,在三万七千多小时跨本体具身数据和约2.72亿VLM样本上完成单阶段预训练,并通过仿真与真机经验强化显著提升成功率。