PAPER DEEP DIVE
JEPA-Anything:跨域正交预测世界模型
JEPA-Anything 用正交预测分解把世界模型的潜变量拆成互补因子,以独立路径预测并在七个异质领域验证,在控制与分子动力学等任务上改善长时预测和干预误差。
一句话总结
JEPA-Anything 把世界模型的潜状态拆成多个正交且仍然活跃的预测因子,再通过伪逆合成为完整状态;同一训练原则被用于视觉、细胞、临床、控制、分子动力学、物理场和天气七类系统。
研究背景与动机
世界模型试图从当前可见上下文推断未观测、被干预或未来时刻的状态。这样的状态既可以表示机器人场景中的物体与运动趋势,也可以表示患者历史之后的健康风险、分子构型之后的轨迹,或者天气场下一时刻的演变。论文采用一个较宽但操作上明确的定义:只要上下文和目标属于同一个底层系统,并且上下文对目标存在可利用的统计依赖,那么连接二者的潜表示就可以被视为世界状态。
JEPA 提供了自然的基础机制。在线编码器把上下文压缩到潜空间,目标编码器定义希望预测的表示,预测器则在表示空间完成上下文到目标的映射。与像素重建相比,潜空间预测可以忽略纹理和噪声,把容量留给对下游任务更有意义的因素。但标准 JEPA 仍然把所有目标信息汇总到单一嵌入,再由单一预测路径处理。
问题在于,不同世界的可预测结构并不均匀。视觉状态可能同时包含位置、对象和操作;物理场包含多个尺度与模态;临床状态包含稀疏且异步发生的事件;分子状态还包含位置、速度、种类和模拟单元。如果这些结构共享一个目标嵌入,高方差方向或容易预测的方向可能占据优化主导,多个潜方向还会重复编码相近信息,较弱但重要的预测结构则可能收到冲突梯度。
因此,论文没有把问题表述为“再造一个领域专用模型”,而是把它表述为潜状态中的预测容量分配问题。它希望固定的世界状态接口能够容纳不同数量的互补因子,各方言只保留自己的观测适配器、上下文采样器和编码器,而预测核心采用同一套算法。
论文用正交预测分解(Orthogonal Predictive Factorization,OPF)回答这一问题。每个目标状态被投影到若干正交子空间,每个子空间由独立预测器处理;正交约束限制不同分支重复表达同一方向,因子活跃度约束避免某些坐标退化,在线编码器方差项则抑制上下文表示塌缩。最终预测可以重新合成为完整潜状态,供一次性读出、规划、干预预测和自回归 rollout 使用。
预备知识:JEPA、潜状态与完整分解
标准 JEPA 使用在线编码器、目标编码器和预测器三部分。目标编码器由在线编码器的指数移动平均更新,其输出被停止梯度;这种非对称结构避免了退化解,也让目标表示随在线模型缓慢变化。论文中的世界状态维数记为 $d$,上下文表示记为 $z_c$,目标状态记为 $z_t$。
OPF 的关键约束是 $K r=d$,其中 $K$ 是因子数量,$r$ 是每个因子的维数。这意味着因子不是随意附加的若干特征,而是对完整状态空间的一次分块。因子索引本身没有预设的“速度”“疾病”或“位置”语义;语义只能通过后续探针、干预或外部实验建立。
另一个关键区别是分解与合成都显式保留。许多表征学习目标只约束嵌入统计,却不保证这些分量还能恢复原状态。JEPA-Anything 在分析方向使用 $P_k^\top$,在操作方向使用分析矩阵转置的 Moore–Penrose 伪逆,目标是让多个预测输出重新构成完整世界状态。
方法详解
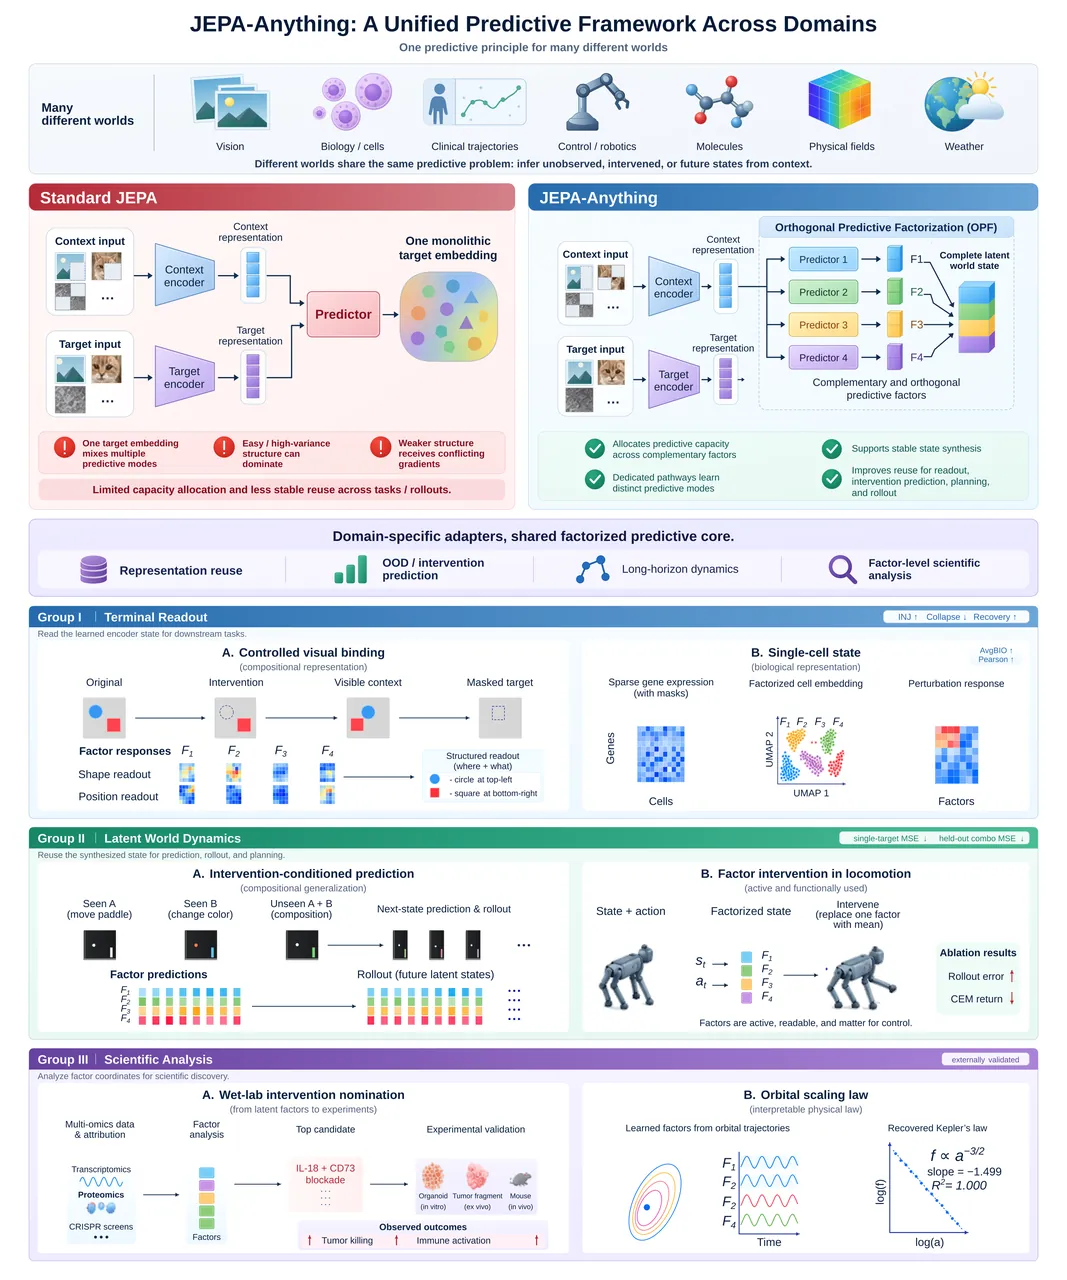
图 1:论文总览。上半部分对比标准 JEPA 的单体目标与 OPF 的多因子预测和状态合成;下半部分列出终端读出、潜动态与科学分析三类实验。
flowchart LR
    X[Raw observation] --> A[Domain adapter: tokens and descriptors]
    A --> V[Context-target sampler]
    V --> E[Online encoder]
    V --> T[EMA target encoder]
    T --> G[Stop-gradient target state]
    G --> P[K orthogonal projections]
    E --> Q[K dedicated predictors]
    P --> Q
    Q --> U[Predicted factor stack]
    U --> S[Pseudoinverse synthesis]
    S --> Z[Complete latent world state]
    Z --> R[Readout / planner / rollout / analysis]
1. 域适配器保留观测差异,预测核心保持统一
设 $\delta$ 表示一个领域,$x\sim\mathcal{D}_{\delta}$ 是原始观测。适配器 $\mathcal{A}_{\delta}$ 把输入转换为内容 token $H$ 和结构描述符 $S$。描述符可以表示图像块坐标、时间戳、图节点位置、实体身份,也可以为空。随后,视图采样器 $\mathcal{V}_{\delta}$ 选择上下文索引 $C$ 和目标索引 $T$。整个过程可以写作:
$$x\xrightarrow{\mathcal{A}_{\delta}}(H,S)\xrightarrow{\mathcal{V}_{\delta}}(H_C,S_C,T,S_T).$$这条公式的意义是,领域差异在前端被压缩成统一 token 接口,而后续预测逻辑不再依赖原始数据类型。视觉可以使用 ViT,序列可以使用 Transformer,图数据可以使用 GNN,集合或表格则可以使用 MLP;共同部分只包括在线与 EMA 目标编码方案、因子预测、状态合成和三项正则。
目标编码器参数按指数移动平均更新:
$$\bar{\theta}\leftarrow m\bar{\theta}+(1-m)\theta,\qquad 0\leq m<1.$$在线编码器产生 $z_c=f_\theta(H_C,S_C)$,EMA 编码器产生 $z_t=f_{\bar{\theta}}(H,S)_t$。当目标只有一个索引时,该公式退化为常见的单向量 JEPA;当目标包含多个区域或时间点时,它给出结构化目标集合。
2. 正交预测分解
OPF 学习 $K$ 个投影器 $P_k\in\mathbb{R}^{d\times r}$。目标输出先停止梯度,再投影到各因子:
$$\widetilde{z}_t=\operatorname{sg}(z_t),\qquad z_t^{(k)}=P_k^\top\widetilde{z}_t,\qquad k=1,\ldots,K.$$每个因子有独立预测器 $q_k$。预测器接收共享上下文表示 $z_c$ 和必要时的目标描述符 $s_t$:
$$\widehat{z}_t^{(k)}=q_k(z_c,s_t).$$这种分工使不同预测路径可以专门吸收不同方向的变化,而不是让一个预测器同时拟合所有结构。描述符可以告诉模型当前要预测哪个时间点或空间区域;如果上下文已经唯一决定目标,预测器也可以忽略描述符。
所有预测拼接为 $\widehat{u}_t$ 后,通过分析映射的伪逆恢复完整潜状态:
$$\widehat{z}_t=(P^\top)^\dagger\widehat{u}_t\in\mathbb{R}^{d},\qquad P=[P_1,\ldots,P_K].$$当投影严格正交时,$(P^\top)^\dagger=P$,合成简化为 $\widehat{z}_t=\sum_k P_k\widehat{z}_t^{(k)}$。论文强调,单纯拼接因子坐标并不等于状态合成;显式伪逆步骤才是从多个预测分支返回完整世界状态的接口。
面向时间、动作或干预的动态系统可以写成:
$$\widehat{u}_{t+1}=\left[q_1(z_t,\xi_t,s_{t+1});\ldots;q_K(z_t,\xi_t,s_{t+1})\right],\qquad \widehat{z}_{t+1}=(P^\top)^\dagger\widehat{u}_{t+1}.$$其中 $\xi_t$ 表示动作、干预标签或已知外力。重复应用该递推式就得到潜空间 rollout;规划器只需在预测状态上定义回报,领域层不必重新设计状态转移接口。
3. 为什么必须同时约束正交性与活跃度
如果只增加多个预测头,不同投影器可能学到重复方向。论文直接回归每个因子,损失为:
$$\mathcal{L}_{\mathrm{pred}}=\frac{1}{K|T|r}\sum_{t\in T}\sum_{k=1}^{K}\left\|\widehat{z}_t^{(k)}-z_t^{(k)}\right\|_2^2.$$直接回归方向与幅值,是为了保留状态合成所需的尺度信息。仅有预测损失仍然不能保证因子互补,因此论文把每个投影器内部的正交性和不同投影器之间的正交性都写入损失:
$$\mathcal{L}_{\mathrm{orth}}=\sum_{k=1}^{K}\left\|P_k^\top P_k-I_r\right\|_F^2+\sum_{1\leq i<j\leq K}\left\|P_i^\top P_j\right\|_F^2.$$第一项防止单个投影器内部出现退化基,第二项惩罚不同因子反复编码同一方向。当两项目标都严格满足时,因子空间构成正交直和。对任意状态 $z$,有:
$$\left\|P^\top z\right\|_2^2=\sum_{k=1}^{K}\left\|P_k^\top z\right\|_2^2=\left\|z\right\|_2^2,\qquad z=\sum_{k=1}^{K}P_kP_k^\top z.$$这表示正交分解在零惩罚极限下不会丢失状态能量,也可以精确恢复原状态。若预测因子带有误差 $e$,严格正交还给出 $\|\widehat{z}-z\|_2=\|e\|_2$ 和条件数 $\kappa_2(P)=1$。反之,若多个分支几乎共享方向,分析矩阵的最小奇异值会趋近零,条件数变大,因子误差在合成时会被放大。
几何正交还不等于统计活跃。某个坐标即使属于独立子空间,也可能在所有样本上近似常量。为此,论文对每个目标坐标设置标准差下界:
$$\mathcal{L}_{\mathrm{fac}}=\frac{1}{Kr}\sum_{k=1}^{K}\sum_{j=1}^{r}\max(0,\gamma_{\mathrm{fac}}-\sigma_{k,j}^{\mathrm{fac}}),\qquad \mathcal{L}_{\mathrm{enc}}=\frac{1}{d}\sum_{j=1}^{d}\max(0,\gamma_{\mathrm{enc}}-\sigma_j^{\mathrm{enc}}).$$第一项作用于停止梯度的目标因子,因而主要塑造投影器;第二项直接作用于在线上下文表示,提供编码器层面的反塌缩信号。将各项合并后,训练损失为:
$$\mathcal{L}_{\mathrm{OPF}}=\mathcal{L}_{\mathrm{pred}}+\lambda_{\mathrm{orth}}\mathcal{L}_{\mathrm{orth}}+\lambda_{\mathrm{fac}}\mathcal{L}_{\mathrm{fac}}+\lambda_{\mathrm{enc}}\mathcal{L}_{\mathrm{enc}},\qquad \mathcal{L}_{\mathrm{train}}^{(\delta)}=\mathcal{L}_{\mathrm{base}}^{(\delta)}+\mathcal{L}_{\mathrm{OPF}}.$$这说明 JEPA-Anything 不替换领域原有的基础损失,而是在其上增加一个统一预测核心。不同任务可以调整 $d,K,r$ 和三个权重,但功能形式保持不变。
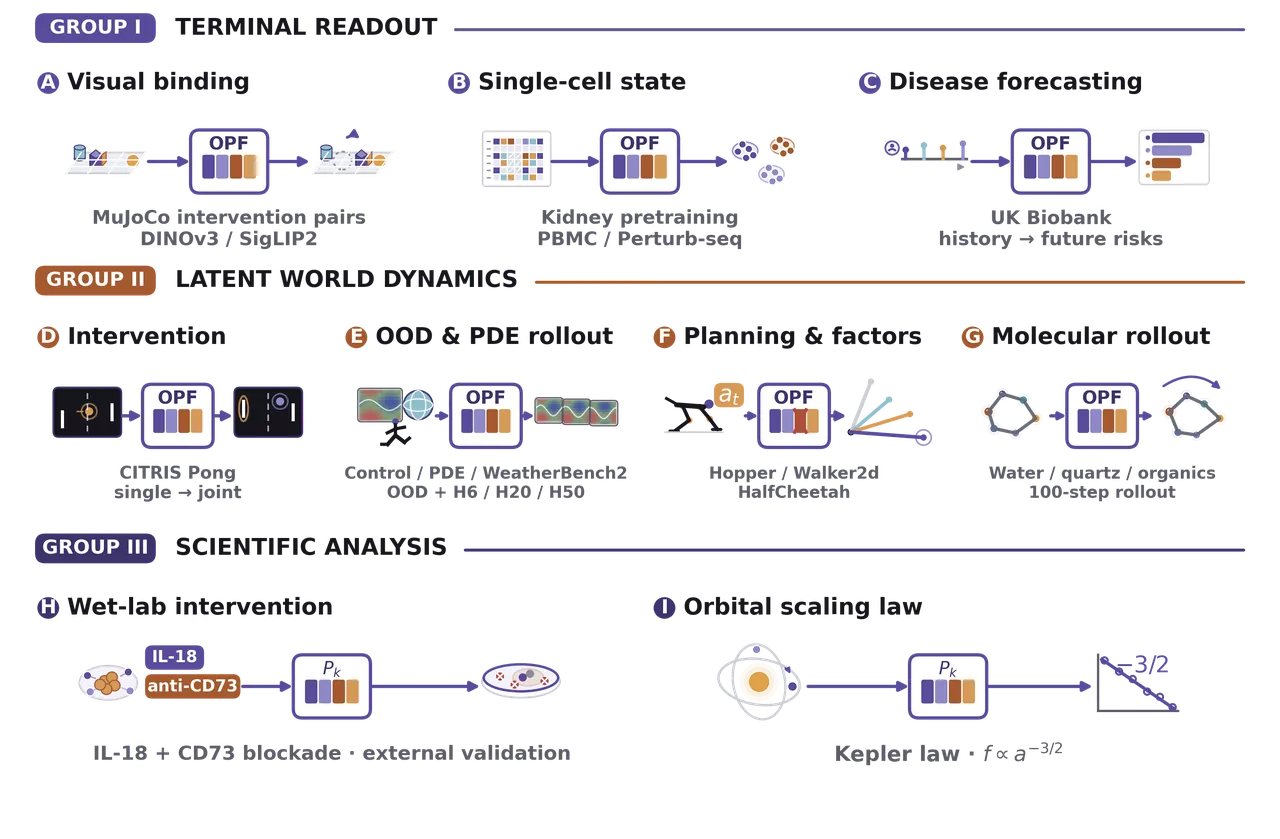
图 2:论文的场景总览。不同领域保留各自的上下文、目标、编码器和评价协议,但都通过同一个 OPF 状态接口连接。
4. 同一核心支持读出、规划与科学分析
对于普通下游任务,模型只保留在线编码器,再接领域读出器:
$$h_{\delta,\tau}(x)=R_{\delta,\tau}\left(f_{\theta}^{\delta}(\mathcal{A}_{\delta}(x))\right).$$读出器可以选取一个 token、池化序列、保留时间索引,或者训练轻量探针。OPF 在这里的作用是塑造可复用编码器,而不是强迫所有任务显式消费因子。
对于未来状态预测、干预、规划和自回归模拟,模型则保留投影器与预测器,由合成状态继续进入解码器、规划器或下一时刻转移。对于科学研究,因子本身可以被保留为诊断接口:$u_k(x)=P_k^\top z_{\delta}(x)$。论文借此寻找可被实验干预的候选方向,或把潜模态与已知物理规律对照。
公开代码如何对应论文方法
公开仓库的提交版本为 c6e6c88f3ef75a4ce7acd660d6fa5779d995512c,核心库把论文公式拆成可测试的 PyTorch 原语。最有价值的对应首先是状态分析与合成。分析操作直接使用爱因斯坦求和,合成操作则显式计算伪逆:
# jepa-anything-core/src/jepa_anything_core/opf.py:149
def decompose_state(state: Tensor, basis: Tensor) -> Tensor:
    ...
    return torch.einsum("...d,krd->...kr", state, basis)

# jepa-anything-core/src/jepa_anything_core/opf.py:167
def compose_state(factors: Tensor, basis: Tensor) -> Tensor:
    ...
    synthesis = torch.linalg.pinv(flat)
    return torch.einsum("...a,da->...d", factors.flatten(start_dim=-2), synthesis)
这段代码与式 (3) 和式 (5) 一一对应。它还刻意把普通伪逆合成与专用于审计的转置合成分开:后者只有在基接近正交时才是精确的,因此它的误差可以反过来成为几何诊断指标。这种设计比只提供一个“投影并重建”函数更透明。
第二处关键对应是正则项。代码没有把正交性简化为因子样本之间的去相关,而是直接把 Gram 约束施加到学习到的分析方向上:
# jepa-anything-core/src/jepa_anything_core/losses.py:95
within_grams = torch.einsum("kad,kbd->kab", work, work)
within_penalties = (within_grams - identity).square().sum(dim=(-2, -1))

for first in range(num_factors):
    for second in range(first + 1, num_factors):
        cross_gram = work[first] @ work[second].transpose(0, 1)
        cross_penalties.append(cross_gram.square().sum())
代码还明确区分“几何正交”与“统计去相关”。前者约束投影方向,后者只描述样本协方差;二者都不自动证明因子具有因果或语义含义。这个边界与论文的科学主张一致:因子编号默认匿名,只有独立干预或外部实验才能给坐标赋名。
仓库提供 OrthogonalFactorProjection、projector_orthogonality_loss、factor_activity_loss、encoder_variance_loss、容量匹配基线和几何审计,并有针对 QR 初始化、伪逆合成、低精度、统计监控和边界条件的测试。但 README 同时声明,仓库不包含论文中的完整领域训练代码、数据集和模型权重,检查点示例也没有性能声明。因此论文实验与公开核心库之间存在清晰的复现边界。
实验设计与结果
论文把实验组织为三类。第一类是终端读出,模型只在一个任务读出器处结束:视觉绑定、单细胞表示和临床事件预测。第二类是潜世界动态,预测状态会被反复用于干预预测、六步或更长 rollout、PDE 和连续控制规划。第三类是科学分析,因子坐标被用于生物实验候选干预与轨道规律检验。
匹配比较尽量固定适配器、编码器、上下文和目标采样、优化预算、数据划分、下游读出及原始基础损失。标准 JEPA 使用单一目标嵌入,JEPA-Anything 增加 OPF 损失。不同域的 $d,K,r$ 会变化,但 $Kr=d$ 的完整分解合同保持一致。
| 任务域 | 潜状态 $d$ | 因子数 $K$ | 因子宽度 $r$ | 主要评价 |
|---|---|---|---|---|
| 视觉绑定,MuJoCo | 384 或 768 | 4 | 96 或 192 | 注入准确率、塌缩率、网格恢复 |
| 单细胞,Norman | 512 | 4 | 128 | AvgBIO、Pearson 相关 |
| 临床事件 | 768 | 4 | 192 | 超过 1000 类事件的 PRAUC |
| CITRIS 干预 | 160 | 5 | 32 | 一阶与六步四通道 MSE |
| 动态与 PDE | 128 | 4 | 32 | OOD、六步与长 rollout MSE |
| 连续控制 | 32 | 4 | 8 | CEM 真实环境回报 |
| 分子动力学 | 64 通道 | 4 | 16 | 一步 MAE、100 步 RMSD |
视觉实验使用 DINOv3 ViT-S 和 SigLIP2 Base,通过块掩码预测学习目标状态。在相同 learned-grid 读出下,JEPA-Anything 同时提高注入准确率和网格恢复,并降低塌缩率。DINOv3 的 INJ 从标准 JEPA 的 .572 提升到 .581,Coll. 从 .426 降到 .417,Rec. 从 .645 升到 .659;SigLIP2 对应为 .483 到 .490、.514 到 .503、.679 到 .688。
单细胞实验在约 80 万个人肾细胞上预训练,并在 PBMC-10K 上进行微调和零样本聚类,同时用 Adamson 与 Norman 数据评价扰动响应。结果如下:
| 模型 | PBMC 微调 AvgBIO | PBMC 零样本 AvgBIO | Norman Pearson | Adamson Pearson |
|---|---|---|---|---|
| scGPT | 0.7531 | 0.5288 | 0.631 | 0.905 |
| Cell-JEPA | 0.7830 | 0.7194 | 0.787 | 0.937 |
| JEPA-Anything | 0.8301 | 0.7752 | 0.814 | 0.942 |
这组结果不仅说明细胞类型聚类更好,也说明因子化预测改善了对未见扰动表达响应的泛化。临床任务使用同一批患者划分和事件词表,以 PRAUC 排名超过 1000 个未来事件;合成后的因子状态高于匹配的单体 JEPA。由于稀有事件很多,使用 PR 曲线比单纯准确率更合理。
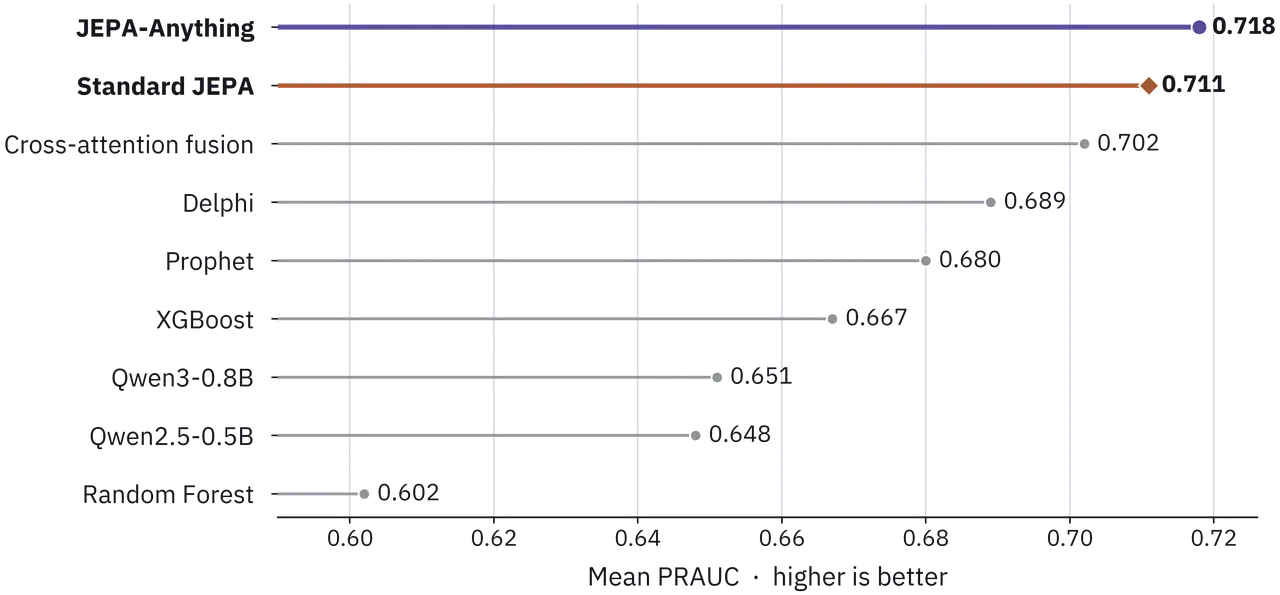
图 3:超过 1000 个未来临床事件的预测结果。所有方法使用相同患者划分和事件词表,以平均 PRAUC 排名。
CITRIS Interventional Pong 测试了单个干预和训练中未同时出现的组合干预。相对标准 JEPA,单干预一步 MSE 从 0.009541 降到 0.006218,下降 34.83%;组合干预从 0.009441 降到 0.008223,下降 12.90%;六步自由 rollout 从 0.009478 降到 0.008665,下降 8.58%。组合干预的改善说明模型并非只记住完整干预模式,而是能够重组已经学习过的状态变化。
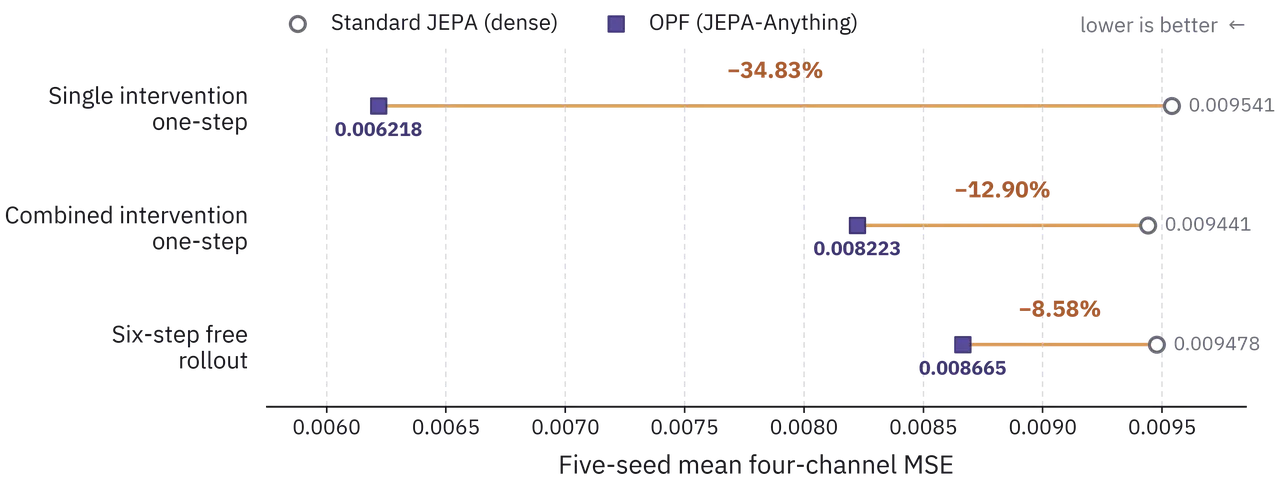
图 4:CITRIS Interventional Pong 的单干预、组合干预与六步自由 rollout。纵轴为四通道 MSE,越低越好。
机制审计进一步显示,非约束多头因子的跨子空间重叠为 0.4550,最小奇异值仅 0.00513,条件数高达 438.52,转置合成 NMSE 为 0.7886。正交因子版本把重叠降到约 $5.18\times10^{-16}$,最小奇异值提高到 0.999989,条件数约 1.00005,转置合成 NMSE 约 $2.98\times10^{-14}$。这里的意义不只是“数值更好”,而是多个预测分支能够组成非重叠、单位条件数且可稳定恢复的状态坐标。
十任务动态基准覆盖 CausalWorld、DeepMind Control、PDEBench 和 WeatherBench2,每个任务使用五个种子。四个代表性系统的六步误差都低于单体 JEPA。例如 PDEBench Burgers 的第一步 MSE 从 0.001830 降到 0.001101,第六步从 0.006369 降到 0.004014;浅水方程第一步从 0.007090 降到 0.003999,第六步从 0.010510 降到 0.006522。
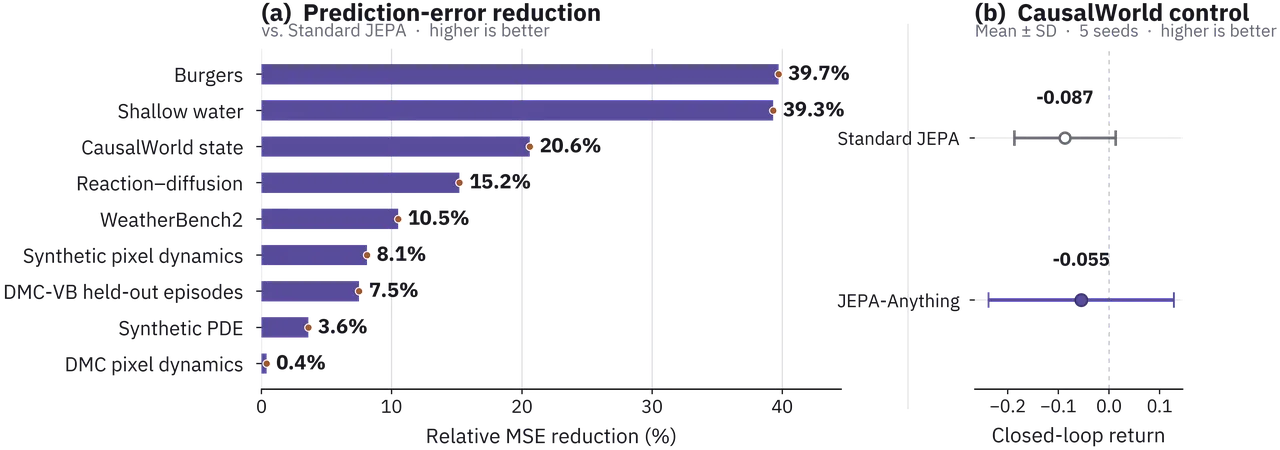
图 5:十任务动态基准。左图给出相对标准 JEPA 的 MSE 变化,右图给出 CausalWorld 闭环控制回报。
| 系统与指标 | 标准 JEPA | JEPA-Anything | 变化方向 |
|---|---|---|---|
| Burgers 后期保留集 MSE | 0.16621 | 0.08389 | 约降低 49.5% |
| Burgers 六步 MSE | 0.29186 | 0.16153 | 约降低 44.7% |
| Kuramoto–Sivashinsky MSE | 1.1012 | 0.9558 | 约降低 13.2% |
| 分子 100 步最优系统数 | 0/4 | 4/4 | 四种体系全部最佳 |
长 rollout 实验把 Burgers 扩展到 20 步和 50 步。JEPA-Anything 在分布内轨迹的 20 步误差降低 5.84%,50 步降低 3.15%;在高频 OOD 轨迹上分别降低 5.01% 和 2.82%。优势仍存在,但随预测步数增加明显缩小,说明正交状态接口减少了误差积累,却没有消除长期稳定性问题。
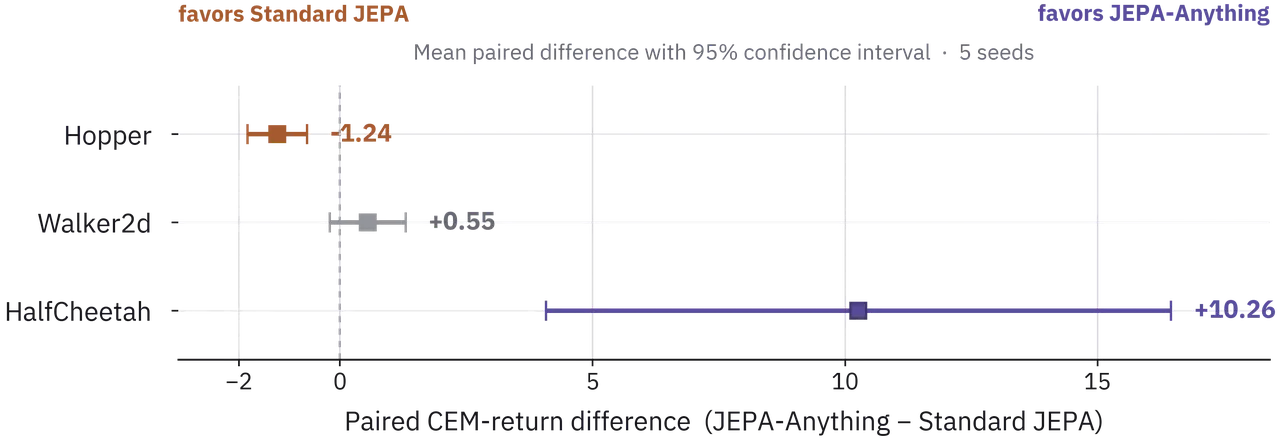
图 6:容量匹配的连续控制规划。正差值表示 JEPA-Anything 的 CEM 回报高于标准 JEPA,Hopper 上则相反。
连续控制的结果更具条件性。Walker2d 和 HalfCheetah 的平均 CEM 回报更高,Hopper 则由标准 JEPA 更好。因子干预实验仍显示四个八维子空间全部活跃:Hopper、Walker2d 和 HalfCheetah 的因子标准差分别处于约 0.692–0.715、0.587–0.601 和 0.673–0.678。把任一因子替换为训练均值都会增加 rollout 误差;在 HalfCheetah 中,F1 或 F3 的掩蔽在五个种子上都降低真实环境回报。
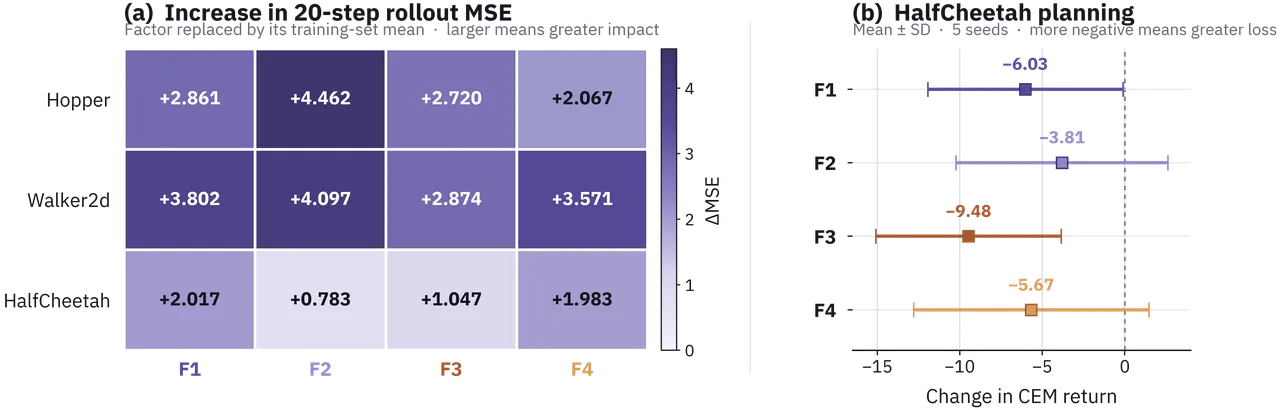
图 7:逐因子功能干预。左图显示 20 步 rollout 的误差增量,右图显示 HalfCheetah 真实环境中的 CEM 回报变化。
分子预测使用 TrajCast 风格等变模型,把 OPF 作用于 $l=1$ 扇区的 64 通道维度,并保持 $O(3)$ 等变。JEPA-Anything 在水的 100 步 RMSD 为 2.459,石英为 1.877,对乙酰氨基酚为 1.776,苯为 0.0645,四种体系的 MAE 和最终位置 RMSD 都最低。生物部分则从因子分析中提出 IL-18 联合 CD73 阻断,并在共培养、患者来源类器官、肿瘤碎片和免疫健全小鼠中观察到支持;轨道分析从无物理标签的轨迹中恢复 Kepler 关系 $f\propto a^{-3/2}$,拟合斜率为 -1.4991,$R^2$ 为 0.9999999。
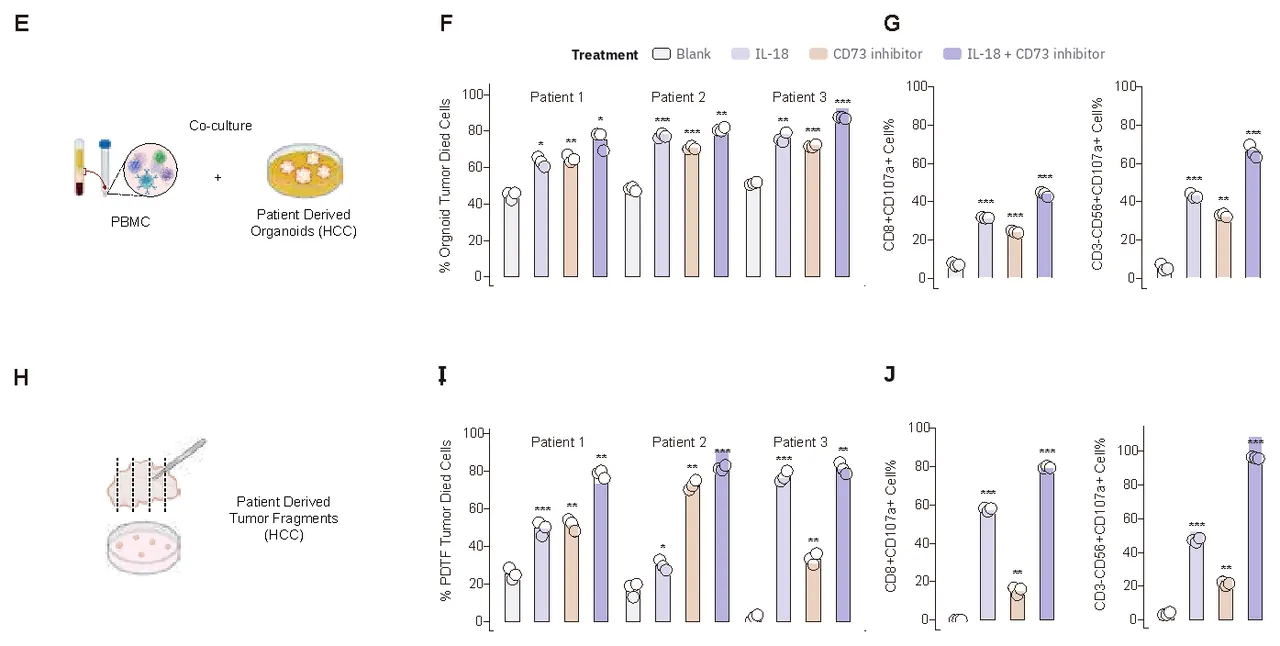
图 8:患者来源肝癌类器官和肿瘤碎片中的实验结果。IL-18 与 CD73 阻断组合在测试条件中呈现最强的肿瘤细胞杀伤。
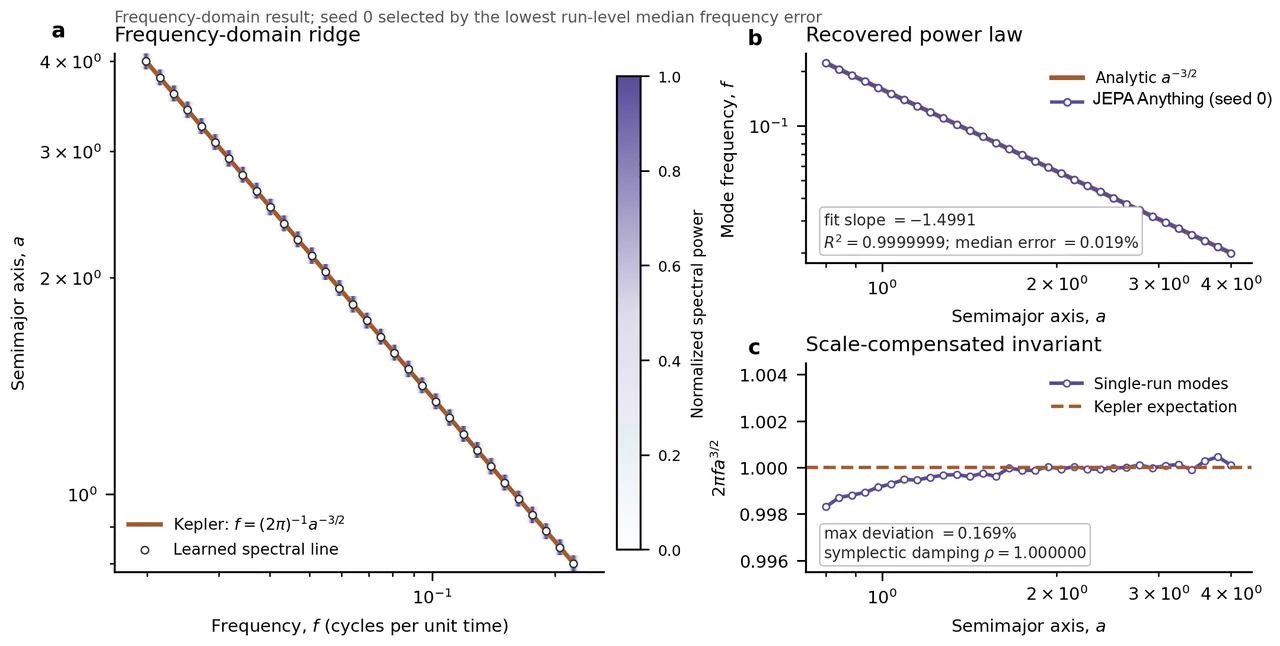
图 9:潜模态的物理规律检验。学习到的频谱模态恢复 Kepler 关系,拟合斜率为 -1.4991,决定系数接近 1。
讨论:这项工作真正改变了什么
从世界模型角度看,JEPA-Anything 的主要贡献不是把同一个 encoder 强行用于所有模态,而是把“如何分配预测容量”和“如何恢复完整状态”抽成统一层。不同系统仍然拥有不同观测、目标和 encoder;“Anything”描述的是接口与学习原则的适用范围,不是共享一份权重。
从机器人学习角度看,最直接的启示是预测器结构本身可以成为稳定 rollout 的一部分。若多个预测头占用的方向高度重叠,分析矩阵会病态,微小预测误差在状态合成时被放大。正交约束给出更接近单位条件数的坐标系统,再配合逐坐标活跃度下界,就得到可测量的“分支是否真的工作”的证据链。对于模型预测控制,这比单看一步预测损失更接近规划器真正需要的能力。
从科学发现角度看,论文没有把潜因子直接宣称为因果变量。它把因子作为候选分析接口,再用外部实验或已知物理规律检验。IL-18/CD73 的湿实验和 Kepler 规律测试分别提供了生物与物理方向的证据。这种态度很重要,因为正交、独立或低相关都不等于因果可识别。
局限与风险
第一,作者明确说明“Anything”并不意味着所有域共享同一个 encoder 或同一组权重。论文比较的是共同预测核心和状态接口;每个领域仍需要单独的数据、适配器、编码器、训练预算和领域基础损失。因此,跨域收益没有自动转化为零样本跨域迁移。
第二,公开仓库的范围小于论文。核心库包含 OPF、正则、基线和审计,但不提供论文中的数据集、完整实验管线或训练权重;检查点示例明确没有性能声明。复现者可以核验张量级方法契约,却不能仅凭仓库得到 Table 3 至 Table 9 的全部结果。
第三,连续控制结果依赖环境。JEPA-Anything 在 Walker2d 和 HalfCheetah 上提高平均回报,却未在 Hopper 上超过标准 JEPA。因子掩蔽证明各分支对动力学有用,并不能推出四个因子在所有任务上都同样高效。组合策略可能需要按环境调整 $K,r$ 或正则权重。
第四,长期误差仍会累积。Burgers 的 50 步优势小于 20 步优势,高频 OOD 改善也从 5.01% 缩到 2.82%。几何稳定只控制状态合成对因子误差的放大,不保证动力学模型本身在所有分布上准确。要用于安全关键控制,还需要分布外不确定性校准、闭环约束和失效检测。
第五,正交子空间并不具备天然语义。论文的湿实验和物理解释说明部分因子可以形成可检验假设,但另一些因子可能同时编码多个变量。任何把因子直接命名为“速度”“疾病”或“意图”的做法,都需要独立实验支持。
结论与展望
JEPA-Anything 把世界模型分解为两个层次:领域适配层负责把原始观测变成上下文和目标,OPF 核心负责把目标空间切成正交、活跃且可重新合成的预测因子。它用同一条损失和状态接口支持终端读出、递归世界动态、规划与科学分析,并在多个差异极大的系统中得到改善。
这篇工作的价值不只在于某个单项指标,而在于提供了一个可审计的设计原则。研究者可以检查因子是否正交、是否活跃、是否能恢复完整状态、是否真的被规划器使用,再进一步判断它们的科学含义。对具身智能而言,这为构建更稳定、更可诊断的世界模型提供了一条清晰路线;对跨学科世界模型而言,它把预测精度和外部实验连接成了可检验的证据链。