Dream-RSI:在演化世界中递归自我改进
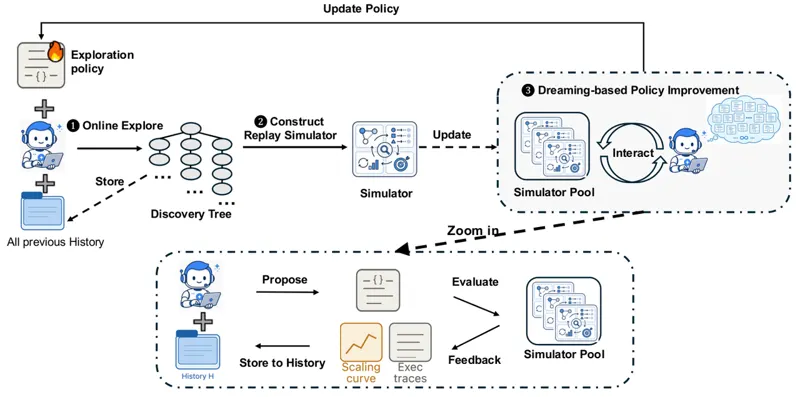
固定的探索策略无法随搜索空间扩大而自适应,在线优化元策略又要为每个候选策略付出昂贵的长程 rollout。Dream-RSI 把已完成的发现历史组织成发现树,当作可回放的世界:候选探索策略在树里“做梦”式重放,只读取已记录的执行结果即可被打分,再由策略开发智能体改写策略代码,选出回放分最高的版本重新上线,形成递归自我改进闭环。在 Lasso 求解器、三个数学优化问题与 KernelBench 四个 GPU 核任务上,它以少 1.7 倍到 162 倍的智能体调用取得同等或更好的发现质量。
Tong Zheng, Xidong Wu, Zheng Zhang2026年9月14日
递归自我提升世界模型LLM智能体2026年9月14日