DeWorldSG:基于世界模型先验的深度感知3D语义场景图生成
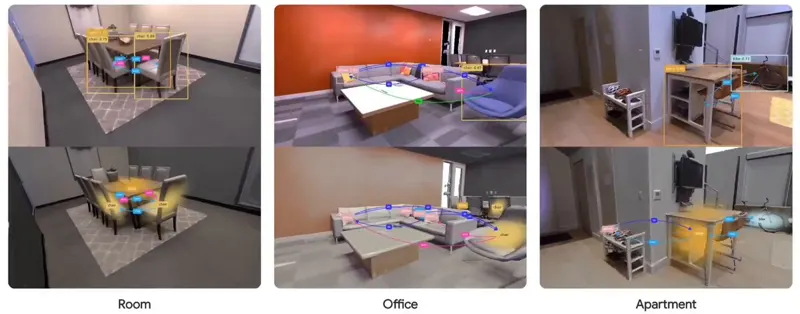
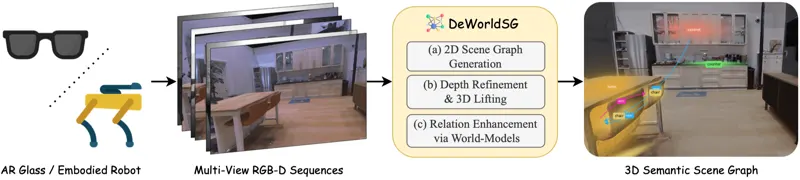
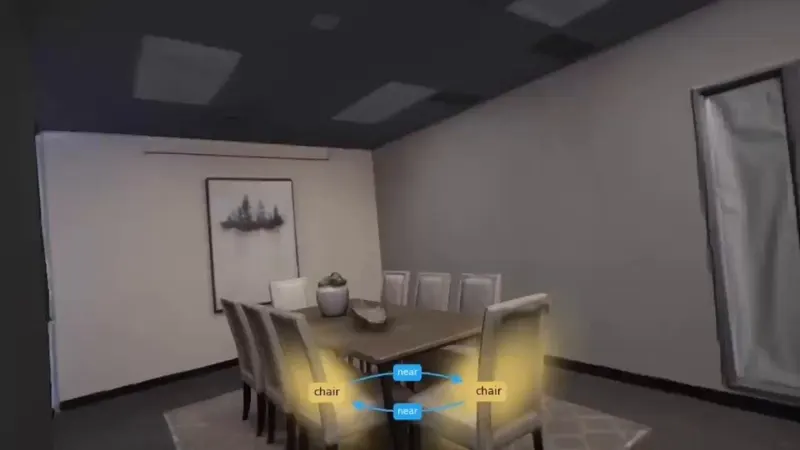
DeWorldSG从RGB-D序列生成时空鲁棒的3D语义场景图。通过深度引导滤波估计实例级几何3D高斯分布,将每个物体表示为概率3D节点而非单点投影;跨物体对聚合时空证据并用世界模型(V-JEPA 2)的上下文先验精炼关系。三元组召回率提升77.4%,谓词召回率提升23.2%。
Seok-Young Kim, Abdelrahman Elskhawy, Taewook Ha·2026年7月1日
场景图RGB-D 视觉V-JEPA 22026年7月1日
 0:48