Skip to content
← 标签

#宇树 G1 (70)

PanTact:用可穿戴接触接口教会人形机器人全身灵巧性

PanTact:用可穿戴接触接口教会人形机器人全身灵巧性

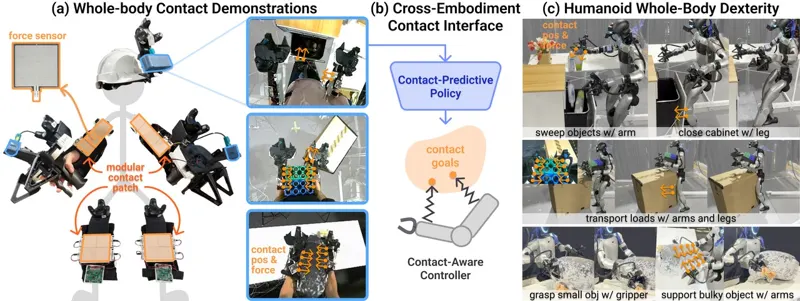
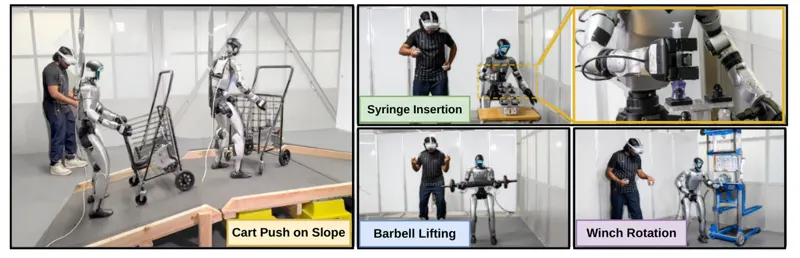
PanTact 把接触而不是关节轨迹当作人到机器人的迁移货币。可穿戴贴片由 44×44 mm 的 FSR 模块磁吸拼装,一块 50×50 mm 自研 PCB 以 1 kHz 同读 16 路,走带 CRC 的 RS-485 菊花链,每块贴片挂一个 Vive tracker 把传感器中心定位到世界系,接触状态按每通道自适应基线二值化,阈值 max(0.35β, r_min)。策略以身体遮蔽后的 3D 第一视角点云、双腕图像与本体感知为观测,10 Hz 预测 H=16 的动作块,内含 look-at 点、EEF 位姿与夹爪宽度、逐传感器接触目标(二值状态加 3D 位置)。控制器用软最小邻近距离 d(p,q)(T=0.02 m)把激活接触交给当前最近的机器人表面,并沿按压方向偏移 δ 形成虚拟目标以产生按压力,因此 G1 不装任何触觉传感器也能抱住物体。三种公式化实现各有代价:免训练的上身 IK、由 SONIC 执行稠密参考的 WBIK、PPO 在 4096 个仿真环境训 30k 迭代的稀疏接触跟踪器(50 Hz、29 关节、上身 8 / 全身 16 个接触槽)。29-DoF Unitree G1 实测:Grasp-and-Embrace 85%(上身 IK)与 80%(稀疏),Humanoid UMI 为 0;Sweep-and-Stow 端到端 90.63%,UMI++ 两阶段各 18.75%、端到端 0;Carry-and-Push 90% 对 40%。仿真回放消融显示加入接触目标后三种控制器接触距离都下降,EEF 精度几乎不受损。

Xu, Xiaomeng, Zhang, Han, Ruan, Zhian · 129次阅读 · 2026年10月8日
Whole-Body Manipulation触觉接触丰富操作2026年10月8日
生成、跟踪、改进:用 RL 微调运动生成器实现感知的多技能人形机器人运动

生成、跟踪、改进:用 RL 微调运动生成器实现感知的多技能人形机器人运动

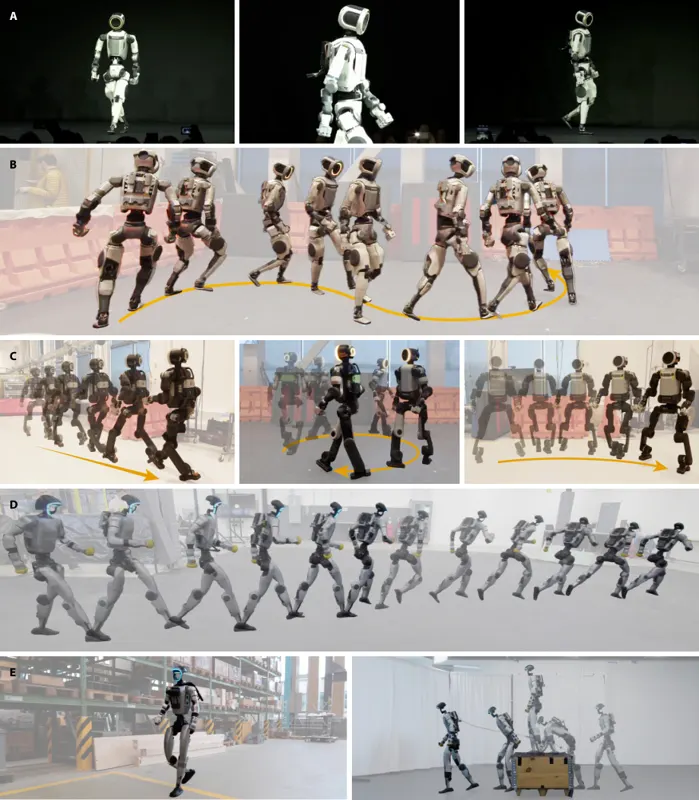
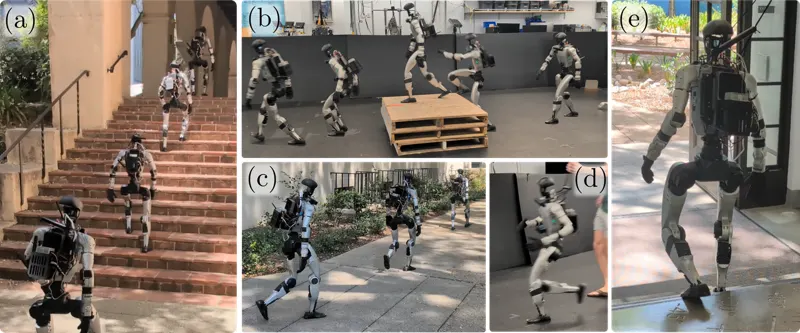
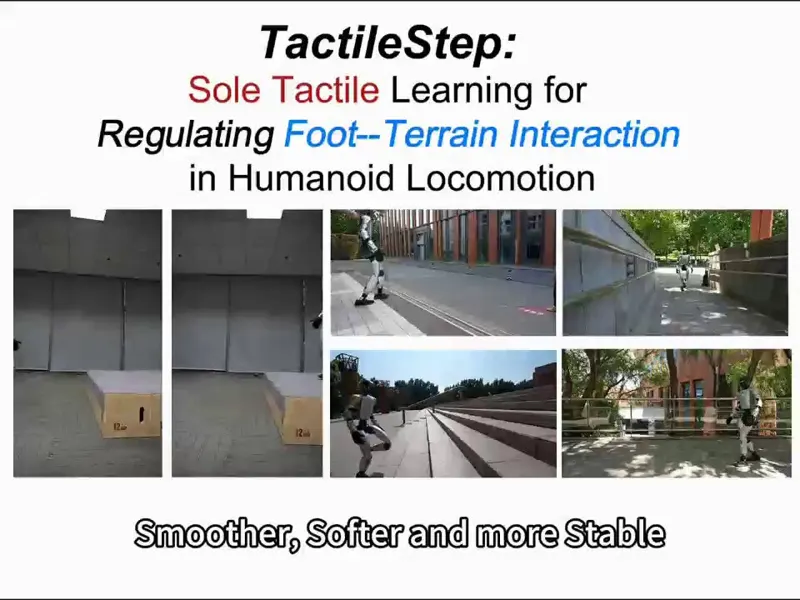
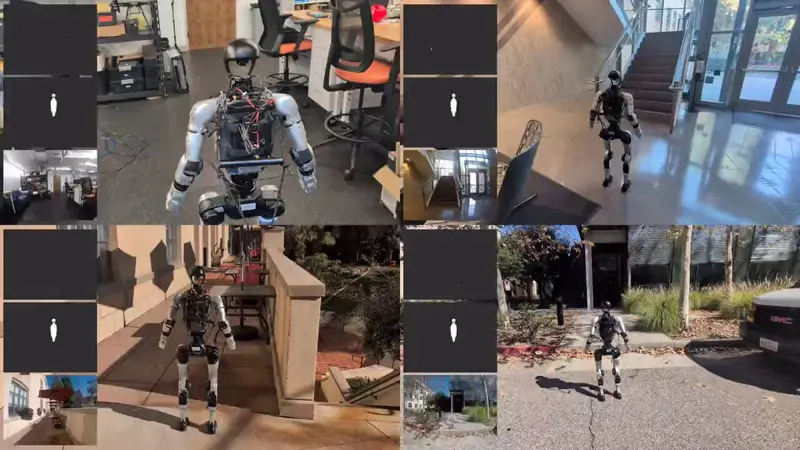
通用人形机器人需要的运动控制器必须同时具备多技能、感知、动态与足够的鲁棒性,才能去到人能去的地方。本文提出一个两层运动架构:(1)一个感知的流匹配运动生成器,从原始深度图规划全身轨迹;(2)一个用控制引导强化学习(CLF-RL)训练的感知跟踪策略,负责实时跟上这些动作。两张策略都训练在一个由动力学优化后的人体数据构建的、与地形一致的运动片段库上,因此既有准确的速度跟踪,又有与地形一致的参考。核心贡献是一个简单而有效的离线(off-policy)RL 微调环,用来改进运动生成器:配合生成器使用一种结构化搜索方法采数据,再做优势加权回归。这个离线环比在线的残差微调样本效率高得多,并且在没见过的几何与技能组合上提升了地形一致性——成功通过地形的比例最高提升 25 个百分点,技能选择最高提升 80 个百分点。因为直接用原始深度图感知环境,不需要里程计与高度图,室外部署很轻松;两个相机让策略能更早看到地形,无论指令速度是多少都能自主调速以通过地形。同一对策略让一台 Unitree G1 人形机器人在室外环境中行走、奔跑、站立、跳上跳下箱子并上下楼梯。项目主页:https://zolkin1.github.io/generate-track-improve/

Zachary Olkin, William D. Compton, Aaron D. Ames · 660次阅读 · 2026年9月25日
Humanoid LocomotionPerceptive Locomotion强化学习2026年9月25日
Rolling-WAM:把世界动作模型的去噪摊到每个重规划周期

Rolling-WAM:把世界动作模型的去噪摊到每个重规划周期

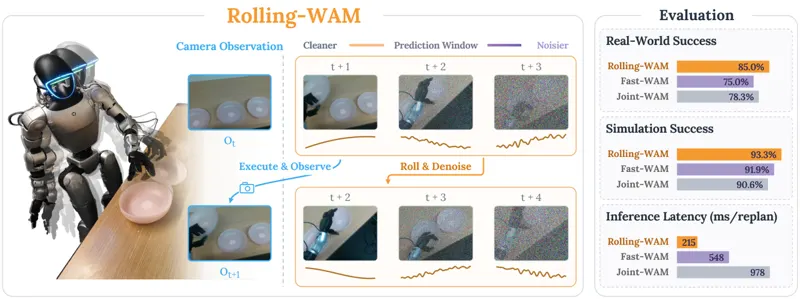
南加州大学、布朗大学、复旦大学与丰田研究院提出 Rolling-WAM。世界动作模型(WAM)把未来视觉预测与动作生成耦合,但标准做法要求每个重规划周期把整个预测视野从纯噪声完整去噪一遍,延迟巨大、闭环反应迟钝。作者指出 receding-horizon 控制实际只执行视野的开头一小段,未被执行的尾巴含有价值却被丢弃。Rolling-WAM 维护一个滑动窗口,窗口内越靠未来的 chunk 噪声越高:滚动模式下 chunk j 的噪声为 σ((j-1+τ)/W),第一个 chunk 在周期结束时变干净,且满足 σ_{j+1}(0) = σ_j(1) 的衔接条件,因此窗口前移后被保留的 chunk 恰好处于新位置的起始噪声,可直接接着去噪。每个 chunk 仍走满 N 步,但计算被摊到多个周期,稳态每周期只需 N/W 步。默认 N=10、W=5、K=16,即维持 80 个动作的预测窗口而每次更新只跑 2 步去噪。注意力掩码上,每个动作 chunk 可 attend 整个窗口的视觉特征,动作之间的直接注意力仅限同 chunk,视频 token 不 attend 动作 token,训练与推理一致。结果:稳态重规划 215 ms 对比 Joint-WAM 的 978 ms,加速 4.5 倍,比不做未来想象的 Fast-WAM(548 ms)还快,且比两个 VLA 基线(285/296 ms)更快;LIBERO 98.1%、RoboTwin 2.0 93.3%(全场最高,且无具身预训练即超过预训练的 LingBot-VA)、Unitree G1 真机三任务 85.0%。消融显示窗口 W=5 最优而 W=8 掉到 69.5%,且跨 chunk 直接动作注意力反而有害——动作应借道共享视觉未来协调。

Yinghua Zhou, Junjie Ye, Yiqi Zhao · 731次阅读 · 2026年9月24日
Rolling-WAM世界动作模型WAM2026年9月24日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。