PAPER DEEP DIVE
SteadyTray:冻结步态、只训残差,让人形边走边端稳托盘
人形边走边端托盘的难点不在走,而在托盘与物体之间没有任何刚性连接:脚底落地冲击沿运动链传到末端执行器,物体只靠摩擦与重力被动约束,转弯、加减速或被推时随时滑移、倾斜、翻倒。SteadyTray 提出 ReST-RL,把两件事在参数层面拆开:预训练步态基策略训练完即完全冻结,任何后续梯度都不许回流;残差模块由特权编码器(机器人线速度、托盘位姿与投影重力、物体位姿/线速度/角速度,输出 64 维特征)加零初始化适配器组成,既可在动作空间叠加残差修正,也可用 FiLM 逐层调制冻结基策略的激活。零初始化保证训练第 0 步与原策略逐位一致,不会先毁掉步态再重建。部署侧用 DAgger 只蒸馏编码器、适配器整体冻结,学生仅需本体感知加头部 RealSense D435 与 AprilTag 的物体位姿估计,把模仿难度从动作空间压到 64 维潜空间。Isaac Lab 仿真(8192 并行环境,2×RTX A6000)中:变速指令跟踪成功率 96.9%(冻结基策略 47.4%、端到端 89.1%),推机器人 84.6%(基策略仅 9.1%),推物体 74.6%;三种残差接法成绩接近,说明收益来自结构化残差解耦本身而非某种适配器形态。奖励曲线显示端到端总奖励不低,但物体直立奖励长期停在约 0.9,残差变体爬到约 1.8。观测延迟消融中,延迟训练在 0.00 到 0.06 秒全部档位领先,含零延迟档(90.2 对 78.4)。Unitree G1(29 自由度)零样本端起咖啡杯、装水红酒杯、手术器械与密封食品盒,抗踢抗推恢复由上下肢协调完成。局限:编码器只处理单个物体、不建模细粒度几何与物理属性;头部相机视场窄且固定,难以换持握姿态避障;纯 sim-to-real RL 依赖大量奖励塑形与仿真调校;评测未覆盖高重心、易滑动或软体载荷。
论文:SteadyTray: Learning Object Balancing Tasks in Humanoid Tray Transport via Residual Reinforcement Learning(arXiv:2603.10306v1,2026-03-11)
作者:Anlun Huang*、Zhenyu Wu*、Soofiyan Atar、Yuheng Zhi、Michael Yip(UC San Diego,* 为共同一作)
代码:已发布。GitHub 仓库 AllenHuangGit/SteadyTray(Apache-2.0),训练依赖其 IsaacLab 分支 AllenHuangGit/IsaacLab_SteadyTray,仓库内含四阶段训练任务、MuJoCo sim2sim 部署脚本与导出策略权重
内容类型:人形机器人双臂 loco-manipulation、残差强化学习、sim-to-real;实机平台为 Unitree G1(29 自由度)
一句话总结
SteadyTray 把「边走边端托盘」拆成两个可以分别优化的目标:冻结一个已经会走路的步态基策略,只训练一个由特权观测编码器加残差适配器组成的小模块去抵消步态传到手端的振荡,再用 DAgger 把编码器蒸馏成只吃相机观测的学生版;仿真中变速跟踪成功率 96.9%、抗外推成功率最高 84.6%,并在 Unitree G1 上零样本端起了咖啡杯、装水的红酒杯与手术器械。
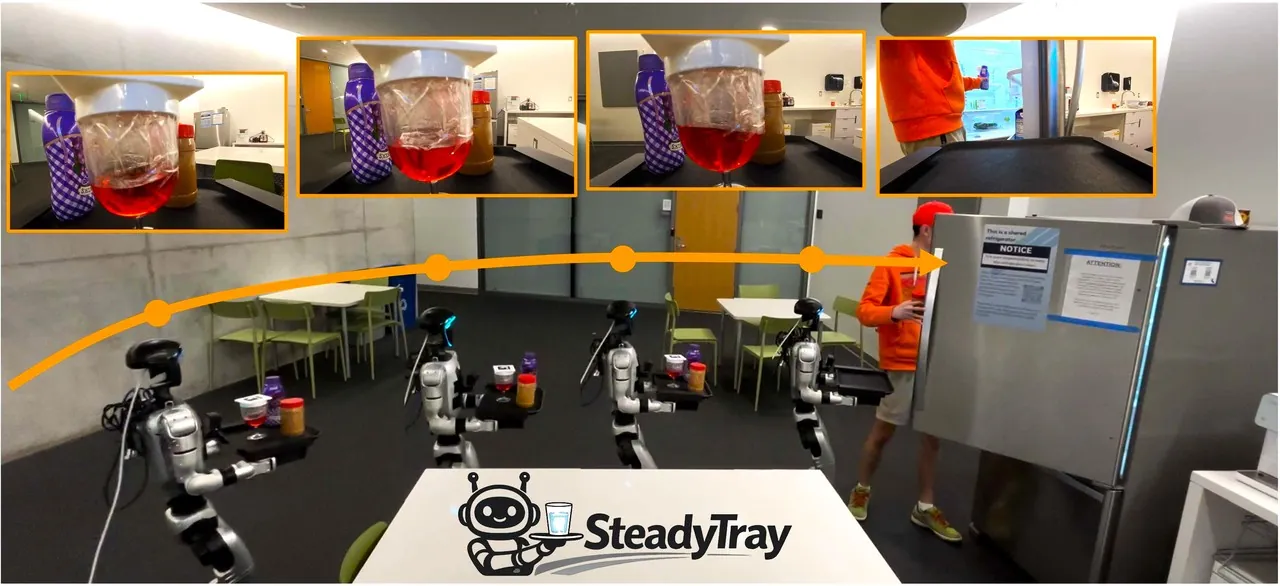
图一:论文 teaser。上排为仿真中托盘上物体的特写序列,下排为 Unitree G1 在办公环境端托盘行走的实机画面,载荷包含装液体的红酒杯。
研究背景与动机
论文从一个劳动力数字切入:2025 年 12 月美国雇主报告的医疗与社会援助岗位空缺为 125 万,住宿与餐饮服务为 81 万。送餐、手术室无菌器械转运、养老机构辅助这类任务的共同点是「移动」与「端持」同时发生,而且环境是为人类设计的:杂物、线缆、窄通道。轮式底盘在受到大扰动时无法产生主动稳定动作,四足平台的承载姿态也受限;双足人形凭借小平面足迹与主动稳定能力,被认为是这类空间里更合适的载体。
但「端」这件事比「走」难得多。行走时脚部落地冲击是躯干与底座振荡的主要来源,扰动沿运动链向上传递,上半身与步态必须同时自适应地抵消它。已有工作如 SoFTA 能在行走中抑制悬挂或固定在手上的单个物体的振荡,可那类物体与手之间是刚性或弹性连接;托盘上的物体没有任何连接,只靠摩擦与重力被动约束,转弯、加速、减速、被推时都可能滑移、倾斜、翻倒。论文明确指出:据其所知,此前没有任何方法在转弯、加减速或承受外推这类常见机动中,成功平衡过托盘上无固定的物体。
难点的物理本质是托盘引入了一层非刚性中间耦合:末端执行器调节的是托盘的运动,而物体只被被动约束。于是控制器面对一对目标冲突——既要生成敏捷的全身步态,又要让末端执行器姿态接近水平以稳住托盘与物体。把两件事塞进一个端到端策略里,梯度会互相拉扯;论文的实验部分恰好证实了这一点:端到端基线的总奖励并不低,但其中大部分来自行走项,物体直立奖励始终明显落后。
论文的回应是结构性的而非奖励性的:不重新设计一个更大的单体策略,而是承认「走路」与「稳物」是两种时间尺度与信息来源都不同的技能,用冻结加残差的方式把它们在参数层面分开。基策略负责不被自己绊倒,残差模块负责把步态传到手端的扰动主动消掉。这个分工同时带来工程上的好处:基策略可以复用社区已经验证过的行走训练配方,残差模块参数量小、训练快、且不破坏已有步态。
第三个动机来自部署。特权信息(物体在托盘坐标系下的速度、托盘的投影重力等)在仿真里唾手可得,在真机上并不存在。论文因此把「用特权信息学」与「用可部署信息跑」分成两步:教师阶段用特权观测训练残差模块,学生阶段只蒸馏编码器、适配器整体冻结,使真机策略的输入收缩到本体感知加头部相机对物体的位姿估计。这条教师—学生链路是 ReST-RL 名字里 Student-Teacher 的含义。
预备知识:残差强化学习与特权蒸馏
残差强化学习的通用形态是:保留一个已训练好的策略,在其输出或中间特征上叠加一个可学习的修正项,只训练修正项。它最初用于 sim-to-real 中补偿模型误差,后来被扩展到动作跟踪与协作搬运。它的价值在于把探索空间限制在「对已有行为的偏离」上:修正项零初始化时,系统行为与基策略完全一致,训练不会先毁掉已有技能再重建。
特权教师—学生蒸馏则是腿足机器人社区的标准做法:教师用仿真器才有的状态(线速度、接触力、物体真实位姿)训练,学生用可部署观测模仿教师。SteadyTray 的特殊之处在于蒸馏的对象不是整个策略而是残差模块里的编码器:适配器在教师阶段已经学会了「给定正确特征该如何修正」,学生只需要学会「从相机观测里估出同样的特征」。这把蒸馏问题的维度从动作空间压缩到 64 维潜空间,显著降低了模仿难度。
方法详解
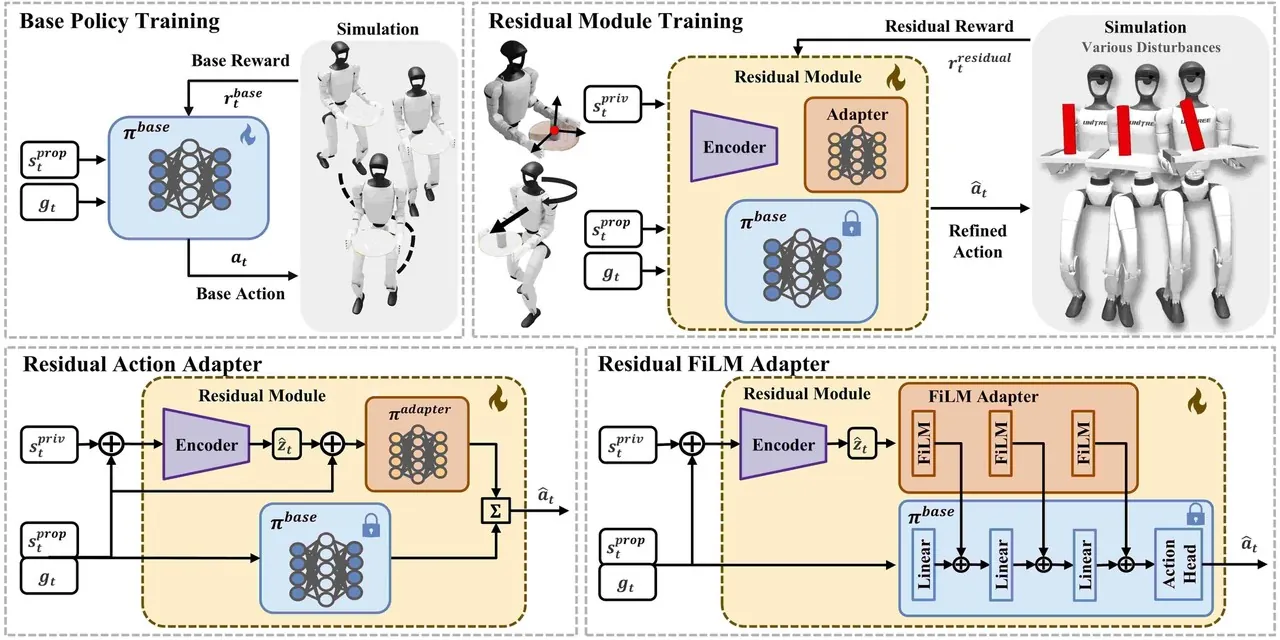
图二:ReST-RL 框架。左上为基策略训练,右上为残差模块训练(特权观测进编码器),下排为两种适配器接法:动作适配器在动作空间叠加修正,FiLM 适配器逐层调制冻结基策略的激活。
问题形式化:目标条件策略与三组观测
任务被写成目标条件强化学习:策略 $\pi:\mathcal{G}\times\mathcal{S}\to\mathcal{A}$,动作空间 $\mathcal{A}\subseteq\mathbb{R}^{n}$ 是全部人形关节的目标关节位置。时刻 $t$ 的目标 $\mathbf{g}_{t}=[\hat{\mathbf{v}}^{r_{x}}_{t},\hat{\mathbf{v}}^{r_{y}}_{t},\hat{\boldsymbol{\omega}}^{r_{\text{yaw}}}_{t}]$ 是期望的机器人线速度与偏航角速度。观测分两路:本体感知 $\mathbf{s}^{\text{prop}}_{t}=[\mathbf{q}_{t-H:t},\dot{\mathbf{q}}_{t-H:t},\boldsymbol{\omega}^{\text{r}}_{t-H:t},\mathbf{g}^{\text{r}}_{t-H:t},\mathbf{a}_{t-H:t-1}]$,含关节位置、关节速度、机器人角速度、投影重力与上一步动作的历史;物体观测 $\mathbf{s}^{\text{obj}}_{t}=[\mathbf{p}^{c}_{t-H:t},\mathbf{q}^{c}_{t-H:t}]$ 是物体在相机坐标系下的位置与四元数姿态。基策略用 $H=5$ 步历史,残差模块用 $H=32$ 步历史——长窗口是为了看见「逐渐失稳」的趋势,短窗口里这种趋势是不可见的。
第一阶段:冻结的步态基策略
基策略 $\pi^{\text{base}}:\mathcal{G}\times\mathcal{S}^{P}\to\mathcal{A}$ 先被训练成「端着空托盘也能走稳」:输入本体感知历史,输出目标关节位置,用 PPO 最大化折扣回报
$$\mathbb{E}\left[\sum_{t=1}^{T}\gamma^{t-1}r^{\text{base}}_{t}\right]$$
其中 $r^{\text{base}}_{t}=\mathcal{R}^{\text{base}}(\mathbf{g}_{t},\mathbf{s}^{\text{prop}}_{t})$ 包含速度跟踪、躯干稳定、脚部冲击、以及托盘—末端执行器的接触与朝向项。训练完成后基策略参数完全冻结:后续所有梯度都不允许流回它。这是全文最重要的一条工程约束——它保证残差模块无论学成什么样,名义步态性能都不会退化。
残差模块:特权编码器加两种适配器
残差模块由编码器与适配器组成。教师阶段的编码器吃特权观测 $\mathbf{s}^{\text{priv}}_{t}=[\mathbf{v}^{\text{r}}_{t-H:t},\mathbf{p}^{\text{tray}}_{t-H:t},\mathbf{g}^{\text{tray}}_{t-H:t},\mathbf{p}^{\text{obj}}_{t-H:t},\mathbf{v}^{\text{obj}}_{t-H:t},\boldsymbol{\omega}^{\text{obj}}_{t-H:t},\mathbf{g}^{\text{obj}}_{t-H:t}]$,即机器人线速度、托盘位置与投影重力、物体的位置/线速度/角速度/投影重力,再拼上本体感知与目标,输出 64 维特征 $\hat{\mathbf{z}}_{t}=\phi(\mathbf{s}^{\text{priv}}_{t},\mathbf{s}^{\text{prop}}_{t},\mathbf{g}_{t})$。适配器有两种实例化。
第一种是残差动作适配器:它从 $[\hat{\mathbf{z}}_{t};\mathbf{s}^{\text{prop}}_{t};\mathbf{g}_{t}]$ 直接回归一个修正动作 $\tilde{\mathbf{a}}_{t}$,与基动作叠加后送低层控制器:
$$\hat{\mathbf{a}}_{t}=\alpha_{\text{base}}\,\mathbf{a}_{t}+\alpha_{\text{residual}}\,\tilde{\mathbf{a}}_{t}+\mathbf{q}_{\text{default}} \quad (1)$$
其中 $\alpha_{\text{base}}$、$\alpha_{\text{residual}}$ 是两路动作的缩放,$\mathbf{q}_{\text{default}}$ 是默认关节位置。第二种是残差 FiLM 适配器:它不改动作,而是对冻结基策略内部的每个线性层做逐特征仿射调制。对输出为 $\mathbf{y}=f(\mathbf{x})$ 的冻结层,适配器由 $\hat{\mathbf{z}}_{t}$ 预测 $(\boldsymbol{\gamma}_{t},\boldsymbol{\beta}_{t})$ 并计算
$$y^{\prime}_{i}=y_{i}\bigl(1+\gamma_{t,i}\bigr)+\beta_{t,i},\quad i=1,\dots,d \quad (2)$$
两种适配器都零初始化:训练开始时修正恒为零,系统行为与基策略逐位相同,步态技能被完整保留;随着训练推进,修正项才逐渐长出任务特异性。PPO 联合优化编码器与适配器参数,最大化 $\mathbb{E}[\sum_{t}\gamma^{t-1}r^{\text{residual}}_{t}]$。论文特意同时实现两种结构,是为了回答「收益来自残差这个结构,还是来自某一种具体接法」——实验给出的答案是前者。
特权蒸馏:只蒸编码器,适配器整体冻结
特权观测在真机上不存在,因此需要学生版。蒸馏用 DAgger 进行,且只作用于编码器:学生编码器 $\phi^{\prime}$ 仅吃物体观测(32 步历史)加本体感知与目标,输出 $\mathbf{z}_{t}=\phi^{\prime}(\mathbf{s}^{\text{obj}}_{t},\mathbf{s}^{\text{prop}}_{t},\mathbf{g}_{t})$;冻结的适配器把 $\mathbf{z}_{t}$ 映射为学生动作 $\hat{\mathbf{a}}^{\text{student}}_{t}$。教师编码器对同一 rollout 输出 $\hat{\mathbf{z}}_{t}$,经同一个冻结适配器得到教师动作 $\hat{\mathbf{a}}^{\text{teacher}}_{t}$。学生用联合损失训练:
$$\mathcal{L}=\mathcal{L}_{z}+\mathcal{L}_{a}=\|\mathbf{z}_{t}-\hat{\mathbf{z}}_{t}\|_{2}^{2}+\|\hat{\mathbf{a}}^{\text{student}}_{t}-\hat{\mathbf{a}}^{\text{teacher}}_{t}\|_{2}^{2} \quad (3)$$
潜空间对齐保证学生估出的特征与教师同分布,动作对齐保证即使特征有偏差、最终行为也要贴近教师。适配器冻结意味着教师阶段学到的「特征到修正」的映射被原封不动搬到真机,蒸馏误差只可能来自编码器一侧,问题被刻意做小了。
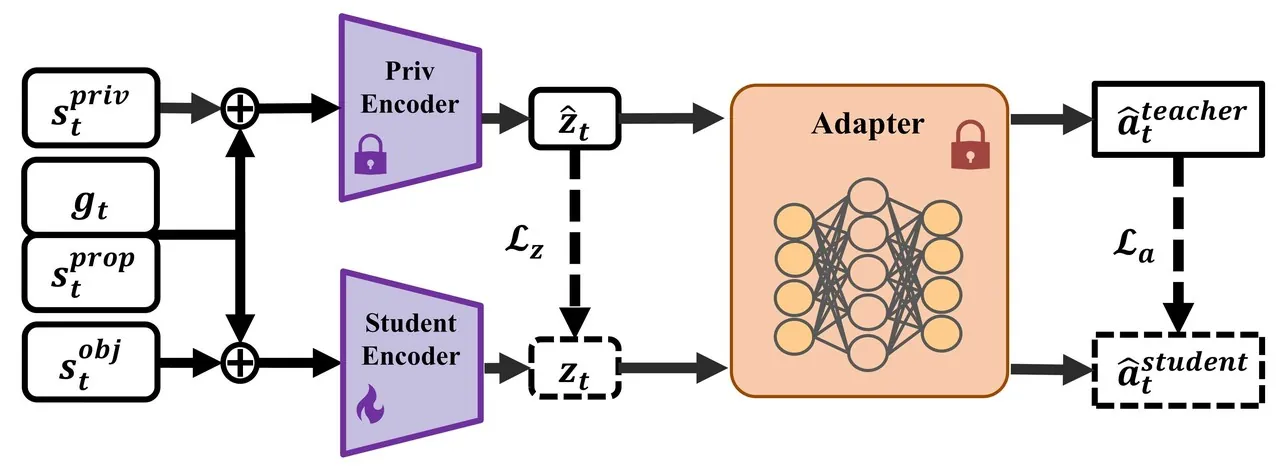
图三:蒸馏结构。教师编码器(冻结,紫色锁)吃特权观测,学生编码器吃物体观测,两者经同一个冻结适配器输出动作,损失为潜空间 L2 与动作 L2 之和。
随机化、控制延迟与观测延迟
训练对机器人、托盘、物体三者的质量、摩擦、恢复系数以及躯干质心做域随机化,并引入控制延迟以覆盖执行与通信时延。物体用不同尺度的圆柱体采样,初始位置在托盘中心附近加随机水平偏移与偏航,避免过拟合固定初始构型;每个 episode 的第一秒速度指令置零,给物体一个稳定的初始化窗口;训练中对物体施加随机推扰,逼残差模块学会恢复行为。
最值得注意的是观测延迟:只对物体相关观测 $(\mathbf{s}^{\text{obj}}_{t},\mathbf{s}^{\text{priv}}_{t})$ 引入延迟 $\ell_{t}$,使残差模块在时刻 $t$ 读到 $t-\ell_{t}$ 的测量值,且采样到的延迟会保持若干步以模拟时间相关的感知时延。理由是物体感知的时延天然高于本体感知。消融显示这个看似只为 sim-to-real 服务的 trick,连零延迟情形都一起提升了——模型被迫学会用历史而非瞬时值做估计,本身就提高了稳定性。
奖励设计:稀疏物体奖励与三阶段课程
奖励分两层。基奖励 $r^{\text{base}}_{t}$ 沿用社区成熟的行走项(速度跟踪、躯干竖直速度与滚俯仰角速度抑制、脚部冲击、关节限位与动作速率正则),并加入托盘项:托盘—末端接触指示、托盘—末端四元数误差、托盘直立与托盘速度抑制。腰关节偏离只被轻罚,因为过严的腰约束会削弱政策用上体主动补偿扰动的能力。物体奖励 $r^{\text{obj}}_{t}$ 刻意稀疏,只有两项:
$$r^{\text{obj}}_{t}\supset \exp\!\big(-\lambda_{\text{upright}}\big\|\mathbf{P}_{xy}\big(\mathbf{g}^{\text{obj}}_{t}\big)\big\|_{2}^{2}\big)+\mathbf{1}_{\{\text{object\_tray\_contact}\}}$$
即物体自身重力投影的横向分量越小越好(物体越直立),以及物体与托盘保持接触。不给位置或速度目标,是为了让适配器在推扰下自己发现恢复策略,而不是模仿一个预设轨迹。残差模块的总目标是 $r^{\text{residual}}_{t}=r^{\text{base}}_{t}+r^{\text{obj}}_{t}$。
训练分三阶段继承式推进:阶段一预训练行走,阶段二加入托盘保持奖励微调,阶段三加入物体稳定奖励训练残差模块,每一阶段继承前一阶段全部奖励项并按需修改或关闭个别项。失败条件(托盘或物体掉落、倾角过大)不用立即终止,而是延迟超时:条件持续违反 1.0 秒后才截断 episode。这既保留采样效率,又让策略看见失败后的状态并学会在其中保持行走稳定——真机上未见过的物体状态可能触发异常行为,这一点对安全部署至关重要;同时截断 episode 保留价值函数自举,评论器不会把失败后状态错误地学成零回报。
阶段一还有一个加速技巧:上半身课程损失。全身策略的动作空间太大,优化器会同时探索步态与上体动作而收敛缓慢。论文在 PPO 损失上追加一项,惩罚指定上半身关节索引集合 $\mathcal{J}_{\mathrm{upper}}$ 上动作分布的均值与标准差:
$$\mathcal{L}_{\mathrm{upper}}=\alpha\left(\frac{\sum_{b,j}\mu_{b,j}^{2}}{|\mathcal{B}||\mathcal{J}_{\mathrm{upper}}|}+\frac{1}{2}\cdot\frac{\sum_{b,j}\sigma_{b,j}^{2}}{|\mathcal{B}||\mathcal{J}_{\mathrm{upper}}|}\right) \quad (4)$$
对 $\mu$ 的 L2 惩罚把上体动作推向默认姿态,对 $\sigma$ 的惩罚抑制在这些关节上的探索,使早期梯度全部留给下肢;$\alpha$ 可按课程衰减,且该正则只在阶段一使用,后续阶段释放上体去学习端托与稳物。
方法流程总览
flowchart TD
  S1["阶段一 预训练行走
上半身课程损失冻结上体
PPO 优化基策略"]
  S2["阶段二 托盘保持微调
加入托盘直立 接触 四元数对齐奖励"]
  S3["阶段三 残差教师训练
基策略冻结
特权编码器 + 动作或FiLM适配器
零初始化 PPO"]
  S4["阶段四 DAgger 蒸馏
适配器冻结
学生编码器只吃相机物体观测
潜空间与动作双对齐损失"]
  DEP["真机部署 Unitree G1
头部 RealSense D435 + AprilTag
估计物体位姿"]
  S1 --> S2 --> S3 --> S4 --> DEP
  S3 -.->|"冻结基策略"| S4
  OBS["特权观测 物体速度 托盘重力"] --> S3
  CAM["可部署观测 物体位姿 本体感知"] --> S4
实验结果
仿真在 Isaac Lab 中进行,实机为 29 自由度 Unitree G1,末端执行器为托盘专门设计:它们托住托盘并部分约束其运动,但托盘与任何一端都不刚性连接——这正是任务难处的来源。真机物体位姿由贴在物体上的 AprilTag 与 G1 头部 RealSense D435 相机估计。评测三个任务:Command Track(每 10 秒重采样速度指令)、Push Robot(行走中对外力推机器人躯干)、Push Object(推物体);episode 长 20 秒,推扰每 5 秒触发一次。指标为成功率(物体全程直立且在托盘上)、线速度/角速度跟踪误差、以及 Grav-XY(物体局部坐标系下重力单位向量 xy 分量的 L2 范数,0 为完全直立,接近 1 为几乎水平)。
主结果见表一。三个任务上所有 ReST-RL 变体都大幅压低 Grav-XY 并抬高成功率,而跟踪误差与基线相当——说明稳定性收益不是以牺牲跟令为代价换来的。Command Track 上 FiLM WB 达到 96.9% 成功率、Grav-XY 0.046;Push Robot 上 FiLM WB 84.6%、Action WB 73.4%,而基策略只有 9.1%、端到端 44.0%;Push Object 上 FiLM WB 74.6%、Action WB 71.3%,基策略 25.2%、端到端 50.2%。三种残差接法(FiLM WB、Action WB、Action JT)成绩接近,论文据此把收益归因于「以物体特征为条件的结构化残差适配」这一结构本身,而非某一种适配器形态。
| 任务 | 方法 | TrackLinErr (m/s) | TrackAngErr (rad/s) | Grav-XY | 成功率 (%) |
|---|---|---|---|---|---|
| Command Track | Base Policy (WB) | 0.110 | 0.078 | 0.179 | 47.4 |
| Command Track | End2End | 0.116 | 0.096 | 0.046 | 89.1 |
| Command Track | ReST-RL (Action WB) | 0.093 | 0.081 | 0.029 | 95.9 |
| Command Track | ReST-RL (Action JT) | 0.160 | 0.135 | 0.031 | 96.7 |
| Command Track | ReST-RL (FiLM WB) | 0.106 | 0.069 | 0.046 | 96.9 |
| Push Robot | Base Policy (WB) | 0.162 | 0.110 | 0.190 | 9.1 |
| Push Robot | End2End | 0.170 | 0.123 | 0.055 | 44.0 |
| Push Robot | ReST-RL (Action WB) | 0.146 | 0.110 | 0.039 | 73.4 |
| Push Robot | ReST-RL (FiLM WB) | 0.142 | 0.094 | 0.043 | 84.6 |
| Push Object | Base Policy (WB) | 0.110 | 0.079 | 0.186 | 25.2 |
| Push Object | End2End | 0.117 | 0.099 | 0.049 | 50.2 |
| Push Object | ReST-RL (Action WB) | 0.096 | 0.084 | 0.023 | 71.3 |
| Push Object | ReST-RL (FiLM WB) | 0.107 | 0.073 | 0.040 | 74.6 |
表一:Isaac Lab 仿真主结果(论文表 II 摘选,均值列)。三个任务使用相同的速度指令;Grav-XY 越低物体越直立。
端到端基线的失败模式被奖励曲线解释得很清楚:它的平均总奖励与 ReST-RL 相当甚至更早爬升,但物体直立奖励长期停在约 0.9,而 ReST-RL 两个变体爬到约 1.8。总奖励里行走项占大头,端到端策略用行走分数掩盖了稳物失败;结构化残差则把优化压力集中到物体上。图四与图五并排是全文最有说服力的一组图,因为它把「为什么不能端到端」从观点变成了可测量的证据。
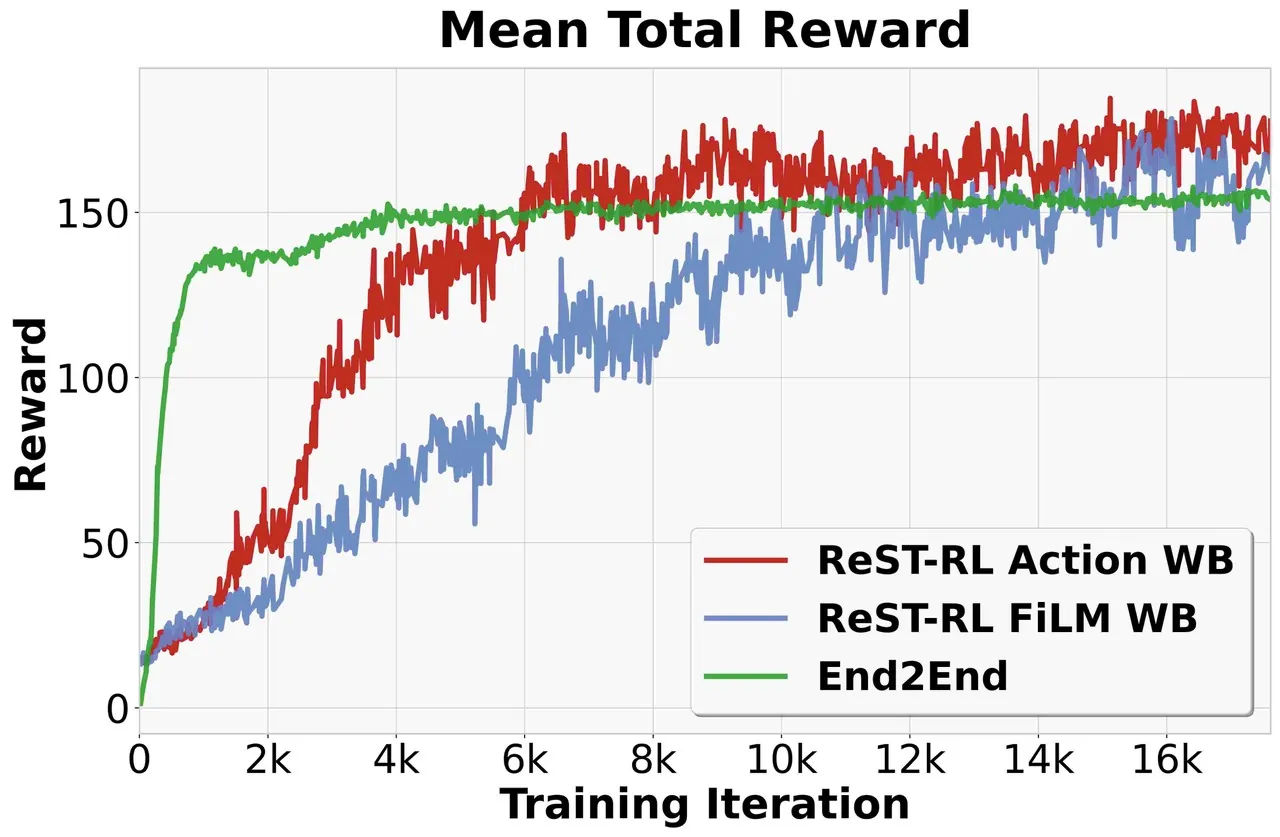
图四:平均总奖励训练曲线。End2End(绿)最早爬到约 150 的平台,ReST-RL 动作适配器(红)在约 6k 迭代后反超并最终最高,FiLM 适配器(蓝)收敛最慢、后期追平——只看总奖励看不出稳物失败,需与图五并读。
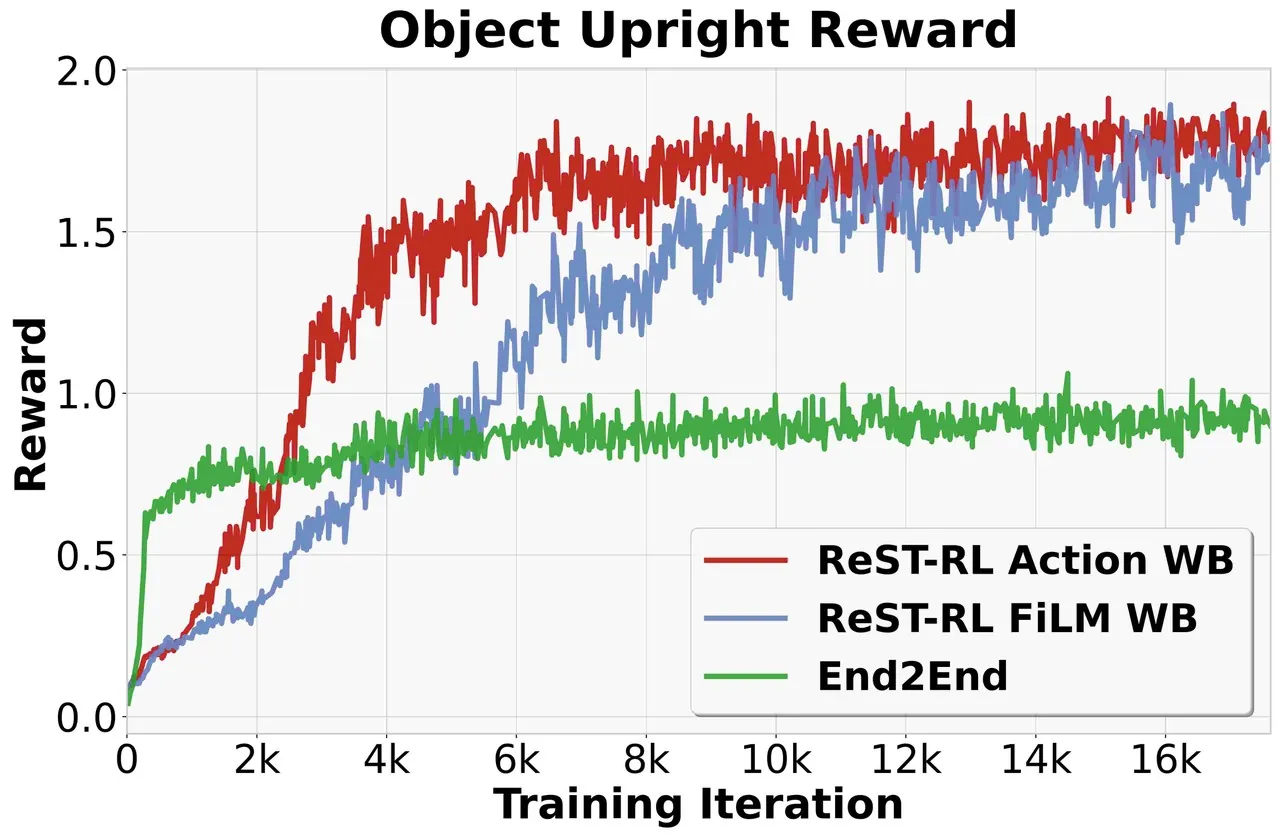
图五:物体直立奖励训练曲线。End2End(绿)长期停在约 0.9,ReST-RL 动作适配器(红)与 FiLM 适配器(蓝)爬到约 1.8,说明端到端优化的总奖励掩盖了稳物目标的失败。
观测延迟消融见表二。在 Push Robot 任务下,对感知时延 0.00/0.02/0.04/0.06 秒四档评测,用延迟训练的策略在每一档都胜出,包括零延迟档(90.2 对 78.4);时延增大到 0.06 秒时差距扩大到 78.3 对 55.2。也就是说延迟随机化不仅服务于 sim-to-real,还让策略学会在信息不完整时做时序一致的估计,本身就是一种正则。
| 观测延迟 (s) | 用延迟训练 成功率 (%) | 不用延迟训练 成功率 (%) | 差值 (百分点) |
|---|---|---|---|
| 0.00 | 90.2 | 78.4 | +11.8 |
| 0.02 | 88.4 | 68.1 | +20.3 |
| 0.04 | 83.7 | 61.0 | +22.7 |
| 0.06 | 78.3 | 55.2 | +23.1 |
表二:观测延迟消融(论文图 5 读数,Push Robot 任务)。延迟训练在全部时延档位上领先,含零延迟档。
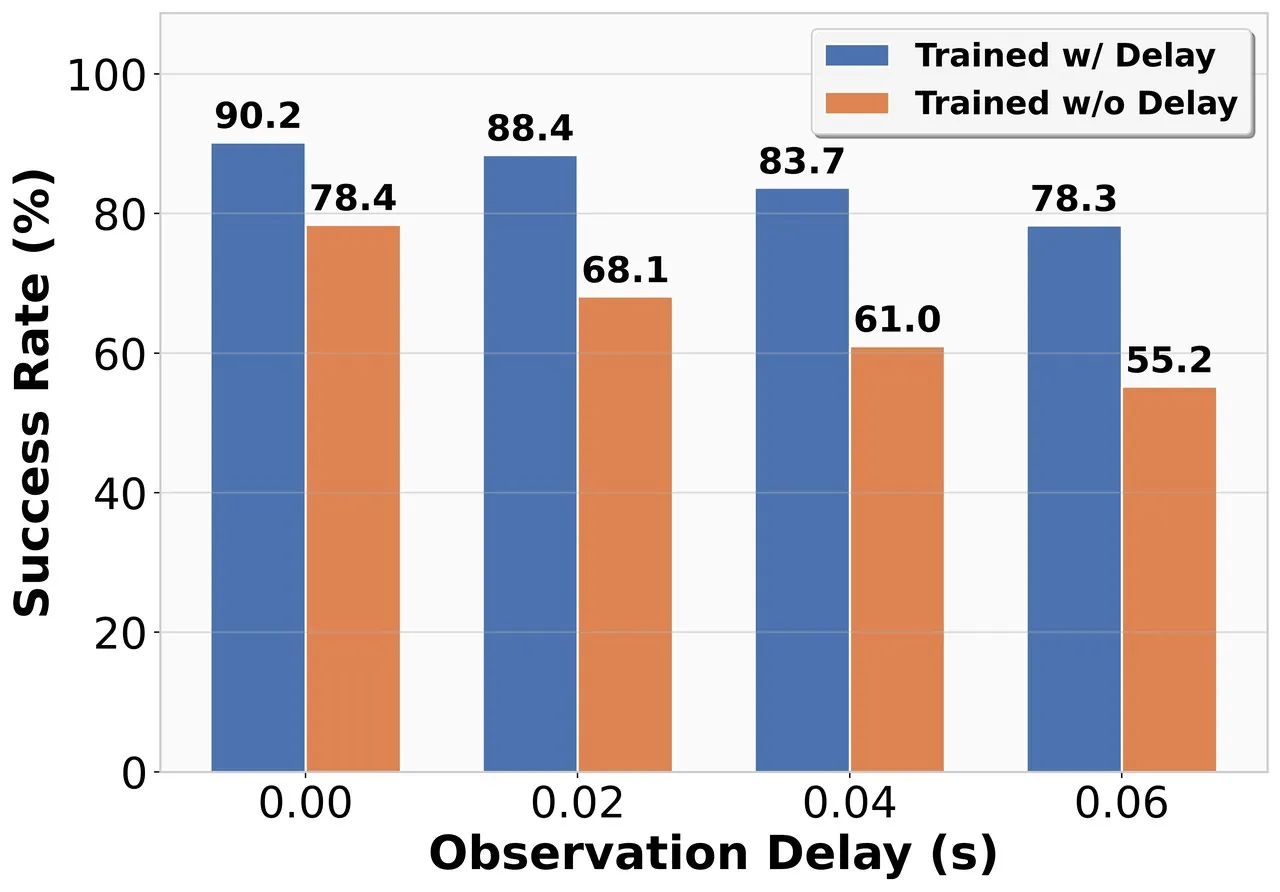
图六:观测延迟消融。横轴为评测时注入的感知时延,蓝为用延迟训练、橙为不用;差距随评测时延单调扩大。
扰动鲁棒性用极坐标成功率图呈现:对推机器人任务,按推力方向(前/后/左/右及其间)与幅值(32/65/98/130 N 环)网格化评测,整体成功率 77.8%,仅在极端推力下中等程度退化;正文给出的均值为推机器人 74.4%、推物体 73.9%。速度跟踪与恢复曲线则显示躯干速度在指令切换与外推(约 10 秒、13 秒推机器人,约 16 秒推物体)后快速回到指令值,物体速度紧随其后,没有持续振荡。
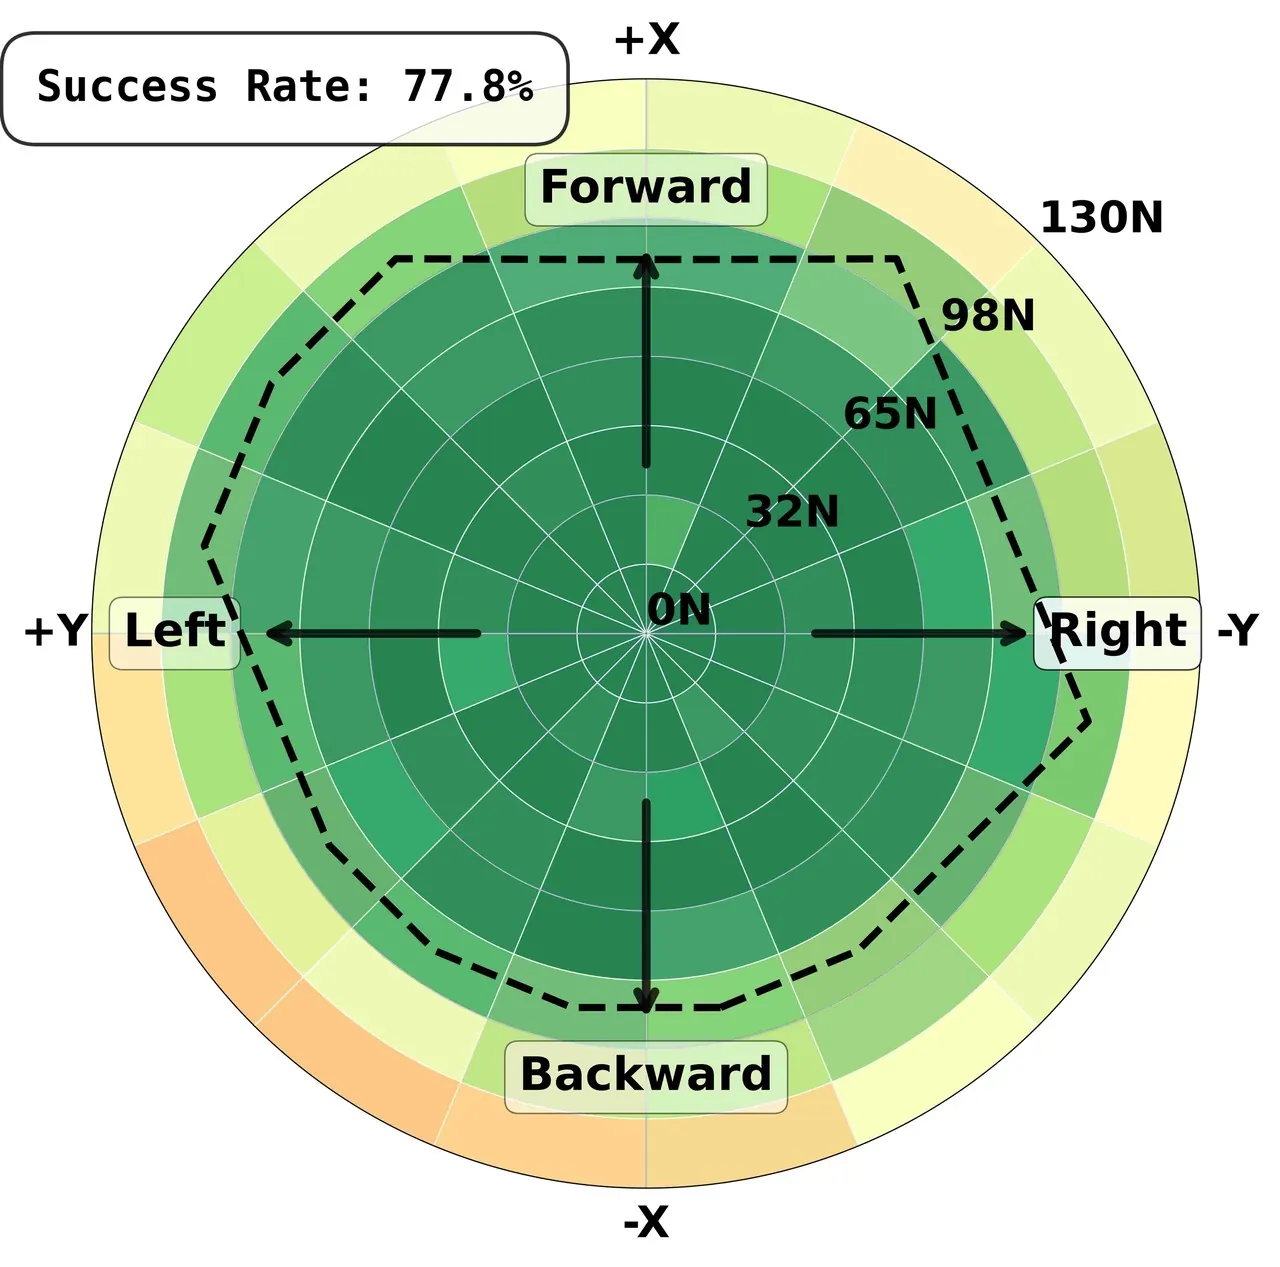
图七:Push Robot 任务下按推力方向与幅值的成功率极坐标图,环为 32/65/98/130 N,整体成功率 77.8%。
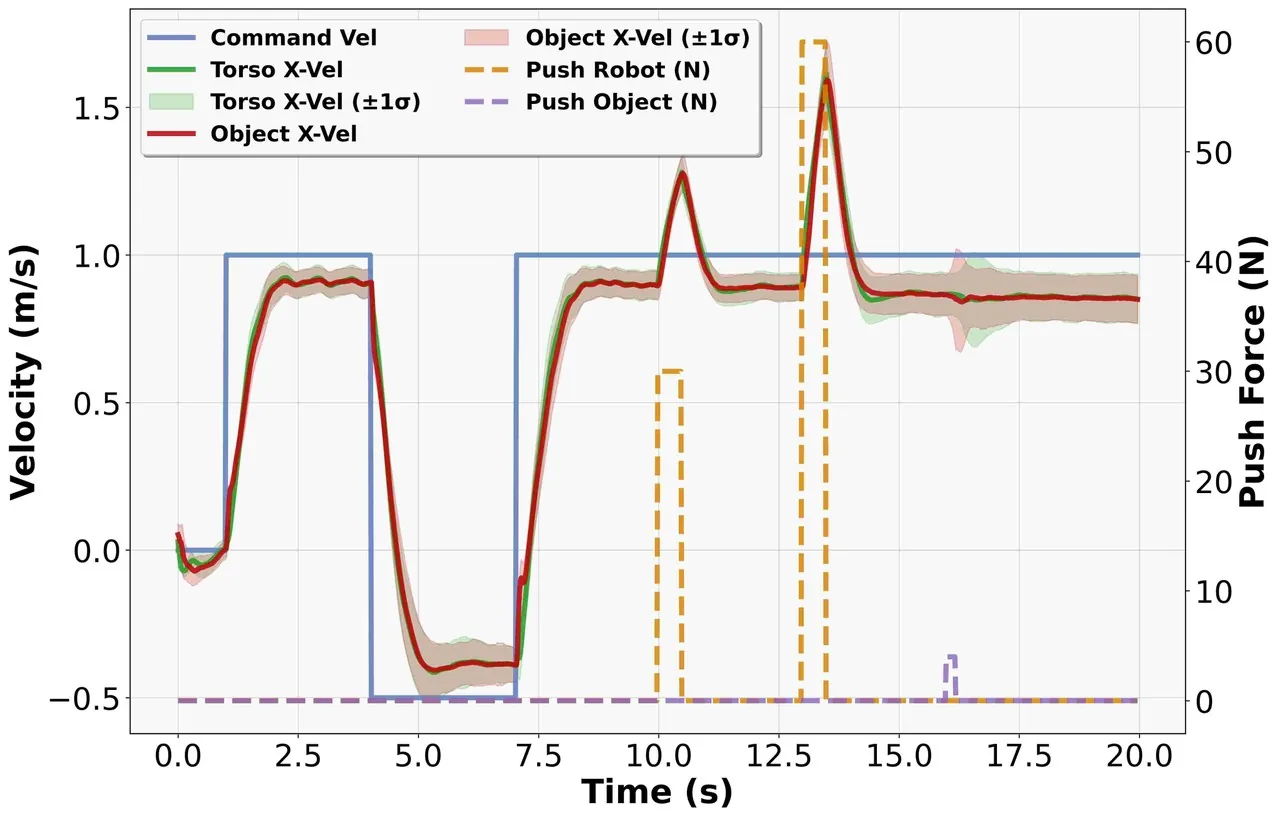
图八:指令切换与外推下的躯干/物体速度响应。推扰造成的速度尖峰在约一秒内被吸收,物体速度与躯干速度保持紧耦合。
物体尺度泛化方面,论文按圆柱半径—高度比扫描成功率:在很宽的长径比范围内成功率保持高位,只在极端细长(比值 0.1)时中等下降。真机部分更具冲击力(图一下排):同一策略零样本端起标准咖啡杯、装水红酒杯、医疗与手术器械、密封食品盒,质量分布、几何与接触属性各不相同,无需重训或微调;对机器人踢踹与对物体推压两种扰动下,恢复动作由上下肢协调完成,且没有突兀的纠正动作。
训练配置
教师与蒸馏阶段都在 2 块 NVIDIA RTX A6000 上跑,每 GPU 4096 个并行环境、共 8192,每环境 24 步。基策略与适配器主体 MLP 为 [512, 256, 128];Transformer 历史编码器上下文维度 64、2 层、4 头;FiLM 适配器隐层 128、$\gamma$ 截断 ±3.0;动作适配器残差 MLP [512, 256, 128]。PPO 用 $\gamma=0.99$、GAE $\lambda=0.95$、clip 0.2、价值系数 1.0、熵系数 0.01、目标 KL 0.01、5 个 epoch、4 个 mini-batch、梯度范数上限 1.0。蒸馏学习率 $5\times10^{-5}$、1 个 epoch、梯度范数上限 0.5、MSE 损失。
代码对应:论文方法在仓库里的落点
官方仓库 AllenHuangGit/SteadyTray 给出了完整训练管线与 sim2sim 部署代码,论文方法可以逐条对应到源码。式 (2) 的 FiLM 调制在 scripts/rsl_rl/adapter/adapter.py 的 FiLMAdapter.forward 中实现,且代码比论文多两个细节:调制网络末层零初始化之外还有一个可学习门控 $\alpha$(初值 0.1),以及 $\gamma$ 的截断(配置表给 ±3.0),即实际公式为 $y^{\prime}=y(1+\alpha\gamma)+\alpha\beta$;基线性层的 requires_grad 被显式关闭,对应论文的「冻结」。式 (1) 在同一个文件的 ResidualActionAdapter.forward 中:残差 MLP 的输入是上下文嵌入与本体感知的拼接,末层零初始化,输出经门控 $\alpha$ 后加到基动作上。
式 (3) 的双项损失在 scripts/rsl_rl/adapter/distillation.py 的 update() 中:embedding loss 与 action loss 各以系数 1.0 加权(embedding_loss_coef / action_loss_coef),教师 latent 与教师动作均值在 rollout 时缓存并 detach,优化器只更新学生编码器参数;DAgger 的 $\beta$ 从 1.0 线性退火到 0.0,控制 rollout 时使用教师动作的概率。历史编码器在 scripts/rsl_rl/adapter/encoder.py,TransformerEncoder 的默认参数(ctx_dim=64、num_layers=2、num_heads=4)与论文表 VI 完全一致。四阶段训练对应 README 中的四个任务名:G1-Steady-Tray-Pre-Locomotion、G1-Steady-Tray、G1-Steady-Object、G1-Steady-Object-Distillation,阶段二到四各自 resume 上一阶段 checkpoint;部署侧 deploy/deploy_mujoco 提供 MuJoCo sim2sim 验证。
局限性
作者自述的第一条限制是物体编码:当前编码器只处理单个物体,且不捕捉细粒度几何与物理属性,作者建议未来接入基础位姿估计模型或视觉强化学习来改善物体表示。第二条是硬件带来的感知限制:头部相机视场窄且固定,使「换一种持握姿态端物体」变得困难,而杂乱场景中避开碰撞往往正需要替代持握姿态。第三条更宏观:纯 sim-to-real 强化学习依赖大量奖励塑形与细致的仿真器调校,对接触丰富的 loco-manipulation 任务而言这条路会越来越不实用。
从读者视角还可以补两条。其一,仿真评测的物体是随机尺度的圆柱体,真机展示物体虽多样但都是近似轴对称或盒状的稳定几何,对高重心、易滑动或软体载荷(如一摞纸、一碗汤)的行为没有量化;成功率是二值的「全程不倒不掉」,不区分「晃了一下但稳住」与「纹丝不动」,而后者恰恰是送餐场景里液体洒出的决定因素。其二,对照系缺少模型基方法:托盘稳物在轮式与 aerial manipulation 上有模型基协调控制的先例,论文只与学习基基线比较,无法说明残差 RL 相对模型预测控制的样本效率与上限差距。
总结与展望
SteadyTray 的贡献可以概括为三层:定义了一个此前没有被正式攻克的任務——双足行走中平衡托盘上无固定物体;给出一个结构上把行走与稳物解耦的残差教师—学生框架,并用消融证明收益来自解耦本身而非某种适配器形态;以及一组让 sim-to-real 成立的训练细节(观测延迟、控制延迟、延迟超时终止、上半身课程),其中观测延迟被证明连仿真内的稳定性也一起提升。作者展望的延伸方向是更广义的 loco-manipulation:行走中的开门、推车等接触丰富任务,以及在保持预训练步态不变的前提下引入视觉或触觉反馈做全身自适应。
对工程实践而言,这篇论文给出的可复用资产很具体:冻结基策略加零初始化残差适配器的组合,是任何「已有行走策略、想加新上体技能」项目的低风险起手式;只蒸馏编码器而冻结适配器的做法,把特权蒸馏的模仿难度压到 64 维潜空间;延迟超时终止则是一个容易被忽视但对真机安全重要的细节。仓库放出四阶段训练脚本与 checkpoint,使这套配方可以被直接复现与改造。
金句
「托盘不是载荷的容器,而是一层非刚性耦合:它把每一次落脚的冲击,原封不动地递给上面那个没有任何固定的杯子。」
「端到端策略的总奖励并不难看——难看的是被总奖励遮住的那条物体直立曲线。」