PAPER DEEP DIVE
Embodied-R1.5:用统一具身基础模型演化物理智能
Embodied-R1.5 把具身认知与空间推理、任务规划与纠错、具身指认与定位三个能力维度统一进单个 8B 模型:三条自动化数据管线构建 150 亿 token 语料,多任务均衡 RL 配方化解异构任务冲突,PGC 闭环框架让单模型自驱完成长程任务。24 个具身 VLM 基准拿下 16 项 SOTA,平均超 Gemini-Robotics-ER-1.5 达 17 分;挂轻量动作头少量数据微调即成 VLA,SimplerEnv 92.4%、LIBERO-Plus 74.0%,四套操作基准全面超过依赖大规模动作预训练的强基线。
一句话总结
Embodied-R1.5 把「具身认知与空间推理、任务规划与纠错、具身指认与定位」三个能力维度统一进一个 8B 模型:用三条自动化数据管线造出 150 亿 token 的训练语料,配一套多任务均衡 RL 配方化解异构任务冲突,再以 Planner-Grounder-Corrector 闭环让单个模型自驱完成长程任务全流程——24 个具身 VLM 基准拿下 16 项 SOTA,平均超 Gemini-Robotics-ER-1.5 达 17 个百分点;因为具身推理已经内化,接一个轻量动作头微调少量数据就成了 VLA,四套操作基准全面超过靠大规模动作预训练的 π0.5 等强基线。
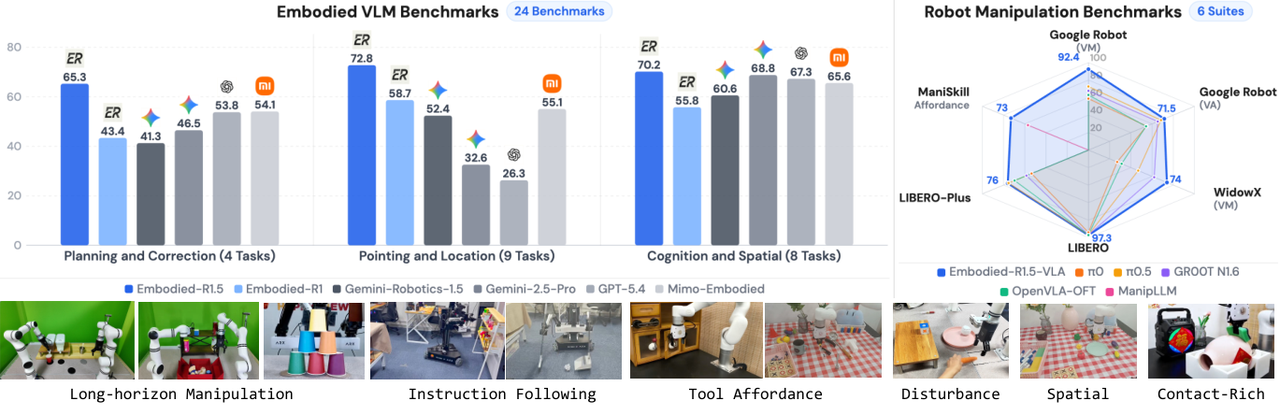
图 1:Embodied-R1.5 全景。上:24 个具身 VLM 基准成绩概览;下:从基础模型到 VLA 的能力演化路径。
研究背景:统一具身基础模型的三个瓶颈
大语言模型在数字世界大获成功,但把智能扎根物理世界、实现通用物理智能仍是核心挑战。作者主张通向物理智能需要的是一个具身基础模型(Embodied Foundation Model, EFM):所有能力都以物理为根基,感知、推理与执行统一在单一架构内。EFM 所需能力可归纳为三个维度:
- 具身认知与空间推理——理解物理世界的语义与空间结构:空间关系、度量推理(距离/尺寸/容纳性)、单目深度与跨视角几何、以机器人为中心的对象与场景认知;
- 任务规划与纠错——覆盖执行全生命周期:长程任务分解、下一步规划,以及过程监测(完成判定)、错误定位与错误纠正;
- 具身指认与定位——把高层推理落到坐标与轨迹:开放词汇指认、功能部件定位(OFG)、物体流与末端执行器流的视觉轨迹生成(VTG),甚至 3D 空间轨迹。
而实现统一 EFM 有三个现实瓶颈:(1)能力碎片化——现有模型各管一段,有的专注认知、有的专注规划纠错、有的专注指认,跨维度的尝试(如 RynnBrain)也要靠多个不同规模的模型拼起来;(2)多任务冲突——长文本推理、轨迹预测、多样指认的输出格式差异巨大,联合训练收敛困难,不同能力互相侵蚀;(3)缺少长程闭环验证——多数工作停留在具身问答层面,没验证推理能力在长程复杂决策下是否真正扎根物理。
方法
统一能力与架构
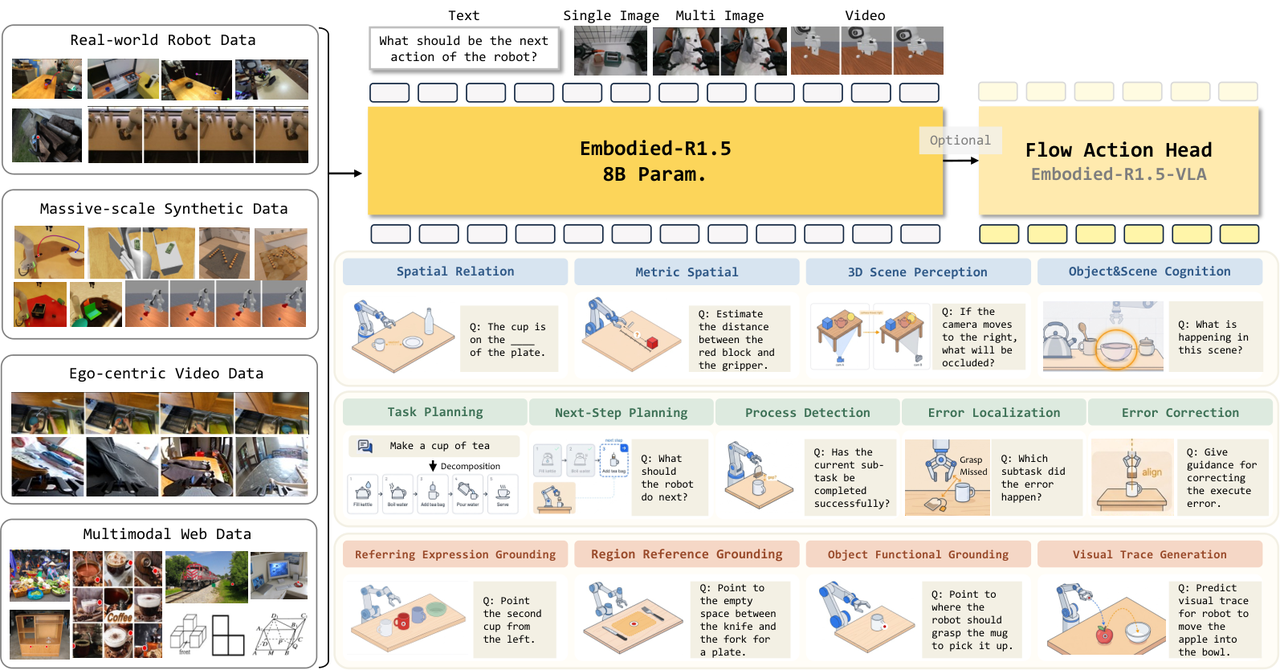
图 2:Embodied-R1.5 的能力分类学与架构。三个能力维度构成从感知到决策到执行的递进推理链。
模型基于 Qwen3-VL-8B-Instruct,8B 参数平衡了推理能力与部署成本。所有输出——坐标、轨迹、自由文本推理——统一表达为纯文本 token 序列:坐标归一化输出,轨迹为有序坐标序列。与依赖特殊 token 输出坐标的方案相比,直接生成数字坐标文本预测更稳定且词表开销可忽略;坐标还能在多步推理中作为可反复引用的符号,保持视觉锚定。
进一步可扩展为 Embodied-R1.5-VLA:在 VLM 主干上挂一个基于 DiT 的轻量流匹配动作专家,构成双系统架构——System 2 负责推理,System 1 负责动作生成。动作专家从 VLM 中间层提取视觉-语言特征,经动作分块生成连续动作序列。核心假设是:当 VLM 已充分内化具身推理能力时,大规模动作预训练变得不再关键,更强的具身主干会大幅降低下游动作学习的数据需求。
三条自动化数据管线:150 亿 token
训练语料整合 34 个数据集、超 150 亿 token。开源数据覆盖不到的关键能力缺口,由三条自动化管线补齐:
管线 1:3D 场景标注(空间推理)。整合多视角时空推理、度量深度、机器人视角认知数据后,仍缺桌面级细粒度操作空间推理。ER1.5-Spatial(2 万样本)全自动构建:从真实机器人场景 RGB 图像重建 3D 语义场景图——链式调用双后端语义理解、MoGe-2 度量尺度单目几何估计、Grounded-SAM 开放词汇实例分割、RANSAC 水平面配准,每层嵌套质量控制——再从场景图程序化生成空间推理 QA 对。
管线 2:失败感知标注(规划与纠错)。现有规划数据只给成功示范,没有结构化失败标注。ER1.5-Correction(80 万样本)沿两个正交维度组织:按阶段分规划失败/执行失败,按认知层级分检测/定位/纠正——三级恰好对应闭环自主执行的完整纠错链。规划失败用五种结构化扰动算子(步骤遗漏、冗余、交换、对象错误、动作替换)对正确计划施扰并同步生成三级 QA;执行失败用视频截断、描述替换、物理引擎扰动注入来模拟。数据横跨真实(BridgeData V2、RoboFail、RoboFAC)与仿真(ManiSkill、GEMBench),全部经过扰动有效性验证、正负样本平衡与人工抽检。
管线 3:功能可供性与轨迹(指认)。真实世界部件级标注极贵,靠大规模数据增广突破:从仿真(ManiSkill-PartNet、PRISM)合成功能部件定位数据,并把多个异构可供性标注源统一重组为 OFG 训练格式;另构造 RegularRearrangement 数据——规则排列图案缺 1-2 个元素,要求模型推理补全位置,把空间推理与指认能力熔于一炉。轨迹方面,有 3D 末端位姿的数据集直接投影到 2D 像面;无元数据的用微调的 Detectron2 末端执行器检测器跟踪夹爪;物体轨迹用 Co-Tracker3 跨帧跟踪。值得注意的是:轨迹数据不要求高保真仿真——低保真仿真数据依然带来强泛化(语义泛化),因为 VTG 学的是运动的拓扑结构与方向语义而非渲染保真度。最终 ER1.5-Pointing 含 40 万样本。
两阶段训练:SFT + 多任务均衡 RFT
阶段 1(SFT):从 Qwen3-VL-8B 出发全参数微调,所有异构输出统一为 token 序列在同一个因果语言建模目标下联合优化 1 epoch;视觉编码器与 LLM 主干联合训练不冻结——具身场景的视觉分布与通用预训练差异显著,需要深度适配。
阶段 2(RFT):GRPO 直接用于异构多任务会遇到两个失衡——任务内,组级标准差归一化使更新偏向低方差样本,中等难度样本(学习信号最强)反而欠优化;任务间,奖励尺度差异巨大,高密度任务支配梯度。论文的多任务均衡配方五管齐下:
- 难度感知数据筛选:用 SFT 检查点的 rollout 通过率过滤语料,保留 20 万中等难度样本;
- 动态过滤:组内 rollout 奖励全同的退化组自动检测并屏蔽,保证梯度只来自有区分度的样本;
- 全局批奖励归一化:优势用组内均值保序、用整个混合批次的标准差统一梯度量级——无需任务标签或历史状态,比 EMA-GRPO 的逐任务滑动平均在数据量悬殊时更稳;
- 五族奖励函数:精确匹配(0/1)、IoU(空间定位)、点距离(分段线性衰减)、轨迹 RMSE(连续)、语义相似度(RM 打分),连续奖励统一用分段线性衰减给部分得分,避免二值奖励的稀疏性;
- 优势估计与全局批归一化:优势写为 $A_i = \frac{r_i - \bar{r}_{\text{group}}}{\sigma_{\text{batch}}}$,组内均值保留组内相对排序、全局批次标准差统一跨任务梯度量级;
- 分段线性衰减奖励:给定距离度量 $d$ 与阈值对 $(\underline{d}, \bar{d})$,$$R(d) = \begin{cases} 1 & d \le \underline{d} \\ \frac{\bar{d} - d}{\bar{d} - \underline{d}} & \underline{d} < d < \bar{d} \\ 0 & d \ge \bar{d} \end{cases}$$ 该部分得分为 RL 提供密集梯度;
- IoU 奖励(空间定位):$$R_{\text{IoU}} = \frac{|B_{\text{pred}} \cap B_{\text{gt}}|}{|B_{\text{pred}} \cup B_{\text{gt}}|}$$
- 轨迹 RMSE 奖励(VTG):对预测与真值轨迹线性插值到等采样点数后 $$R_{\text{traj}} = f\!\left(\sqrt{\frac{1}{N}\sum_{k=1}^{N}\lVert \hat{\tau}_k - \tau_k \rVert^2}\right)$$ 三维轨迹的深度维以 MAE 独立评估后等权平均;
- 自适应思考:只约束输出格式不强制推理链。由于奖励只评最终答案,模型自发学会了按需分配算力——指认这类感知任务几乎零思考开销直接出坐标,复杂规划任务则生成结构化思考过程。这种涌现的自适应计算分配恰好对齐具身需求:高频定位要实时,低频规划要深思。
PGC 闭环自主框架
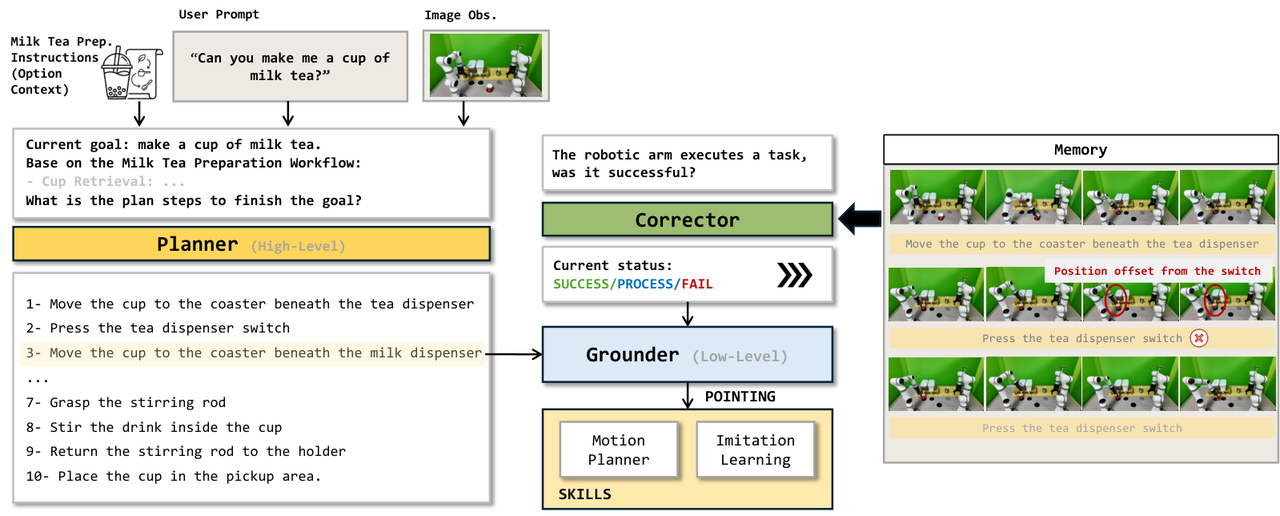
图 3:Planner-Grounder-Corrector 闭环。单个 Embodied-R1.5 实例以统一推理服务驱动完整自主栈,无多模型级联、无多智能体编排。
PGC 框架以「做一杯奶茶」为示范运行:Planner(高层)把长程指令分解为结构化子任务序列,随执行推进基于最新观测做下一步规划;Grounder(低层)对每个子任务自适应编排指认能力组合——如"按下奶茶机开关"需先用 OFG 定位开关这个功能部件,再用 VTG 规划按压轨迹——产出精确空间指令交给底层技能执行器;Corrector 异步查询,结合当前观测与 Memory 中的历史持续评估执行状态(SUCCESS / PROCESS / FAIL)。Memory 是简单的 FIFO 缓冲,执行中定率采样图像并记录各子任务状态注记。检测到失败时,错误信息写入 Memory 反馈给 Planner 触发重试或自适应重规划。
精妙之处在于三角色由同一个模型实例扮演:Corrector 能直接复用 Planner 阶段建立的推理上下文与 Grounder 的空间理解,避免级联系统的信息丢失,错误归因更准。PGC 本身只是无状态的轻量调度器,不含任何推理逻辑或启发式规则——系统的上限只由模型能力决定,随模型进步自然扩展。制作奶茶、扫地、叠杯子等长链真实任务全程无人干预完成。
实验结果
具身 VLM 基准:24 项中 16 项 SOTA
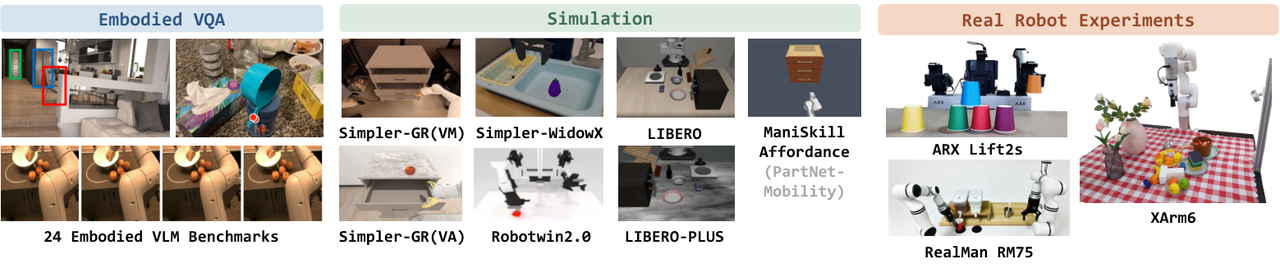
图 5:实验评估总览。评测全部经 EmbodiedEvalKit 统一管线完成,保证可复现。
| 维度(基准数) | Embodied-R1.5 平均 | 最强对照 | 对比优势 |
|---|---|---|---|
| 规划与纠错(4) | 65.3 | Mimo-Embodied 54.1 / Gemini-Robotics-ER-1.5 41.3 | +24.0pp(vs Gemini-ER) |
| 指认与定位(9+3) | 72.8 | Qwen3-VL-8B 59.2 / Embodied-R1 58.7 | 9 项指认基准全 SOTA |
| 认知与空间推理(8) | 70.2 | Gemini-2.5-Pro 68.8 / GPT-5.4 67.3 | 无短板,RoboSpatial 69.7 SOTA |
规划与纠错维度上 RoboFAC 77.2% 直接验证了失败数据管线的有效性,EgoPlan-2 53.8% 确认了第一人称规划能力。指认维度优势最悬殊:Part-Afford 82.9%、RoboAfford 80.0% 印证 OFG 功能部件管线的增益,视觉轨迹上物体流(VABench-V RMSE 7.00)与机器人流(ShareRobot-V RMSE 15.79)双双领先。认知维度与最强通用模型差距较小但无单项短板;7 个通用视觉基准上相对底座 Qwen3-VL-8B 几乎无退化,MMMU(54.8 vs 52.0)与 ScienceQA(93.1 vs 92.3)反而提升——具身训练没有以牺牲通用理解为代价。
仿真操作:少量动作数据胜过大规模预训练
把 Embodied-R1.5 挂上 DiT-B 动作头(2048 维 VLM 隐状态作交叉注意力上下文 + 32 个可学习未来查询 token,流匹配生成 7 维连续动作,推理时 4 步 Euler 积分),不做任何大规模动作预训练,直接在基准数据上微调:
| 基准 | Embodied-R1.5-VLA | 最强基线 | 代表性基线 |
|---|---|---|---|
| SimplerEnv Google Robot(视觉匹配) | 92.4% | 72.7% | π0.5 71.4%、GR00T-N1.6 67.7%、OpenVLA 24.5% |
| SimplerEnv Bridge | 71.5% | 68.4%(π0.5) | GR00T-N1.6 65.3%、RT-2-X 54.4% |
| LIBERO-Plus(总扰动) | 74.0% | GR00T-N1.5 62.0% | π0.5 57.1%、OpenVLA 4.2% |
| LIBERO(无动作预训练组) | 97.3% | 93.6%(π0.5 同组) | OpenVLA-OFT 97.1%(有预训练) |
四套基准全面领先。SimplerEnv Google Robot 上超 π0.5 逾 20 个百分点;PartNet-Mobility 上超专用方法 ManipLLM 达 11 个百分点。LIBERO-Plus 的分扰动细目里,语言与背景扰动下优势最明显——具身推理内化带来的正是对语义与外观变化的鲁棒性。这组实验是论文核心论点的直接证据:内化的具身推理可以有效替代动作数据规模——上游理解了意图,下游动作头只需学一个从意图到连续动作的简单映射。
PGC 真机闭环
零样本真机实验覆盖指令跟随、可供性定位、铰接物体操作与长程复杂任务。PGC 框架下,制作奶茶、清扫垃圾、叠杯等长程任务全程无人干预完成,失败子任务(如第一次没按中奶茶机开关)经 Corrector 定位后由 Planner 重规划、第二次成功——闭环纠错不是摆设,而是真机长程成功率的直接来源。
意义与局限
3 条自动化管线
Spatial / Correction / Pointing"] --> B["SFT 全参数微调
Qwen3-VL-8B · 1 epoch"] B --> C["多任务均衡 RFT
难度筛选·动态过滤·全局批归一
5 族奖励 · 自适应思考"] C --> D["Embodied-R1.5 EFM
24 基准 16 项 SOTA"] D --> E["PGC 闭环
Planner + Grounder + Corrector
单模型实例 · 无状态调度"] D --> F["+ DiT-B 动作头
少量数据微调 → VLA"] F --> G["SimplerEnv 92.4%
LIBERO-Plus 74.0%
零样本真机长程任务"] E --> G
这项工作的行业意义有三层:其一,证明 8B 规模就能在具身推理上压过 Gemini-Robotics-ER 与 GPT-5.4,且全链路开源——具身基础模型的门槛在快速下探;其二,「推理内化替代动作数据规模」的假设得到四套基准的实证支持,为 VLA 训练范式提供了一条绕开昂贵机器人数据军备竞赛的路线;其三,PGC 框架展示了单模型闭环自主的最小可行形态——当能力统一在一个模型里,智能体的上限就只受模型能力约束,而非系统工程复杂度。
局限方面:论文正文未展开讨论失败模式,但从实验设计看,VLA 的动作生成仍依赖仿真内评测的验证,Sim-to-Real 的长尾场景、Memory 的 FIFO 简化设计、以及低保真仿真轨迹数据的语义泛化边界,都是后续工作需要回答的问题。