PAPER DEEP DIVE
UCAG-P:一个策略驾驭九种本体——小米的相机中心统一动作几何预训练
小米具身智能团队联合澳门大学提出 UCAG-P:把机械臂、双臂、人形与人手视频统一表示为相机可观测的锚点几何运动(腕部 p0 + 抓取中心 p1 的相机系 3D 轨迹),几何条件化翻译器再输出可执行命令,人类视频无需重定向或视频合成即可直接监督策略。基于 Qwen3-VL-4B 三阶段训练,语料 102 万条轨迹 / 6373.6 小时 / 9 种本体(36.7% 人手数据);单 checkpoint 零微调拿下 LIBERO 98.3%、RoboTwin Easy 88.7% / Hard 89.2%、LIBERO-Plus 零样本 82.0%、RoboCasa GR-1 62.0%;Piper 真机取面包 60% vs π0.5 的 20%,ALOHA→ARX 跨本体零样本 35%。
一句话读懂
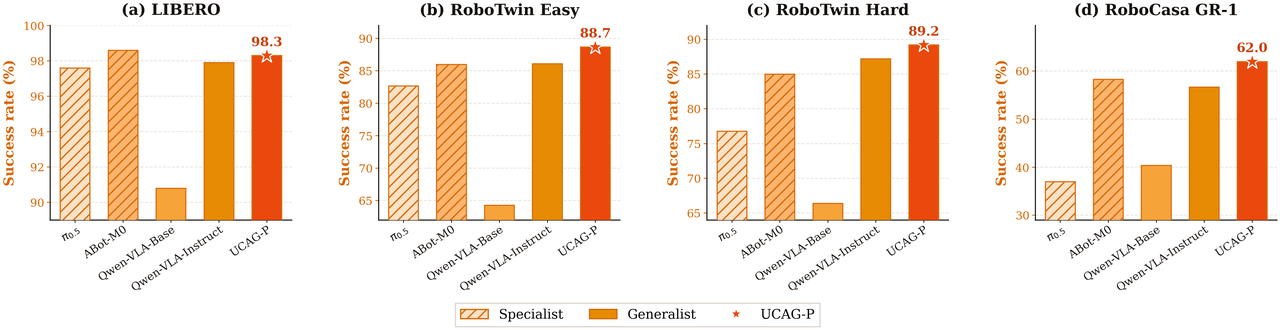
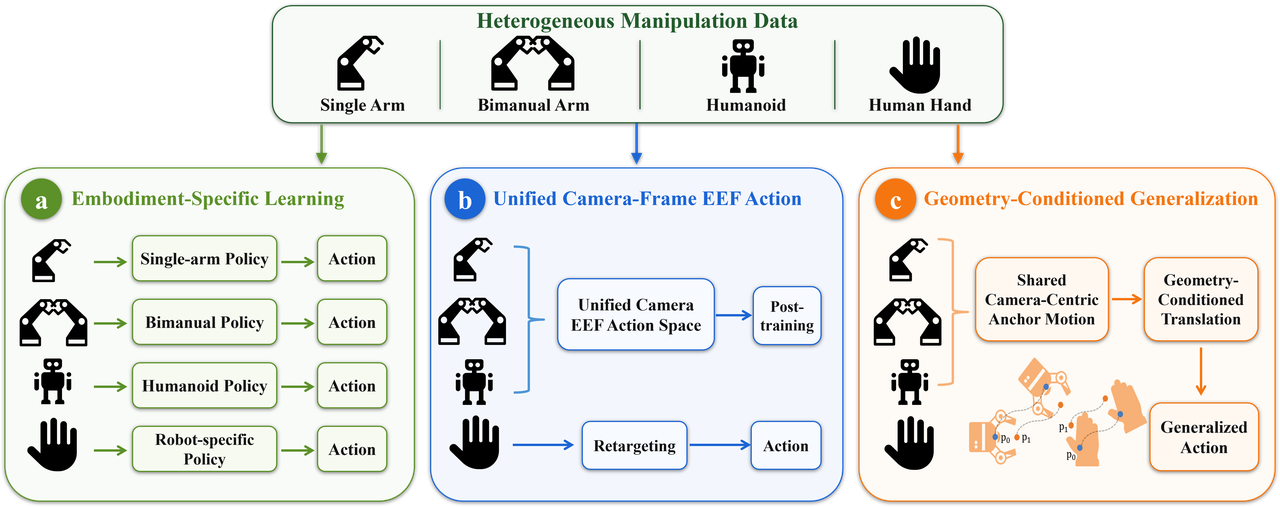
小米具身智能团队联合澳门大学提出 UCAG-P(Unified Camera-centric Action Geometry Pre-training):不再让机器人各自的关节命令充当「共享动作空间」,而是把所有操作行为统一表示为相机可观测的锚点几何运动——手腕/末端执行器点 $p_0$ 与抓取中心 $p_1$ 在相机坐标系下的 3D 轨迹。机械臂、双臂平台、人形机器人、乃至人类手部视频,全部被当作同一套动作模式(action schema)的不同「本体」(embodiment)。一个几何条件化的动作翻译器再把共享的几何预测翻译成目标机器人可执行的命令。单个 checkpoint 不做任何基准微调,同时拿下 LIBERO 98.3%、RoboTwin Easy 88.7% / Hard 89.2%、LIBERO-Plus 零样本 82.0%、RoboCasa GR-1 62.0%。
一、问题:具身数据的「异构墙」
VLA 模型规模化的最大瓶颈早已不是数据总量,而是数据的异构性:同一行为在不同数据集里可能是末端执行器增量、关节命令、夹爪状态、或人手关键点序列。主流方案要么做显式动作重定向(retargeting),要么做人到机器人视频合成,要么给每个数据集挂一个适配分支——这从根本上阻碍了统一策略的联合训练。此前跨本体方案(π0、GR00T、X-VLA、ABot-M0 等)的动作接口仍绑定在机器人特定的命令或本体专属输出头上,人类视频无法作为「第一等公民」直接参与监督。
UCAG-P 的核心洞察是:跨本体最稳定的公共结构不在底层控制器,而在相机可观测的操作几何。无论什么形态的机器人或人手,「任务进展」都体现在腕部/末端与抓取中心在相机视野中的运动——它与 VLA 策略使用的视觉证据天然绑定,却不依赖任何关节布局或控制器。
二、预训练数据:1,020,672 条轨迹,6,373.6 小时,9 种本体
语料横跨三大来源共 11 个数据集子集:真机数据 266.3 小时(4.18%,DROID、RoboChallenge、RoboCoin-Piper)、仿真数据 3,767.5 小时(59.11%,其中 InternData-A1 合成数据占 3,649.4 小时)、人手数据 2,339.7 小时(36.71%,EgoDex 829 小时、EgoVerse 1,362 小时、VITRA 148.7 小时)。另有 ShareRobot、RefSpatial-v2、RoboVQA 等视觉-语言混合数据补充指令跟随、空间定位、可供性理解与轨迹推理。人类演示通过 MediaPipe 手部关键点转换:腕关键点映射为 $p_0$,拇指尖与食指尖的中点映射为 $p_1$,其运动成为相机中心伪动作监督——完全不需要人到机器人的视频合成或显式重定向。
数据流水线四阶段:episode 索引与领域划分(保留数据集身份与混合采样权重)→ 视觉/语言标准化(统一 224×224,固定视角槽位,缺失视图置零并禁用)→ 几何与动作对齐(由前向运动学、相机标定、手部关键点恢复 $p_0/p_1$;机器人专有量留空而非伪造)→ 时间窗口化(默认地平线 $H=30$,有效性掩码处理短尾段)。
2.1 深挖数据配方:为什么是 59% 仿真 + 37% 人手?
细看表 1 的构成会发现一个反直觉的配比:真机数据只占 4.18%(266.3 小时),而合成数据 InternData-A1 一家就贡献了 3,649.4 小时(57.26%)。这并非忽视真机,而是对「相机中心」接口的一次定向验证——合成数据能以近乎零成本提供带精确标定的 $p_0/p_1$ 几何真值(前向运动学直接可算),是训练共享几何预测最干净的监督来源;真机数据虽然昂贵,却带着真实光照、遮挡、深度噪声与控制器抖动,负责打磨策略对现实分布的适配。人手数据更特殊:它只有「伪动作」级别的监督(MediaPipe 关键点推得的相机系轨迹),没有可执行命令标签,因此在三阶段训练里只参与共享运动头的监督,翻译器的 $\mathcal{L}_{\text{cmd}}$ 对它整体掩零。
数据清洗同样做了四道把关:不可读或不完整的 episode、过短的轨迹、缺失必需模态的样本在训练前即被剔除;RGB 统一缩放到 224×224 并加轻量颜色增广弥合仿真/真机/第一人称的外观鸿沟;不同相机数量被打包进固定视角槽位,缺失视图置零并禁用;指令保留原始文本并在标注的改写间随机采样以增强语言多样性。几何对齐阶段按数据源取「最可靠的状态与控制信号」——LIBERO 用场景相机参数对齐目标,RoboTwin 双臂轨迹变换到训练参考系,RoboCasa 的关节状态按身体部位分解后经缓存的前向运动学恢复臂部锚点与相机几何。
时间窗口化默认 $H=30$:以当前帧 $\tau_t$ 的观测为锚,其后 30 步构成监督块 $\{g_{t+h}\}_{h=1}^{H}$;末端不足的短段填充到目标长度后由时间有效性掩码剔除损失。端到端量与关节量在启用时按领域统计量缩放,否则保留处理后的物理单位——这套设计让 11 个异构子集得以在同一个 batch 里混训而不互相污染物理语义。
三、方法:锚点对 + 三段式架构 + 三阶段训练
3.1 相机中心动作空间
每一步的几何动作由 30 维向量描述:
$$g_{t+h} = \left[\, m^L_{t+h},\; m^R_{t+h},\; \xi^{\text{cam}}_{t+h} \,\right] \in \mathbb{R}^{30}$$
每个机械臂 $a \in \{L,R\}$ 占 10 维:
$$m^a_{t+h} = \left[\, \Delta p^{\text{cam}}_{0,t+h},\; \Delta p^{\text{cam}}_{1,t+h},\; \Delta\psi^{\text{cam}}_{t+h},\; \gamma^{\text{gripper}}_{t+h},\; 0 \,\right] \in \mathbb{R}^{10}$$
其中 $\Delta p^{\text{cam}}_0$ 与 $\Delta p^{\text{cam}}_1$ 是两个锚点在相机系下相对块首帧的位移,$\Delta\psi$ 是面内旋转(以 sin/cos 连续表示),$\gamma$ 是夹爪开度/手张开度。相机运动项 $\xi^{\text{cam}} = [\Delta t^{\text{cam}},\, r_6(\Delta R^{\text{cam}}),\, 0]$ 仅在机载相机移动时启用,固定相机数据集整体掩掉。单臂样本掩掉另一臂块,缺失标注的通道直接掩出损失——每个样本只为它拥有的监督信号负责。
3.2 架构分解:共享预测 + 几何翻译
基座策略 $\pi_\theta(o_t, l) = \hat{g}_{t:t+H}$ 使用 Qwen3-VL-4B-Instruct 骨干,多视角 RGB、语言指令与本体感知上下文编码后,由可学习的动作查询 token 经运动头(2560→5120 维隐层 + 两级残差 MLP)输出 30 步 × 30 维的共享几何块。翻译器则条件化于:
$$\hat{u}^{(k)}_{t:t+H} = \phi_\psi\!\left(\, \hat{g}_{t:t+H},\; s^{(k)}_t,\; T^{(k)}_{\text{base}\leftarrow\text{cam}},\; J^{(k)}_t,\; z^{(k)}_{\text{geo}} \,\right)$$
其中 $T_{\text{base}\leftarrow\text{cam}}$ 是相机到基座外参变换,$J_t$ 是当前位形下的局部雅可比,$z_{\text{geo}}$ 是本体结构 token。翻译器输出 80 维稀疏命令布局——八个有序 10 维块(左/右臂关节、左/右末端 XYZ+6D 旋转、左/右手/夹爪、腰部、移动底盘),未激活块被掩码且永不派发给控制器。VLM 上下文通过 8 个可学习查询 token 注意力池化注入动作头,消融显示这让 RoboCasa GR-1 从 58.3% 升至 62.0%(+3.7pp)。
3.3 三阶段训练
Stage 1(相机中心特化):128 张 H20 训 200K 步,用一切带相机中心标注的样本(含 VLM 混合数据)建立锚点运动预测的公共接口;Stage 2(几何条件翻译):8 张 H20 训 10K 步,用真值轨迹隔离「几何→命令」映射,免受上游预测误差污染;Stage 3(机器人-人类联合训练):64 张 H20 训 10K 步,翻译器改吃策略自身的预测(匹配推理时输入分布),并剔除通用 VLM 数据让最终 checkpoint 专注具身控制。总损失:
$$\mathcal{L} = \mathcal{L}_{\text{geo}} + \lambda_{\text{cmd}}\, \mathcal{L}_{\text{cmd}}$$
两项均为掩码归一化 L1 损失,例如:
$$\mathcal{L}_{\text{geo}} = \frac{\sum_{h=1}^{H}\sum_d m^g_{h,d}\,\lvert \hat{g}_{t+h,d} - g_{t+h,d} \rvert}{\max\!\left(1,\; \sum_{h=1}^{H}\sum_d m^g_{h,d}\right)}$$
3.4 训练配方与推理流程
三个阶段的算力配置差异悬殊,恰好映射了各阶段的任务难度:Stage 1 动用 128 张 H20、200K 步(全局 batch 1,536)——它要把 Qwen3-VL 的视觉-语言先验「掰」到锚点几何预测上,是整个框架的根基;Stage 2 只用 8 张 H20、10K 步——几何到命令的映射有解析结构(雅可比、外参都是已知量),学习成本天然低;Stage 3 用 64 张 H20、10K 步做联合微调(全局 batch 768)。优化器 AdamW($\beta_1=0.9$、$\beta_2=0.95$),梯度裁剪 1.0,1000 步 warmup 后余弦衰减至 $5\times10^{-7}$;骨干与 Qwen-VL 接口用 $1\times10^{-5}$ 的低学习率保护预训练权重,动作模块用 $1\times10^{-4}$ 快速收敛。
推理时序是一条两段式流水线:基座策略先从当前观测与指令预测 $\hat{g}_{t:t+H}$——这一步与目标机器人无关,任何本体都能复用同一个前向;随后翻译器读入目标本体的状态与几何条件,产出 $\hat{u}^{(k)}_{t:t+H}$,下游控制器只执行当前本体激活的命令槽位。运动头逐 2560 维动作 token 投影到 5120 维隐层、经两级残差 MLP 输出 30 步 × 30 维;动作头则把 VLM 条件化特征、相机位姿、雅可比与运动预测各自归一化投影到共享 2560 维空间,由两层八头 Transformer 编码器融合后映射为 30 步 × 80 维的稀疏 qpos 命令块。这套「共享前向 + 轻量翻译」的结构还意味着:给一台新机器人接入,只需采集少量带标定的演示训练翻译器(真机实验正是在同等演示预算下完成的 SFT 适配),共享骨干完全冻结复用。
四、实验战绩
| 基准 | 类型 | 最强专项(Specialist) | UCAG-P(统一 checkpoint) |
|---|---|---|---|
| LIBERO | 单臂 | ABot-M0 98.6 / Being-H0.7 99.2 | 98.3 |
| RoboTwin Easy | 双臂 | Being-H0.7 90.2 / ZR-0 88.7 | 88.7(+2.6 vs Qwen-VLA-Instruct) |
| RoboTwin Hard | 双臂 | Being-H0.7 89.6 | 89.2(Randomized 设定全表最佳) |
| RoboCasa GR-1 | 人形 | JoyAI-RA 63.2 / ZR-0 69.3 | 62.0(24 任务中 6 项第一) |
| LIBERO-Plus | 零样本鲁棒 | ABot-M0 80.5 | 82.0(机器人状态扰动 92.8、光照 98.9) |
LIBERO 四套件(Spatial/Object/Goal/Long)均分 98.25%,其中 Goal 99.2% 为全表最佳,四个套件分差仅 2.8 个点,说明空间推理、物体交互、目标跟随与长时程执行高度一致。值得注意的是 LIBERO-Plus 上完全零样本(未用任何 LIBERO 数据后训练)仍领先专项训练的 ABot-M0,对机器人本体状态、光照、背景扰动尤其鲁棒;相机与传感器噪声扰动仍是短板。
真机:Piper 机器人上「取面包」(评估人到机器人迁移)60% vs π0.5 的 20%、开抽屉 90% vs 85%、双臂叠碗 75% vs 65%——同等演示预算、观测与控制器下,UCAG-P 初始化显著加速真机适配。跨本体迁移:把 RoboTwin 的 ALOHA 直接换成 ARX(场景、扰动种子、相机外参全不动),零样本仍拿到 35.0%——证明相机中心运动是可迁移的中间目标,但形态学与运动学失配仍是未解难题。
RoboTwin 50 任务逐项对比中,UCAG-P 在 Randomized 设定平均 89.20% 超过 ZR-0 的 87.98%;短板同样清晰——OpenMicrowave(铰链体开启)仅 11%/13%,接触密集的铰接体操作是明确瓶颈。
4.1 三组对照实验怎么读
表 3 的对照设计值得细品:「Specialist」是在单一基准上后训练的专项方法,「Generalist」是跨任务统一模型。UCAG-P 在 LIBERO 上 98.3% 距离专项冠军 Being-H0.7 的 99.2% 仅 0.9 点,但注意它没有做任何基准微调;在 RoboTwin Hard 上它反而以 89.2% 压过多数专项模型(含 π0.5 的 76.8%),对比最强 Generalist 基线 Qwen-VLA-Instruct 分别领先 2.6 / 2.0 / 5.3 点(Easy / Hard / GR-1)。RoboCasa GR-1 的 62.0% 落后 JoyAI-RA 的 63.2%,24 任务中 UCAG-P 在杯入抽屉、砧板入纸箱及多个餐盘放置任务上拿到单项第一,但富含接触与铰接物体的任务(如牛奶入微波炉仅 44%)暴露了共享几何接口在力控密集场景的表达上限。
LIBERO-Plus 的七类扰动给出了接口鲁棒性的细粒度画像:机器人本体状态扰动 92.8%、光照 98.9%、背景 98.0% 大幅领先所有对照(OpenVLA-OFT 的机器人状态扰动仅 31.9%),说明「看腕部和抓取中心在动」这一监督目标对机器人外观与本体读数的变化天然免疫——几何不随本体读数漂移。相反,相机扰动 51.2% 是七类中最弱项:几何锚点定义在相机系,相机内外参变化直接动摇了表示的参照系,这也是作者列出的标定依赖风险的直接体现。
真机三人任务(Piper 平台)中「取面包」是唯一的人到机器人迁移评估:人类演示只提供 MediaPipe 手部关键点转换的锚点轨迹监督,就能让策略在真机上以 60% 成功率抓住面包,是 π0.5(20%)的三倍——共享几何接口把「人的手怎么接近并握住面包」这一任务本质从人手视频里剥了出来,绕过了传统 imitation 里最贵的一步。叠碗任务额外要求双臂手部检测,75% vs 65% 的领先进一步佐证双臂协同在共享锚点布局下的可协调性。
4.2 消融与逐任务画像
两组消融框定了架构各组件的贡献:动作头加入注意力池化的 VLM 特征让 RoboCasa GR-1 从 58.3% 升到 62.0%(+3.7pp),说明紧凑的视觉-语言上下文为动作预测提供了几何之外的互补信息;RoboTwin 50 任务的逐项对比(表 B.5)则显示 UCAG-P 在 Clean 88.66% 几乎追平 Motus(88.66% 持平),Randomized 89.20% 全表最佳且比自己的 Clean 成绩还高 0.54 点——随机化场景下反而更稳,是共享几何表示鲁棒性的又一注脚。逐任务短板集中在 OpenMicrowave(11%/13%)与 TurnSwitch(54%/53%)等铰链体/开关类接触任务,以及 BlocksRankingSize(67/69)这类需要精确尺寸感知的排序任务。
| 数据家族 | 代表数据集 | 本体 | 小时数 | 占比 | 监督类型 |
|---|---|---|---|---|---|
| 真机 | DROID、RoboChallenge、RoboCoin-Piper | 单/双臂 | 266.3 | 4.18% | 机器人动作 |
| 仿真 | LIBERO、RoboTwin 2.0、RoboCasa GR-1、InternData-A1 | 单臂/双臂/人形 | 3,767.5 | 59.11% | 机器人动作 |
| 人手 | EgoDex、EgoVerse、VITRA | 第一人称人手 | 2,339.7 | 36.71% | 伪动作(MediaPipe 锚点) |
| 合计 | 11 个子集 / 1,020,672 条轨迹 | 9 种本体 | 6,373.6 | 100% | 混合 + 掩码 |
| 扰动类别 | 相机 | 机器人状态 | 语言 | 光照 | 背景 | 噪声 | 布局 | 平均 |
|---|---|---|---|---|---|---|---|---|
| π0(零样本*) | 13.8 | 6.0 | 58.8 | 85.0 | 81.4 | 79.0 | 68.9 | 53.6 |
| UniVLA(零样本*) | 1.8 | 46.2 | 69.6 | 69.0 | 81.0 | 21.2 | 31.9 | 42.9 |
| ABot-M0(零样本*) | 60.4 | 67.9 | 86.4 | 96.2 | 91.6 | 86.4 | 82.6 | 80.5 |
| UCAG-P(零样本) | 51.2 | 92.8 | 83.5 | 98.9 | 98.0 | 75.2 | 74.3 | 82.0 |
* 表示在标准 LIBERO 上后训练但未微调 LIBERO-Plus;UCAG-P 为完全零样本。
五、方法结构一览
真机+仿真+人手 6,373h"] --> B["统一数据流水线
索引/标准化/几何对齐/窗口化"] B --> C["Stage 1: 相机中心特化
Qwen3-VL-4B + 运动头
200K steps / 128x H20"] C --> D["Stage 2: 几何条件翻译器
真值轨迹 / 10K steps"] D --> E["Stage 3: 联合训练
翻译器吃策略预测 / 10K steps"] E --> F["单 checkpoint"] F --> G["共享输出
30 步 x 30 维锚点运动"] F --> H["翻译器输出
30 步 x 80 维稀疏命令"] G --> I["LIBERO 98.3 / RT 89.2
LIBERO-Plus 0-shot 82.0"] H --> J["Piper 真机
面包 60% vs pi0.5 20%"]
六、边界与启示
作者在结论中直数列出了失败案例分析的三大局限,值得逐条展开。首先是几何估计的误差传播链:UCAG-P 的监督目标定义在相机系,因此相机标定误差、深度估计误差、本体运动学误差、以及 MediaPipe 手部关键点定位误差,都会先污染相机中心目标、再顺着翻译器放大进可执行命令。第二是跨本体迁移的天花板:ALOHA→ARX 的 35.0% 虽为非零结果,但与源本体的 88.66%/89.20% 之间的鸿沟说明,仅仅统一几何目标并不足以消解形态学与运动学层面的失配——同一个「伸手」动作在短臂与长臂机器人上需要截然不同的关节轨迹。第三是评估规模的克制:真机实验有意控制在受控范围内,作者明确表示更广泛的现实鲁棒性需要在更多机器人、相机布置、物体类别与长时程任务上验证。
把 UCAG-P 放回今年的技术脉络里看,它与 GE-Act 2.0 的原生世界动作模型、BSC-Nav 的类脑空间记忆构成了三条互补的路线:GE-Act 追求「从零训练、规模换能力」,BSC-Nav 追求「三维记忆换长程任务」,而 UCAG-P 追求的是动作空间的重新抽象——当共享目标从机器人命令上升到相机可观测几何,人类视频(全球最廉价、最大量的操作数据源)就不再需要昂贵的视频合成或显式重定向即可直接监督策略学习。36.7% 的人手数据占比和真机取面包 3 倍于 π0.5 的成绩说明这条路已经能兑现数据红利。
更值得关注的是它对下游工程实践的启示:翻译器与共享骨干解耦意味着「一个新本体 = 一批带标定的演示 + 一次轻量训练」,而不必重新采集全量数据、重训整套 VLA;稀疏 80 维命令布局则让单臂、双臂、带腰人形、移动底盘共用同一套接口定义,部署时按本体掩码派发即可。对于要在多种硬件形态间复用同一策略栈的团队,这套「共享几何 + 本体翻译」的工程结构,可能比基准上的几个百分点更有参考价值。项目页与代码见 public-bots.github.io/UCAG-P。