PAPER DEEP DIVE
FLORA:开放机器人数据引擎套件
Flora 用分割、字幕和奖励三模型,把机器人视频转成时间戳动作字幕、过程奖励与结果奖励,已用于训练 GR00T。
一句话总结
Flora 用一个分割器、一个字幕器和一个奖励器组成的数据引擎,同时产出时间戳动作字幕、过程奖励、结果奖励和测试期 rubric 奖励;它已用于训练 GR00T,作者报告的成本约为 GPT-6 Astra 的 1/125。
研究背景与动机
机器人基础模型已经从单一本体策略走到跨本体、跨任务、跨数据源的通用模型。这个转变把瓶颈从“能否训练一个策略”推向“能否持续清洗并标注大规模数据”。论文把数据生命周期拆成三类监督:预训练需要时间戳动作指令做语言条件输入和数据配比;强化学习后训练需要过程奖励把信用分到回合内部的动作;部署需要结果奖励监测真实机器人集群、发现失败并批量评估策略。
这三类标注在工程上经常被拆开处理。通用视频语言模型可以勉强覆盖多种任务,但在机器人语料上按小时级视频、逐窗口视觉输入和长输出推理计费时,成本会迅速放大。专用小模型虽然便宜,却往往只服务一种粒度:有的只做片段检索,有的只做结果打分,有的只预测逐步进度,难以让同一个机器人团队维护一套一致的标注契约。
Flora 的出发点因此不是再造一个通用视觉对话模型,而是把机器人数据工程中最稳定的三种输出抽出来:先把动作放到时间轴上,再给动作写意图描述,最后判断动作是否推进任务或造成失败。三个模型各自围绕可验证标签训练,组合成一个可离线运行的标注管线。
论文还强调工业可用性。Flora 用于训练 GR00T 模型,作者报告的吞吐是每天最多 20 万小时视频、使用 512 块 GB300 GPU。这个数字说明它不是只为了基准刷分而构造的原型,而是要进入持续采集、清洗、筛选和后训练的循环。
开放权重也改变了使用方式。研究团队可以在本地保留未发布的机器人数据,按自己的相机布置、任务类型和失败定义重新标注,而不必把全部原始视频交给第三方 API。对于数据敏感、私有任务多、失败模式特殊的机器人实验室,这一点的意义不亚于基准分数。
预备知识
第一层是时间动作分割。输入一段时长为 T 的人类或机器人视频,系统要输出半开区间与动作描述。所谓意图动作,指操作者尝试完成的事件,不必成功;所谓半开区间,指左端包含、右端不包含,方便相邻事件在时间轴上不重复。
第二层是奖励粒度。结果奖励回答整个回合是否完成;过程奖励回答哪一步失败、哪一步低效、哪一步恢复。Flora 把稠密奖励离散成 0.5 秒一组的三级标签:失败、次优、正常。这种离散化牺牲了连续回报的细腻度,但让人类标注和模型输出都可检查。
第三层是训练方法。三个模型都从 Qwen3.5 视觉语言模型微调:分割器用 9B,字幕器和奖励器用 27B。先做监督微调,分割器与字幕器再用 GRPO 继续优化;奖励器只发布监督微调版本。GRPO 的关键是在同一输入的多个 rollout 内部做组内比较,再用可验证指标生成奖励。
方法详解
1. 输出契约:一条视频变成可复用监督
Flora 把时间戳字幕定义为公式 (1):
$$\mathcal{A}(X)=\{(s_i,e_i,c_i)\}_{i=1}^{N},\qquad I_i=[s_i,e_i),\quad 0\le s_i < e_i \le T.$$
其中 X 是视频,T 是总时长,N 是事件数,I_i 是第 i 个半开区间,c_i 是该区间内的意图动作描述。这个定义把“时间定位”和“自然语言描述”固定在同一个元组里,后续预训练过滤、数据配比和语言条件策略训练都能直接消费。
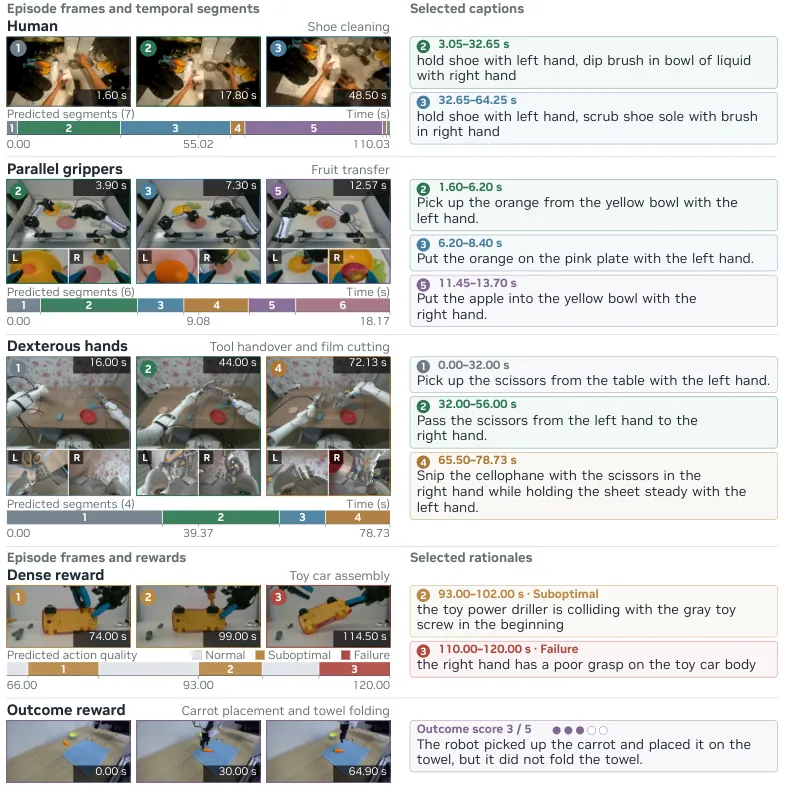
图 6:从视频到可复用监督。重叠窗口先拼成事件区间,再交由字幕器加入上下文;同一个奖励器可给出稠密、结果或 rubric 标签。
整体流程可概括如下:
flowchart TB
    V[Raw robot video] --> M[Temporal segmenter 9B]
    M --> W[Overlapping windows
16s standard or 32s long horizon]
    W --> S[Stitch local intervals
at 20 Hz ticks]
    S --> C[Captioner 27B]
    C --> A[Timestamped captions
start, end, intended action]
    V --> R[Rewarder 27B]
    R --> D[Dense quality labels
failure, suboptimal, normal]
    R --> O[Outcome reward
score 1 to 5]
    R --> U[Test-time rubric reward]
    A --> P[Pretraining data filtering and rebalancing]
    D --> RL[RL post-training and failure analysis]
    O --> F[Fleet monitoring and policy evaluation]
2. 时间分割:中心发射、上下文守卫
分割器不直接处理整条长视频,而是把视频切成重叠窗口。标准窗口 16 秒:中间 12 秒是发射核心,两端各 2 秒是守卫;64 帧按 4Hz 采样。长时程机器人数据改用 32 秒窗口:24 秒核心加 4 秒守卫,128 帧按 4Hz 采样。局部时间戳以 20Hz 离散 tick 表示,并带左右继续标志。
$$\mathcal{F}_k=f_\theta(X_{W_k},q_k)=\{(u_{kj},v_{kj},\ell_{kj},r_{kj})\}_{j=1}^{n_k}.$$
公式 (12) 表示第 k 个窗口的输出:u 和 v 是窗口内局部起止,左旗标和右旗标说明动作是否延伸到边界。确定性过滤只保留与发射核心相交的片段,投影到回合时间后,再按时间重叠和继续标志拼接。这样同一个动作可以在多个窗口中留下证据,但不会被重复计成多个事件。
# tempseg/batch_utils/vendor/production_adapter/core/flora_runtime/video_segmentation/fine_temporal.py:108
HUMAN_FINE_WINDOW_PROFILE_ID: FineWindowProfile(
    left_guard_us=2000000,
    core_us=12000000,
    right_guard_us=2000000,
    slot_count=64,
    slot_fps=4,
)
代码中的配置与论文文字一一对应。核心加守卫的设计有两个作用:守卫区让模型看见动作的前后文;只从核心区发射片段,则避免相邻窗口对同一动作反复投票造成边界漂移。作者还保留 shifted windows 做边界细化,而不是用平滑器盲目平均端点。
3. 上下文字幕:定位归分割,语义归字幕器
得到事件区间后,字幕器只负责描述,不允许改边界。对目标区间 I_i,管线先取其前、后最近的非重叠事件作为上下文,然后调用公式 (2):
$$c_i=g_\phi(X_i^-,X_i,X_i^+,q_{\mathrm{cap}}).$$
X_i 是目标帧,X_i^- 与 X_i^+ 是邻近事件帧,q_cap 是字幕提示。前后块帮助模型区分“拿的是哪一个物体”和“这一步处于哪个阶段”;但输出必须只描述目标区间,否则语义会越过时间边界。不可用上下文直接省略。
# captioner/batch_utils/vendor/pts_input_adapter.py:18
windows = [
    ('BEFORE', max(0, start_us - 2000000), start_us),
    ('TARGET', start_us, end_us),
    ('AFTER', end_us, min(duration_us, end_us + 2000000)),
]
实现把 BEFORE、TARGET、AFTER 三个角色显式写进输入。多相机情形不拼接整个回合,而是在每个采样时刻把主相机和腕部相机拼成固定布局的 mosaic;提示词声明相机角色,并要求跨视图写一条自洽动作描述。失败尝试也保留目标,但不写成已经成功。
4. 奖励器:同一个模型三种接口
Flora-Rewarder 是单个 27B 模型,靠提示词切换输出。结果奖励输出 1 到 5 分;稠密奖励输出 0.5 秒组的 1、2、3 级标签和异常段理由;rubric 奖励按用户给的任务步骤逐项给分。多相机输入仍走 mosaic,rubric 输入则把每路相机作为独立视频传入。
$$R_\rho(X)=\sum_{j=1}^{n}\hat y_j,\qquad \hat y_j\in V_j,\qquad \sum_{j=1}^{n}\max V_j=1.$$
公式 (3) 是 rubric 奖励的契约:第 j 步只能从允许分数集合 V_j 中取值,各步满分加总为 1。这样测试期奖励不是一句模糊评价,而是可检查的分步得分。人类评分也遵循同一格式,便于算 L1 误差。
结果奖励还可以读分数 token 的概率分布,得到连续值:
$$p_k=p_\psi(s=k\mid X,\ell,q_{\mathrm{out}}),\qquad \mathbb{E}[s]=\sum_{k=1}^{5}k\,p_k,\qquad \hat y=\frac{\mathbb{E}[s]-1}{4}\in[0,1].$$
公式 (19) 把 1 到 5 的离散分数归一化到 0 到 1。排序轨迹时用期望值,而不是只取 argmax。这让部分完成任务也能得到中间奖励,也是 Flora 在 RoboRewardBench 上优于 Astra 的关键场景。
5. 稠密奖励:回顾式标注与边缘裁剪
稠密奖励窗口是 16 秒、64 帧、4Hz,但视觉编码器把相邻两帧合成 0.5 秒组,所以一个窗口输出 32 个组。每个组只取 1 到 3 级;非正常段还要给出理由。模型被迫先声明窗口最坏等级,再输出 32 个组标签,二者不一致的解析结果会被拒绝。
窗口每 10 秒前进一次,最后的 4 秒在非末尾窗口中被裁掉。原因很直接:组标签是回顾式的,如果某个动作是否失败要靠后续画面确认,就不应该在没有后文的位置强行给标签。代码把这组常量写得很清楚:
# rewarder/batch_utils/core.py:412
DENSE_FRAMES = 64
DENSE_FPS = 4.0
DENSE_GROUPS = 32
DENSE_STRIDE_S = 10.0
DENSE_TAIL_TRIM_S = 4.0
LABELS = {1: "failure", 2: "suboptimal", 3: "normal"}
重叠窗口的标签拼接不是简单平均。公式 (22) 对每个时间点按“最近保留组、离窗口边缘最远的组、更早窗口、组号”做字典序最小化,选出唯一来源。重复、冲突和末端重复帧由此得到确定性解决。
$$(k^{\star},g^{\star})=\operatorname*{lexmin}_{(k,g)\in\mathcal{C}}\left(\min_{\tau\in\tau_{k,g}}\lvert t-\tau\rvert,\;-\min(g-1,\,32-g),\;k,\;g\right),\qquad a_t=a_{k^{\star},g^{\star}}.$$
6. 训练:从监督到可验证强化学习
三个模型都用输出 token 的交叉熵做监督微调:
$$\mathcal{L}_\eta(\mathcal{B})=-\frac{\sum_{(x,y)\in\mathcal{B}}\sum_{t=1}^{|y|}\log p_\eta(y_t\mid x,y_{<t})}{\sum_{(x,y)\in\mathcal{B}}|y|},\qquad \eta\in\{\theta,\phi,\psi\}.$$
分割器只更新 rank-32 LoRA,视觉编码器冻结;字幕器更新语言模型和视觉 merger;奖励器更新语言模型、视觉 merger 和视觉编码器,但视觉编码器使用更低学习率。这反映出三个任务对视觉表征的依赖强度不同:分割最怕视觉漂移,奖励需要在机器人画面上学到失败语义。
分割器的 GRPO 奖励是公式 (16):
$$r_{\mathrm{seg}}=0.45F_{0.5}+0.15F_{0.75}+0.25P_{0.5}+0.15B.$$
F 是 tIoU 阈值下的 F1,P 是精度,B 综合端点误差与继续标志准确性。低阈值 F1 权重最大,高阈值 F1 惩罚边界粗糙;精度防止模型靠大量碎片段刷召回;B 让边界和是否延续动作都进入可验证信号。
字幕器的 GRPO 奖励是公式 (17):
$$r_{\mathrm{cap}}=\frac{2M}{R+M+F}.$$
R 是参考要求的支持质量,M 是被正确覆盖的质量,F 是事实错误惩罚。它不是粗略 BLEU,而是要求模型写出有视觉证据支持的动作、物体、操作者协调和空间关系;一个错误只按语义族惩罚一次,避免反复解释同一错误导致分数过度下降。
奖励器使用 SFT 共训三种任务,不重加权,也不过采样。rubric 示例走 thinking 输出,结果和稠密示例直接给结构化答案。这个选择与发布版本一致:Flora-Rewarder 的公开结果没有叠加 RL。
实验结果
时间戳字幕在 WGO-Bench 上评估。该基准包含 25 段 HomER 人类第一视角、50 段 DROID 外部视角和 25 段 Galaxea 头部视角机器人视频。分割用 tIoU 0.75 的一对一时间匹配;金窗字幕在参考区间内评估;联合标注要求时间匹配和字幕都通过。
$$F_{\mathrm{seg}}=\frac{2\,\mathrm{TP}}{|\widehat{\mathcal{I}}|+|\mathcal{I}^{\star}|}.$$
公式 (5) 是标准 F1,但评估不做边界吸附,未匹配的预测和参考都留在分母里。Flora 的平均分割 F1 是 50.3%,高于 GPT-6 Astra 的 46.0%;联合 F1 是 34.5%,排第二,Astra 为 39.0%;金窗字幕是 64.7%,低于 Astra 的 77.4%。也就是说,Flora 的主要优势是时间定位,不是单段文本质量。
| 系统 | 分割 F1@0.75 | 金窗字幕 | 联合 F1@0.75 |
|---|---|---|---|
| GPT-6 Astra | 46.0 | 77.4 | 39.0 |
| Gemini 3.8 Flash | 26.4 | 70.9 | 21.7 |
| Qwen3.5-27B | 22.4 | 43.7 | 13.7 |
| Flora | 50.3 | 64.7 | 34.5 |
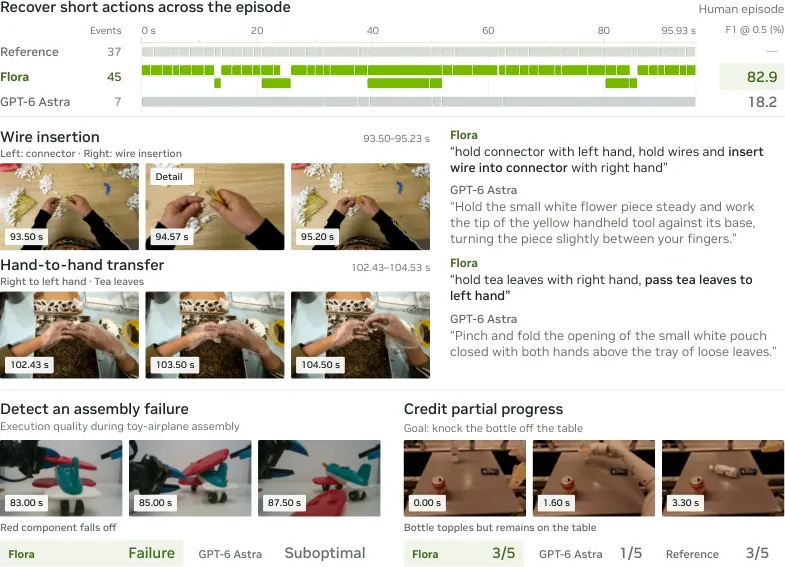
图 4:WGO-Bench 上的完整管线对比。所有数值为百分比,越高越好。
管线消融显示训练后的两阶段系统显著超过同一主干的通用管线。与 Refiner 相比,Flora 平均分割 F1 高 16.9 点,联合 F1 高 7.3 点,金窗字幕基本持平。API 替换实验进一步说明:把 Flora 的窗口和提示留在原处,仅把两个训练模型换成 Gemini 3.8 Flash,分割 F1 只有 21.2%,联合 F1 只有 16.4%,远低于训练后的 50.3% 和 34.5%。因此收益不能归功于提示工程或窗口设计本身。
DenseCaptionBench 补足 WGO 的覆盖缺口,用 300 段完整回合评估 100 段人类、100 段平行夹爪机器人和 100 段灵巧手机器人。分割阈值放宽到 tIoU 0.5,字幕质量按动作、物体、协调和细节四组参考要求计分。Flora 在 Human100 上拿到 54.6% 分割、66.5% 字幕、37.4% 联合,三项均第一;Robot Avg 拿到 66.9%、73.7%、51.0%,三项均第二。
| 系统 | Human 分割 | Human 字幕 | Human 联合 | Robot Avg 分割 | Robot Avg 字幕 | Robot Avg 联合 |
|---|---|---|---|---|---|---|
| GPT-6 Astra | 44.2 | 60.3 | 29.7 | 71.9 | 80.2 | 57.9 |
| GPT-5.6 Sol | 32.6 | 36.4 | 14.6 | 45.8 | 69.6 | 33.6 |
| Gemini 3.8 Flash | 33.5 | 46.7 | 17.7 | 45.8 | 66.0 | 32.2 |
| Flora | 54.6 | 66.5 | 37.4 | 66.9 | 73.7 | 51.0 |
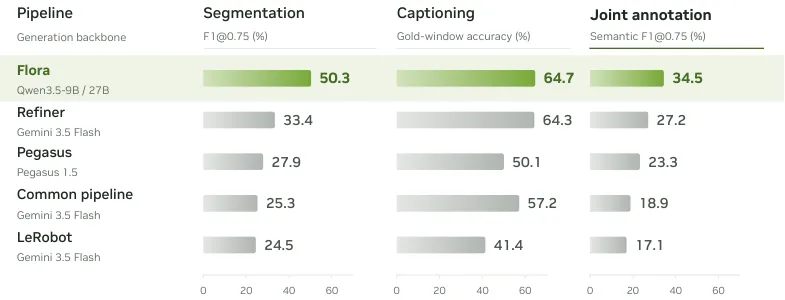
图 3:同一个数据引擎在时间戳字幕和奖励标注任务上的结果摘要。
奖励评估更直接地体现部分完成任务的判断。RoboRewardBench 用 1 到 5 分的结果标签,报告平均绝对误差。Flora-Rewarder 的 MAE 是 40.0,Astra 是 55.4,误差相对下降 27.8%。RobometerBench 的 OOD Kendall τ_a 上,Astra 以 82.3 高于 Flora 的 72.0;ID VOC 两者同为 98.9,Flora 的 OOD VOC 是 99.6。这组结果说明 Flora 并非在所有奖励维度都超过 Astra。
| 系统 | RoboReward MAE | Dense macro F1 | 失败召回 | Rubric pooled L1 |
|---|---|---|---|---|
| GPT-6 Astra | 55.4 | 40.7 | 0.0 | 3.6 |
| Gemini 3.8 Flash | 83.3 | 38.8 | 11.7 | 32.6 |
| Qwen3.5-27B | 84.8 | 30.8 | 5.7 | 15.4 |
| Flora-Rewarder | 40.0 | 46.2 | 53.3 | 6.5 |
DenseRewardBench 是最有说服力的实验之一:40 段二臂机器人回合、4861 个时间步,其中 300 步是失败。Flora 的失败召回达到 53.3%,没有基线超过 11.7%;Astra 的失败召回是 0。代价同样明确:Flora 把约 11% 正常步骤判成失败。对监控场景而言,这个误报率会打扰操作员;对数据筛选而言,它可能丢弃有用但表现笨拙的数据。
成本分析放在固定 50 段 DenseCaptionBench 子集上,包含 20 段人类、15 段平行夹爪和 15 段灵巧手。Flora 的质量是 57.1%,按 8 块 GB300、每 GPU 10 美元每小时估算为每小时源视频 0.72 美元;Astra 最大推理设置的质量是 53.7%,已知用量的 API 成本是 88.49 美元每小时。论文给出的精确比值是 122.49,正文概括为约 125 倍。
$$C_{\mathrm{Flora}}=\frac{p\,g\,N}{3600\,H\,S}.$$
公式 (9) 中 p 是 GPU 时价,g 是 GPU 数,N 是回合数,H 是源视频小时数,S 是条件速率。论文取 S=1.23495 episodes/s,并给出 0.70804 到 1.74862 的工程区间。因此 0.72 美元不是报价,而是在这些假设下的部署估算。
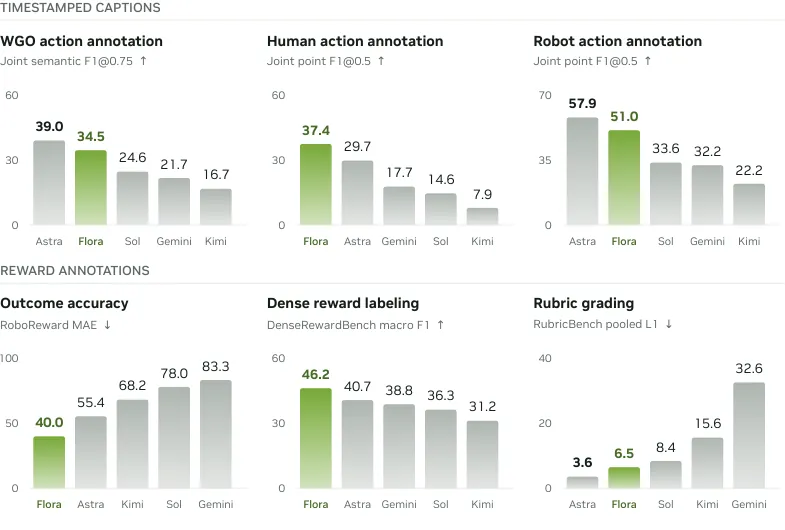
图 2:标注质量与成本散点。Flora 在论文设定的质量口径下落在更低成本区域。
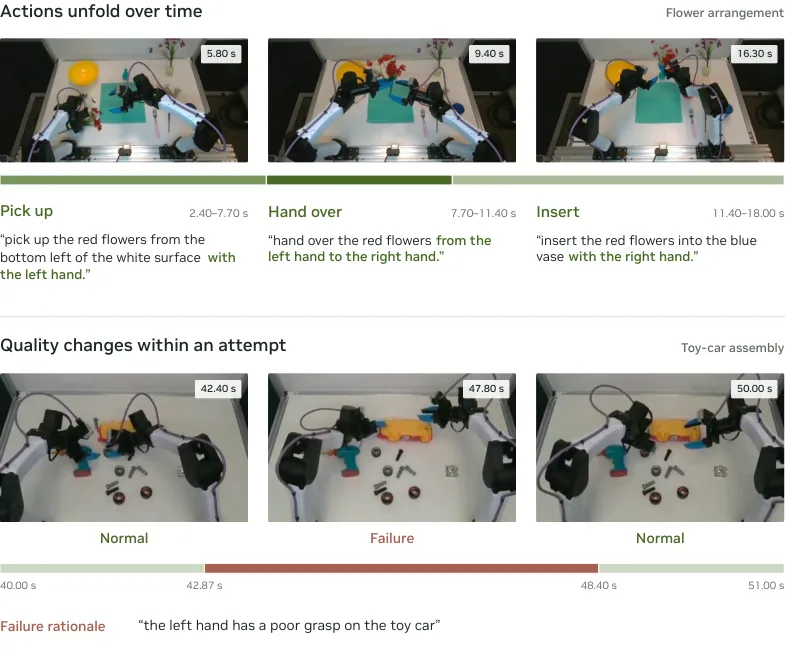
图 5:Flora 与 GPT-6 Astra 的定性对比,覆盖时间覆盖、局部操作细节和失败识别。
局限性
第一,作者明确指出 DenseCaptionBench 的 judge 是 GPT-6 Astra,而 Astra 也是被评估系统,存在 generator-judge 自偏好风险。判别时模型身份被隐藏,但这不能从机制上消除共享评分器的偏好,也不能替代完全独立的人类评分。
第二,失败召回的收益伴随误报。约 11% 正常步骤被判为失败,论文把这一点写进正文。如果直接把 dense reward 送进 RL,这可能让模型过度规避正常但保守的动作;如果用于部署报警,还需要阈值、二次复核和操作员反馈。
第三,字幕文本不是全面领先。WGO 金窗字幕只有 64.7%,低于 Astra 的 77.4% 和 Gemini 3.8 Flash 的 70.9%。Flora 的优势主要来自分割和联合任务,若项目只需要高质量单段描述而不关心时间边界,它未必是最佳选择。
第四,成本结论依赖假设。8 GPU 的 S=1.23495 条件速率不是已验证的生产 GPU 时分母,GPU 时价假设为 10 美元,106 个 API 请求未计入价格,存储、计费粒度和部署开销也被排除。所以应把 122.49 倍理解成论文口径的部署估算,而不是可迁移的总拥有成本保证。
第五,附录的定性分析承认 Flora 会把粗粒度参考事件拆成多个短段,也会在少数样本中混淆动作阶段或物体。密集分割提高了召回,但在参考标准本身较粗的任务上,这可能损害精度和用户可读性。
总结与展望
Flora 的贡献不是单点刷新所有基准,而是把机器人数据标注的三种长期需求放进同一套可复现的模型与格式:时间戳字幕、过程奖励和结果奖励。分割器负责事件边界,字幕器负责意图语义,奖励器负责执行质量;训练目标都与人类可检查的参考标签或规则绑定。
从工程视角看,真正可迁移的是几条约束:中心发射窗口防止跨窗口重复;半开区间和 20Hz tick 让时间轴可审计;密集标签必须有后文证据;rubric 分数集合在测试期固定;错误奖励按语义族而不是重复次数计罚。这些约束比“再大一点的 VLM”更容易移植到某个具体机器人实验室。
开放权重之后,下一层价值在于适配。团队可以用自己的相机布置、失败定义和 rubric 重新微调或校准,把 Flora 当作数据引擎的起点,而不是黑盒标注服务。作者提到的物理自动研究和人到机器人迁移则是更远的应用:如果系统能可靠定位失败和进度,自动实验闭环就有了稳定的监督信号。
金句
机器人模型的可扩展性,先由可检查的数据标签决定,再由参数量决定。