两个轻量代理策略的速度差在每个去噪步引导冻结基座,真机与仿真任务平均绝对成功率比 pi-0.5 高 53%。
一只 22 自由度灵巧手内同时握住两个刚性零件并完成对齐与插入:纯仿真强化学习训练,靠单相机零样本迁移到真实手,瓶+盖、注射器、马克笔三类装配任务闭环成功率 15/20、17/20、16/20。
把渲染视图上的分割结果反传到单个高斯,为已有 3DGS 场景补上物体级理解:渲染视图、分割并识别物体、跨视图累积证据,再把带标签的高斯聚合成带包围盒与元数据的三维实例。当前版本全程本地运行,使用 SAM 3 与 Qwen 3.8 27B,作者称即将发布。
SimWorld Studio 基于 Unreal Engine 5,让编码智能体用语言或图像指令生成可验证、可训练且会随机器人能力演化的具身环境。
mjbatch 用释放 GIL 的 C++ 线程池,让 CPU 并行运行数千个 MuJoCo 仿真,支持 RL、MPC、系统辨识和机器人硬件联合设计。
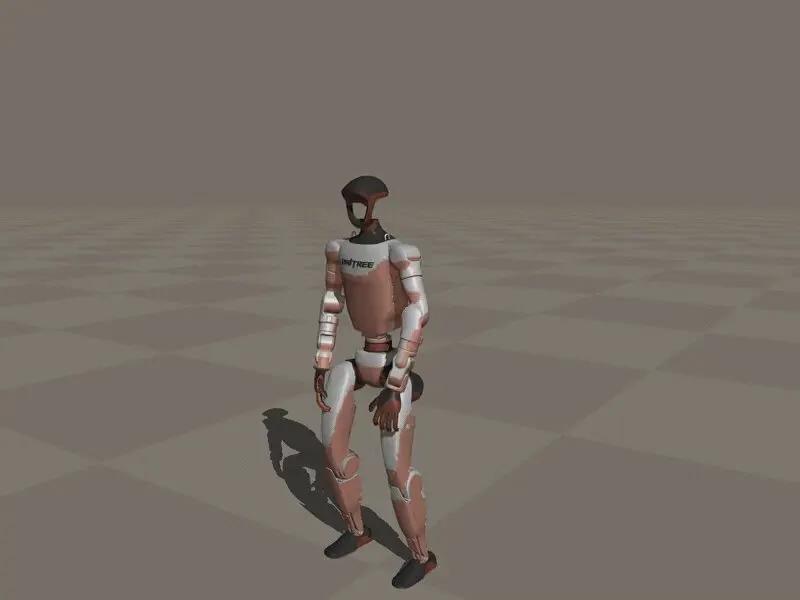
CAP 用去噪世界模型把受污染深度重建为干净深度,与 50Hz 本体感受 VAE 双通路融合,让 G1 单策略在感知退化中稳定行走,脏深度成功率 97.9%。
Chen, Hongjin, Xu, Zijun, Ma, Shihao
基础视觉语言模型(VLM)对世界已有广泛认知,但把这种认知转成机器人控制仍然困难。我们提出 Show-Harness——一套「具身 harness」,通过连接意图与动作的紧凑语义接口,让 VLM 直接「玩」机器人。Show-Harness 对外暴露 VLM 天然可推理的离散语义动作单元,再由机体专属的解释器把它们确定性地接地为局部机器人动作,使 VLM 始终对细粒度物理决策负责。基于同一接口,我们验证了两条路径:(1)直接解锁闭源前沿 VLM 实现零样本机器人控制;(2)只需几 GPU 小时微调,即可把小规模开源 VLM 适配为低成本部署的策略。我们进一步做出 GUMI(GUI 操作界面),把同一语义动作空间延伸到基于 GUI 的演示采集,让人类与智能体无需专用遥操作硬件即可跨机体「玩」机器人。大量实验表明,装配 Show-Harness 的 VLM 智能体在任务、机体与环境之间稳健泛化,优于代表性的 agentic 与 VLA 范式。这些结果说明:合适的接口本身就能从基础 VLM 中释放大量具身能力,无需额外的模型容量,也无需昂贵的机体专属预训练。
Yanzhe Chen, Zechen Bai, Zhijun Cao
Fire3D 将未分割图像或普通 RGB 视频转为完整纹理、可交互的仿真 3D 场景,自动发现物体、估计 6-DoF 位姿,并在不到一分钟内完成重建。
StereoPolicy 不依赖深度传感器、深度图、点云或激光雷达,而是从双目图像对中学习 3D 结构。在 5 项真实桌面操作任务中,方法成功率达到 59%,高于 RGB 的 42%、RGB-D 的 41% 和 PointNet 的 14%。
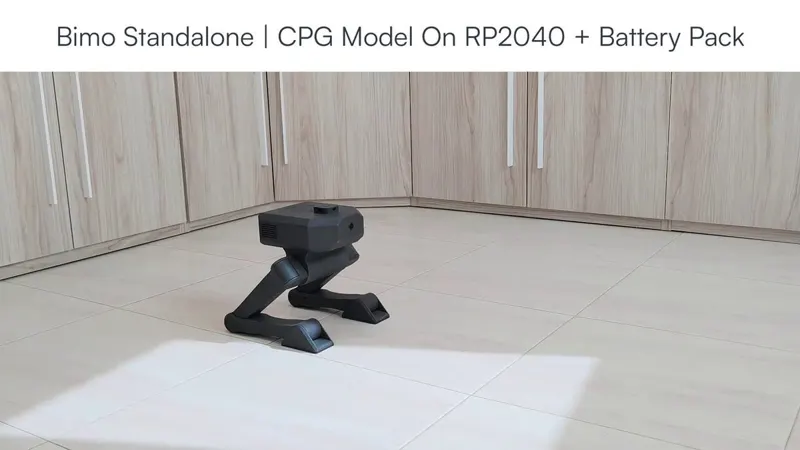
Bimo 开源双足机器人可以由 PC 遥控, 加装 SBC 做机载计算, 甚至直接在 RP2040 上运行行走策略; 仓库覆盖 API、IsaacLab 训练、MCU 固件与 ROS2 四个模块。
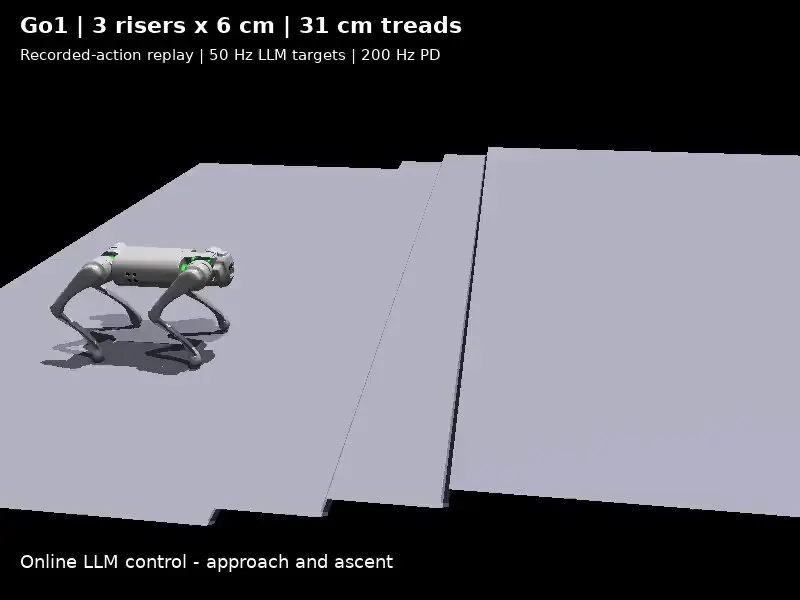
用 GPT-6 Astra 在仿真里驱动 Unitree Go1 爬楼梯: 模型不写步态代码而直接给出关节角序列, 属盲走, 推理调用之间物理暂停; 作者并回顾 2023 年 GPT-4 轨迹生成的同类工作。
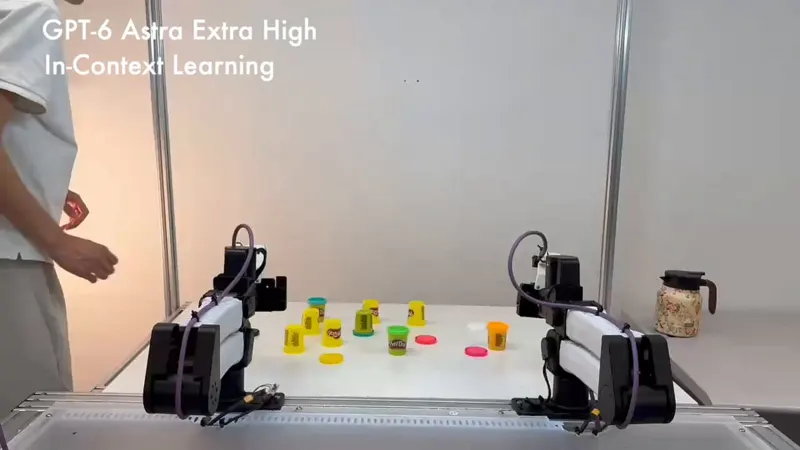
把一段人类完成新任务的录像放进 codex 应用, 提示它用同样方式驱动机械臂, GPT-6 Astra 首次尝试即成功, 说明它开箱就具备物理层面的上下文学习能力。
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。