GTA-2:模块化 VLM 框架零样本机器人操作,无演示胜过 π0.5
视频加载中
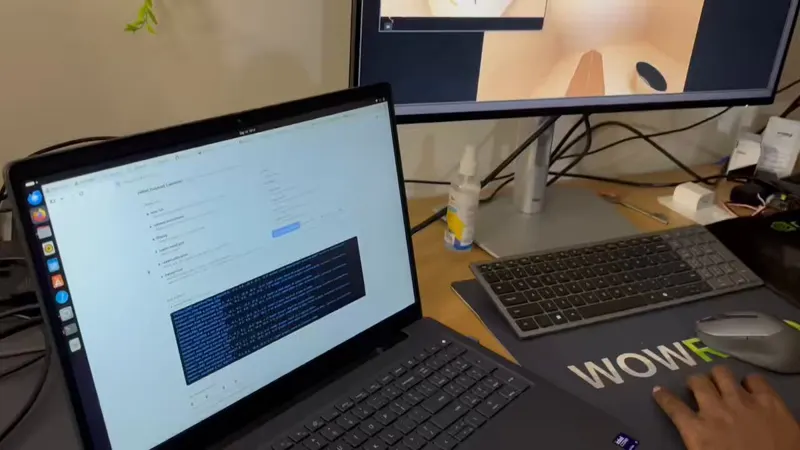
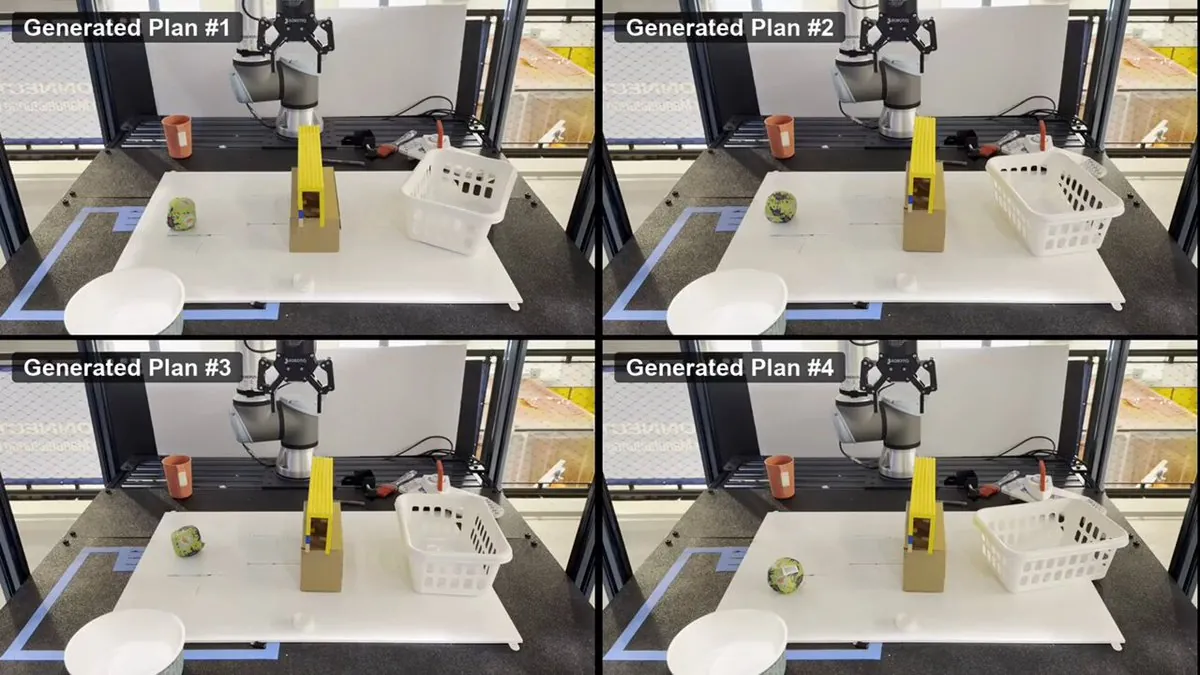
视频加载中Leo Kharon 发布的 100 秒演示介绍 GTA-2(Grounded Task Axes 第二版):一套面向零样本机器人操作的模块化视觉-语言模型框架与配套基准,仅凭自然语言指令即可生成新的操作行为,无需任务专属演示、策略训练或微调。框架由四个专职 VLM 智能体串联:先把任务分解为有序子任务;再由以物体为中心的任务轴组件生成抽象技能;接着赋值数值参数;最后把关键点与坐标轴接地到图像中。设计刻意把任务含义的推理与执行所需的几何和控制分离:操作被表示为语义子任务加任务相关关键点与轴、控制器组合、场景相关参数,某一阶段出错可单独纠正而无需重训。视频依次展示五段式界面:Task Decomposer 生成子任务清单(移动到球上方、闭爪抓球、抬升移到白篮上方、开爪放球),Skill Generator 产出技能,Parameter Setter 给出如 30cm 抬升高度等数值参数,Keypoint Module 接地关键点,最终生成并运行机器人脚本;真机画面中桌面机械臂执行四个生成计划,场景含黄色物体与白色篮筐。推文强调的亮点:零机器人演示条件下胜过 π0.5。
Category: arm
Author: @LeoKharon
Date: 2026-09-18T00:00:00
Duration: 100.0s