Uni-VLaT:给预训练 VLA 加上全身触觉,人形 loco-manipulation 成功率 32%→75%
视频加载中
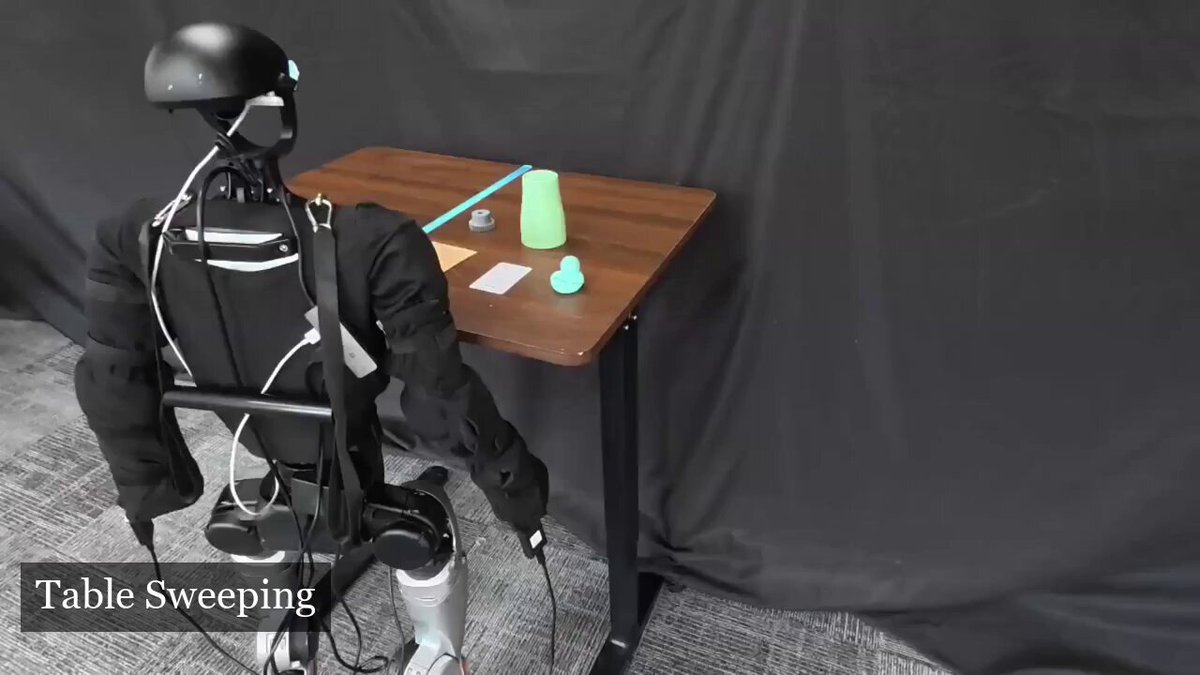
视频加载中Uni-VLaT 为预训练 VLA 策略加入全身触觉以适应人形 loco-manipulation,五个真机任务平均成功率从 32%(无触觉)提升到 75%,比仅输入触觉(68%)高 7 个百分点。最抓人的结果是「拍背行走」(Back-Tap Walking):拍机器人背部它就走、停止拍就停,零视觉信号——无触觉 0% 成功率、有触觉 85%,这不是「触觉有帮助」而是「没有触觉这个任务根本不存在」。它还能跨 GR00T 与 π0.5 两种骨干泛化。方法:区域传感器读数编码为空间触觉 token,短因果历史捕捉接触起始/支撑/释放;训练时用触觉锚定的多模态预测目标(预测未来触觉、本体与视觉表征);触觉通路适配预训练 VLA 保留视觉语言先验。
Category: humanoid
Author: @stepjamUK
Date: 2026-09-29T00:00:00
Duration: 67.4s
Reference: https://ggkiller-air.github.io/Uni-VLaT/