Skip to content
← 标签

#移动操作 (62)

PanTact:用可穿戴接触接口教会人形机器人全身灵巧性

PanTact:用可穿戴接触接口教会人形机器人全身灵巧性

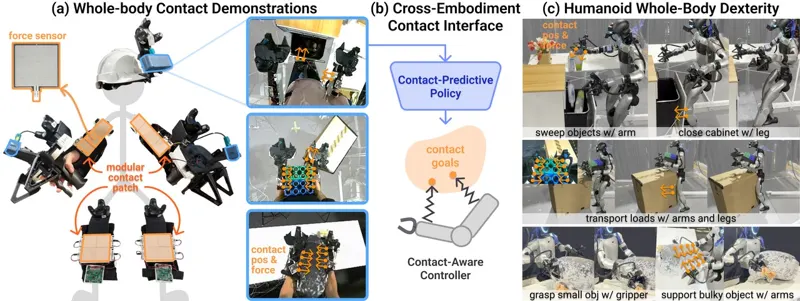
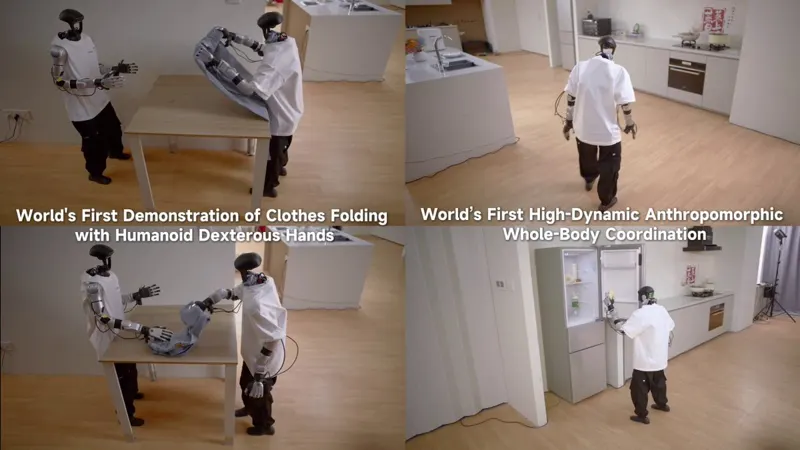
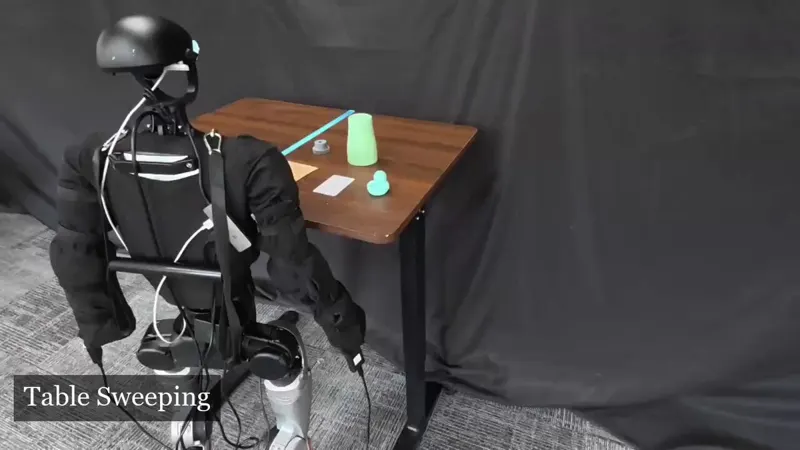
PanTact 把接触而不是关节轨迹当作人到机器人的迁移货币。可穿戴贴片由 44×44 mm 的 FSR 模块磁吸拼装,一块 50×50 mm 自研 PCB 以 1 kHz 同读 16 路,走带 CRC 的 RS-485 菊花链,每块贴片挂一个 Vive tracker 把传感器中心定位到世界系,接触状态按每通道自适应基线二值化,阈值 max(0.35β, r_min)。策略以身体遮蔽后的 3D 第一视角点云、双腕图像与本体感知为观测,10 Hz 预测 H=16 的动作块,内含 look-at 点、EEF 位姿与夹爪宽度、逐传感器接触目标(二值状态加 3D 位置)。控制器用软最小邻近距离 d(p,q)(T=0.02 m)把激活接触交给当前最近的机器人表面,并沿按压方向偏移 δ 形成虚拟目标以产生按压力,因此 G1 不装任何触觉传感器也能抱住物体。三种公式化实现各有代价:免训练的上身 IK、由 SONIC 执行稠密参考的 WBIK、PPO 在 4096 个仿真环境训 30k 迭代的稀疏接触跟踪器(50 Hz、29 关节、上身 8 / 全身 16 个接触槽)。29-DoF Unitree G1 实测:Grasp-and-Embrace 85%(上身 IK)与 80%(稀疏),Humanoid UMI 为 0;Sweep-and-Stow 端到端 90.63%,UMI++ 两阶段各 18.75%、端到端 0;Carry-and-Push 90% 对 40%。仿真回放消融显示加入接触目标后三种控制器接触距离都下降,EEF 精度几乎不受损。

Xu, Xiaomeng, Zhang, Han, Ruan, Zhian · 133次阅读 · 2026年10月8日
Whole-Body Manipulation触觉接触丰富操作2026年10月8日
MobileVISTA:生成式数据增强让移动操作扛住 15cm 站位偏差

MobileVISTA:生成式数据增强让移动操作扛住 15cm 站位偏差

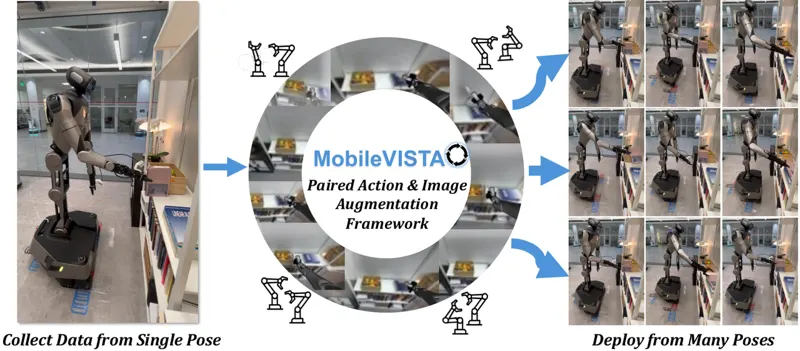
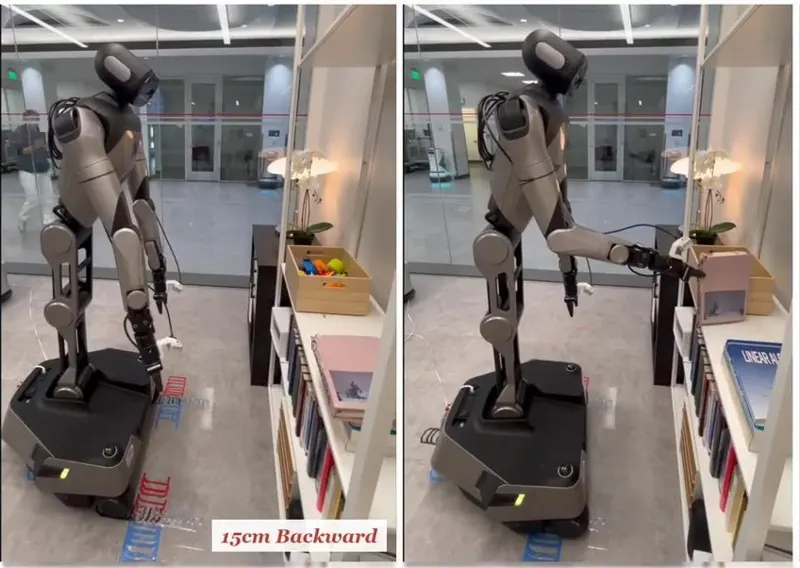
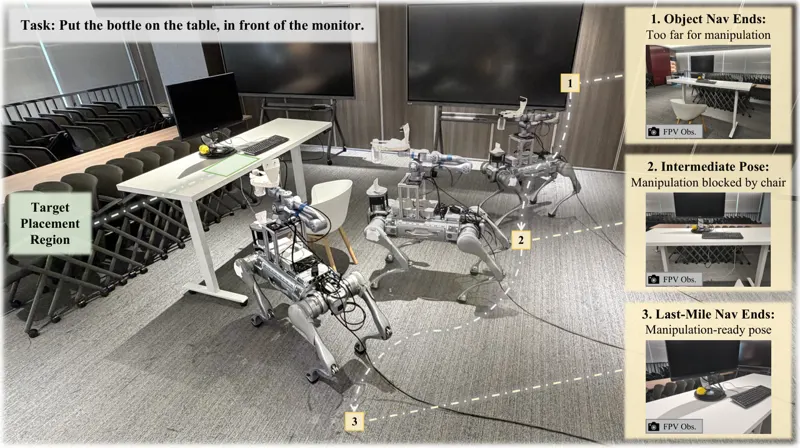
移动操作策略大多照着一个站位采的示范学出来,部署时底座偏几厘米,第一视角画面和末端轨迹就一起偏,成功率断崖式下滑。MobileVISTA 不重采数据,而是把已有示范「搬」到新站位。视觉侧先按 (r,θ)~(√u·15cm, 2πv) 采样盘面偏移与 ±5° 偏航,用天空盒掩码(仿真里 GR-1 标红、Franka 标黄;真机走 URDF 深度阈值 0.995 再膨胀 5px)把机器人抠掉,Open3D 反投影成点云、按相机外参升到世界系平移 Δp,再用重定向动作正运动学算出的新外参重投影,被遮挡的洞交给 E2FGVI 补,最后把机器人渲到新位置合成回去(仿真 512×512,真机 6× 上采样)。动作侧是闭式变换:p'_t=T⁻¹[p_t;1]、R'_t=R_inv_yaw·R(r_t)、夹爪原样透传,双臂绕中点偏航,再用 mink IK(FrameTask 1.0/1.0、PostureTask 1e-5、≤20 步)解回关节。数据量仿真 1:1(200→200)、真机 1:10(50→500)。GR-1 的 Can Sort 在 r=15cm 从微调 π0.5 的 0.320 提到 0.527,Pouring 0.460 对 0.013;双臂 Franka 的 Box 从基线最高的 0.087(DP3)提到 0.247,Drawer 0.413 反而高过仿真 oracle 的 0.393。真机 Book Stacking 随机站位抓到 17/25、放上书堆 13/25,三个基线只有 1-2/25。消融指向关键在「机器人几何随站位变」:只做动作变换几乎无增益(0.00-0.11),固定机器人几何会丢掉 Pouring +0.47、Can Sort +0.28、Box +0.24。补图质量 PSNR 也压过 GEN3C(Can Sort 25.02 对 16.29 dB),单帧耗时 2.39-4.31 分钟(L40S)对 GEN3C 的 13.65-16.85 分钟(H200)。

Wistreich, Suzannah, Tian, Stephen, Huang, Isabella · 141次阅读 · 2026年10月5日
移动操作Data Augmentation模仿学习2026年10月5日
VAP-TAMP 精读:用动作知识引导 VLM 主动感知——机器人在执行中发现「门只开了一半」怎么办

VAP-TAMP 精读:用动作知识引导 VLM 主动感知——机器人在执行中发现「门只开了一半」怎么办

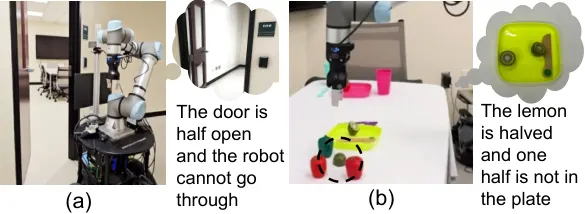
SUNY Binghamton + CMU + Ford Research + Agility Robotics,TAMP(任务与运动规划)+ VLM 主动感知框架。核心问题:TAMP 规划假设全知世界,但真实执行中随时冒出计划外状况——门只半开过不去、柠檬切半后一半掉出盘子。既有开放世界规划方法隐含假设「状况是完全可观测的」,而现实中机器人只能靠不靠谱的机载传感器。VAP-TAMP 的关键创新是 **VLM 与动作知识的双向交互**:用当前动作 PDDL 前置条件/效果构造视觉问句去 prompt VLM,再用 VLM 输出更新动作知识。三个模块:① 场景图生成器(RGB-D 点云+实例分割+CLIP 嵌入,几何规则判定 on/inside/near,动作驱动+观测驱动双通道更新);② 主动感知(对每个谓词生成 N 个语义等价问句让 VLM 多数投票,响应不一致→VLM 建议视角方向(left/right/closer/above)→导航过去再看,预算 K 内循环直至视图充分);③ 状况处理(verify-execute-verify 闭环:动作前验前置条件、动作后验效果,任一失败→修正场景图→PDDL 重规划;诊断区分感知错误/世界状态变化/执行失败三种根源)。真机实验:Segway RMP+UR5e+Robotiq 夹爪,4 个家务任务×25 次共 100 试,**成功率 88%**(OK-Robot 76%、COWP 69%、Closed-World 33%),72/100 试验中至少出现一次计划外状况;VLM 引导选视角平均 1.61 个 vs 贪心遍历 4.35 个(省 63%);失败模式显示 VAP-TAMP 的失败集中在操作硬件(42%),感知瓶颈被转移走。仿真实验(OmniGibson,5 任务+注入故障概率)证明基于具体状态谓词的验证优于 SuccessVQA/AffordanceVQA 及其组合,效果验证贡献大于前置条件验证(抓取/切割各 50% 组合故障率只能靠后验发现)。

Austine Oloo, Zainab Altaweel, Yohei Hayamizu · 468次阅读 · 2026年4月28日
TAMP主动感知视觉语言模型2026年4月28日
BSC-Nav:从反应式到认知式,为具身智能体装上类脑的三维空间记忆

BSC-Nav:从反应式到认知式,为具身智能体装上类脑的三维空间记忆

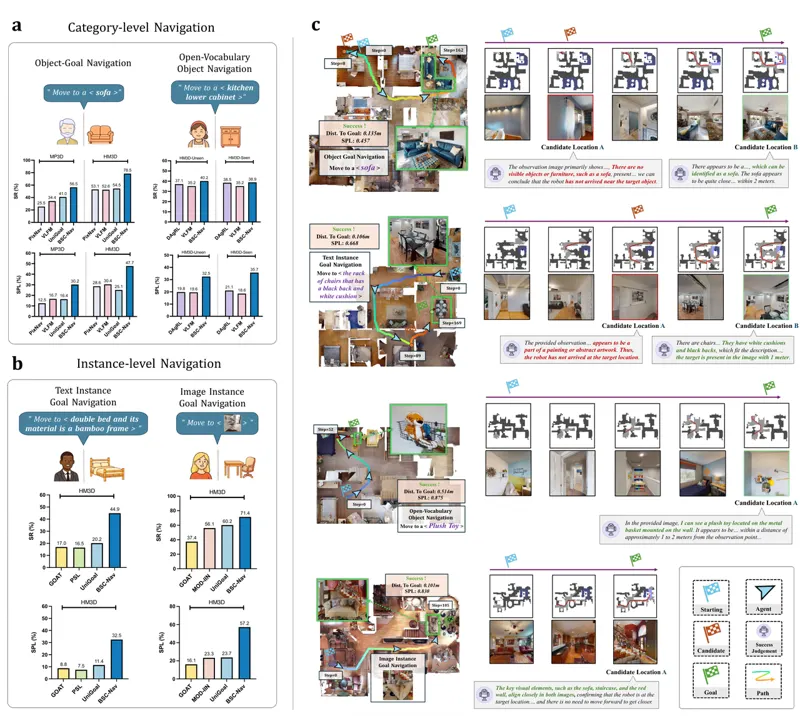
清华大学(计算机系、心理与认知科学系)与北京航空航天大学提出 BSC-Nav(Brain-inspired Spatial Cognition for Navigation)。论文指出,现有具身智能体无论走端到端强化学习还是「MLLM + 模块化流水线」,本质上都是反应式、无状态的——处理完观测就丢弃,缺乏持久的空间内部模型,导致知识碎片化、规划短视、泛化差。作者从神经科学借来答案:生物把空间知识巩固为地标、路线知识、概览知识三种互相连接的形式。BSC-Nav 用三个模块在计算上实例化了这套结构——地标记忆以四元组(世界坐标、开放词汇类别、检测置信度、GPT-4o 生成的上下文描述)编码显著线索与位置的持久关联,并用「空间重叠集 + 置信度加权融合」去重;认知地图用 DINO-v2 提取 patch 特征,经逆透视投影与级联坐标变换投射到体素网格,并采用受自由能原理启发的 surprise 驱动更新——按新特征与邻域内既有特征的平均距离决定是否写入,缓冲区满则替换 surprise 最低者,从而既保留跨视点多样性又控制存储;工作记忆按指令复杂度分层检索,简单目标用纯文本 GPT-4 推理地标记忆(甚至能由共现地标推断未记录目标的位置),复杂目标先由 GPT-4o 精炼描述、再用 Stable Diffusion 3.5 「想象」目标外观,经 DINO-v2 编码与中心距离加权池化后查询认知地图(imagine-then-localize),最后用相似度加权 DBSCAN 聚类得到候选坐标。多候选时不贪心选最高置信度,而是用 H_i = λ·p_i + (1-λ)(1-d_i/d_max) 复合打分排序探索序列。实验覆盖 MP3D/HM3D 共 62 个场景、8,195 个 episode:OGN 在 HM3D 达 78.5% SR(超 SOTA 的 UniGoal 24.0 个百分点),OVON 以零样本超越有监督的 DAgRL,IIN 达 71.4%;SPL 提升比 SR 更一致(IIN 达 57.2% vs 23.7%)。主动具身问答 A-EQA 上 LLM-Match 54.6 为最高,但仍落后人类 27.5。真机用 AgileX Ranger-mini-3.0 底盘 + Franka Research 3 机械臂 + RealSense D435i 平台,在约 200 m² 两层空间跑 75 个 episode,IIN 有 4/5 目标达 100% SR,失败时也稳定定位到语义合理区域;并展示了导航与操作原语协同的长程任务(如「做早餐」依次操作三个开放词汇物体)。论文提出「空间认知的具身图灵测试」应考察三个维度:实时构建可复用空间表征、从稀疏部分观测中抽象推理、把高层目标转译为可执行空间计划。

Ruan, Shouwei, Wang, Liyuan, Kang, Caixin · 880次阅读 · 2025年8月24日
BSC-Nav空间认知认知地图2025年8月24日

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。