R²-WAM:世界动作模型需要怎样的视觉表征
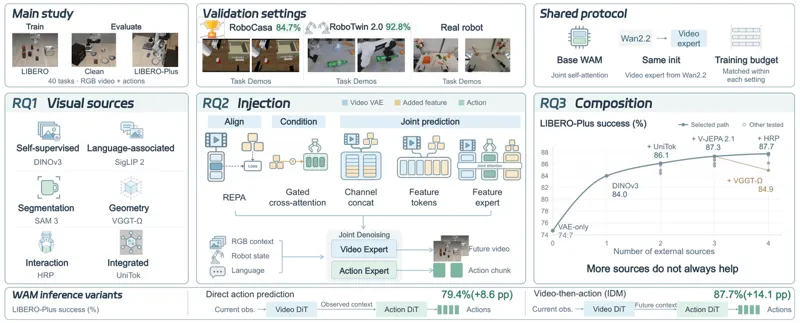
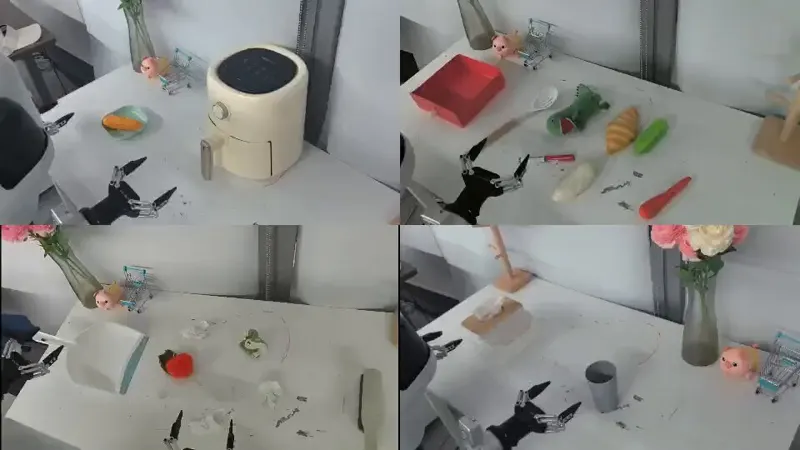
世界动作模型(WAM)的视觉底座继承自为像素重建训练的视频 VAE,缺的正是操作所需的语义、空间与接触信息。本文把同一个 Wan2.2 双专家骨架与同一套训练协议固定下来,在 LIBERO-Plus 上受控比较 13 种冻结视觉表征、5 种特征注入机制与多种特征组合,得到三条结论:通用表征优于专用表征(平均总体成功率 82.2 对 80.0),视角/背景/噪声每一类扰动的最佳均值都来自通用源;通道级联合预测最强(13 源平均 81.5,领先次优机制 5.1 个点),收益主要来自"预测未来特征"而非"条件于当前帧";追加表征源只在互补时有效,最大额外增益仅 3.7 个点,师生同场(C-RADIOv4 + DINOv3)反而掉到 78.6。据此固化的 R²-WAM(DINOv3 + UniTok + V-JEPA 2.1,通道级拼接)在 RoboCasa GR1 Tabletop 达 84.7%(+5.9)、RoboTwin 2.0 达 92.8%(+2.2),Galbot G1 真机四任务各提升约 10 个点。
Kai Liu, Jiangran Lyu, Tingyu Deng · 36次阅读 · 2026年10月9日
世界动作模型Visual Representation机器人操控2026年10月9日
 1:34