PAPER DEEP DIVE
R²-WAM:世界动作模型需要怎样的视觉表征
世界动作模型(WAM)的视觉底座继承自为像素重建训练的视频 VAE,缺的正是操作所需的语义、空间与接触信息。本文把同一个 Wan2.2 双专家骨架与同一套训练协议固定下来,在 LIBERO-Plus 上受控比较 13 种冻结视觉表征、5 种特征注入机制与多种特征组合,得到三条结论:通用表征优于专用表征(平均总体成功率 82.2 对 80.0),视角/背景/噪声每一类扰动的最佳均值都来自通用源;通道级联合预测最强(13 源平均 81.5,领先次优机制 5.1 个点),收益主要来自"预测未来特征"而非"条件于当前帧";追加表征源只在互补时有效,最大额外增益仅 3.7 个点,师生同场(C-RADIOv4 + DINOv3)反而掉到 78.6。据此固化的 R²-WAM(DINOv3 + UniTok + V-JEPA 2.1,通道级拼接)在 RoboCasa GR1 Tabletop 达 84.7%(+5.9)、RoboTwin 2.0 达 92.8%(+2.2),Galbot G1 真机四任务各提升约 10 个点。
一句话总结
本文不提出新的表征,而是用同一个世界动作模型骨架、同一套训练协议,系统比较 13 种预训练视觉表征、5 种特征注入机制与多种特征组合,得出三条可操作的结论:通用表征应作默认、通道级联合预测应作默认、追加表征源要按互补性挑选;并把这三条结论实例化为 R²-WAM,在 RoboCasa GR1 Tabletop 与 RoboTwin 2.0 上分别取得 84.7% 与 92.8% 的成功率。
一、研究背景与动机
世界动作模型(World Action Models, WAMs)的做法,是把预训练视频生成模型改造成机器人控制器:视频专家负责预测未来视频潜变量,动作专家负责预测动作块,两者通过联合注意力耦合。DreamZero、LingBot-VA、Fast-WAM 等工作已经证明,视频预训练带来的视觉结构与时间动力学先验确实能迁移到控制上。但这条路线有一个被普遍忽略的继承物:视频模型的变分自编码器(VAE)潜空间。
VAE 的训练目标是像素级重建。重建要求潜变量保留"画面长什么样"的信息,却不要求它保留"该怎么动手"的信息:物体语义、空间关系、接触与可操作范围这些操作相关的量,在重建目标里并没有被显式优先化。于是出现了一个结构性的错位——WAM 的视觉底座是为看而优化的,而它的任务是做。
近期已有若干工作尝试用外部视觉表征弥补这一缺口:有的做表征对齐,有的做动作条件化,有的做联合预测,并都报告了性能与鲁棒性的提升。问题在于,这些工作各自基于"我认为 WAM 缺哪种视觉能力"的先验去挑选表征,且把表征选择与注入机制设计耦合在一起。读者无法判断:提升究竟来自表征本身,还是来自那套为它定制的注入方式?
第二个未被回答的问题是组合。操作任务对视觉的需求是多样的——语义、几何、物体范围、运动、交互——这暗示可能需要多种表征;但额外的表征源也可能带来冗余信息,甚至在优化过程中互相干扰。多源组合是否单调有益,是一个只能靠实验回答的经验问题。
本文的出发点正是把这两个变量解耦。作者在一个共同的 WAM 骨架与共享训练协议下,对表征源、注入机制、特征组合做受控比较,提出三个研究问题:RQ1 哪些视觉表征能提升 WAM 性能;RQ2 哪种注入机制从外部特征中获益最大;RQ3 组合更多表征源是否持续带来收益。论文的原话是:"Systematic comparisons across representation types remain limited, leaving unclear which visual representations best support robot manipulation in WAMs."(跨表征类型的系统比较仍然缺乏,哪些视觉表征最能支撑 WAM 中的机器人操作仍不清楚。)
二、预备知识
流匹配(flow matching)。本文所有生成量(视频潜变量、动作、外部特征)都用流匹配训练:给定干净样本 $x_0$ 与噪声 $\epsilon$,构造 $x_\tau=(1-\tau)x_0+\tau\epsilon$,模型回归速度场 $v=\epsilon-x_0$,损失为该速度上的均方误差。推理时从纯噪声出发,按调度器逐步去噪。理解这一点后,文中所有"联合去噪""未来特征预测"的说法都只是在说:把外部特征也当成一个与视频潜变量同构的生成量。
双专家 WAM 骨架。基座模型由 Wan 2.2 视频生成模型初始化的视频专家与一个独立动作专家组成。两者通过带非对称掩码的联合注意力交互:动作 token 可以注意视频 token 与动作 token,视频 token 只注意视频 token;两个专家都通过交叉注意力读取 T5 编码的语言指令,并额外以机器人状态与流时间 $\tau$ 为条件。这个掩码方向很重要——它决定了"动作能看到什么",也正是后文五种注入机制各自做文章的地方。
LIBERO 与 LIBERO-Plus。LIBERO 是 40 个桌面操作任务的仿真基准,本文按 Fast-WAM 的协议每任务 50 次 rollout;但作者发现 LIBERO 上的性能接近饱和,于是把同一批模型零-shot 地搬到 LIBERO-Plus(LP)上评测:7 类扰动(相机视角、机器人本体、语言、光照、背景、图像噪声、布局),每个评测种子跑满 10,030 条 episode。LP 因此承担了本文绝大部分的判别力。
三、研究设计:一个骨架,三个问题
3.1 基座训练目标与记号
基座 WAM 同时预测未来视频潜变量 $z_{1:T}^{\mathrm{vae}}$ 与动作块 $a$,训练目标为两路流匹配损失的加权和:
$$\mathcal{L}_{\mathrm{WAM}}=\mathcal{L}_{\mathrm{FM}}(z_{1:T}^{\mathrm{vae}})+\lambda_{\mathrm{act}}\mathcal{L}_{\mathrm{FM}}(a) \tag{1}$$
其中 $\mathcal{L}_{\mathrm{FM}}$ 是各模态预测速度与目标速度的均方误差,$\lambda_{\mathrm{act}}$ 为动作损失权重(实验中取 1.0)。记号上,$t=0$ 指当前观测,$t=1,\ldots,T$ 指未来序列,$\tau$ 指流时间;因此 $z_0^{\mathrm{vae}}$ 是当前帧 VAE 潜变量,$z_{1:T,\tau}^{\mathrm{vae}}$ 是流时间 $\tau$ 处的未来视频潜变量。推理时未来视频与动作都从噪声初始化、联合去噪。
3.2 十三种表征与"通用/专用"的划分
作者比较 13 个预训练视觉编码器,全部冻结、只从基座 WAM 可见的 RGB 观测上提特征,并按预训练目标归入六种侧重:视觉自监督(VC-1、VideoMAE V2、V-JEPA 2.1、DINOv3、LingBot-Vision)、语言关联(SigLIP 2、Qwen3.5)、分割监督(SAM 3)、几何监督(VGGT-Ω)、交互导向(HRP、DynaFLIP)、多目标/多教师(UniTok、C-RADIOv4)。在此之上做一个关键二分:面向广泛视觉或视觉-语言任务迁移的记为通用(general-purpose),主要为某种特定视觉能力预训练的记为专用(specialized)。这个二分不是按精度划的,而是按"预训练意图"划的——它直接决定了 RQ1 的结论形态。
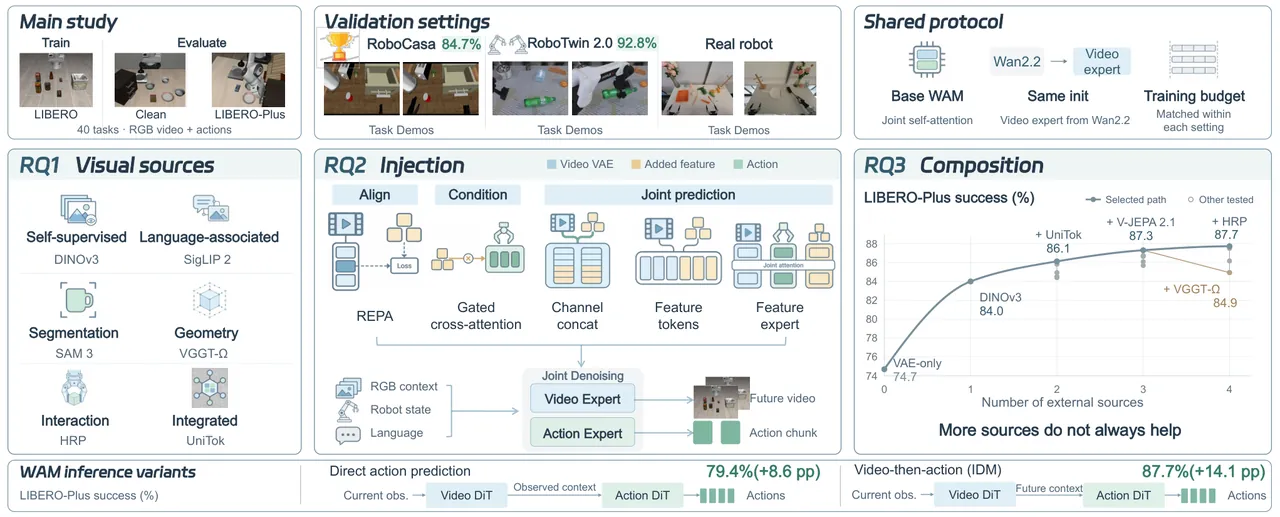
图 1(论文 Figure 1):研究总览。共享训练协议下并列比较视觉特征源(RQ1)、五种注入机制(RQ2)与特征组合(RQ3),并给出跨骨架与真机验证。
3.3 五种注入机制
记当前与未来外部特征为 $f_0$ 与 $f_{1:T}$(需要时用上标 $k$ 标记来源),流时间 $\tau$ 处的未来特征状态记为 $f_{1:T,\tau}$。五种机制覆盖三类思路:表征对齐、动作条件化、联合预测。
表征对齐(REPA)。用一个可训练投影器把 WAM 中间隐状态映到外部特征空间,以余弦距离损失与冻结教师的空间对应特征对齐。对齐发生在视频专家第 8 个块的输出上,投影器是三层 MLP;教师轨迹按视频 token 网格做空间重采样,观测切片保留、八个未来切片平均为两组。其损失为:
$$\mathcal{L}_{\mathrm{REPA}}=1-\frac{1}{|\Omega|}\sum_{i\in\Omega}\left\langle\widehat{P(h_i^{8})},\widehat{f_i}\right\rangle \tag{3}$$
其中 $\Omega$ 为有效的未来 token 集合(不含观测切片),宽帽表示 $\ell_2$ 归一化。冻结教师与投影器只在训练期存在,推理时整条对齐支路被移除——这是它与其余机制最本质的区别。
门控交叉注意力。在动作专家的 30 个块中各插入一路特征交叉注意力:以混合注意力之后的归一化动作状态为查询,以当前观测特征 $f_0$ 经适配器投影后为键值;输出经一个可学习标量门 $\tanh(g_\ell)$ 缩放后加回残差,且 $g_\ell$ 初始为 0,使新增支路起初完全中性:
$$\widetilde{h}_a^{\ell}=\bar{h}_a^{\ell}+\mathrm{CA}_{\mathrm{text}}^{\ell}(\bar{h}_a^{\ell},c)+\tanh(g_\ell)\,\mathrm{CA}_{\mathrm{feat}}^{\ell}(\bar{h}_a^{\ell},f_0) \tag{4}$$
该机制不预测未来特征、也没有辅助损失,冻结编码器与交叉注意力支路在推理期保持激活。对 REPA 与三种联合预测机制,总目标统一写作:
$$\mathcal{L}=\mathcal{L}_{\mathrm{WAM}}+\lambda_{\mathrm{aux}}\mathcal{L}_{\mathrm{aux}} \tag{2}$$
其中 REPA 的 $\mathcal{L}_{\mathrm{aux}}$ 是余弦对齐损失,联合预测机制的是未来特征流匹配损失;门控交叉注意力则只用 $\mathcal{L}_{\mathrm{WAM}}$ 训练。默认辅助损失权重为 1.0,特征专家与 REPA 用 0.1。
通道级拼接(channel-wise concat)。把外部特征在空间上对齐到 VAE 潜变量网格,沿通道维拼接;视频专家的输入/输出投影相应扩维,从而 jointly 预测 VAE 与外部特征两路速度,而视频 token 的排布与注意力掩码完全不变。观测特征保持干净,未来 VAE 潜变量与未来特征一起加噪、一起预测;推理时未来特征从噪声初始化参与联合去噪,但最终只解码 VAE 潜变量。
token 级拼接与特征专家。token 级拼接把外部特征展平为独立 token 序列 $[V_0,V_{1:T},F_0,F_{1:T},A]$,用独立输入投影映到视频专家隐宽度、与 VAE token 共享全部 Transformer 块,另设预测头映回源维度 $C_f$;特征流的速度目标为 $\epsilon_f-f_{1:T}$。特征专家则把共享换成独立:一个 30 块、隐宽 1024、FFN 宽 4096、24 头的独立 Transformer,与视频/动作专家通过掩码联合注意力交换信息,但各自保留投影与前馈参数。三者同属联合预测,差别恰在"融合在哪一层、参数是否共享"。
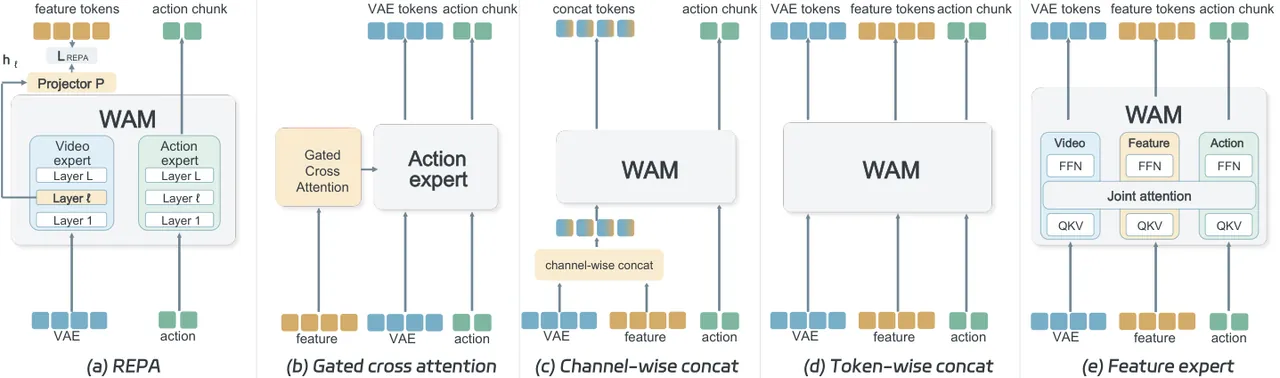
图 2(论文 Figure 2):五种注入机制的结构对比。(a) REPA 隐状态对齐;(b) 门控交叉注意力;(c) 通道级拼接;(d) token 级拼接;(e) 特征专家。
3.4 组合协议
组合实验固定通道级拼接为公共机制。对源集合 $\mathcal{K}$,各源特征按固定顺序沿通道维拼接,当前帧与未来帧分别并入扩展后的潜变量:
$$f_t=\mathrm{Concat}_{\mathrm{ch}}\{f_t^k: k\in\mathcal{K}\},\quad \widetilde{z}_0=[z_0^{\mathrm{vae}},\,f_0]_{\mathrm{ch}},\quad \widetilde{z}_{1:T,\tau}=[z_{1:T,\tau}^{\mathrm{vae}},\,f_{1:T,\tau}]_{\mathrm{ch}} \tag{8}$$
当前状态 $\widetilde{z}_0$ 保持干净,每个源各自贡献一路未来特征损失,总辅助损失为各源之和:
$$\mathcal{L}_{\mathrm{aux}}=\sum_{k\in\mathcal{K}}\mathcal{L}_{\mathrm{FM}}(f_{1:T}^k) \tag{9}$$
源相关的预处理与拼接顺序在训练与评测间保持一致。这个协议把"组合"变成了一个纯粹的可加项实验:每加一个源,就多一路通道、多一路预测损失,其余一切不变。
3.5 机制为何有效:预测消融与动作敏感度
为解释通道级拼接的优势,作者做了两类诊断。其一是预测消融:在通道级拼接内部区分"当前特征条件化"与"未来特征预测"。其二是局部动作敏感度:把最终归一化动作块记为 $A_m(F;\xi)\in\mathbb{R}^{32\times 7}$($F$ 为当前帧 DINOv3 原始特征,$\xi$ 为其余固定输入与已实现的采样噪声),对完整十步去噪过程求导,得到动作-特征 Jacobian 块:
$$J_{g,c,p}=\frac{\partial a_g}{\partial F_{c,p}} \tag{5}$$
其中 $a_g$ 为平移/旋转/夹爪三组动作之一(维度 96/96/32),$F_{c,p}$ 为某相机上 $7\times 7$ 诊断网格中一个 $2\times 2$ 特征块的全部通道。为避免构造完整 Jacobian,用 Rademacher 随机投影 $z_r$ 做向量-Jacobian 乘积估计局部敏感度:
$$\widehat{s}_{g,c,p}=\left[\frac{1}{R}\sum_{r=1}^{R}\left\|\frac{\partial (z_r^{\top} a_g)}{\partial F_{c,p}}\right\|_2^2\right]^{1/2} \tag{6}$$
再对 49 个网格单元与两个相机视角取平均,得到机制 $m$、动作组 $g$ 在观测状态 $o$ 下的敏感度标量:
$$\widehat{S}_{m,g}(o)=\frac{1}{2\cdot 49}\sum_{c=1}^{2}\sum_{p=1}^{49}\widehat{s}_{m,g,c,p}(o) \tag{7}$$
这套诊断的意义在于:它不比较成功率,而是直接测量"动作生成在多大程度上局部依赖外部视觉输入"。REPA 因推理期没有外部特征输入而不适用该诊断——这本身就说明了它的信息通路是训练期的。
flowchart TB
    subgraph SRC["13 frozen encoders, 6 pretraining emphases"]
        D[DINOv3]
        U[UniTok]
        V[V-JEPA 2.1]
        O[SAM 3 / VGGT-Omega / HRP / SigLIP 2 / ...]
    end
    subgraph MECH["5 integration mechanisms, shared WAM backbone"]
        R[REPA align]
        G[Gated cross-attn]
        C[Channel-wise concat]
        T[Token-wise concat]
        F[Feature expert]
    end
    WAM[Wan2.2 video expert + action expert]
    SRC --> MECH
    MECH --> WAM
    C -->|LP avg 81.5 pct, best| REC[R2-WAM recipe]
    D --> REC
    U --> REC
    V --> REC
    REC --> B1[RoboCasa GR1 Tabletop 84.7 pct]
    REC --> B2[RoboTwin 2.0 92.8 pct]
    REC --> B3[Galbot G1 real robot, 4 tasks]
图:本文的研究-配方链路。13 个冻结编码器经 5 种机制进入同一 WAM 骨架,胜出的通道级拼接与三个互补源固化为 R²-WAM 配方,再跨骨架、跨基准、跨真机验证。
四、实验结果与解读
4.1 RQ1:通用表征是默认答案
所有单源实验统一用通道级拼接注入,基线为 VAE-only WAM。LP 七类扰动下的总体成功率(三个评测种子的均值)如下表:
| 表征源(分组) | 相机 | 背景 | 噪声 | 总体 |
|---|---|---|---|---|
| VAE-only 基线 | 51.2 | 62.0 | 66.6 | 74.7 |
| DINOv3(通用/自监督) | 64.2 | 83.9 | 86.0 | 84.0 |
| C-RADIOv4(通用/多教师) | 62.6 | 86.2 | 86.6 | 83.5 |
| SigLIP 2(通用/语言关联) | 60.7 | 82.4 | 83.4 | 83.1 |
| V-JEPA 2.1(通用/自监督) | 63.0 | 80.7 | 84.4 | 82.4 |
| SAM 3(专用/分割) | 57.8 | 75.3 | 81.5 | 80.6 |
| VGGT-Ω(专用/几何) | 62.4 | 75.7 | 79.6 | 80.6 |
| HRP(专用/交互) | 52.6 | 82.2 | 81.2 | 79.8 |
先读基线:VAE-only 在语言扰动(91.1%)与光照扰动(94.3%)下表现很好,却在视角变化(51.2%)、背景变化(62.0%)与图像噪声(66.6%)下显著塌陷——重建目标留下的鲁棒性缺口是不均匀的。再读结论:通用表征的平均成功率为 82.2%,专用表征为 80.0%;且在全部七类扰动中,每一类的最高均值都来自某个通用源,包括视角、背景、噪声这些"看起来该由专用能力补救"的类别。HRP 是为手部-物体-接触监督而训练的交互表征,按理最懂操作,但它在视角扰动下只有 52.6%,几乎与基线持平。作者据此给出 Takeaway 1:不要按"假设缺什么能力"去挑专用编码器,通用表征应作默认。
4.2 RQ2:通道级联合预测赢在哪里
13 个表征 × 5 种机制的全矩阵中,按表征取平均的 LP 总体成功率如下(由论文 Table 8 的逐源数据汇总):
| 注入机制 | 13 源平均 LP 总体 | DINOv3 单源 LP 总体 | 推理期是否保留特征通路 |
|---|---|---|---|
| 通道级拼接 | 81.5 | 84.0 | 是(参与联合去噪) |
| 特征专家 | 76.4 | 78.7 | 是 |
| REPA | 76.2 | 78.1 | 否(训练期对齐) |
| 门控交叉注意力 | 74.7 | 73.9 | 是(当前特征记忆) |
| token 级拼接 | 72.7 | 76.1 | 是 |
通道级拼接以 81.5% 的平均值领先次优机制 5.1 个百分点,且这个领先不是靠个别源撑起来的:13 个源里有 12 个在通道级拼接下拿到该源的最高分。更有信息量的是失败案例——token 级拼接下 V-JEPA 2.1 只有 49.5%、SigLIP 2 只有 66.4%,均低于 VAE-only 基线,说明"把特征当独立 token 塞进共享 Transformer"对某些特征几何是灾难性的;而通道级拼接在同一批源上没有任何一个低于 77.5%。
为什么是通道级?预测消融给出了第一层答案:在 DINOv3 + 通道级拼接内部,只保留未来特征预测(去掉当前特征条件)为 81.9%,只保留当前特征条件(不预测未来)为 76.5%,两者齐全为 84.0%。也就是说,收益的大头来自"让视频专家学会预测外部特征的未来",当前帧条件化只是锦上添花。共享 PCA 可视化进一步显示,视频专家预测出的未来 DINO 特征保留了可辨认的粗空间结构。第二层答案来自动作敏感度:通道级拼接在接近、抓取、放置三类状态上的平移与旋转敏感度都高于其他机制,即动作生成确实更强烈地"用到"了新增的视觉信息。作者把这两点写进 Takeaway 2:新机制应支持未来特征预测,并让动作专家有效使用新增特征。
4.3 RQ3:组合的收益是递减且有条件的
以 DINOv3 为起点、固定通道级拼接,逐个追加候选源。DINOv3 单独带来 +9.3 个百分点(74.7→84.0),而所有被评估组合中,追加源带来的最大额外收益只有 3.7 个百分点。更细的条件性体现在:SigLIP 2 加到 DINOv3 上 +1.8,但一旦 UniTok 已在集合中,SigLIP 2 反而 −0.4;V-JEPA 2.1 同时在场时它只 +0.2。C-RADIOv4 蒸馏自 DINOv3、SigLIP 2 与 SAM 3,与 DINOv3 组合把成功率压到 78.6%——师生同场等于重复计数。反之,V-JEPA 2.1 加到 DINOv3+UniTok 上有正收益,与其基于视频的预测式预训练提供互补线索一致。Takeaway 3 因此是:追加源要按"它在现有表征之外贡献了多少任务相关信息"来选,组合只是精修手段。
4.4 配方验证:跨骨架、跨基准、跨真机
把三条结论固化即得 R²-WAM:DINOv3 + UniTok + V-JEPA 2.1,通道级拼接。加入 HRP 可再 +0.4(87.3→87.7),但作者为控制辅助编码器与预测目标数量保留三源。跨骨架验证中,直接动作预测骨架的 LP 从 70.8 升到 79.4,video-then-action(IDM)骨架从 73.6 升到 87.7,说明配方不依赖联合去噪这一特定形式。跨基准验证如下表:
| 基准 | VAE-only | R²-WAM | 最强对比方法 |
|---|---|---|---|
| RoboCasa GR1 Tabletop(24 任务 × 50 次) | 78.8 | 84.7(+5.9) | LAWA 80.8 / WALA 75.2 / DIAL 70.2 |
| RoboTwin 2.0(50 任务 × 100 次,clean+rand 平均) | 90.6 | 92.8(+2.2) | WALA-Wan 92.3 / LingBot-VA 92.2 / Fast-WAM 91.8 |
真机部分在 Galbot G1 双臂平台上做四个任务、每模型每任务 20 次试验:空气炸锅备餐 50.0→60.0,指令抓取放置 70.0→80.0,推杯 65.0→75.0,清扫任务以碎片收集率计 48.3→66.7。三个二值任务各 +10.0 个百分点,且覆盖顺序操作与工具使用,说明配方收益能穿过仿真-现实边界。
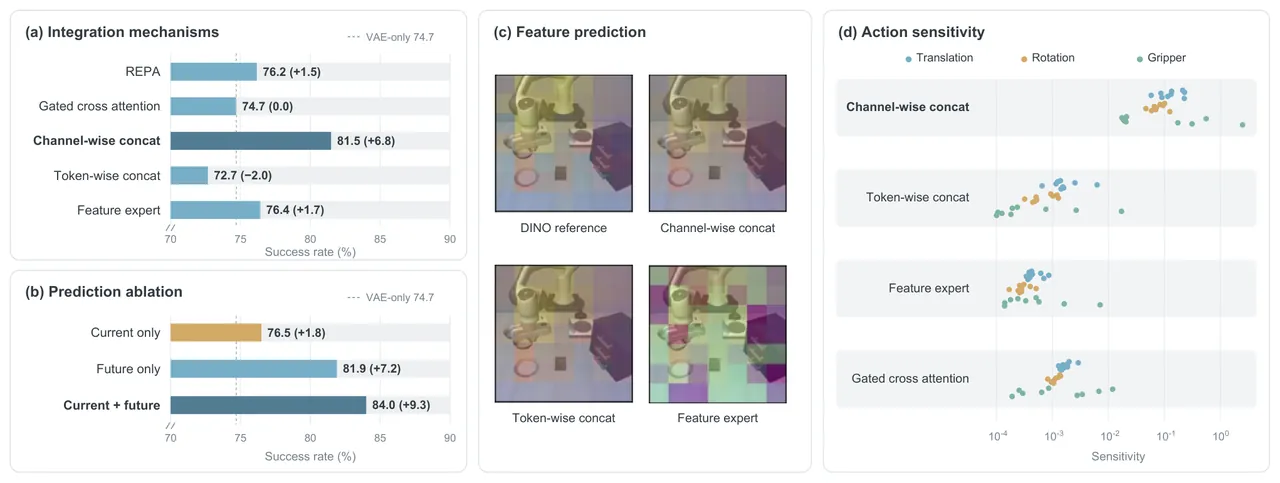
图 3(论文 Figure 3):机制分析。(a) 五种机制在 13 源上的平均 LP 成功率;(b) DINOv3 预测消融;(c) 共享 PCA 下的未来特征预测可视化;(d) 局部动作敏感度散点。
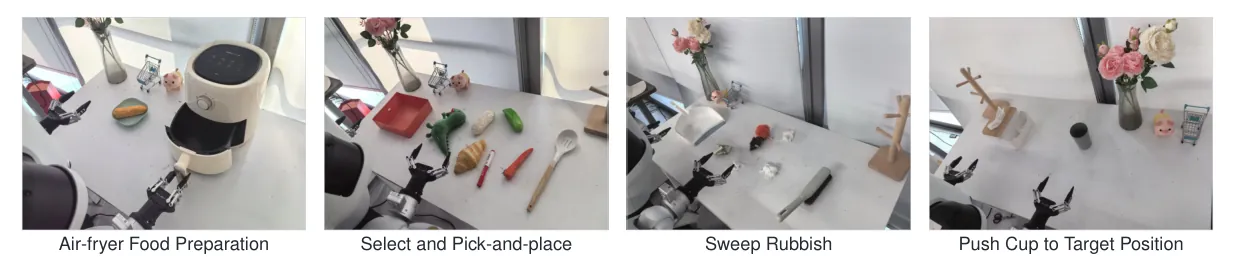
图 4(论文 Figure 5):真机四任务场景——空气炸锅备餐、指令抓取放置、清扫碎片、推杯到目标位置。
五、局限性
作者自述。其一,组合路线的边际收益有限:即便最好的被评估组合,其额外增益也小于"把第一个强通用表征加到 VAE-only 基线"所带来的初始增益,因此组合只能作为补充路线。其二,为限制辅助编码器与特征预测目标的数量,配方止步于三源(HRP 的 +0.4 被主动放弃),更大组合空间未被探索。
本文的判断。其一,全部比较都是"每个配置一个训练 checkpoint、三个评测种子",即报告的不确定性只覆盖评测噪声、不覆盖训练噪声;token 级拼接下 V-JEPA 2.1 的 49.5% 这类塌陷,无法区分是机制性缺陷还是单次训练的优化失败,机制排序的置信区间实际上比表格显示的更宽。其二,13 个编码器全部冻结且基本取 L 规格,研究没有触及编码器容量、分辨率与微调与否这几个同样可能主导收益的旋钮;"通用/专用"的二分也依赖作者对预训练意图的归类(C-RADIOv4 蒸馏三家教师仍被计入通用),换一个归类方式,Takeaway 1 的措辞强度会变化。其三,判别力主要来自 LIBERO-Plus 这一个仿真族的扰动基准,真机验证只有 4 任务 × 20 次,配方在更长horizon、移动操作或双臂强耦合任务上的表现仍是开放问题。
六、总结与展望
这篇论文的贡献不在新模型,而在把"给 WAM 加视觉特征"这件原本靠先验与手感的事,变成了一组可复核的受控实验。它给出的配方极其朴素:先上一个强通用表征,用通道级拼接让它参与联合预测,再按互补性谨慎追加源。R²-WAM 在两个主流操作基准与真机上的增益,说明这条朴素路线目前还没有被更花哨的机制超越。对后续工作,论文把方向指回了两处:更强的通用视觉基础模型,以及更能让动作专家用好视觉信息的注入机制——前者决定上限,后者决定上限能被兑现多少。
对工程实践,本文还留下一个可直接复用的实现细节:在第一作者的特征空间训练仓库中,冻结编码器取末层 patch token(去掉 CLS 与寄存器 token)后重采样到目标网格(wan/features/extractors.py:120-168),流匹配的速度目标写作 $v=\epsilon-x_0$(wan/features/modeling.py:229-240),并对高维 DINO 潜变量做维度相关的 timestep 平移 $\alpha=\sqrt{d_{\mathrm{eff}}/d_{\mathrm{base}}}$、$t'=\alpha t/(1+(\alpha-1)t)$(wan/features/modeling.py:242-256)——这三处与论文附录 A、B 的描述逐条对应,可作为复现通道级拼接的起点。