Skip to content
←返回领域索引

领域赋能 · 创作与设计

设计与前端

视觉设计、UI 组件、网页与幻灯片排版

设计与前端是当下 AI 水位最高的创作领域,但水位分布极不均匀:概念与发散环节(情绪板、风格探索、方案草图、图标与插画素材)已经基本被 AI 接管,一个人一晚上能出过去一周的量;而收敛环节——把方案落成有栅格、有状态、有可访问性、能在真实断点下不崩的界面——AI 只能做到「看起来像设计稿」,离「能交付的代码」还差一层工程判断。所以这个领域的正确用法是把 AI 放在前端(发散、变体、素材)和末端(切片、标注、组件命名),中间的取舍与系统一致性仍然由人负责。这个领域的梯顶按「进不进得了生产管线」排:能输出可编辑源文件、能锁品牌一致性、能直接产出前端代码的排在前面,只能出效果图的排在后面。

在追资产
7
可装用技能
4
能力域
8

SOTA 应用

7
图像生成设计与前端梯顶C

GPT Image 2.5:把「多轮改图不走样」写成 API 契约的图像旗舰

OpenAI 2026-09-08 发布的图像生成与编辑模型,分 Flare(默认档:画质高于 GPT Image 2、延迟低 50%)与 Sunburst(精度档:用更长生成时间换复杂细节保真)两个变体,共 4 个端点(各一个文生图 + 一个编辑),API 面与价格完全一致。能力面:长边 3840px、6 档质量(auto/low/medium/high/xhigh/max,比上代多两档天花板)、单次最多 16 张参考图编辑、可选 mask、PNG/WebP 真 alpha 透明输出。发布重点是「多次编辑之间细节保持一致」与「基于批注只改一处」,即多轮改图不漂移。第三方水位:Artificial Analysis 竞技场(2026-09-22)上,sunburst 同时是文生图第 1(Elo 1423)与图像编辑第 1(1526),flare 双榜第 2(1401/1482),是唯一双榜登顶的系列;但两行都还标 preliminary、票数(8791/8014)远少于被超越的 gpt-image-2(82862)。闭源、只走 ChatGPT 与 API,不能自托管或微调。未做基准复现,置信度记 C(厂商宣称)。

1423/1526Arena 文生图 / 图像编辑 Elo 双榜第 1厂商宣称 · 2026-09
产品OpenAI官网
GPT Image 2.5:把「多轮改图不走样」写成 API 契约的图像旗舰
图像生成设计与前端梯顶C

Qwen-Image-2.1:一套开放权重同时做生成、局部编辑与透明输出

阿里 Qwen 的图像生成与编辑一档,把文生图、局部编辑(圈选/涂抹/独立 mask)、最多 10 张参考图融合与原生 RGBA 透明输出收进同一个 7B 视觉生成组件(32 层 Single-Stream DiT),并用混合粒度注意力与前缀 KV 缓存复用压低批量出图的边际成本;原生 2048px、7 档宽高比。它是当前可下载权重里图像竞技场排位最靠前的一档(文生图第 17 / Elo 1228,图像编辑第 16 / 1367),但许可是 Qwen Research License 而非 Apache-2.0,商用前必须单独读条款,diffusers 还需从 git 主干安装。未做基准复现,置信度记 C(厂商宣称)。

7B视觉生成组件参数厂商宣称 · 2026-09
产品阿里 Qwen (Alibaba)官网Repo
Qwen-Image-2.1:一套开放权重同时做生成、局部编辑与透明输出
图像生成设计与前端梯顶C

FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线

Black Forest Labs 的 FLUX 家族用整流流(rectified flow)Transformer 做图像生成,并放出 Apache-2.0 的 dev 档权重,是开源侧最重要的图像基线;Kontext 一档把「按指令改这张图的局部而不动其余」做成了可用能力。采集库里另有 FLUX 3 的发布记录,厂商把它定位成统一图像/视频/音频的世界模型,这一主张记为待核验。

Apache-2.0开放权重档位(dev)厂商宣称 · 2024-08
产品Black Forest Labs官网Repo
FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线
3D 与世界模型设计与前端梯顶C

Hunyuan3D 2.1:权重开放的 3D 生成基线,自托管路线的默认起点

腾讯把形状与纹理两阶段都放出了权重,并给出 PBR 材质输出,这让「3D 生成」第一次有了一个可以在自己机器上跑、可以微调、可以塞进内部管线的参照实现。它的价值不在跑分领先,而在可复现:任何关于 3D 生成能力的判断,都可以拿它当基线去比。

产品Tencent官网Repo
Hunyuan3D 2.1:权重开放的 3D 生成基线,自托管路线的默认起点
图像生成设计与前端梯顶D

Nano Banana Pro:把「聊天式改图」做成产品形态的图像编辑模型

Gemini 的原生图像生成与编辑一档,社区叫它 Nano Banana。它的关键不是画质峰值,而是交互形态:多轮对话里持续改同一张图、能读图里的文字再改、能把多张参考图合成一张。这让图像生成第一次像「和设计师对话」而不是「抽卡」。它的排名多来自偏好竞技场,那是投票不是测量,记为待复现。

产品Google DeepMind (Gemini image)官网
Nano Banana Pro:把「聊天式改图」做成产品形态的图像编辑模型
AI 编程设计与前端C

Figma Make:以设计系统为上下文入口的 prompt-to-app,回路终点是托管 URL 而非你的仓库

Figma Make 是 prompt-to-app 这条赛道里唯一以「你已在维护的设计文件」为第一上下文的:挂载 team libraries、组件、variables 与 styles,打包成 Make kit 供团队复用;编辑用 edit tool 点选元素、draw tool 圈画区域、annotations 逐元素下指令,把「我说的是哪个按钮」从文字描述变成视觉指点。但回路终点是 Figma 托管的 URL(AWS + Cloudflare),不是你的 GitHub 仓库——有 code editor、能导出代码,却没有 PR→CI 这条路。成本按 credits 计:Professional Full seat 3,000/月、中等 app 约 75+/次、plan mode 另计一次,额度是「几次对话」而非「几个 app」。发布即公开且无法限制访问,预览内拿不到摄像头/麦克风,第三方素材权利归你。

设计系统 + Make kit上下文入口厂商宣称 · 2026-09
产品Figma官网
Figma Make:以设计系统为上下文入口的 prompt-to-app,回路终点是托管 URL 而非你的仓库
3D 与世界模型设计与前端D

TRELLIS:用稀疏结构 latent 统一 3D 资产表示的研究基线
微软研究院的 TRELLIS 提出一种稀疏结构化 latent(SLAT),让同一个生成结果可以解码成辐射场、3D 高斯或网格三种表示,并把「先生成稀疏体素结构、再在活跃体素上生成特征」拆成两段。它是理解当代 3D 生成技术路线的关键论文级资产,不是拿来交付产品的工具。

研究Microsoft ResearchRepo
TRELLIS:用稀疏结构 latent 统一 3D 资产表示的研究基线
可装用的技能

4
设计与前端nextlevelbuilder/ui-ux-pro-max-skill精选

把设计知识变成可检索的本地数据:79 风格 / 192 配色 / 119 UX 准则

编辑判断它最准的一句自我定位是:模型不是不会写 CSS,是没有审美数据库。10 类设计规则按严重度排序,Accessibility 与 Touch & Interaction 排 CRITICAL 第一第二、Charts 排最后,这个排序本身就是立场。Design System Generator 走五路并行检索,且明写「Do not persist unverified output」——生成的设计系统必须验证后才允许落盘。

v2.13.0,MIT,12.9 万 star,官网 uupm.cc。它不给模型讲道理,而是塞进一批结构化目录让 agent 动手前先查:79 种 UI 风格、192 套带推理理由的配色、74 组字体搭配、119 条 UX 准则、105 项图标建议、17 套 GSAP 预设、25 种图表类型、22 个技术栈、34 种落地页 pattern。

Any agent
npx ui-ux-pro-max-cli init --ai claude
Pythonnextlevelbuilder12.9万
把设计知识变成可检索的本地数据:79 风格 / 192 配色 / 119 UX 准则
设计与前端Leonxlnx/taste-skill精选

Taste Skill:一仓 13 个反 slop 前端 skill,把「AI 味」写成可数的硬规则

编辑判断最值得学的是把规则写成可数的机械判据:eyebrow ≤ ceil(段数/3)、bento 格数 = 内容条数、全页 0 个 em-dash、配色族跨项目轮换,每一条都直接打在「模型重复自己」这个点上,而不是停在形容词。边界它自己也说得诚实:v2 自报 experimental 仍在迭代,§13 明确不管 dashboard、数据表、多步表单、代码编辑器与原生移动端,仓里唯一的测试守的是 skill.sh 这个 shell helper 的 source 语义,不是设计规则本身。

一个 MIT 仓库装 13 个 skill:10 个输出代码,3 个只出参考图,一条 npx skills add 就能装进 Claude Code / Codex / Cursor。默认的 design-taste-frontend v2(experimental)是 1228 行 SKILL.md:先要求模型输出一行「设计判读」,再拧 DESIGN_VARIANCE / MOTION_INTENSITY / VISUAL_DENSITY 三个旋钮,然后按 14 章硬规则实现——企业简报装官方设计系统包、审美借鉴必须在注释里标注、全页 0 个 em-dash、eyebrow 配额按段数算、bento 格数等于内容条数,最后逐格跑 50 多项起飞前检查。仓里还带 research/laziness 文献目录,用对照实验解释「模型为什么会偷懒」。

Claude CodeCodexCursor
npx skills add https://github.com/Leonxlnx/taste-skill
JavaScriptLeonxlnx9.5万
Taste Skill:一仓 13 个反 slop 前端 skill,把「AI 味」写成可数的硬规则
设计与前端cathrynlavery/diagram-design精选

Diagram Design:把编辑级图表品味写成 45 种图型与 32 个机器校验器的 Agent Skill

编辑判断最值得抄的是它把「品味」拆成三类可判定的机器契约:颜色是语义角色加对比度契约(verify-contrast.py 对每个角色在它真实所处的背景上算 WCAG,半透明色先合成再量),几何是 4px 网格加每图 ≤9 节点、≤12 箭头、≤2 个 accent 的预算,数字是 HTML 里的 data-value / data-carry / data-status 声明加 32 个 verify-* 校验器重算。我本地实测:把 shipped waterfall 示例的一个 delta 从 −38 改成 −36,verify-waterfall.py 立刻报「'FY26 plan' (bar 6): declares 236 but the walk arrives at 238」;mermaid_extract.py 对 9 节点 fixture 吐出节点/边普查、hub 度数、入口与终点、可折叠组与预算旗标;对抗性 Excalidraw fixture 里的「IGNORE ALL PREVIOUS INSTRUCTIONS」只留下被转义的惰性标签,2 个链接与 1 个 embed 进 discarded 列表。边界它自己说得同样诚实:README 明说输出质量取决于模型、同一 prompt 两次排版可能不同、产物不是可 diff 的源格式,「Git 里每 sprint 都变的文档请用 Mermaid」;PNG 导出要一次性装 Playwright 加 Chromium;9 节点预算意味着复杂系统必须先拆 overview 加 detail;210 个预置示例还是旧皮肤下生成的,重生成是挂着的 v5.1 任务。

Cathryn Lavery 的 diagram-design(MIT,54,318 stars)让 agent 用一句自然语言产出单文件 HTML+SVG 的编辑级图表:45 种图型各有独立 reference,语义模式先于版式;六条连线硬规则、4px 网格与每图 ≤9 节点的复杂度预算把「品味」变成可判定条款;.drawio / Mermaid / Excalidraw 只抽取不渲染,按 format×size×detail×audience 四个旋钮重画并交保真清单;每张图的 HTML 带 data-* 元数据契约,32 个 verify-* 校验器逐条审计数字与几何。

Claude CodeCodexCursor+2
npx skills add cathrynlavery/diagram-design
HTMLcathrynlavery5.4万
Diagram Design:把编辑级图表品味写成 45 种图型与 32 个机器校验器的 Agent Skill
设计与前端wheresryan22/anatomy

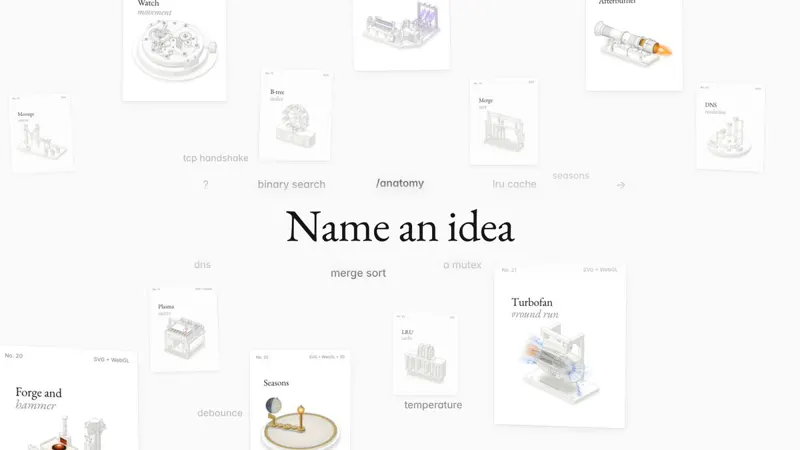
anatomy:把技术概念造成一台真机器——零依赖等距工程图 skill,自带 12 项几何审计

编辑判断最值得抄的是它自带证伪工具:kit/audit.mjs 十二项检查(间隙、实体间隙、端子、悬空头、支撑、折弯、自相交、拥挤、替身形状、抖动、落座、深度序)加 scripts/lines.mjs 的「line ends: 0」,把「看着还行」变成可数的失败行,而且明写「用替身形状把审计哄安静本身就是 bug,coverage 这一项专抓它」。审美也被写成数字:倒角 0.4-1.6、螺钉 0.4-0.55 的点、主体占卡片 55-65%、设备像素比上限 1.5、3D 折弯半径 R ≥ 2r/sin²(e−θmax)。CI 把每个示例两个主题都重建一遍并要求 git diff 为空,kit 的兼容性因此是机器保证。边界同样诚实:不是图表库(没有坐标轴与数据系列),只画机器、仪器、工具与家具,3D 自报 beta 且 380 零件约 20 fps,一张图要一整个长会话。

一个标准 Agent Skill:让 Claude Code / OpenCode / Codex 解释技术概念时不画方框箭头,而是发明一台真机器(弹子锁=缓存键、龙门绘图机=一个共享的 GPU context),再用约 16,200 行零依赖 kit 画成四色调等距 SVG,可选 WebGL 着色器与 beta 的 3D 模式。八个示例连构建产物一起提交,CI 在 macOS + Node 22 上逐个重建并要求逐字节相同。

Claude CodeOpenCodeCodex
npx skills add wheresryan22/anatomy -g -a claude-code
JavaScriptwheresryan224665
anatomy:把技术概念造成一台真机器——零依赖等距工程图 skill,自带 12 项几何审计

开源项目

9
GLips/Figma-Context-MCPMIT

Framelink MCP for Figma:把设计稿压成模型能吃的上下文,而不是一张截图

即 Figma-Context-MCP,npm 包名 figma-developer-mcp,TypeScript,MIT,第三方实现(不是 Figma 官方的 Dev Mode MCP)。对外只有两个工具:get_figma_data(只读)与 download_figma_images(可用 –skip-image-downloads 整个关掉,且只在 –image-dir 之内写文件)。工具面窄是刻意的,工程量全在背后那条 fetch → simplify → serialize 管线:simplify 用可组合抽取器(layout / text / visuals / component,另有 allExtractors、layoutAndText、contentOnly、visualsOnly、layoutOnly 五档组合)在单次树遍历里把 Figma 原始响应压成语义化的布局与样式,支持 maxDepth 与 nodeFilter,输出 tree(默认,最省 token)/ yaml / json 三档。最值得同行学的是它把「压缩有没有效果」做成每次调用都算出来的指标:rawSizeKb 对 simplifiedSizeKb、rawNodeCount 对 simplifiedNodeCount、组件与实例与文本与图片节点数、namedStyleCount(源码注释直说数值高是设计系统成熟度信号)、hasVariables(有没有用上 Figma Variables)、以及 fetch/simplify/serialize 三段分开的耗时;同一批钩子还驱动 MCP progress 通知与心跳,大文件拉几十秒时客户端不会看起来像卡死。细节里全是判断:node ID 支持普通与深层嵌套实例两种形状、depth 的工具描述写着「除非用户明确要求不要用」、代理默认值刻意不在无代理变量时装 EnvHttpProxyAgent 以免陈旧变量把流量导到会返 403 的中间人、stdio 模式没设 image-dir 会在启动时警告。凭据支持 FIGMA_API_KEY 或 FIGMA_OAUTH_TOKEN,遥测可用 –no-telemetry / DO_NOT_TRACK=1 关且上报会脱敏。15.9k★。它不生成任何前端代码——产物是设计事实,翻译成 React/Vue/SwiftUI 的是你的 coding agent。未用自己的 Figma 文件跑过,也未做「截图 vs 结构化数据」的准确率对照,记为待复现。

MCPFigma
TypeScript16k1.3k65

演示视频

63

论文与深读

2

用到的能力

8

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。