Gemini Omni:视频交付单位从「一次抽卡」变成「一段可对话的编辑过程」
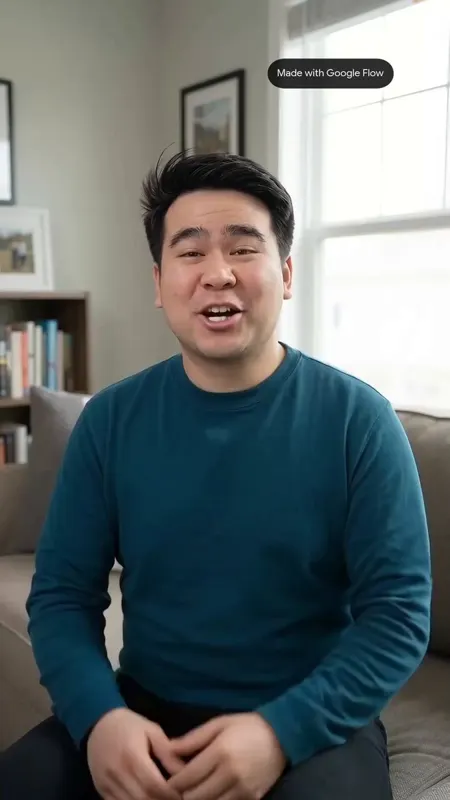
Google DeepMind 的视频与多模态生成模型,官方定位 create anything from any input, starting with video:逐步对话编辑视频,每次编辑建立在上一次之上并维持连贯场景,交付单位从一个镜头提到可改素材;另两条:真实世界知识、任意参考合成单一输出。水位连票数读:Artificial Analysis 竞技场(2026-09-22)文生视频榜 gemini-omni-1.1-flash 以 Elo 1516 第 1,但只有 1,784 票、CI ±15;第 2 同门 1513、26,576 票、±9,3 分差远小于各自 CI,统计不可区分,即 Omni 系列并列榜首。图生视频榜第 1 是 minimax-h3(1495、57,112 票),Omni 以 1488、3,734 票第 2。定价:输入 $1.50/1M tokens,输出文本 $9.00/1M、视频 $17.50/1M,720p 约 $0.10/秒、30 秒约 $3。付费层 GA、免费层无。闭源不可自托管、不能微调。置信度 A(已确认),视频域首条 A 档;A 指读数可信可核,不等于无争议第一。
1516Arena T2V Elo(1784 票)已确认 · 2026-09
Gemini Omni:视频交付单位从「一次抽卡」变成「一段可对话的编辑过程」可灵 3.0 系列:音频原生进模型、画面到 4K,参数化镜头语言仍是它的护城河
快手可灵是国内最早把视频生成推到「能接商业单」水位的一条主线,长期强项不在纯文生视频,而在图生视频与运镜控制:先由图像环节锁定构图与角色,再让视频模型在确定的关键帧上补间,配合首尾帧约束与推/拉/摇/移/环绕/跟随的镜头参数,做出可预测的短片段。3.0 系列(官方 release-note 横幅:全面开放 API)带来三处实质跃迁——音频原生进模型(5/10/12 秒音频档)、图像与视频原生 2K/4K、智能分镜与元素参考把多镜头连贯从剪辑问题变成模型可控问题;型号分工为 3.0 / 3.0 Omni / 3.0 Turbo、Kling Image 3.0 与 -omni、Native 4K Video、Motion Control。竞技场水位说实话:图生视频 kling-v3-pro 第 19(Elo 1354),前面是 MiniMax h3、gemini-omni、wan3.0、seedance-2.5。3.0 系列的官方发布精确日期未拿到权威源,指标日期只按可核验月份记 2026-09。闭源、只走厂商接口;未做基准复现,置信度记 C。
3.0 / Omni / Turbo当前旗舰系列厂商宣称 · 2026-09
可灵 3.0 系列:音频原生进模型、画面到 4K,参数化镜头语言仍是它的护城河Seedance 2.5:把视频交付单位从「一个镜头」提到「30 秒叙事」
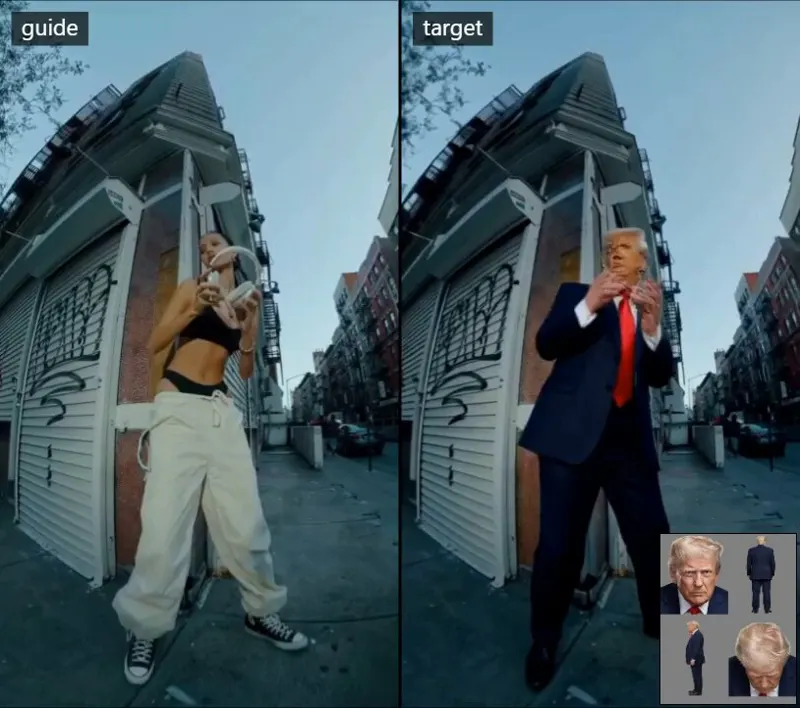
字节 Seed 的视频生成主线。1.x 是文生/图生的静音短镜头,2.0 起换成统一多模态音视频联合生成架构(文本/图像/音频/视频四类输入),2.5 把交付单位直接提到 30 秒一段叙事,并支持再续写两次、白模控制、绿幕编辑、专业运镜与表演调度。第三方水位是它最硬的地方:Artificial Analysis 竞技场(2026-09-22)图生视频 dreamina-seedance-2.5-720p 第 4(Elo 1477),文生视频 2.0 第 5(1479)、2.5 第 7(1474)。闭源,只走 Dreamina / 火山引擎 / BytePlus,不能自托管与微调;SeedVideoBench-2.0 是内部评测,无法独立复现。未做基准复现,置信度记 C(厂商宣称)。
30s单次生成叙事时长厂商宣称 · 2026-09
Seedance 2.5:把视频交付单位从「一个镜头」提到「30 秒叙事」Wan 万相:视频生成侧的开放权重基线,让整个生态能在自己机器上迭代
阿里通义万相把视频生成模型以 Apache-2.0 放出权重,是视频域里最重要的公共基线。它的价值与闭源服务不同:不在于「今天出片最好看」,而在于可微调、可复现、可在自己的推理栈上跑——LoRA、ControlNet 式条件控制、量化加速、蒸馏少步数这一整套生态工作都围绕它展开。对情报站来说,一个开放权重基线意味着「视频生成现在能做到什么」这个问题第一次有了可以自己验证的参照系,而不必相信厂商精选样本。许可与仓库公开这两条已核验,画质与物理表现仍是 C 级厂商口径。
Apache-2.0开放权重许可厂商宣称 · 2025-07
产品阿里巴巴通义 Alibaba Tongyi官网Repo Wan 万相:视频生成侧的开放权重基线,让整个生态能在自己机器上迭代FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线
Black Forest Labs 的 FLUX 家族用整流流(rectified flow)Transformer 做图像生成,并放出 Apache-2.0 的 dev 档权重,是开源侧最重要的图像基线;Kontext 一档把「按指令改这张图的局部而不动其余」做成了可用能力。采集库里另有 FLUX 3 的发布记录,厂商把它定位成统一图像/视频/音频的世界模型,这一主张记为待核验。
Apache-2.0开放权重档位(dev)厂商宣称 · 2024-08
产品Black Forest Labs官网Repo FLUX:把图像生成从「出图」推进到「可控编辑 + 开放权重」的那条主线豆包工作:从 PPT 到操作电脑,字节的生产力 agent
字节 2026-08 推出的生产力 agent:做 PPT/文档/表格、深入调研、定时任务,还能读写本地文件、跨页面填表,并用手机远程派发任务。
Office 三件套 + 电脑操作能直接交付什么(厂商宣称)厂商宣称 · 2026-08
豆包工作:从 PPT 到操作电脑,字节的生产力 agentOpenMontage:把你的 AI 编程助手变成一整间视频制片厂
开源的 agent 化视频制片系统:代码里没有编排器,Claude Code、Cursor、Copilot、Codex 等编程助手本身就是编排器。YAML 流水线清单、Markdown 导演技能、100 多个注册工具与七维打分的供应商选择器,把调研、提案、剧本、场景计划、素材、剪辑、合成做成带创意审批门与预算治理的流水线;零 API key 也能靠 Piper 离线语音、Archive.org/NASA/Wikimedia 与免费素材库剪出真 footage 视频,Backlot 看板把阶段、故事板审批与逐笔花费摊在墙上。
71kGitHub Star 数
OpenMontage:把你的 AI 编程助手变成一整间视频制片厂HyperFrames:写 HTML 就能渲染视频、为 Agent 而生的开源确定性视频引擎
HeyGen 开源的 HyperFrames 把视频定义成带 data-* 时间属性的 HTML:无构建步骤、index.html 直接可播可预览;渲染时无头 Chrome 逐帧 seek 抓取、FFmpeg 编码,同一输入永远得到同一支 MP4。它自带 21 个 agent 技能、frame.md 设计系统转译层与 Catalog 组件库,Claude Code / Codex / Cursor 等编码代理可以跑完 plan—write—lint—preview—render 的整条生产循环;AWS Lambda 路径支持分布式渲染。Apache-2.0,无按次渲染费用。
63kGitHub Star 数
HyperFrames:写 HTML 就能渲染视频、为 Agent 而生的开源确定性视频引擎Toonflow:开源 AI 短剧与漫剧视频生成平台,剧本、分镜、资产与镜头在同一张无限画布上成片
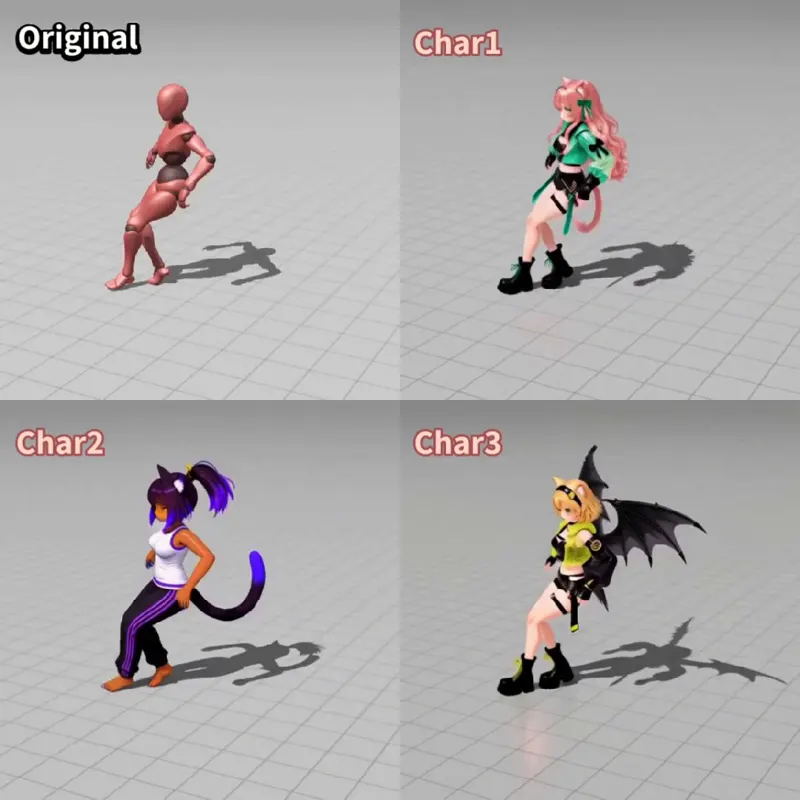
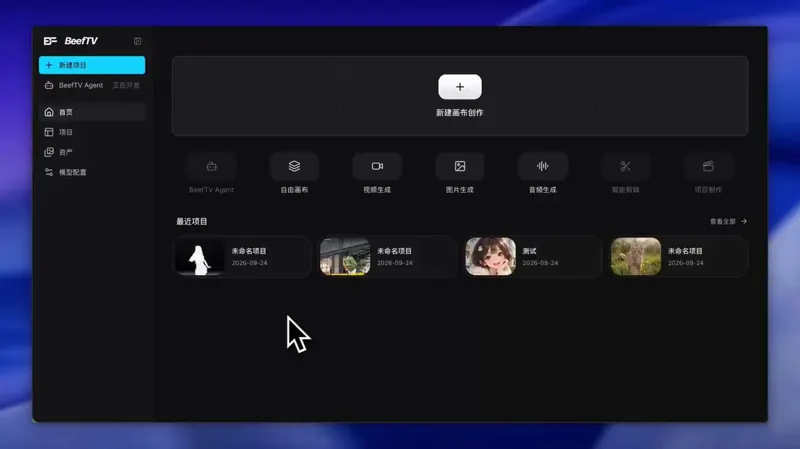
Toonflow 把短剧与漫剧的制作链路产品化为无限画布节点:文本节点写剧本与分镜,图片生成节点出角色三视图与场景图,视频生成节点按参考素材逐镜头出片,音频节点与 3D 导演台补齐配音与机位预演;模型层完全开放,第三方 API、本地 ComfyUI 与 LLM 皆可接入,Agent、MCP 与插件市场把同一张画布开放给机器。MIT 许可,桌面 / Android / Docker / 服务器四态部署。
18kGitHub Star 数
Toonflow:开源 AI 短剧与漫剧视频生成平台,剧本、分镜、资产与镜头在同一张无限画布上成片Wan2GP:让 6GB 显存的显卡跑主流生成模型
面向显存贫乏者的一站式本地生成应用:视频、图像、音频与语音模型统一入口,底层 MMGP 用块交换、显存预载与七档 Profile 把超显存模型跑起来,最低 6GB 显存。
10kGitHub Star 数
Wan2GP:让 6GB 显存的显卡跑主流生成模型LiveTalking:实时交互流式数字人引擎
LiveTalking 用插件化链路串起 LLM、TTS、三种口型模型与 WebRTC、RTMP、虚拟摄像头输出,支持打断、动作编排、录制和多会话。
9.7kGitHub Star 数
LiveTalking:实时交互流式数字人引擎Pika H3 Flex:最多 12 路引用驱动的六步同步音视频生成
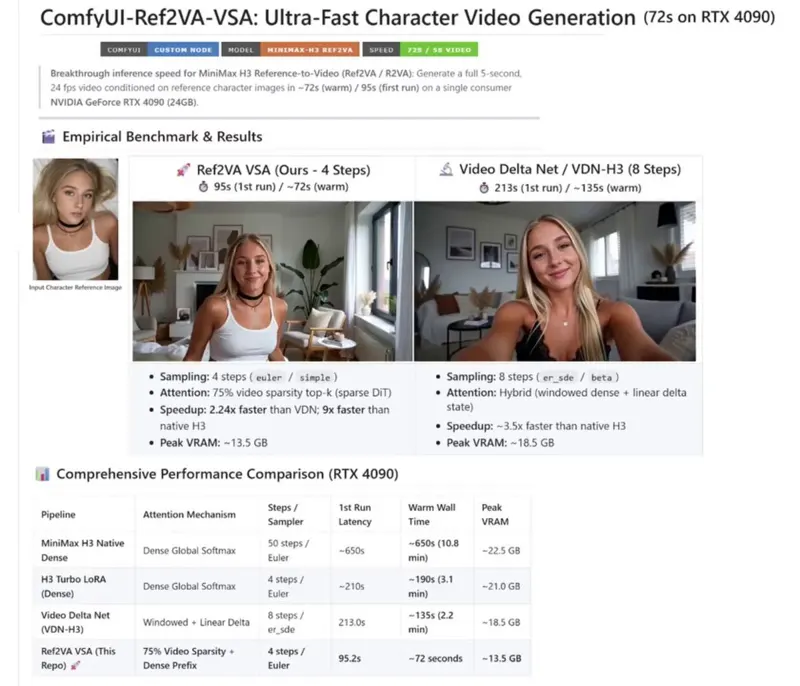
Pika Labs 在 MiniMax-H3 上开源的双适配器音视频生成工具,支持首尾帧和多模态引用,六步联合生成视频与立体声,并明确算力与许可证边界。
1.3kGitHub Star 数
Pika H3 Flex:最多 12 路引用驱动的六步同步音视频生成LiveKit Agents:把实时语音 AI 智能体做成可编程参与者
LiveKit Agents 是开源的实时语音 AI 智能体框架(Apache-2.0,15.0k star):智能体以服务器端「可编程参与者」身份加入 WebRTC 房间,能听、能看、能说。Agent、AgentSession、entrypoint、AgentServer 四层抽象之上,是 83 个可插拔 STT/LLM/TTS/Realtime 插件与 LiveKit Inference 统一模型字符串;轮转检测 transformer、自适应打断与 AMD 答机检测把对话稳健性做进框架;原生 MCP、多智能体交接、pytest 事件流断言加 LLM 评委,console/dev/start 三种运行模式直通生产调度与电话栈。
15kGitHub Star 数
LiveKit Agents:把实时语音 AI 智能体做成可编程参与者