PAPER DEEP DIVE
轮子+腿+层级强化学习:ETH 苏黎世街头 8.3 公里自主配送的背后
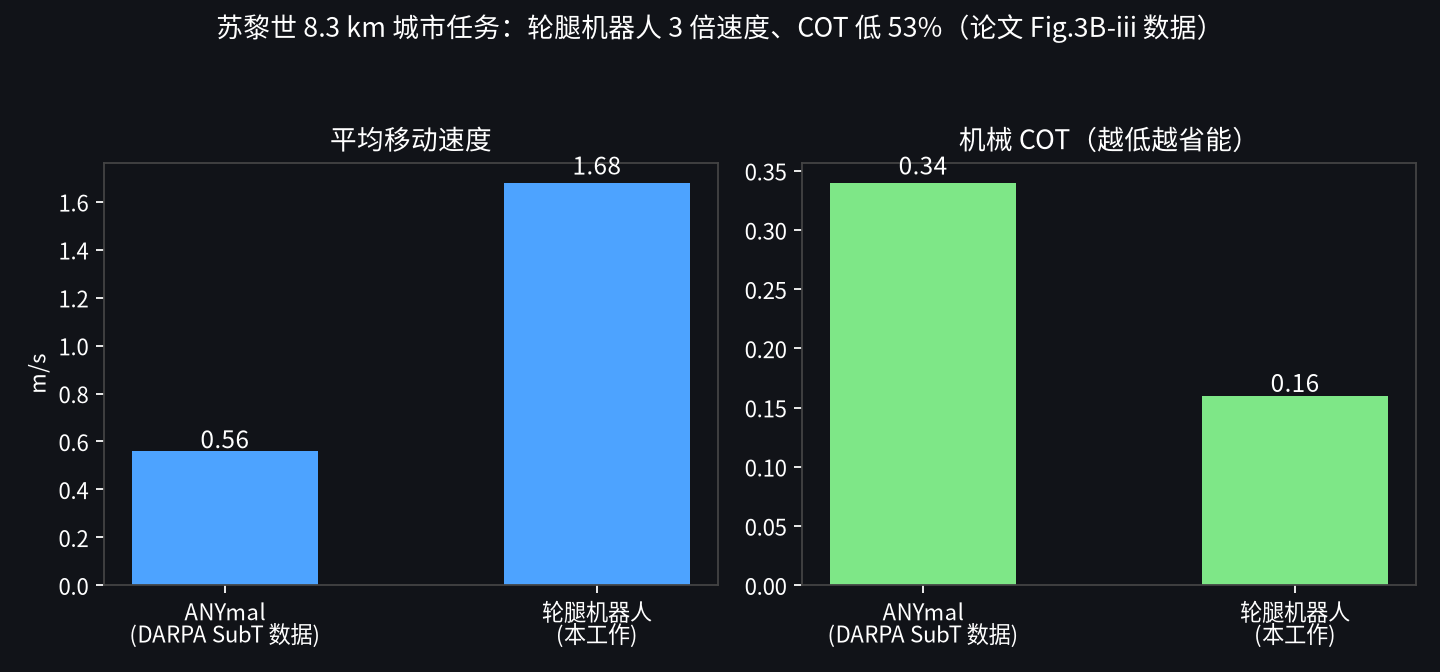
ETH Zurich Hutter 团队(Science Robotics 2024)用三层强化学习(LLC 运动控制 + HLC 导航 + 全局规划)打通轮腿混合机器人的城市自主配送:8.3 公里仅 3 次人工干预,平均 1.68 m/s、机械 COT 0.16(比 DARPA SubT 腿式快 3 倍、能耗低 53%),导航推理 0.34 ms 比采样规划器快三个数量级且零碰撞;步态完全涌现(爬行驱动、主动悬挂、膝盖攀爬),并诚实标注了感知视野、语义缺失与人工建图三大边界。
轮子+腿+层级强化学习:苏黎世街头 8.3 公里自主配送的背后
最后一个送进你家门口的包裹,可能是四条腿上装着四个轮子的机器人送来的。ETH Zurich 机器人系统实验室 Marco Hutter 团队发表在 Science Robotics(Vol. 9, Issue 89, 2024)的这项工作,把「轮腿混合机器人如何真正在城市里自主干活」这个问题做成了一套完整系统:自适应运动控制(LLC)+ 移动性感知的局部导航(HLC)+ 城市级全局路径规划,三层全部由强化学习驱动,并在苏黎世与塞维利亚完成了公里级自主导航验证。
为什么要轮腿混合?论文开篇算了一笔账:纯腿式的 ANYmal 在 DARPA 地下挑战赛中的平均速度约 2.2 km/h——比普通人步行还慢一半,且续航最多 1 小时;纯轮式机器人则上不了台阶。城市配送的场景恰恰两头都要:大面积平坦路面要高速高效,楼梯、路缘、碎石、草坪又要求越障能力。轮腿机器人在每条腿末端装驱动轮,平坦路面滚着走、复杂地形迈着走,是这条需求曲线的自然解——但前提是有人能解决「什么时候该滚、什么时候该迈」这个混合步态难题。
(预扫描点云 + 导航图, 人选目标点)"] --> WP["两个路点 WP1/WP2
(pure-pursuit 前视插值)"] WP --> HLC["HLC 高层导航控制器 (10 Hz)
输入: LLC 信念状态 + 地形高度 +
过去 10m 访问位置记忆"] HLC -->|"速度目标"| LLC["LLC 低层运动控制器 (50 Hz)
RNN 策略 + 特权学习
自主选择步态: 走/驱/混合"] LLC -->|"关节位置+轮速"| R["ANYmal 轮腿机器人"] R -->|"IMU/编码器/高度图"| HLC
LLC:把步态选择完全交给学习,不给人任何直觉
低层运动控制器(LLC)是 RNN 策略,基于 Miki 等人的感知运动控制框架,但做了两处关键改动:改进观测/动作空间,并彻底移除工程化的运动基元(CPG)。训练用特权学习:训练阶段智能体能看到真实速度/加速度、地形属性、无噪声外感受测量,部署时策略只依赖 IMU、关节编码器和机载高度图的原始测量——连传统的状态估计器都不要了,直接用原始传感器读数,减少启发式滤波带来的失效点。结果是步态完全涌现:大离散障碍上出现爬行+驱动的非对称步态,楼梯和陡坡上回归经典 trot 步态,起伏路面(高度差接近轮半径)直接滚过去——四条腿同时微调伸展幅度充当主动悬挂,让轮子保持贴地;下坡时主动压低身体防倾覆。平地峰值速度 5.0 m/s(硬件极限 6.3 m/s)。最戏剧性的两个镜头:从约 60cm 高的桌面开下去时前腿先伸后蜷保持机身水平,前轮落地瞬间前滚恢复平衡;上约 40cm 高台时四轮全部悬空,就用膝盖爬行直到某个轮子重新触地——这类行为没有模型可以设计,正是无模型 RL 的价值所在。
HLC:用 0.34 毫秒替代传统「规划+跟踪+通信」三件套
高层导航控制器(HLC)是本文最大的技术贡献:它把传统导航栈里的路径规划、路径跟踪、模块间通信三个模块合成一个神经网络,以 10 Hz(与机载高度图更新率对齐)直接输出速度目标。输入有三路:LLC 的信念状态(RNN 隐状态,编码地形属性与扰动)、机器人周围地形高度值、以及一个独特的位置记忆——过去访问过的 20 个位置(每 50cm 记录一个,覆盖 10 米,恰好是典型路点间距),让 HLC 基于自己的导航历史做决策。训练环境用计算机游戏的 Navigation Graph 概念 + WFC 程序化内容生成:每条 episode 生成新的无障碍路径、随机采样路点,含绕行、动态障碍、粗糙地形与窄通道,并奖励沿最短路径走向目标——这种受控组合的训练方式效果优于随机撒障碍。
8.3 公里、30 分钟级任务、三次人工干预
苏黎世 Glattpark 的交付演示任务:先用 handheld 激光扫描仪花 90 分钟扫描 245m×345m 城区,生成点云、建导航图、由人放置目标点(导航图同时编码社会偏好——避开绿化带和私人领地)。部署时机器人用 LiDAR 在预扫描点云中定位(高楼间比 GPS 稳),收到一个 GPS 目标点后完全自主规划与行进,点云只用于定位、不用于导航。机器人累计自主行驶 8.3 km,全程仅三次人工干预:路径上有小孩(虽可绕行但主动停车保安全);导航图建成后长出了高草(安全停下,人工触发全局重规划);长走廊等几何退化环境定位漂移(靠局部地形图安全行驶,等定位恢复)。速度与能耗的对比是全文最亮眼的数据:平均 1.68 m/s、机械 COT 0.16——对比 DARPA SubT 中 ANYal 的数据,速度 3 倍、COT 低 53%。增益主要来自驱动模式:四条腿均匀承重、关节几乎静止,驱动时关节的机械 COT 贡献接近零;单看腿部关节的能耗比 ANYmal 还低 16%(尽管重 12kg 且更快)——这与发热损耗直接相关。
局部导航的四个「有脑子」瞬间
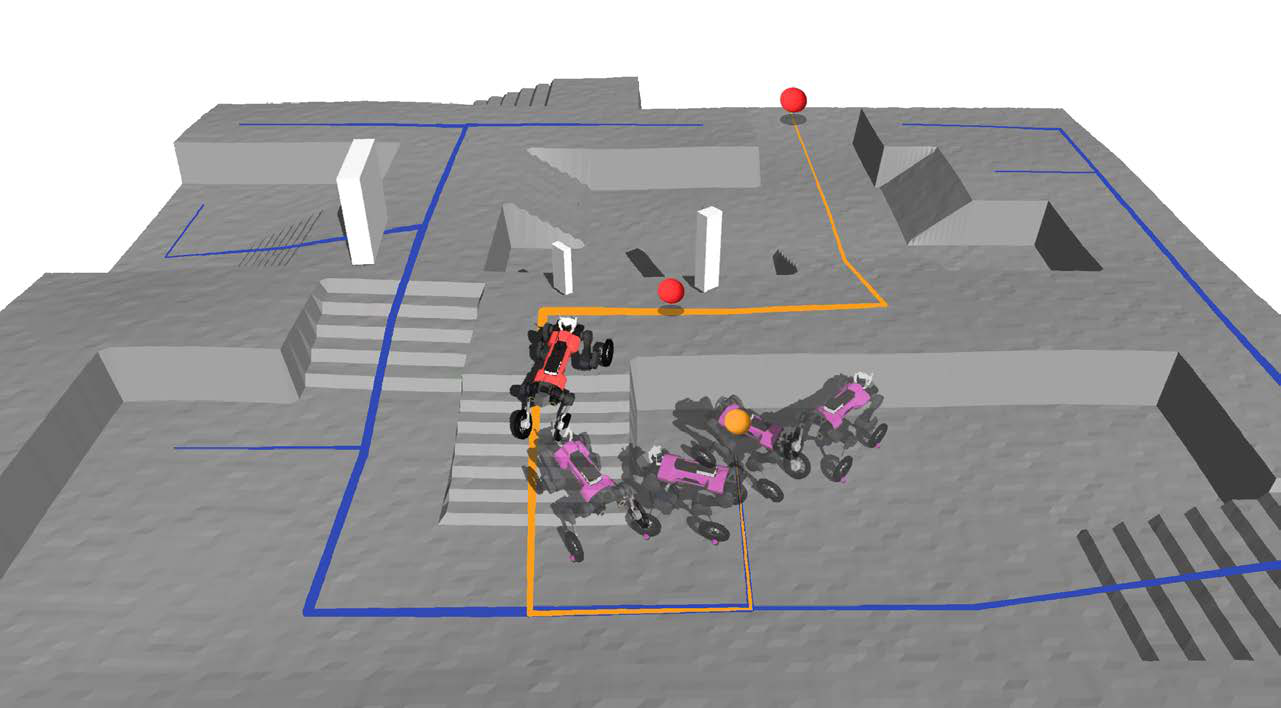
论文的局部导航案例读起来最像「机器人有智能」。探索性绕障:路被堵死时,机器人会倒车、沿墙搜索,直到找到通往目标的楼梯——位置记忆让它知道自己去过哪。窄门穿越:两个门、门间站着一个人、缝隙恰好和机器人一样宽——无碰撞通过(当时甚至没开人体检测)。非对称越障认知:面对楼梯+0–50cm 变高台阶的组合障碍,机器人先倒车探索,沿台阶找到约 20cm 的可行高度再上;数据分析进一步显示它下台阶能过比上台阶更高的坎——这打破了传统通行性代价图「与运动方向无关的对称估计」的假设,说明 HLC 真的在基于当前地形、自身状态和低层控制器的特性做决策,而不是查一张静态代价表。动态避人:相机人体检测在行人周围 50cm 半径注入高度偏移,HLC 与行人保持恒定距离安全超越。
与采样式规划器的正面对比:快 3000 倍,且零碰撞
对比实验揭示了「学习式紧耦合导航」相对传统采样规划的本质优势。基线是基于通行性代价图的采样规划器(为腿式机器人设计的 SOTA 方法,单次规划需数秒)。结果:①速度——HLC 从观测更新到网络推理平均 0.34 ms,基线在桌面机(Ryzen 9 3950X + RTX 2080)上超过 1 秒,差三个数量级;②碰撞——只有本方法实现零碰撞轨迹,基线因重规划延迟 + 假设完美跟踪而反复撞上动态变化,且远距离位姿目标导致高速指令过冲;③跟踪误差——本方法平均 0.24 m/s 且分布均匀,基线 0.45 m/s 且在指令突变时出现尖峰(LLM 直接拒绝执行不合理的速度指令);④探索——在部分可观测场景中本方法能动态探索新区域,成功率最高;消融实验证明去掉位置记忆的策略陷入重复行为与局部极小,失败率最高。这些结果共同说明:当机器人运动快到秒级规划来不及反应时,导航必须与运动控制的实际能力(延迟、误差、步态特性)联合训练,而不是各自最优后再拼起来。
数字之外:基线为何总在撞
对比实验的失败案例分析比成功率数字更有信息量。基线采样规划器的失败被归为两类根因。遮挡处理:通行性代价图来自高度图,被遮挡区域默认不可通行,规划器在这些区域前反复卡死;给遮挡区域打上「可通行」的启发式补丁后能解部分问题,但重规划延迟让它在环境变化时依然措手不及——而 HLC 的位置记忆 + 探索行为让它能「去看一眼」再决定。跟踪误差假设:几乎所有传统方法都假设运动控制器完美执行速度指令,但真实的 LLC 有延迟、有误差、有拒绝执行不合理指令的保护逻辑;当基线给出远距离位姿目标时产生的高速指令导致过冲,机器人冲出可通行区域——这类「规划器聪明、执行器跟不上」的失配在快机器人上被速度放大。反观本方法,HLC 与 LLC 是联合训练的:高层的每个速度指令都在训练中「体验过」低层的真实响应,指令天然落在低层能力的包络内。这正印证了论文导言里 DARPA SubT 的教训——模块各自最优、靠启发式拼起来的系统,会在真实环境中出现中途停顿重规划、锯齿形运动等低效行为;紧耦合的学习式系统把「模块间通信」这个工程黑洞直接吃进了网络权重里。
诚实的边界
作者对系统局限的交代同样值得读。其一,语义信息几乎缺席——目前除「给行人注入高度偏移」外全靠几何信息,铺装路面检测、视觉通行性估计等场景理解是明确的下一步。其二,感知视野受限——HLC 只看前方 3 米,这是高度图的固有约束;机器人硬件能跑 6.2 m/s,但自主部署时因建图延迟根本不敢跑到最大速度,「去掉高度图、直接消费原始传感器流」被点名为最有希望的方向。其三,建图仍然要人工——90 分钟手持扫描对大规模部署是现实瓶颈。这些坦白让「公里级自主配送」的结论显得更可信:系统已在真实城市的复杂环境中工作,而它的天花板也被清楚地标注了出来。
把整套系统拼起来的工程细节
公里级自主不是两个神经网络就能撑起来的,论文对系统集成的交代同样密实。机器人载荷包括三个 LiDAR、前置 RGB 立体相机、配送箱、5G 路由与 GPS 天线——其中 RGB 相机独立于点云地形图存在,因为点云地形图捕捉不了动态障碍:相机以高频跑人体检测,20 米内实时跟踪行人,并在检测位置周围的高度图上注入缓冲偏移。全局路径来自导航图上的最短路算法,路径点间距 2–20 米,经 pure-pursuit 思路在机器人当前位置投影与下一个图节点之间插值出 WP1/WP2 两个前视路点;目标点经移动网络下发,路径在机载计算。定位方案值得一提:在预扫描点云中做 LiDAR 定位(LiDAR+IMU+关节编码器),作者实测这比 GPS 在高楼间更稳——GPS 在城市峡谷里的多路径效应是配送机器人落地的经典坑。三次人工干预的记录也精确到场景:路径上的儿童(可绕但主动停)、导航图建成后长出的高草(建图与部署之间的现实时间差问题)、长走廊定位退化(几何退化环境是 LiDAR 定位的软肋)。这些细节共同回答了一个审稿人必然要问的问题:这套系统是真在城里跑过,还是又一个仿真里的完美曲线。
混合步态的定量刻画:为什么「下台阶比上台阶强」
论文对混合运动的定量分析很有味道,因为它揭示了基于模型的规划很难捕捉的复杂性。台阶高度与指令速度的关系:机器人能越过的最大台阶高度随指令速度变化,且下台阶明显强于上台阶——这与 HLC 的行为吻合(它会避开向上过不去的高坎以保护膝盖并确保安全),说明「能过」不是地形和机器人的静态属性,而是地形 × 机器人状态 × 运动方向的三元函数。坡度 × 速度的步态边界:在摩擦系数固定为 0.7 的仿真坡面上,以固定线速度上坡测试(能爬 2 米判成功),发现迈步步态只在坡度陡且指令速度超过 0.5 m/s 时才涌现——低速时驱动模式反而更稳。这意味着传统基于模型的规划与路径跟踪方法即便给出完美的通行性地图,也难以刻画「该用哪种步态以什么速度过这段坡」这类耦合决策。与传统 MPC 控制器的对比:团队此前的 MPC 控制器缺乏鲁棒性,在论文 Fig.6 展示的真实地形(草地、沙地、碎石、楼梯、坡面)上根本无法运行——而学习式 LLC 在所有这些地形上都给出了自适应步态。这一组结果共同指向本文的深层论点:轮腿混合系统的设计空间太大(步态 × 速度 × 地形 × 载荷),手工规则与模型优化都覆盖不全,把设计空间交给 RL + 特权学习是务实的选择。
为什么选显式分层而不是端到端:一个工程决策的样本
论文在方法部分难得地公开了架构选择的思考过程,对做系统的研究者是很好的参考。团队考虑过三种方案:①端到端统一策略(同时管运动+导航,如 Rudin 等人的做法);②学习式潜在子目标的高层低层解耦(子目标隐式学习,灵活但黑箱);③显式子目标的 two-level HRL——低层专注运动、高层输出速度目标。他们选了第三条,理由全是工程现实:显式切分让两个控制器可以独立开发(两个小组并行推进互不阻塞)、低层策略可跨高层应用复用(符合腿式机器人领域的普遍实践)、且高层输出的速度目标物理可解释,调试时人看得懂。团队还试过让高层直接命令步态参数(类似 Tsounis 等人的做法),实验记录在补充材料里。这个「没有选最优雅方案、选了最可维护方案」的决策过程,与论文里三次人工干预的诚实记录一起,构成了一篇顶刊系统论文应有的工程诚实。
这篇论文为什么值得放进机器人学习的必读清单
它的价值可以从三个层次看。系统层:这是少数把「感知-导航-运动」三层真正端到端打通并在真实城市跑出公里级里程的工作,而不是某一行代码的改进——从手持扫描建图、导航图的社会偏好编码、移动网络下发目标、LiDAR 点云定位,到两个神经网络的层级协作,每一环都有工程细节与失败记录支撑。方法层:它把「导航规划」与「运动控制」之间那条一直靠手工接口连接的缝,改成了联合训练——HLC 消费 LLC 的 RNN 隐状态而非显式状态估计,直接输出速度目标而非位姿目标,位置记忆替代了显式地图搜索;0.34 ms 的推理延迟让导航决策第一次快到能与 5 m/s 级别的移动速度匹配。结论层:速度 3 倍、机械 COT 低 53%(单看腿部关节能耗也更低),证明轮腿混合不只是「两种模式的拼凑」,而是能在平坦城市环境中把腿式机器人 1 小时续航、2.2 km/h 的现实瓶颈正面推开的一条路径。而对做具身智能的人来说,最值得记住的也许是那个 DARPA SubT 的教训:把各自的 SOTA 模块用启发式拼起来,得到的常常是中途停顿、来回锯齿的「能跑但难看」的系统;真正的自主性长在模块之间的连接处。
引用
- 论文:Learning Robust Autonomous Navigation and Locomotion for Wheeled-Legged Robots — arXiv:2405.01792;正式发表于 Science Robotics, Vol. 9, Issue 89 (2024)
- 作者:Joonho Lee, Marko Bjelonic, Alexander Reske, Lorenz Wellhausen, Takahiro Miki, Marco Hutter(ETH Zurich Robotic Systems Lab)
- 主结果视频:Movie 1;完整任务:Movie S1;运动实验集锦:Movie S3