PAPER DEEP DIVE
CHOREO:把每个人形技能都变成一条轨迹——免训练组合 2950 个异构技能,G1 八动作长序列成功率 93.8%
中国海洋大学与中科院自动化所的 CHOREO 把 RL 策略、动捕数据、生成模型的输出统一为 SkillMotion 轨迹资产,LLM 规划 + 边界失配评分 + 五次多项式接缝 + 站立桥实现免训练长时程技能组合:552 个技能边界切换成功率 96.7%、摔倒率 4.6%(最强基线 41.5%),八动作序列 93.8% vs 最强基线 41.7%;另验证 6 个 Tracker 接口兼容与 3069 个异构实例 100% 导入。全文仿真完成,真机部署是留白。
要理解 CHOREO 的切入点,可以先看一个具体场景:让机器人「向前走,做一个马步,再继续走」。这里 walk_forward 和 horse_squat 可能分别来自完全不同的世界——前者是 RL 策略,后者是动捕数据集里的一段人体动作重定向。传统做法要么为这组序列专门重训一个策略,要么靠工程师手写状态机在两个控制器之间切换,每次换技能组合都要重来一遍。CHOREO 要消灭的正是这一步:技能库里有什么,机器人就能按语言指令串什么。
一句话与背景:为什么「会得越多」不等于「越能干」
过去两年,人形机器人的「技能清单」以前所未有的速度变长:强化学习跑出了敏捷运动,动捕模仿教会了全身控制,遥操作积累了真值示范,生成模型甚至可以凭文本合成全新动作。但中国海洋大学与中国科学院自动化所团队在这篇发表于 arXiv 2026 年 9 月的论文里指出了一个尴尬的现实:这些技能彼此是孤岛。它们由不同范式训练、用不同表征存储、依赖不同控制器接口——一个 RL 策略输出的动作流、一段动捕数据集里的关节轨迹、一个扩散模型合成的骨架序列,三者之间没有任何一个「即插即用」的衔接方式。论文把这个问题讲得很直接:单纯累积独立训练的能力,并不会自然产出一台更能干的机器人。
现有方案的主路线是「训一个更大的统一策略」:把越来越多样化的数据喂给一个控制器,让它覆盖更广的技能分布。这条路确实有效,但论文点出它的根本局限——每加一个技能都是一次训练问题:要收集兼容数据、改训练分布、重训越来越大的策略。而今天人形技能的生产者已经高度分散——不同研究社区、不同仿真平台、不同生成模型各自产出,「重训式统一」的可扩展性正变得越来越差。于是作者提出了一个互补的关键问题:异构的预训练人形能力,能否在不重训原模型的前提下被持续累积、复用与组合?
CHOREO 的回答建立在一个非常朴素的观察上:不管技能是怎么学出来的,它最终都表现为一段可执行的机器人运动轨迹。RL 策略通过交互生成轨迹,动捕数据显式存储轨迹,生成模型合成的动作也能转换成轨迹。与其费力统一各控制器的内部架构,不如统一它们的行为输出。这个转向把「技能生成」与「技能执行」解耦成两层——新能力接入只是往轨迹库里加资产,而不用碰任何已有控制器。扩充机器人行为,从「反复重训日益复杂的策略」变成了「增长一个可复用的运动技能库」。
用一句话概括它的卖点:训练无关的集成、异构兼容、可扩展且可持续——这三点正是论文 Self-Overview 里给 CHOREO 的三个标签,也分别对应后文的三组实验。
CHOREO 框架:三层结构与 SkillMotion 统一表示
CHOREO 的运行时由三个组件串起来。第一层是离线注册:Source Adapter 把三类来源——动作数据集(解码即得)、RL 策略(在其原生仿真器里 rollout 出有限时程轨迹)、生成模型(在其原生环境里生成后转换)——统一「实体化 → 规范化 → 标注」,只摄取身体状态轨迹本身,不碰源模型参数与策略动作。所有轨迹重定向到统一的本体表示:论文采用 23 自由度 Unitree G1、30 Hz 采样,并统一关节顺序、坐标约定与单位。
每个技能被表示为一个 SkillMotion 资产 M = (τ, z, b_in, b_out, e):τ 是 T 帧轨迹(含关节位置速度、根位姿、足底接触);z 是语义描述子(标签、动作属性、来源溯源);b_in/b_out 是结构化的边界描述子——进入/退出窗口加上运动画像摘要,这是后续组合的关键;e 是执行描述子,记录目标本体、Tracker 配置与验证证据。缺失的速度从序列差分推出,接触状态有则保留、可从运动学推断则推断,否则标记为「未知、零置信」——论文特意强调:未知接触不能当成「确知无接触」处理。
注册有一条验证门:格式合法性、运动一致性、以及用所配 Tracker 做物理可跟踪性检查。可修复的候选定周期修正后重检;通过者携验证证据入库,失败者被隔离,绝不对运行时暴露。最终论文的组织了 2,950 个准入 SkillMotion(来自 2,901 条运动轨迹、16 个 RL 策略、33 个生成模型的异构来源)。换句话说,库里近三千条轨迹从三种截然不同的范式来,但运行时看到的只有同一种格式——这正是后面「多 Tracker 兼容」和「来源吸收」实验能跑通的前提。
动作数据集 / RL 策略 / 生成模型"] --> B["Source Adapter
实体化 → 规范化 → 标注"] B --> C["验证门
格式 / 一致性 / 可跟踪性"] C -->|通过| D["SkillMotion 库
τ 轨迹 + z 语义 + b 边界 + e 执行"] C -->|失败| E["隔离区"] F["用户语言指令"] --> G["LLM 任务规划器
只定语义顺序, 不定轨迹"] G --> H["技能检索与序列解析"] D --> H H --> I{"边界失配 d_i < δ ?"} I -->|是| J["五次多项式局部接缝
位置/速度/加速度六约束"] I -->|否| K["插入稳定站立桥 τ_st
两段接缝拼接"] J --> L["Tracker 适配器
参考/观测构造"] K --> L L --> M["GMT @ 50 Hz
Unitree G1 (MuJoCo)
输出 23 维关节目标"]
核心方法:边界失配评分、五次接缝与站立桥
为什么是「冻结」这么重要?因为整个框架的价值主张都压在这一点上:如果组合时还要微调 Tracker 或重跑 RL 训练,「免训练集成」就不成立。冻结协议意味着所有新技能、新来源、新组合都零梯度地进入系统——技能库从 2,901 条轨迹长到 3,069 个实例的过程中,没有任何一次反向传播。这也让「持续学习」的形态发生了变化:机器人能力的增长不再体现为模型权重的更新,而体现为资产的累积,可以随时回滚、审计、按需加载。
组合的难点在于:每个技能单独验证过,不等于拼起来能连续执行。CHOREO 在线时由 LLM 任务规划器把自然语言指令解析成规范化的技能标签序列(如 walk_forward → horse_squat → walk_forward)——注意规划器只定语义顺序,不生成轨迹与控制命令;真正的物理衔接由运行时处理。
对相邻技能对 M_i 与 M_{i+1},CHOREO 先在平面位置与航向上对齐后继技能,再在标注的退出/进入窗口内选定拼接端点,计算边界失配分:对关节位置、关节速度、根高度、根线速度四个特征族 F = {q, q̇, h, v},按各自维度归一化后加权求和,再加上一项置信度加权的足底接触失配。权重的分工很讲究:关节位置差度量「姿态对不对」,速度差区分「姿态相似但运动趋势不同」的情形,高度与接触项刻画竖直姿态与支撑构型。这个分数是参考级筛选标准而非可行性保证——失配分低于阈值 δ 即可直接衔接。
直接衔接时,CHOREO 用一段五次多项式接缝替换短边界窗口:六个端点约束(两侧各自的位移、速度、加速度)唯一确定多项式系数,接缝外动作原样保留。五次(而非论文早期描述里的三次 Hermite)保证加速度连续,这是低层控制器不抖动的关键。当失配分超阈值,则插入一个预验证的稳定站立参考 τ_st 作为桥——桥不是局部平滑,而是真正改变中间参考:先用同样的接缝算子把源技能接进站立,再把站立接进后继技能。所有环节(原技能、接缝、桥)走同一个执行接口,由 Tracker 专属适配器做坐标转换、时间重采样与参考窗构造。
执行侧论文固定使用 GMT 跟踪器:参考存 30 Hz,GMT 以 50 Hz 控制频率消费,输出 23 维关节目标。评测采用「冻结协议」——在线组合与执行阶段不调用任何源生成器或源策略,只用预先注册的资产。
实验一:长时程组合——序列越长,优势越大
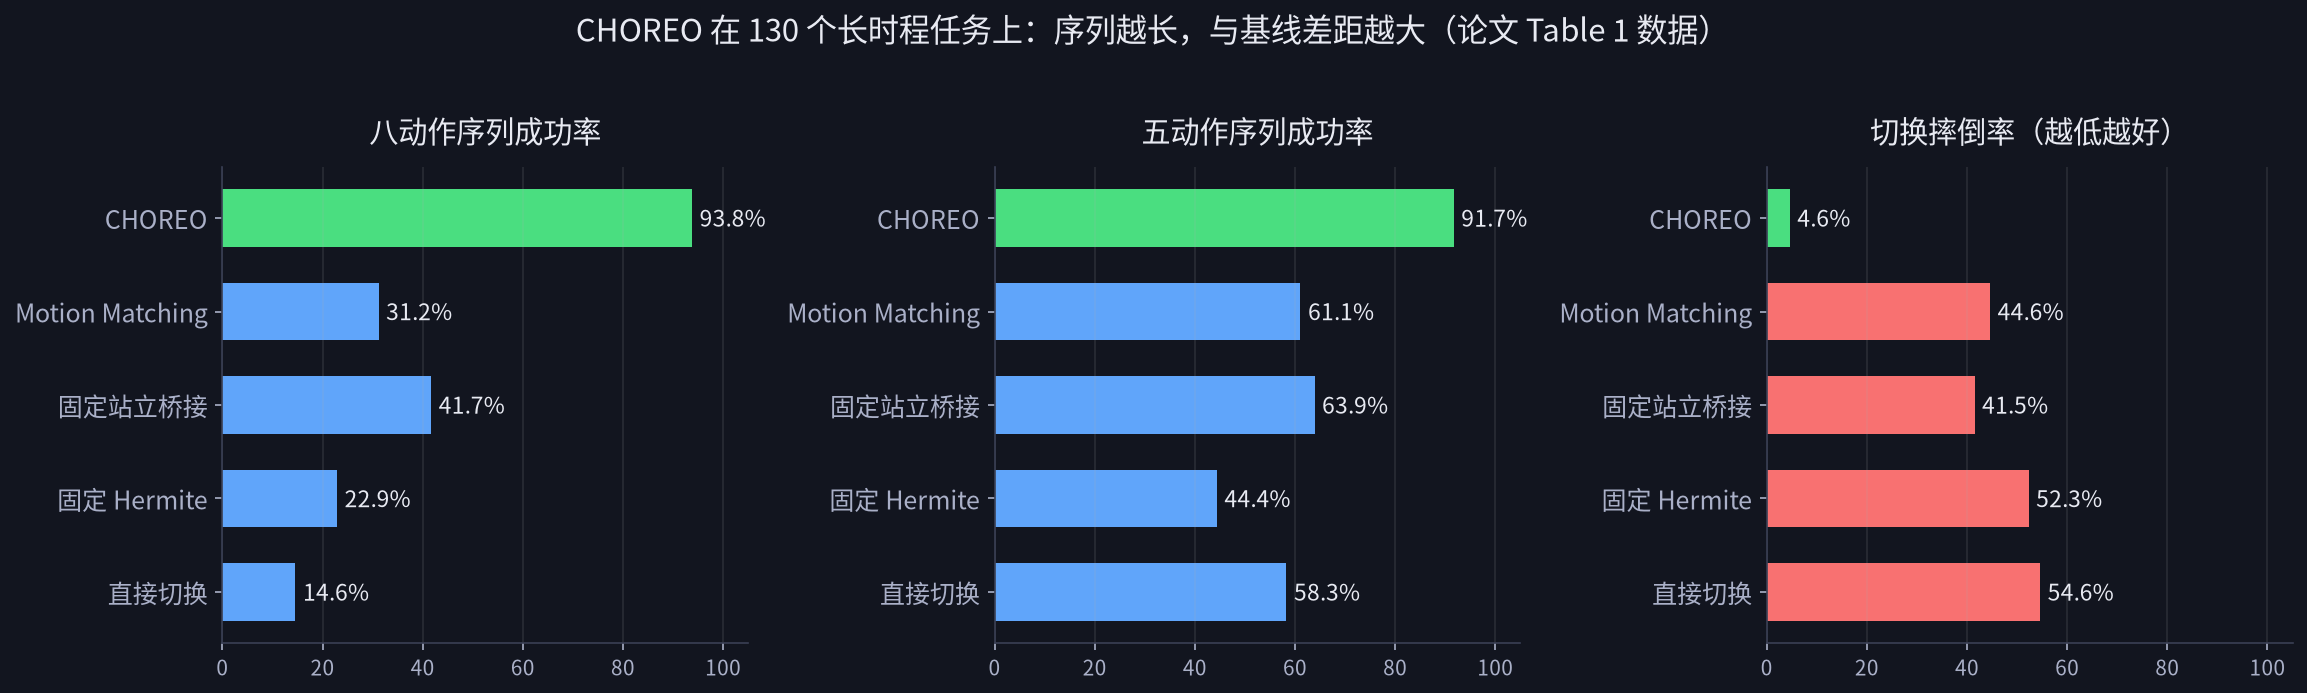
长时程基准包含 130 条提示词条件序列:20 条两动作、26 条三动作、36 条五动作、48 条八动作,共 552 个计划技能边界。成功判据极严格:序列内每个技能与每个过渡全部完成才算成功,越长的序列给每个方法的「犯错机会」越多——一次边界失误就终止整段执行。对比基线四个:直接切换、固定 Hermite 插值、固定站立桥、Motion Matching,全部共享同一任务序列、资产、初始状态与冻结 GMT。
| 方法 | 2 动作 | 3 动作 | 5 动作 | 8 动作 | 边界切换 SR | 摔倒率 | Δq (rad) |
|---|---|---|---|---|---|---|---|
| 直接切换 | 75.0% | 61.5% | 58.3% | 14.6% | 67.2% | 54.6% | 0.0449 |
| 固定 Hermite | 85.0% | 69.2% | 44.4% | 22.9% | 68.8% | 52.3% | 0.0178 |
| 固定站立桥 | 70.0% | 73.1% | 63.9% | 41.7% | 72.6% | 41.5% | 0.0180 |
| Motion Matching | 80.0% | 73.1% | 61.1% | 31.2% | 75.2% | 44.6% | 0.0171 |
| CHOREO | 100% | 100% | 91.7% | 93.8% | 96.7% | 4.6% | 0.0170 |
结果的核心形态是差距随长度拉大:CHOREO 完成全部 46 条两/三动作序列,八动作上 93.8%(45/48),而最强基线在五动作 63.9%、八动作仅 41.7%——CHOREO 的领先从两动作的 15 个百分点扩大到八动作的 52.1 个百分点。边界级指标给出了一致解释:552 个计划边界上 CHOREO 切换成功率 96.7%(超 Motion Matching 21.5 个百分点),摔倒率从最安全基线的 41.5% 压到 4.6%,同时关节位置不连续量 Δq = 0.0170 rad 反而是全场最低——「平滑」与「稳」没有互斥。
基线分析部分写得相当有洞察力。固定 Hermite 把 Δq 从直接切换的 0.0449 压到 0.0178 rad,但八动作成功率仍只有 22.9%、摔倒率高于 50%——光滑的接缝本身不足以支撑可靠组合,因为误差会在边界间累积。固定站立桥在长序列上明显更好(八动作 41.7%),但 41.5% 的摔倒率说明单一中间姿态覆盖不了这个基准里千差万别的边界对。Motion Matching 平滑度接近,但切换与序列成功率都显著落后。结论:CHOREO 的优势不是「缝得平」,而是同时维持边界可行性、低摔倒率与运动连续性,阻止过渡误差跨边界累积。
实验二:异构来源吸收与多 Tracker 兼容
来源适配基准检验「通用接口能否吞下结构迥异的输出」:运动库轨迹 2,969 条、RL 策略 rollout 50 条、扩散模型生成动作 50 条,全部 3,069 个实例通过注册检查(schema 合法、状态有限、存取一致),其中 256 条库动作加全部 RL 与扩散动作共 356 例额外做了闭环物理 rollout。结果:导入 100%(3,069/3,069),物理执行 99.2%(353/356)——三个失败全部出现在库动作抽样子集,RL 与扩散来源 50/50 全过。这个实验把两件事拆开了:导入证明异构输出能转成统一表示;rollout 证明转换后的资产在同一个冻结控制器下真的可执行。RL 与扩散子集的 100% 说明接口不绑定任何单一上游表示。
多 Tracker 基准用同一批 30 条准入轨迹喂给六个冻结跟踪器:GMT、HoloMotion、SONIC、H-ACT 各 100%(30/30),TWIST2 86.7%(26/30),OpenTrack 46.7%(14/30)。资产本身一字未改,差异全部来自各跟踪器适配器与其自身鲁棒性。论文对这组数字的解读很克制:四个 100% 说明这是接口兼容性证据而非系统排名;46.7%–100% 的跨度则提醒读者——统一的运动表示消除不了低层跟踪能力本身的差距。
消融:哪个组件最关键
过渡组件消融在相同 130 任务、同一随机种子与冻结 GMT 下隔离三个组件的贡献。移除「状态-入口兼容性评分」伤害最大:八动作成功率从 95.8% 掉到 75.0%,切换成功率从 97.1% 掉到 90.6%,摔倒率从 5.4% 升到 16.2%——随着过渡误差在长序列上累积,「把当前机器人状态匹配到合适的技能入口」变得越来越重要。移除「运动连续性评分」不改变序列成功率,但 Δq 从 0.0162 升到 0.0177 rad、摔倒率微升——它的贡献主要是更平滑安全的接缝。关闭「桥验证」在这个固定基准上不降成功率也不增摔倒,但论文明确警告不能因此说验证多余:它的安全价值体现在被拒绝的桥候选上,而这部分在本任务集里代表性不足。这种「承认消融结果不等于组件无用」的表述方式,值得很多论文学习。
诚实的边界
论文的限制部分写得很实。其一,长时程基准只有固定任务、每任务只跑一次,性能方差、远超八动作的时程、对未见任务分布的泛化都未被充分刻画。其二,3,069 个导入实例中只有 356 个做了闭环 rollout。其三,Tracker 对比仅 30 条轨迹,度量的是运动执行兼容性而非各系统完整能力。其四,全部实验在仿真里完成——感知噪声、执行器延迟、模型失配、接触不确定性与真实世界扰动都未覆盖。此外,框架受限于现有技能与桥库的覆盖质量,过渡分数依赖人工设计的运动学/接触特征。未来工作列了五项:更大技能集验证、重复试验与分布外长组合、真机部署、学习型过渡可行性模型、状态条件桥生成,以及闭环恢复与真实不确定性下的自适应。
为什么值得读:把 harness 思想搬进人形控制
第一,「统一行为输出」比「统一内部架构」便宜得多。这和软件工程里「标准化接口、不标准化实现」是同一条原则。CHOREO 不要求任何技能方改代码——RL 策略、生成模型、动捕数据各自原样保留,只贡献轨迹。技能生成与执行解耦后,「加技能」这件事的边际成本从「一次训练」降为「一次注册」,这才是它能谈到「可扩展」的原因。
第二,长时程的敌人是误差累积,不是单点失误。固定 Hermite 的失败最说明问题:它把每个接缝都做得很平滑(Δq 低),八动作成功率却只有 22.9%——因为平滑不等于可行,边界误差照样跨段累积。CHOREO 的解法是把「能不能接」当成一个带显式评分的检索问题(连续性 + 兼容性 + 接触置信),接不上就插入站立桥改写中间参考,而不是硬缝。这对任何「把多个已验证能力串成长任务」的系统都成立——包括 LLM agent 的工具链编排。
第三,评测协议的严谨度本身就是贡献。序列级成功判据(一票否决)、失败全部留在分母、冻结协议禁用测试期更新、消融的独立记录完整性校验(520 episodes 零重复零资源失败)、以及对「桥验证消融无差异」的克制解读——这些细节让 95.4%/93.8% 这两个数字可信。当然也要记住它的边界:仿真、G1 单本体、GMT 主导——真机上「站立桥」在扰动下还站不站得住,是这篇论文留给下一年的问题。
CHOREO 由 Ocean University of China(Ziyi Sun、Jingwen Chen 共同一作)与中国科学院自动化所(Long Cheng、Zhaoxiang Zhang)合作完成,受国家自然科学基金(62606500)与山东省自然科学基金资助,arXiv:2609.22274(cs.RO,2026 年 9 月 11 日提交)。