PAPER DEEP DIVE
ResSafe:用残差强化学习为人形机器人学习安全滤波
ResSafe 把人形机器人控制的性能与安全解耦:名义策略只优化任务表现,冻结后用残差 RL 训练一个专学安全修正的策略,最终动作两者相加,等效于隐式最小范数安全滤波器。Unitree G1 极限平衡任务上,随机负载下摔倒率从 7.29% 降至 1.11% 而跟踪误差几乎不涨,且可跨参考策略检查点泛化、迁移至真机。
一句话总结
ResSafe 把人形机器人的「性能」与「安全」拆开训练:先用常规方式训一个只管任务表现的名义策略,冻结后再训一个残差策略专门学安全修正量,最终动作是两者相加。这个解耦让性能—安全的帕累托前沿显著优于单策略把所有目标塞进一个奖励函数里硬调,也无需在线求解优化——学到的残差策略本身就是一个隐式的最小范数安全滤波器。在 Unitree G1 极限平衡任务上,随机负载下摔倒率从基线 7.29% 降到 1.11%,而跟踪误差几乎不涨。
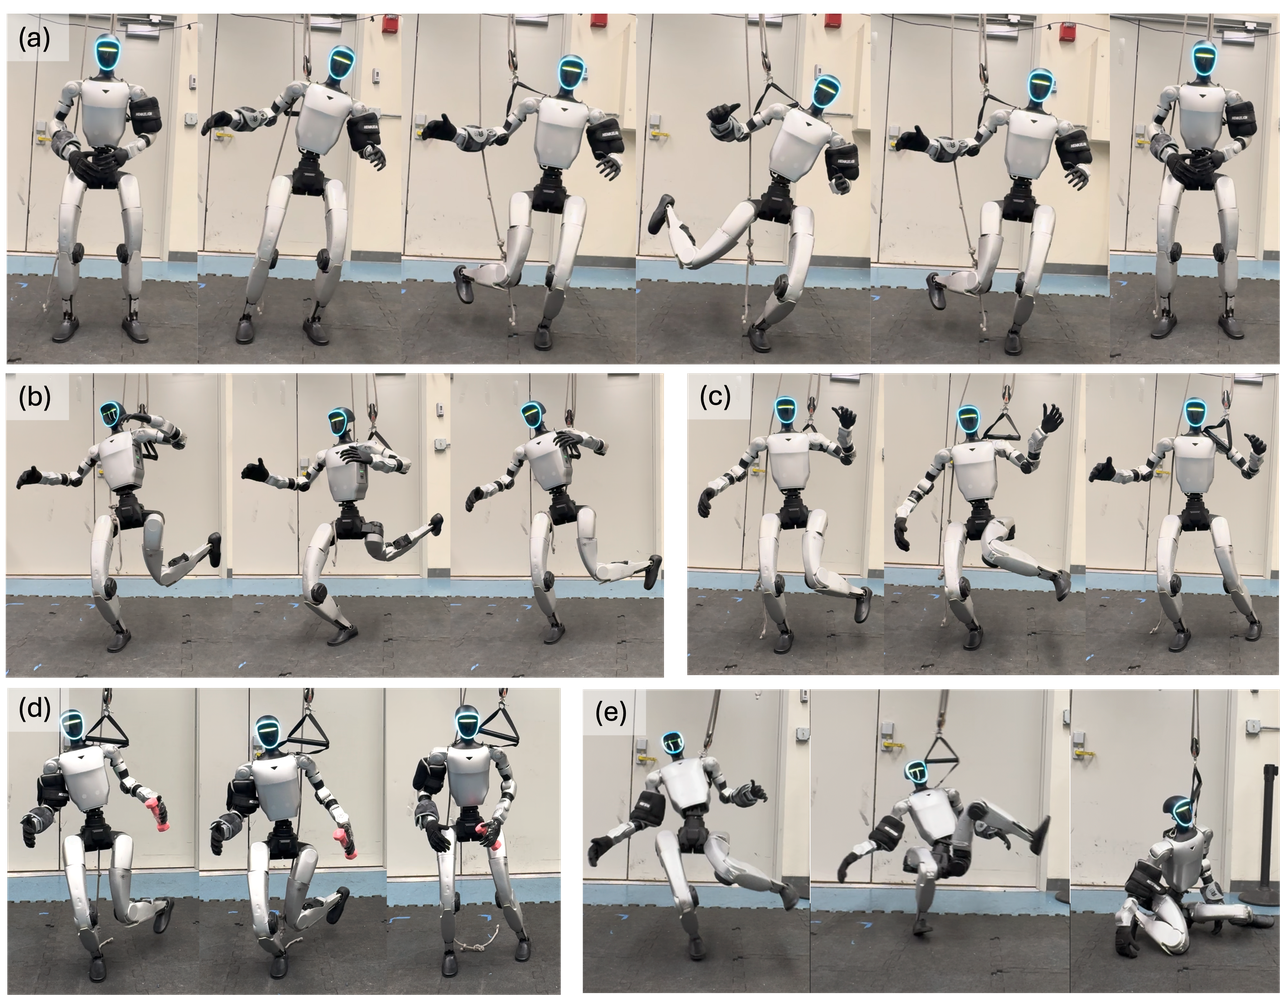
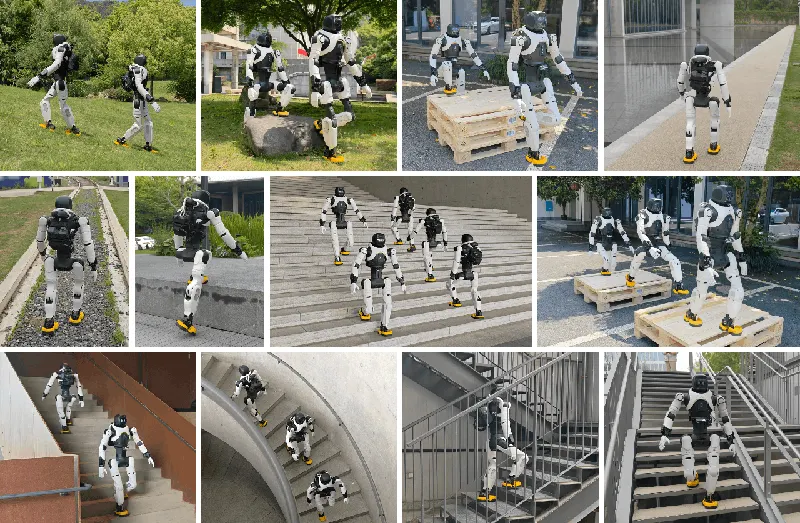
图 1:ResSafe 在 Unitree G1 上的平衡任务验证,含带负载与不带负载两类设置。
研究背景:性能与安全耦合的代价
人形机器人的强化学习天然是一个多目标优化问题:名义性能(敏捷性、动作跟踪精度)必须与安全性、鲁棒性同时权衡,而这些目标往往相互冲突,构成一条帕累托前沿。实践中却有个坏消息——RL 算法基于梯度优化,通常收敛到局部最优,得到的帕累托前沿往往是次优的。于是当前框架里,想提升鲁棒性或安全性(加大域随机化、加强失败惩罚),就几乎必然以性能退化为代价。经典安全 RL 的约束马尔可夫决策过程(CMDP)同样如此:安全与性能通过拉格朗日乘子耦合在一起。
作者的出发点来自对人类运动智能的观察:人学一项新运动时,不会从零重学「保持平衡、避免碰撞」这些安全能力,而是依赖多年成长与物理交互中形成的反射性运动技能。由此提出目标:为机器人开发一个可跨任务迁移、无需为每个任务从零重训的安全滤波策略。作为迈向该目标的第一步,论文在训练阶段显式解耦性能与安全的学习。
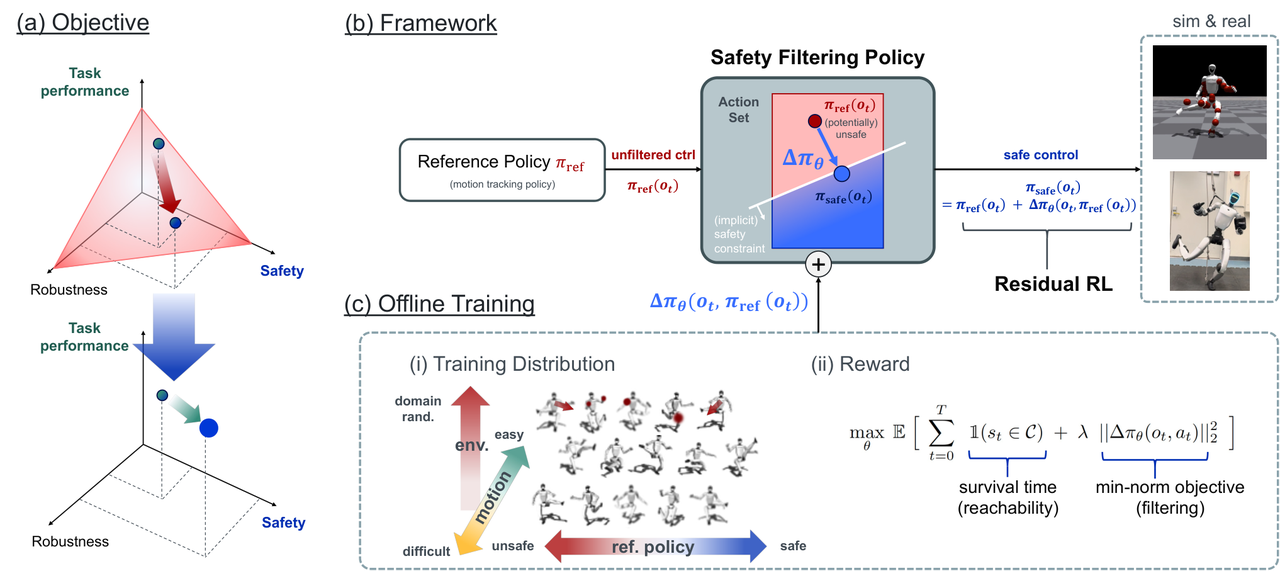
图 2:(a) 单策略框架中性能与安全耦合的次优帕累托前沿;(b) ResSafe 的残差解耦框架;(c) 人形上的训练引导策略。
方法
从安全滤波到动作约束最优控制
考虑受约束的最优控制问题:系统轨迹 $\dot{x}(t) = f(x(t), u(t))$,控制输入满足紧致输入界 $u(t) \in \mathcal{U}$。安全约束由约束集 $\mathcal{C}$ 定义,要求状态全程 $\xi(t) \in \mathcal{C}$;该集可表示为某连续函数 $h$ 的零超水平集 $\mathcal{C} = \{x : h(x) \ge 0\}$。控制目标为:
$$\min_{u(\cdot)} \int_0^T \gamma^t \, \ell(x(t), u(t)) \, dt \quad \text{s.t.} \quad h(\xi(t)) \ge 0,\ \forall t$$
其中前项是任务目标(运行代价 $\ell$ + 折扣因子 $\gamma$),后项是安全约束。论文把这个耦合问题拆成安全子问题与动作约束最优控制问题。基于 Hamilton-Jacobi(HJ)可达性分析定义有限/无限时域最坏情况安全值函数:
$$V(x) = \inf_{u(\cdot)} \sup_{t \in [0,T]} h(\xi(t))$$
约束集内的最大控制不变集即该值函数的零超水平集;一旦轨迹离开该集,约束必被违反。每步所有能避免违规的安全控制输入构成最大安全动作集 $\mathcal{U}_{\text{safe}}(x)$,由值函数确定。据此原问题可等价写成动作约束形式,并在经典安全控制中被 CBF、预测控制等保守近似为安全滤波架构:名义策略先只优化任务目标,滤波器再把可能不安全的名义动作映射为安全动作。
滤波采用最小范数目标——只在安全必需时才修改名义动作:
$$u_{\text{filter}}(x) = \arg\min_{u \in \mathcal{U}_{\text{safe}}(x)} \lVert u - u_{\text{ref}}(x) \rVert^2$$
滤波输出可等价写成「未滤波名义动作 + 滤波修正项」:
$$u_{\text{filtered}} = u_{\text{ref}} + \underbrace{(u_{\text{filter}} - u_{\text{ref}})}_{\Delta u}$$
在 CBF 文献中 $\Delta u$ 被称为 CBF 增广输入。ResSafe 的核心思路就是:不去学安全动作集或值函数,直接用残差 RL 学这个修正项 $\Delta u$。
判别超平面与它的局限
对控制仿射动力学(涵盖刚体机器人动力学),安全动作集可在每步用半空间约束表示:
$$\mathcal{U}_{\text{safe}}(x) = \{u : a(x)^\top u \le b(x)\}$$
其中 $(a(x), b(x))$ 定义了控制输入空间中的判别超平面(discriminating hyperplane, DH),在每步把已认证安全的输入与可能不安全的输入分开。这一表示统一了经典 CBF 与 HJ 可达性滤波器,且最大优势是可以直接从数据学超平面参数,无需显式动力学模型、也无需显式计算 (3) 式的安全值函数。
论文用小车-倒立摆做示例:任务是把小车稳定在目标位置,安全约束是把小车位置限制在某个区间内(刻意与任务目标冲突)。先用 PPO 训一个 MLP 名义策略完成任务,再用 PPO 学到的判别超平面对其做安全滤波。结果有效——但作者明确指出 DH 的两个问题:它学的是约束表示而非直接学滤波后的安全动作,因此在高维系统上泛化较差;而且它把半空间结构强加给安全动作集,对更复杂的系统(安全动作集非凸、非连通)可能不适用。这正引出残差 RL 路线。
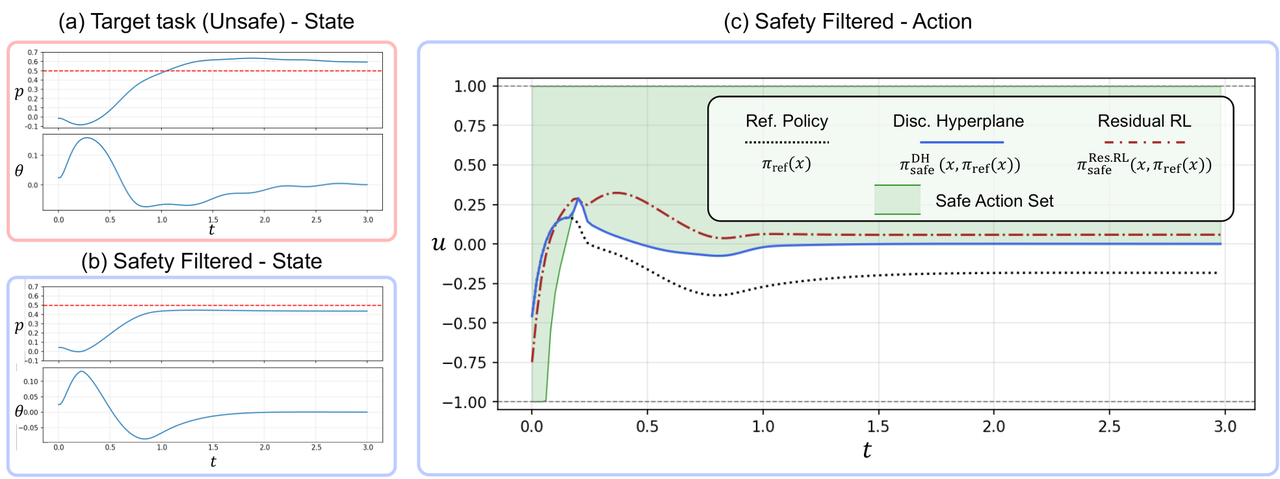
图 3:小车-倒立摆示例。残差 RL 安全滤波器(c 中蓝线)与判别超平面给出的最小范数滤波输入(绿背景为学到的安全动作集)几乎重合,略偏保守。
残差 RL 安全滤波
为应对人形这类高维不确定随机系统,论文改用基于 MDP 的概率安全定义:目标是最大化安全约束满足的概率(安全率)。与现有用 RL 求解 (3) 式可达性值函数的路线相比,关键差异在于——该问题可重构为求和型奖励问题:
$$\max_{\pi} \mathbb{E}\left[\sum_{t=0}^{T-1} \mathbb{1}\{h(x_t) \ge 0\}\right]$$
而现有方法涉及 min-over-time 目标,导出的是另一类 Bellman 方程,PPO 这类现成算法不做专门改造无法直接套用。残差 RL 不学安全动作集,而是直接学 (8) 式中的修正项,把 $\Delta u$ 表示为以状态 $x$ 与名义动作 $u_{\text{ref}}$ 为输入的残差策略,并纳入最小范数目标:
$$\max_{\pi_{\text{res}}} \mathbb{E}\left[\sum_t \mathbb{1}\{h(x_t) \ge 0\} - \lambda \lVert u_{\text{ref}}(x_t) + \pi_{\text{res}}(x_t, u_{\text{ref}}(x_t)) - u_{\text{ref}}(x_t) \rVert^2\right]$$
即 $\max \mathbb{E}[\sum_t \mathbb{1}\{\text{safe}\} - \lambda \lVert \pi_{\text{res}} \rVert^2]$,其中 $\lambda$ 是最小范数惩罚权重。常数项即所谓「存活奖励」(alive bonus)——它在许多实用的机器人 RL 框架里本就是手工设计的奖励项之一。状态不可直接获取时可用观测替代。在小车-倒立摆上,残差 RL 策略几乎精确复现了判别超平面给出的最小范数滤波输入,只是略偏保守;作者认为这份额外保守性构成了鲁棒裕度,恰是后面人形平衡任务上安全率提升的原因。
面向人形平衡的训练设计
Unitree G1 的状态与输入维度极高($n_x, n_u$ 达数十维量级),要让残差策略探索充分以获得鲁棒性与泛化性,必须精心引导训练:
参考策略。用已建立的平衡动作跟踪流水线训练,但不同于只跟踪单一参考动作,论文生成了 1 万条平衡动作组成的多样化数据集,覆盖广泛的可行人形构型与行为,难度各异。在多样动作上训练,可促使安全策略学到更一般的平衡先验,而非过拟合到某条特定轨迹。
奖励设计。残差策略的奖励紧凑——在 (10) 式两项之外再加两项安全奖励:基座速度稳定项(抑制过度水平漂移)与动作平滑惩罚(抑制控制突变)。
训练策略。PPO + 非对称 actor-critic:actor 是部署用的残差策略,只接收部署时可得的观测(本体感知状态 + 参考策略动作);critic 仅训练期使用,可访问特权仿真信息(如真实刚体状态)。另有两项关键技巧:其一,在机器人身体不同位置引入变化的负载并施加随机推力,把策略暴露在失败或近失败状态中——没有这种激励,策略会学出一个不切实际的过度保守滤波器;其二,残差策略针对多个参考策略检查点学习安全修正,从而对未见过的未滤波动作具备泛化能力。
实验结果
仿真:性能—鲁棒性与性能—安全性权衡
在 Unitree G1 上用 IsaacGym 评估,对比三个基线:不带负载域随机化的参考跟踪策略(Baseline)、直接用负载域随机化训练的参考策略(Baseline*)、以及用 PPO 训练的判别超平面安全滤波器(DH)。
| 策略 | 跟踪误差(带负载) | 跟踪误差(无负载) | 摔倒率(带负载) |
|---|---|---|---|
| Baseline | 38.60 mm | 24.95 mm | 7.29% |
| Baseline* | 43.28 mm | 44.40 mm | 1.20% |
| ResSafe | 37.66 mm | 34.04 mm | 1.11% |
读数很清晰:基线跟踪尚可但随机负载下摔倒率攀升,说明精准的动作跟踪并不保证动力学变化时的鲁棒性;直接加负载随机化训练提升了鲁棒性,却换来更高的跟踪误差(无负载时 24.95 → 44.40 mm,几乎翻倍,典型的过度保守)。ResSafe 拿到最低摔倒率,同时跟踪误差仍贴近名义策略——鲁棒性与跟踪性能的更优平衡。
| 策略(安全代价权重) | 跟踪误差 | 摔倒率 |
|---|---|---|
| Baseline* | 59.89 mm | 1.17% |
| Baseline* + Safety (50) | 101.68 mm | 0.00% |
| Baseline* + Safety (100) | 353.55 mm | 1.63% |
| ResSafe | 68.65 mm | 0.50% |
这组对照最能说明解耦的价值:在单策略里加中等安全代价确实能降摔倒率(1.17% → 0%),但加大安全权重会严重劣化跟踪性能,且不能持续改善安全(权重 100 时误差飙到 353.55 mm,摔倒率反而回到 1.63%)。ResSafe 则在改善安全的同时不引发严重跟踪退化——把名义动作跟踪与残差安全修正分离开的直接收益。
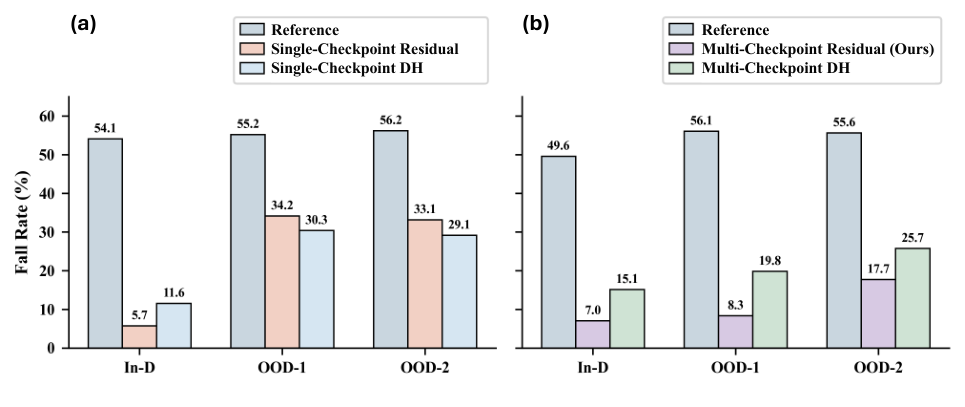
图 4:不同参考策略检查点下的摔倒率。单检查点训练的残差策略换个检查点就明显退化,多检查点训练则保持鲁棒。
泛化实验显示:残差策略若只用单个参考策略检查点训练,换到其他检查点时性能显著退化、摔倒率大幅上升;而跨多个检查点训练的策略在部署到未见参考策略时依然稳健。这说明学到的残差修正捕捉的是与安全性相关的通用行为,而非对某个特定控制器的过拟合。判别超平面滤波器在这两项上都劣于 ResSafe。
真机验证
| 方法 | 摔倒(#9350 带负载) | 跟踪误差 | 摔倒(#6337 带负载) | 跟踪误差 |
|---|---|---|---|---|
| Baseline | 10/10 | 84.13 ± 12.99 mm | 10/10 | 73.56 ± 14.68 mm |
| Baseline* | 0/10 | 47.73 ± 4.01 mm | 5/10 | 62.00 ± 14.43 mm |
| DH | 1/10 | 67.88 ± 20.13 mm | 9/10 | 82.62 ± 22.98 mm |
| Ours | 2/10 | 49.81 ± 11.65 mm | 0/10 | 70.01 ± 3.11 mm |
在真实 G1 上,ResSafe 在多个动作与多种负载条件下摔倒率与跟踪误差均优于基线和判别超平面。一个诚实的细节:Baseline* 在带负载时跟踪更好(因为它显式用跟踪奖励训练),但无负载时因域随机化带来的过度保守,跨多个动作的误差反而更差。整体结论是残差安全滤波策略可迁移到真机,并在挑战性动作任务上提升安全性与鲁棒性。
意义与局限
只优化任务性能
(训练后冻结)"] --> C["最终动作
u = π_ref(x) + π_res(x, u_ref)"] B["残差策略 π_res
PPO + 非对称 actor-critic
奖励 = 存活 + 基座稳定 + 平滑 - λ‖π_res‖²"] --> C C --> D["隐式最小范数安全滤波
无需在线优化 · 无需显式动力学模型"] E["训练激励
随机负载 + 随机推力
多参考检查点 · 1 万条平衡动作"] --> B D --> F["G1 仿真:摔倒率 7.29% → 1.11%
真机:多动作零摔倒"]
ResSafe 的贡献在于给出了一条介于「经典安全滤波(需要模型、难扩展到高维)」与「单策略安全 RL(目标耦合、帕累托次优)」之间的实用路线:用残差 RL 直接学安全修正量,既保留了最小范数滤波的行为特征(只在必要时干预),又不需要在线求解优化或显式动力学模型,还天然支持跨任务、跨参考策略的复用。论文也把它与控制论安全滤波联系了起来——学到的残差策略在行为上等价于一个最小范数安全滤波器,是一种隐式安全滤波机制。
作者坦承五点局限:安全滤波器从数据中学得,因此不提供经典安全滤波意义上的硬保证;残差策略始终比判别超平面滤波器保守,这一现象的理论解释尚待研究;方法依赖人形 RL 中标准的 sim-to-real 技术(系统辨识、域随机化),并未显式处理 sim-to-real 迁移,这也是仿真与真机之间差距的来源之一;安全滤波器的泛化能力受训练动作数据多样性限制(可用微调适配新动作);当前框架是无外部感知的「盲」安全滤波器——而人类的平衡与安全行为高度依赖视觉反馈与环境感知,引入感知、利用环境可供性做安全是重要的未来方向。