PAPER DEEP DIVE
VIRAL:大规模视觉 Sim-to-Real 让人形机器人学会自主移动-操作
NVIDIA 与 CMU 等提出 VIRAL:用 200 条仿真遥操作示范做参考状态初始化,特权 RL 教师(16 卡)学长时程移动-操作,再用 DAgger+BC 混合在 64 卡平铺渲染仿真中蒸馏出纯 RGB 学生策略,零微调部署到 Unitree G1。真实世界 59 次连续试验成功 54 次,单周期 20.2 秒,快于拥有 1000+ 小时经验的专家遥操作员(21.4 秒)。核心发现:算力规模不是便利而是必要条件,低算力配置常训不出来。
一句话总结
VIRAL 是一套纯视觉的人形机器人「移动-操作」(loco-manipulation)sim-to-real 框架:在仿真中用特权 RL 教师学长时程的移动-操作,再用大规模平铺渲染(tiled rendering)蒸馏出只看 RGB 的学生策略,零微调直接部署到真实 Unitree G1。真实世界连续 59 次试验成功 54 次(91.5%),单周期 20.2 秒——比拥有 1000+ 小时 G1 遥操作经验的专家(21.4 秒)还快,成功率逼近专家的 100%。论文的核心发现之一是:算力规模不是锦上添花,而是必要条件——教师训练从 1 卡扩到 16 卡、学生蒸馏从 1 卡扩到 64 卡,低算力配置常常根本训不出来。
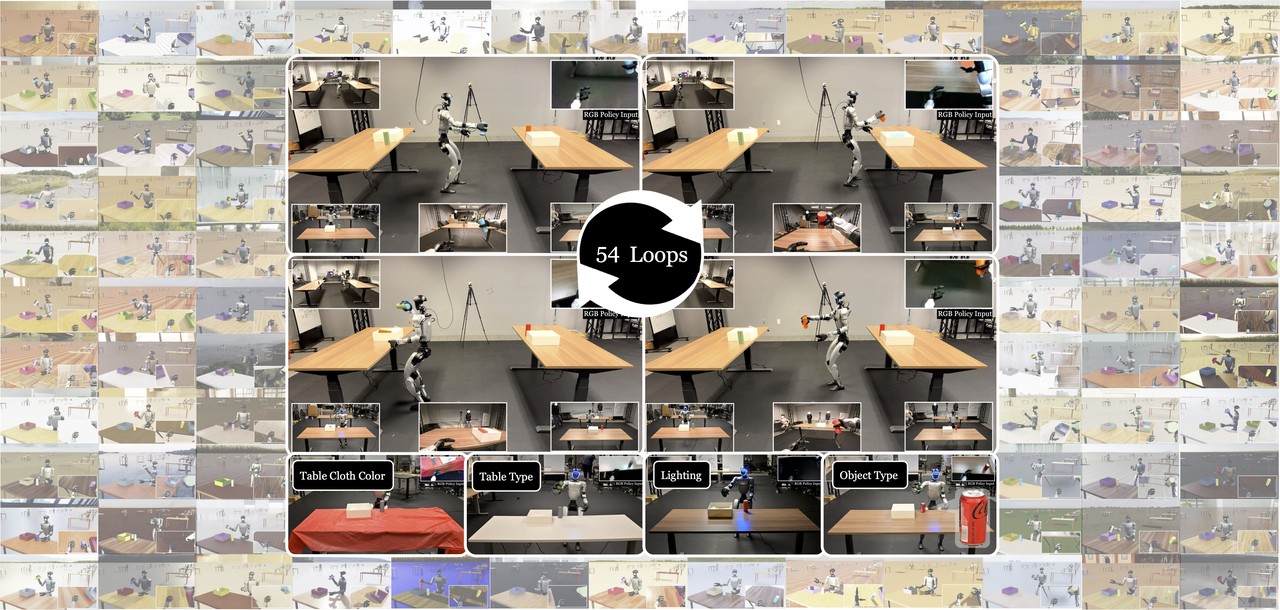
图 1:中间为 Unitree G1 用 RGB 策略在两张桌子之间行走、放置与抓取物体,连续完成 54 个循环;四周是训练所用的多样化仿真场景。
研究背景:人形机器人缺的是「自主移动-操作」
人形机器人常被描述为通用物理智能的自然载体:一种最终能承接社会大量体力劳动的机器。然而尽管硬件与控制快速进步,当前人形机器人在精心编排的 demo 之外,真实、持续的生产力仍然有限。一个核心缺失是自主的移动-操作(loco-manipulation)——在机载感知下把运动与操作紧密协调,并在长时程、跨多样环境中完成有用任务。
现有系统大多只覆盖其中一半:要么专注盲走(blind locomotion),要么做固定基座上的桌面操作,要么重度依赖人类遥操作或非机载传感器。近期一股热潮是把大语言模型的配方搬进机器人——收集大规模真实数据集、从真实遥操作数据训练「机器人基础模型」。但这条路对移动操作尤其昂贵:移动场景比固定桌面有远多的变化,因而需要远多的数据;当移动平台是人形机器人时,每个数据点的成本因硬件复杂度、高自由度、安全约束和遥操作栈的工程开销而进一步抬高。如果把人形移动操作当成「又一个数据问题」,所需规模在实践中可能贵到不可行。
仿真提供了另一条路:现代 GPU 加速的光逼真仿真器能以远低于人类遥操作的边际成本,生成数量级更多的数据。sim-to-real 早已成为腿足运动的事实方法,但操作仍由真实数据模仿学习主导,sim-to-real 的成功通常局限于桌面场景和狭窄任务;而且运动与操作常被分开研究——运动工作忽略操作,操作工作又假设基座固定。VIRAL 要回答的问题正是:视觉 sim-to-real 能否让人形机器人获得有用的自主移动-操作能力?
方法:教师-学生两阶段框架
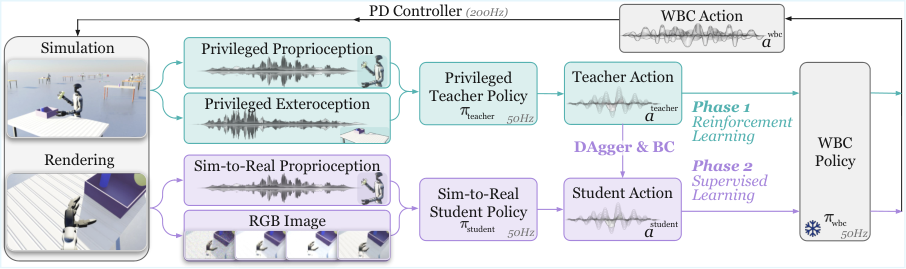
图 2:VIRAL 教师-学生流水线。阶段一在仿真中用全状态特权教师策略输出 WBC 指令;阶段二用 DAgger 与行为克隆蒸馏出只接收 RGB 图像与真实可获取本体感知的学生策略。
阶段一:特权 RL 教师(16 卡 L40S)
教师被形式化为一个目标条件(goal-conditioned)RL 策略。时刻 $t$,教师 $\pi_{\text{teacher}}(a_t \mid o^{\text{priv}}_t)$ 依据特权观测输出给底层 WBC(whole-body control)策略的高层指令:
$$a_t = (\Delta v_t,\ \Delta \omega^{\text{yaw}}_t,\ \Delta q^{\text{arm}}_t,\ \Delta q^{\text{finger}}_t)$$
其中 $\Delta v_t$、$\Delta \omega^{\text{yaw}}_t$ 是线速度($x,y$)与偏航角速度的增量指令,$\Delta q^{\text{arm}}_t$、$\Delta q^{\text{finger}}_t$ 是手臂与手指电机的增量关节目标。特权观测 $o^{\text{priv}}_t = [o^{\text{prop-priv}}_t,\ o^{\text{exte-priv}}_t]$ 包含:
- 特权本体感知 $o^{\text{prop-priv}}_t = [v_t,\ \omega_t,\ g_t,\ a_{t-1},\ q_t,\ \dot{q}_t,\ f^{\text{finger}}_t]$:基座线/角速度、基座投影重力、上一步动作、关节位置与速度、指尖力。
- 特权外感受 $o^{\text{exte-priv}}_t = [e_t,\ T_t,\ O_t]$:当前阶段 $e_t$、放置与抬升目标 $T_t$、物体与桌子相对机器人的变换 $O_t$。
教师用 PPO 训练,配合自定义的分布式 TRL 实现。这一阶段不做视觉渲染,跑在两个 8 卡 L40S 节点(共 16 GPU)上。四个关键设计:
1. 分阶段奖励设计
任务被切分为行走、放置、抓取、转身四段,对应四项奖励:
$$r^{\text{walk}} = \exp\!\big(-4\,(\lVert p_{\text{robot}} - p_{\text{GraspObj}}\rVert - 0.45)^2\big)$$
$$r^{\text{place}} = -\lVert f_{\text{PlaceObj}}\rVert \cdot \mathbb{1}\big(\lVert p_{\text{PlaceObj}} - p_{\text{tray}}\rVert < 0.3\big)$$
$$r^{\text{grasp-z}} = \min\big(h_{\text{GraspObj}} - h_{\text{table}},\ 0.15\big), \qquad r^{\text{grasp-goal}} = \exp\!\big(-10\,\lVert p_{\text{GraspObj}} - p_{\text{goal}}\rVert^2\big)$$
$$r^{\text{turn}} = -\lvert y_{\text{robot}} - y_{\text{desired}}\rvert$$
其中 $r^{\text{place}}$ 用「机器人手指与待放置物体之间的力」乘以「物体距托盘小于 0.3 m」的指示函数,只在接近托盘时惩罚接触力,从而鼓励稳定放置。
2. 增量(delta)动作空间
与多数腿足 RL 工作采用绝对关节目标不同,VIRAL 采用增量动作空间:策略输出增量,再累加进 WBC 指令。实践中这一表示显著加速并稳定了 RL 训练——消融显示,只有 delta 版本的教师能可靠解出任务,绝对动作变体无法达到高成功率。
3. WBC 指令作为「API」
教师不从头学底层运动技能,而是输出高层 WBC 指令。底层采用 HOMIE 作为 WBC 控制器,提供稳定的下半身运动与多样的上半身姿态;VIRAL 在其指令接口上扩展了手指动作。这一层「API 化」带来两个好处:把动作空间限制在人形运动的安全可靠区域内,提升可部署性;同时大幅降低奖励工程负担。作者强调框架并未对特定 WBC 过拟合,可扩展到其他 WBC 控制器。
4. 参考状态初始化(Reference State Initialization, RSI)
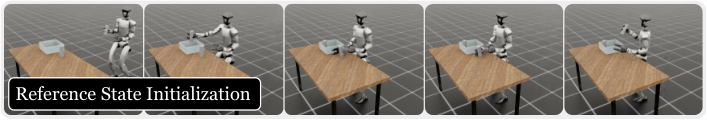
图 4:用于教师 RL 的参考状态初始化帧序列。
高自由度人形的长时程技能通常需要繁重的奖励工程,且常导致次优甚至糟糕的 sim-to-real 迁移。VIRAL 的做法是收集 200 条仿真遥操作示范,作为 RL 的状态初始化缓冲:每个 episode 重置时采样一个示范快照,据此初始化场景(机器人、物体、桌子),让策略在「自己能从零到达这些状态」之前就大量接触多样的高奖励状态。人类提供的抓取与放置位姿是强先验,这种有偏探索大幅降低了对脆弱奖励调参的依赖。消融显示:没有 RSI,教师成功率很快在 10% 以下触顶;有 RSI 的完整教师接近 95%。
阶段二:视觉学生蒸馏(64 卡 L40S + 平铺渲染)
要素一:DAgger 与 BC 混合
学生通过在线 DAgger 与行为克隆(BC)的混合从特权教师蒸馏。二者共享同一个 MSE 目标,在教师与学生诱导观测的混合分布上计算:
$$\rho_o \triangleq \alpha\,\rho^{\pi_{\text{teacher}}}_o + (1-\alpha)\,\rho^{\pi_{\text{student}}}_o$$
$$\mathcal{L}_{\text{distill}} = \mathbb{E}_{o_t \sim \rho_o}\Big[\ \big\lVert \pi_{\text{teacher}}(o^{\text{teacher}}_t) - \pi_{\text{student}}(o^{\text{student}}_t) \big\rVert^2_2\ \Big]$$
其中 $\alpha$ 是混合比例。DAgger 与 BC 的区别只在观测来源:教师 rollout 提供干净、近最优的示范,快速给学生打上强先验;学生 rollout 则把学习器暴露在教师理想分布之外的状态,这对提升纠错鲁棒性、阻止部署时的误差累积至关重要。消融(图 11)给出:纯 BC($\alpha=1$)loss 下降快但策略脆弱,在 Isaac-to-MuJoCo 与真实评测中都表现差;引入学生 rollout($\alpha=0.5$)优化稍慢,但部署成功率大幅提升,因此取 $\alpha=0.5$ 为默认。
要素二:视觉骨干网络
学生视觉骨干采用 SOTA 图像编码器(DINOv3)抽取 RGB 特征,与真实硬件可获取的本体感知融合后送入策略头。消融显示 DINOv3 带来更强的视觉表征与容量,收敛更快、任务成功率更高。
要素三:分布式仿真学习系统
大规模视觉仿真比无渲染物理仿真昂贵得多——吞吐量通常慢至少一个数量级。VIRAL 实现了定制版 TRL,配合 Accelerate 支持跨多 GPU、多计算节点高效扩展,在保留单卡训练简洁性的同时实现近线性扩展。视觉蒸馏在八个 8 卡 L40S 节点(共 64 GPU)上用 Isaac Lab 的平铺渲染完成。
弥合 sim-to-real 的三件事
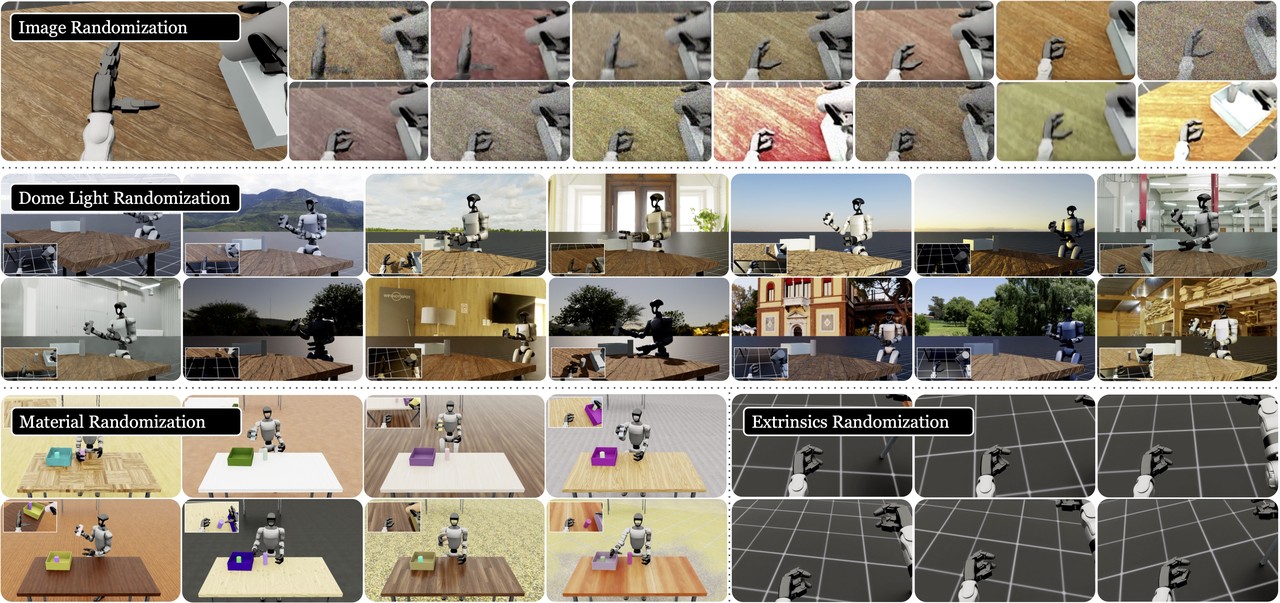
图 3:面向 sim-to-real 鲁棒性的图像、光照、材质与相机外参随机化。
1. 灵巧手的系统辨识(SysID)。现代人形越来越多使用低减速比电机,降低了电机级 SysID 的必要性;但 Unitree G1 的三指灵巧手采用高减速比,存在显著的 sim-to-real 失配。VIRAL 定义了一个真实世界的「抓取-释放」基元,在仿真中重放完全相同的动作序列,然后对手指的 armature、刚度、阻尼参数做 SysID,使仿真关节轨迹对齐真实测量。
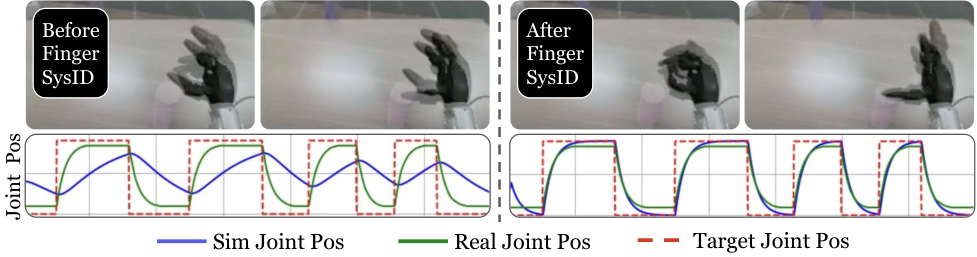
图 5:灵巧手的系统辨识。上为真实-仿真叠加,下为 SysID 前后的关节位置轨迹,显示对齐明显改善。
2. 相机外参对齐与随机化。仿真器内参(焦距、对焦距离、光圈)按厂商规格匹配;但 G1 的相机外参因机械公差在个体间存在差异,同一台机器人上甚至会随时间漂移。VIRAL 通过视觉匹配渲染图与真实图做轻量级外参标定,并在训练中进一步施加外参随机化,确保学生对硬件引起的视角差异保持鲁棒。
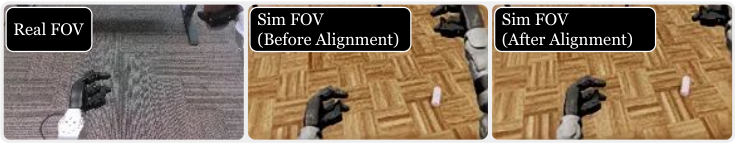
图 6:真实到仿真的相机外参对齐。真实视角 vs 对齐前/后的仿真视角。
3. 视觉与物理随机化。图像质量(亮度、对比度、色调、饱和度、高斯噪声、模糊)、相机外参(小位姿偏移)、相机延迟(传输延迟建模)、dome light 全局光照、以及地板/桌子/物体/机器人部件的材质与颜色,全部随机化。消融(图 13)中三项主导组件是材质随机化(M)、dome 光照随机化(D)、相机外参随机化(E):关掉全部随机化,性能掉到 0.649(相对下降 35.1%);去掉任意单项也会退化——说明这些随机化互补,共同构成鲁棒迁移的关键流水线。
真实世界结果
鲁棒性:54/59,且比专家更快
评测任务是连续移动-操作:人形在两张桌子之间反复行走、放下物体、抓取新物体、转身。59 次连续真实试验中成功 54 次。论文还与两名人类遥操作员对比(都使用同一个 HOMIE 策略,近似同条件对照):
| 操作者 | 成功率 | 单周期耗时 | 说明 |
|---|---|---|---|
| 专家遥操作员 | 100% | 21.4 s | 1000+ 小时 G1 遥操作经验 |
| VIRAL(RGB 策略,零微调) | 见正文:逼近专家 | 20.2 s | 纯机载感知,无需真人介入 |
| 非专家遥操作员 | 73% | 明显更慢 | 约 1 小时经验 |
结论很直接:尽管专家级成功率仍有挑战,VIRAL 达到了接近专家的成功表现,同时比专家更快,并在可靠性与效率上大幅超越非专家——这凸显了它在「辅助遥操作」场景中降低人类工作量的潜力。
泛化:多维度变化全部覆盖
论文系统性地沿多个因子改变环境:托盘起始位置、机器人起始位姿、桌子高度、光照、桌布、桌子类型与颜色、物体类别(图 8)。在所有这些变化下,VIRAL 都无需额外调参即可完成任务。作者把这种鲁棒性归因于训练期的域随机化与 RL 本身的鲁棒性——策略在仿真中已被暴露于多样的视觉与空间条件。
消融:哪些设计真正关键
| 消融项 | 关键发现 |
|---|---|
| 参考状态初始化(RSI) | 无 RSI:成功率 <10% 触顶;有 RSI:接近 95% |
| delta vs 绝对动作空间 | 只有 delta 版本可靠解出任务;绝对动作变体无法达到高成功率 |
| 视觉骨干 | DINOv3 表征更强,收敛更快、成功率更高 |
| DAgger/BC 比例 $\alpha$ | 纯 BC($\alpha=1$)fast loss 但策略脆弱;$\alpha=0.5$ 部署成功率显著提升(默认) |
| 历史架构 | 历史感知模型(前馈/LSTM)一致优于单步基线;更长时间窗在资源允许时有额外增益 |
| 视觉随机化 | 全关掉降到 0.649(-35.1%);去掉 M/D/E 任一项均退化,三者互补 |
| 教师算力扩展(1→16 GPU) | 1–2 卡远低于目标性能且永不达高成功率;8–16 卡稳定推到 90% 以上 |
| 学生算力扩展(1→64 GPU) | 更大批量加速收敛、曲线更平滑、方差更小,最终成功率也略高 |
| 物体泛化 | 十物体训练的教师在每一类上的成功率都高于仅圆柱体训练 |
算力扩展的两组消融尤其值得注意。教师侧(图 14):增加 GPU 不仅加速学习,还显著影响渐近性能——早期甚至出现超线性加速(4 卡达到约 0.2 成功率所需时间远少于 2 卡的一半),因为更大批量的并行环境在单位墙钟时间内覆盖了更广的状态空间。学生侧(图 15):从 1 卡到 64 卡,蒸馏 loss 更快越过同一阈值,成功率曲线陡峭得多;更重要的是训练稳定性——多卡训练 loss 曲线更平滑、成功率方差更小,尤其在学生对分布偏移最敏感的早期阶段。作者由此断言:大规模算力不是便利,而是可靠视觉移动-操作蒸馏的实际要求。
意义与局限
200 条"] --> B["参考状态初始化 RSI"] B --> C["阶段一:特权 RL 教师
全状态观测 · delta 动作空间
PPO · 16×L40S · 无渲染"] C --> D["WBC 指令 API
(HOMIE + 手指扩展)"] D --> E["阶段二:视觉学生蒸馏
DAgger(α=0.5) + BC 混合 MSE
64×L40S · 平铺渲染"] E --> F["sim-to-real 三件套
① 灵巧手 SysID
② 相机外参对齐+随机化
③ 视觉/光照/材质随机化"] F --> G["零微调部署
Unitree G1 · RGB 机载感知"] G --> H["59 次连续试验成功 54 次
20.2 s/周期(快于专家 21.4 s)"]
为什么重要。VIRAL 给出了一个对「人形移动操作 = 又一个数据问题」这一主流叙事的有力反例:它没有用任何真实机器人数据训练,只靠 200 条仿真遥操作示范做状态初始化,就把长时程的「走过去—放下—抓起来—转身」跑到了接近人类专家的水平。这对数据极其昂贵的人形领域,是一条成本结构完全不同的路径。
可迁移的工程要点有三个。其一,示范用作状态初始化而非模仿目标——避开了长时程任务里最脆弱的奖励工程环节,这是一个很省成本的技巧。其二,WBC 当 API——把策略输出限制在已被验证安全可靠的运动流形上,让 RL 只需学「意图」而非「电机」,既降奖励工程负担又提升可部署性。其三,纯 BC 会训出不能纠错的脆弱策略——这一条对任何做视觉蒸馏的团队都适用:必须在数据分布里混入学生自己 rollout 出的状态。
局限方面,论文在结论部分坦率指出:尽管 sim-to-real 在孤立能力上(鲁棒运动、几何感知、刚体操作)成果显著,但要扩展到通用的移动-操作("locomote anywhere, perceive anything, manipulate everything"),仍暴露出四个当前范式尚未弥合的关键覆盖缺口。此外从设计上也能看到边界:任务被限定在两张桌子之间的结构化循环,物体的几何与材质类别有限;系统依赖外部 WBC(HOMIE)作为底层,其能力上界框定了 VIRAL 的动作空间;真实相机外参会随时间漂移,当前的轻量标定是一次性的,长期运行的稳定性未经验证;而「教师 16 卡 / 学生 64 卡」的算力门槛,也意味着复现这套结果本身需要相当规模的资源。